 AIREITER
Un menú de cafetería con cuatro precios parece una tarea sencilla, hasta que el modelo cambia uno de ellos. MOSS Image acierta con este tipo de texto mucho más de lo que cabría esperar por su tamaño, pero funciona mejor cuando le das una estructura clara y revisas el resultado como lo haría un diseñador.
Ese es el equilibrio que ponemos a prueba en este análisis: un modelo de texto a imagen con licencia Apache 2.0 y 5B de parámetros, capaz de aceptar prompts de hasta 4.096 tokens y cajas delimitadoras JSON opcionales para texto y objetos. El equipo de OpenMOSS lo lanzó el 16 de octubre de 2026 con checkpoints Base y SFT, y la API alojada en la plataforma MOSI empezó a funcionar el 20 de octubre. Si trabajas con pósteres, menús, etiquetas o infografías que deben respetar un texto exacto, merece la pena probarlo. Si necesitas consistencia entre personajes o edición fotográfica, sigue con un modelo cerrado.
Los primeros resultados marcan la diferencia: el texto aguanta, la estética no siempre
MOSS Image destaca por mantener textos largos y exactos, no por ganar siempre en estética general. El LongLongTextBench del propio proveedor registra una cobertura de texto Mean-6 del 96,3 en conjunto: 97,1 en textos largos en inglés y 92,4 en chino largo, a través de 240 tareas con una media aproximada de 1.340 caracteres. GPT Image 2 obtiene 99,0 y Nano Banana Pro, 96,6. Son cifras obtenidas por el proveedor en un benchmark diseñado por el propio proveedor, así que conviene tomarlas como una afirmación que hay que comprobar, no como una garantía.
La obediencia al diseño es el segundo dato importante. El informe técnico detallado en este análisis sitúa a MOSS Image en 0,88 mIoU y 0,70 de Layout AUC en la prueba 7Bench de seguimiento de cajas, aproximadamente el doble que Ideogram 4, con 0,44 y 0,20, y claramente por encima de GPT Image 2, con 0,30 y 0,16 en el mismo informe. En RealLayoutArena, con 61 tareas evaluadas a ciegas sobre pósteres, infografías e interfaces, el sistema MOSS completo con mejora de prompts logra 1.698,70 Elo, solo por detrás de GPT Image 2, con 1.844,35. Sin embargo, el modelo base ocupa el primer puesto cuando todos los generadores reciben el mismo prompt mejorado. De nuevo, son resultados del proveedor y todavía necesitan replicación independiente.
Una prueba controlada pequeña permite ver la diferencia de forma más tangible. El equipo de mossimage.run ejecutó MOSS Image SFT frente a FLUX.1 dev una vez por prompt, en el mismo lienzo de 1024x1024 y con las mismas semillas, sin seleccionar solo los mejores resultados: los fallos también se quedaron en el conjunto. No he vuelto a medir la latencia de MOSI alojado para este análisis; los resultados resumidos en la tabla son las primeras salidas de ese equipo a través de endpoints de fal. La API de MOSI, por su parte, se evalúa aquí a partir de su documentación y de su estado de facturación durante la ventana gratuita:
| Prueba | Lo que exigía el prompt | Primera salida de MOSS Image SFT | Primera salida de FLUX.1 dev |
|---|---|---|---|
| Menú de cafetería | MORNING MENU más Espresso 3.50, Flat White 4.20, Butter Croissant 3.80, Avocado Toast 8.50 alineados a la derecha | Los cuatro productos y precios aparecen tal cual | La distribución es clara, pero 3.80 se convirtió en 3.60 |
| Etiqueta de miel | WILDFLOWER HONEY, Raw & Unfiltered, Net Wt. 12 oz (340 g) siguiendo la curva de la etiqueta | Las tres líneas aparecen tal cual | El encabezado y el peso están bien, pero la línea central se convirtió en Raw & Unfilterelrd |
| Póster bilingüe | 周末市集 / WEEKEND MARKET, Sat 10:00–18:00, Riverside Park, Free entry / 免费入场 | Los detalles en chino e inglés aparecen tal cual | La composición es sólida, pero el chino aparece deformado y 10.00–178.00 |
La configuración fue de 50 pasos y CFG 3 para MOSS, frente a 28 pasos y guidance 3.5 para FLUX, mediante fal-ai/moss-image y fal-ai/flux/dev. Tres ejemplos no bastan para proclamar un ganador, como reconoce la propia página, pero sí dejan claro el problema: una imagen convincente con un precio o una hora cambiados es peor que una imagen obviamente fallida.
"MOSS Image manejó bien la distribución estructurada y el texto en inglés para ser un modelo de 5B. No acierta todos los detalles pequeños, pero por fin el flujo de trabajo pareció controlable." — @Olaemmy1200, en un vídeo sobre un flujo de trabajo completo para pósteres
Qué ofrece realmente la API: un generador pequeño con un lector grande
MOSS Image es un transformer de difusión de flujo único con 42 capas, entrenado desde cero. La cifra de 5B corresponde únicamente al generador. A su alrededor trabajan un codificador de texto Qwen3.5-9B congelado, que interpreta el prompt, y una VAE FLUX.2 small-decoder, que renderiza los píxeles. Esta separación explica tanto su fortaleza como sus exigencias de hardware: la comprensión bilingüe y de textos largos procede de un lector de 9B, no del denoiser de 5B.
La ventana de contexto es su ventaja más práctica. El lenguaje natural, las secuencias de etiquetas y todo el diseño JSON comparten un máximo de 4.096 tokens: suficiente para escribir cada línea de un póster en lugar de reducirlo todo a un pie de imagen breve. La documentación de la API de MOSI sitúa el límite alojado en textos largos de hasta 4.000 caracteres, con renderizado de texto, prompts negativos y generación con diseño. Se recomiendan salidas en el rango de 1–2 megapíxeles, extrapolables desde 512x512 hasta 2K, con dimensiones divisibles entre 16.
Hay dos checkpoints que determinan el tipo de resultado:
- MOSS-Image-SFT parte de Base y ha sido refinado mediante ajuste supervisado con datos seleccionados. El equipo de OpenMOSS lo recomienda para generar directamente, ya que agrupa mejor el texto y produce composiciones más limpias. La API alojada utiliza
moss-image-sft-1.0por defecto, con el snapshot fijadomoss-image-sft-1.0-2026-10-09para poder reproducir resultados. - MOSS-Image-Base prescinde del postentrenamiento y de la destilación CFG para conservar la señal de entrenamiento original. La guía oficial lo recomienda para quienes vayan a ajustar el modelo y aconseja congelar el codificador de texto. Elige Base si vas a entrenar una LoRA o buscas otra distribución de estilos, no si quieres crear un póster ahora mismo.
Tanto los pesos como el código de inferencia incluido se publican bajo la licencia Apache 2.0, según la ficha del modelo en Hugging Face y la página oficial del proyecto. Esto permite el uso comercial y el ajuste fino, pero no libera automáticamente los derechos de todos los personajes, logotipos o rostros que generes para una campaña. Conserva el archivo de licencia y la revisión exacta en cualquier proyecto comercial. El código está disponible en el repositorio de OpenMOSS en GitHub.
El diseño en JSON es la razón para aceptar este flujo de trabajo
El lenguaje natural sigue funcionando, pero la sintaxis de diseño es lo que realmente atrae a los diseñadores. Un prompt estructurado describe primero la escena general y después asigna a cada texto u objeto su propia descripción y sus propias coordenadas. Las cajas guían la generación; no son capas vectoriales ni garantizan una precisión píxel a píxel.
El sistema de coordenadas suele confundir a casi todo el mundo la primera vez. Con bbox_coord_space: "abs_centralized" y bbox_format: "yxyx", cada caja se expresa como [y_min, x_min, y_max, x_max] en píxeles respecto al centro del lienzo. En una imagen de 1024x1024, cada eje va de -512 a +512. No pegues coordenadas convencionales con origen en la esquina superior izquierda ni un diseño comunitario de 0–1000 sin convertirlo antes.
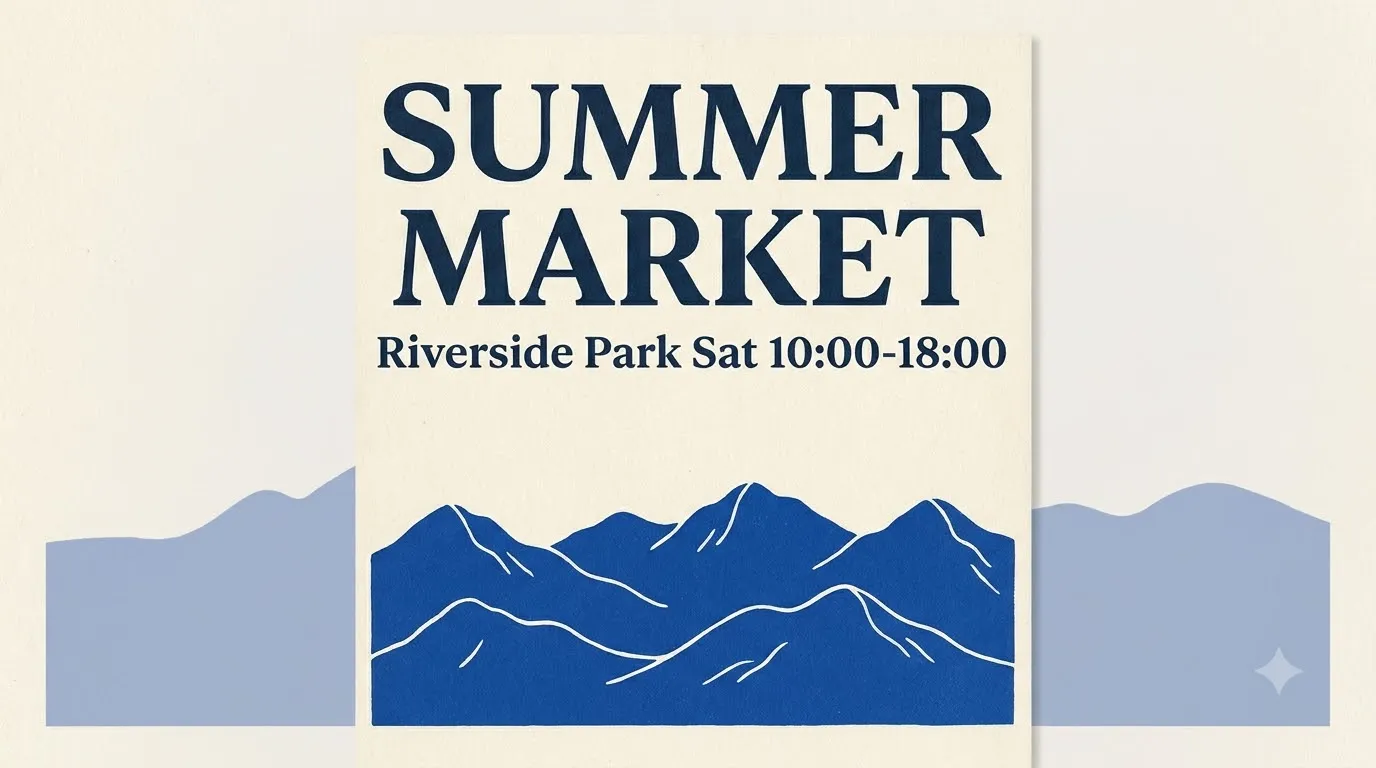
Esta sería una estructura mínima: título arriba e ilustración debajo:
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
Nadie escribe a mano estas cajas para una infografía de 20 elementos. El patrón de trabajo que están usando los primeros usuarios consiste en pedir a un LLM con capacidad de visión que redacte el JSON a partir de un briefing o un boceto y corregir después las coordenadas antes de generar. El probador japonés @chimolog7 lo resumió sin rodeos: el formato bbox es demasiado complicado para hacerlo a mano, así que lo generó con Opus. Después comprobó que el renderizado en japonés presentaba apenas un 1 % de errores percibidos, mientras que Krea 2 seguía escribiendo mal a menudo (publicación).
El segundo truco es regenerar de forma controlada. Como el modelo solo convierte texto en imagen y no admite una imagen de referencia, no puedes pasarle una foto mediante img2img y conservarla. Lo que sí puedes hacer es cambiar el texto o la posición de una caja, mantener la misma semilla y volver a generar: el resto de la distribución suele mantenerse. El usuario @li9292 lo mostró en la portada de un informe semanal con miles de caracteres chinos y 20 cajas: editó una sola caja con la misma semilla y el resto del diseño permaneció en su sitio (publicación). Para trabajos con copy exacto, este ciclo de cambiar una caja y conservar la semilla es más importante que cualquier preset de estilo.
Para poner el renderizado de texto en contexto, nuestra prueba de los mejores modelos de imagen para renderizar texto en 2026 explica por qué hacía falta una alternativa centrada en el diseño.
Cómo se utiliza y cuánto cuesta realmente lo gratuito
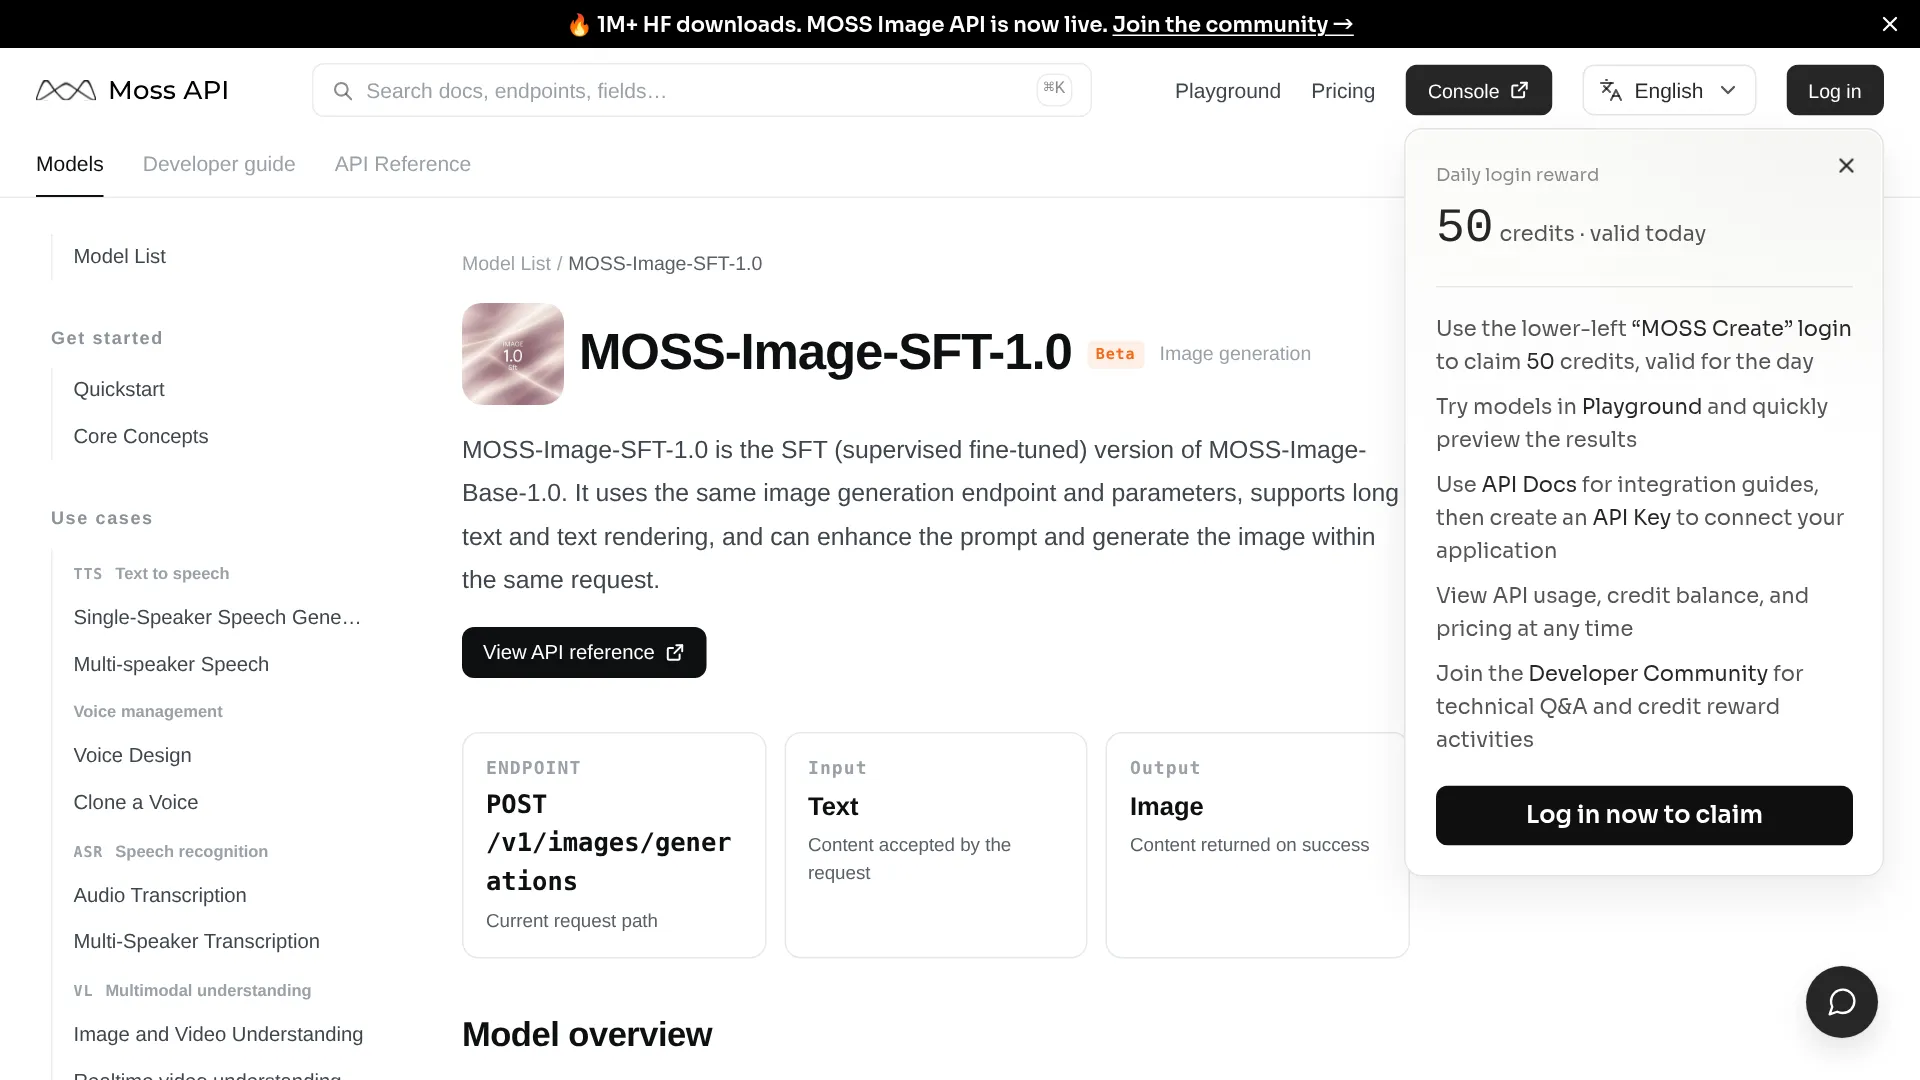
La vía alojada se reduce a un endpoint. La documentación de la API de MOSI ofrece POST /v1/images/generations para moss-image-sft-1.0, con texto de entrada e imagen de salida únicamente: no admite imágenes de entrada, audio ni vídeo, ni ofrece una API de streaming o tareas asíncronas. La mejora de prompts está integrada, pero desactivada por defecto; se activa con prompt_enhance: true y la versión del mejorador se selecciona en el servidor.
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
Cuando necesites controlar cada caja, pasa una cadena JSON de diseño completa como prompt. La versión breve en lenguaje natural de arriba es la llamada más sencilla para copiar y pegar.
En el momento de comprobarlo, la facturación indicaba Free for a limited time a 0 credits, con un enlace a los precios completos para la etapa posterior. La guía sobre Base y SFT señala la misma incertidumbre: el playground está activo desde el 20 de octubre, pero todavía no se ha publicado un precio por imagen estable. Haz tus cuentas pensando en una ventana gratuita para prototipos y, después, en las tarifas del proveedor más el coste de descartar resultados con errores ortográficos.
La inferencia local no tiene coste por imagen, pero sí una factura de hardware considerable. El listado de archivos de Comfy-Org comprobado el 20 de octubre suma unos 29,72 GB de pesos BF16 antes de contar el entorno y la caché: aproximadamente 10,16 GB para el backbone, 19,31 GB para el codificador de texto y 0,25 GB para la VAE pequeña. INT8 ConvRot reduce aproximadamente a la mitad el tamaño del transformer: unos 5,41 GB para el backbone y 9,75 GB para el codificador. También hay una opción de codificador GPTQ W4A8 cercana a 7,34 GB.
| Configuración | Qué hay que descargar | Nota práctica |
|---|---|---|
| BF16 completo | 29,72 GB de pesos + memoria de trabajo | Incluso en 32 GB va justo sin offload; la RAM del sistema y la longitud del prompt importan |
| INT8 cuantizado | Clase de ~15 GB + offload | Ruta documentada de 12 GB a ~1 MP, una imagen por lote (~9,7 GB de pico en la prueba comunitaria citada aquí); es el punto de partida en tarjetas de 8–12 GB |
| DMD comunitario de 8 pasos / 4 pasos | Adaptador + flujo de trabajo compatible | ~24 segundos frente a ~137 segundos en el mismo informe con una RTX 3060 a 1 MP, pero los primeros adaptadores perdían matices; establece antes la referencia de 50 pasos |
La configuración oficial de muestreo utiliza Euler, 50 pasos, CFG 3.0, shift 5.0 y skip-layer guidance en la capa 22, a 1024x1024. La compatibilidad nativa con ComfyUI se incorporó el 16 de octubre (anuncio aquí). Actualiza ComfyUI, busca las plantillas de MOSS-Image y utiliza el flujo Base o SFT correspondiente con los archivos de Comfy-Org; no mezcles un grafo de plugin con un cargador nativo.
Si estás comparando costes de proveedores de forma más amplia, nuestro análisis de la API de generación de imágenes más barata sirve como referencia para calcular el tiempo de GPU y el coste de descartar resultados.
En qué siguen ganando los modelos cerrados
Los límites están claros y conviene tenerlos presentes antes de comprometer un trabajo creativo con este stack. El lanzamiento solo funciona de texto a imagen. No hay edición de imágenes ni entrada de imágenes de referencia; la generación basada en referencias figura como trabajo futuro. Si necesitas conservar una foto subida o mantener un personaje idéntico entre varias escenas, utiliza un modelo orientado a la edición como Qwen Image 2.1 para edición en producción.
Las personas y el criterio estético son la segunda gran diferencia. Con 5B, los rostros pueden resultar genéricos, las proporciones se desvían y las manos repiten los fallos habituales.
"Tampoco consigue bien las proporciones de los personajes. Y no se le dan especialmente bien los típicos problemas de 'manos deformes' y similares." — @SlipperyGem
Las pruebas prácticas citadas respaldan la necesidad de revisar la misma lista antes de publicar: los prompts cortos, los personajes con nombre, las etiquetas de artistas y las restricciones exactas siguen siendo inconsistentes; la letra pequeña necesita una revisión manual y los idiomas que no aparecen en el benchmark inglés/chino también deben comprobarse. La configuración oficial de 50 pasos exige bastante en hardware modesto, mientras que los adaptadores rápidos sacrifican matices de iluminación y seguimiento de restricciones a cambio de velocidad. Guarda el checkpoint, el codificador, la VAE, la precisión, el prompt, la semilla y el tiempo —incluida la codificación— de cada resultado que conserves.
El servicio local orientado a la velocidad cuenta una historia parecida desde el lado del hardware. Lucebox midió 2,7 segundos para 1024x1024 a 8 pasos y CFG 1 en una Radeon AI PRO R9700 con sus propios kernels, 1,8 veces más rápido de extremo a extremo que ComfyUI en una DGX Spark con la misma configuración. Sin embargo, su propia revisión visual detectó 4 de 8 salidas deformes con CFG 1, frente a 1 de 8 con CFG 2.5, que elevaba el tiempo a 5,2 segundos. Más rápido no significa automáticamente más útil.
Preguntas frecuentes sobre MOSS Image API
¿MOSS Image se puede utilizar gratis con fines comerciales?
Los pesos y el código incluido se publican bajo Apache 2.0, una licencia que permite el uso comercial y el ajuste fino sin pagar derechos de licencia. Los endpoints alojados fijan sus propios precios y normas de contenido, y las cuantizaciones o LoRA de terceros tienen sus propias condiciones.
Base frente a SFT: ¿cuál debería utilizar la API?
La API alojada utiliza SFT (moss-image-sft-1.0), el checkpoint ajustado que el equipo recomienda para generar imágenes. Descarga SFT para crear ya pósteres e infografías; utiliza Base cuando vayas a ajustar el modelo o entrenar una LoRA.
¿Puede funcionar con 12 GB de VRAM?
Hay una configuración documentada de 12 GB que funciona con un flujo cuantizado y offloading a la CPU, a ~1 MP y con una imagen por lote.
¿Puede editar una foto o mantener un personaje idéntico?
No. El backbone publicado no admite imágenes de referencia como condición. Reutilizar una semilla con un JSON modificado permite regenerar una composición, pero no conserva una fotografía subida ni garantiza la identidad.
Quién debería probar MOSS Image a continuación
| Tu trabajo | Elige MOSS Image cuando | Elige otra opción cuando |
|---|---|---|
| Póster, menú, diapositiva o mockup de interfaz con texto exacto | El texto bilingüe largo y la colocación mediante cajas importan más que unos personajes fotorrealistas | Solo necesitas eslóganes de una línea; un modelo cerrado será más rápido de indicar |
| Flujo de trabajo para comercio electrónico o editorial | Puedes añadir un paso de LLM a JSON y una revisión del texto, y quieres pesos Apache 2.0 que puedas alojar o ajustar por tu cuenta | Necesitas img2img, inpainting o personajes bloqueados por referencia desde hoy |
| Desarrollador local con presupuesto limitado | Te basta con 12 GB más cuantización, o la ventana gratuita de MOSI cubre tu prototipo | Necesitas rendimiento garantizado, streaming o tareas asíncronas; la API alojada todavía no ofrece ninguna de las tres cosas |
Para diseño con mucho texto y una distribución que puedas especificar, MOSS Image es uno de los pocos modelos abiertos en los que el sistema de restricciones es el producto. Para todo lo que necesite que un rostro siga siendo el mismo rostro, úsalo como motor tipográfico junto a un modelo de imágenes cerrado, no como sustituto.