 AIREITER
Un contexto de un millón de tokens y una tarifa de 0,68 $ por los tokens de entrada hacen que Mistral Large 4 parezca extraordinariamente barato para un modelo de un billón de parámetros. Pero sigue siendo una vista previa pública: no hay una fecha clara para el fin de la tarifa promocional, los límites de los gateways no coinciden siempre con la especificación principal y la futura licencia de los pesos todavía no se ha publicado.
La decisión, en un minuto
Mistral Large 4 merece una prueba si necesitas una API económica y con mucho contexto para documentos, repositorios de código o flujos de trabajo que utilicen herramientas. En cambio, todavía es pronto para considerarlo un sustituto estable para el despliegue propio o un líder demostrado en benchmarks de programación.
| Necesidad | Decisión |
|---|---|
| Probar documentos extensos o grandes bases de código mediante una API | Pruébalo ya, controlando el uso de caché y el coste de salida |
| Necesitar un precio estable a largo plazo | Espera o presupuesta la tarifa más alta de 1,36 $ por los tokens de entrada y 4,18 $ por los de salida |
| Necesitar un despliegue privado | Espera a que lleguen los pesos, la licencia, la cuantización y las instrucciones de servicio |
| Necesitar la mejor puntuación en programación | No elijas basándote solo en las cifras del lanzamiento; ejecuta el mismo sistema de evaluación con tus tareas |
Esto es una decisión sobre una API en vista previa pública, no un veredicto definitivo sobre el modelo. Mistral anunció la vista previa el 6 de octubre de 2026 y sus materiales públicos indican que los pesos están previstos para finales de octubre. (Anuncio de Mistral)
Qué está disponible realmente el 6 de octubre
Mistral Large 4 está disponible como API en vista previa pública a través de Mistral Studio. Mistral lo describe como un modelo multimodal nativo de tipo mixture-of-experts, con 1,05 billones de parámetros totales y 49.000 millones de parámetros activos por token. El anuncio oficial también menciona llamadas a funciones, salidas estructuradas, preguntas y respuestas sobre documentos, procesamiento por lotes, agentes y herramientas integradas.
El modelo también aparece como mistralai/mistral-large-4-0 en OpenRouter, así que el acceso mediante OpenRouter ya no es solo un rumor del día del lanzamiento. Los límites, la latencia, la facturación y las políticas de fallback pueden variar según la ruta.
La API está activa, pero los pesos descargables y la licencia definitiva todavía no. La expresión «open weight» no debe interpretarse como código abierto comercial sin restricciones hasta que Mistral publique la ficha del modelo y las condiciones de uso.
Por qué aparecen dos precios distintos
Las tarifas actuales de la vista previa que aparecen en la documentación del modelo de Mistral resultan atractivas:
| Tipo de token | Tarifa de vista previa | Posible tarifa posterior a la vista previa indicada en los materiales del lanzamiento |
|---|---|---|
| Entrada | 0,68 $ / 1 millón de tokens | 1,36 $ / 1 millón de tokens |
| Entrada en caché | 0,07 $ / 1 millón de tokens | 0,14 $ / 1 millón de tokens |
| Salida | 2,09 $ / 1 millón de tokens | 4,18 $ / 1 millón de tokens |
Las cifras reducidas aparecen como precios de vista previa con un descuento del 50 % en el listado del gateway de Vercel y en otras páginas de acceso al modelo, pero no se indica una fecha de finalización. Considera los 0,68 $ y 2,09 $ como la tarifa actual, no como un precio permanente.
Para una carga de trabajo con 500.000 tokens de entrada sin caché y 100.000 tokens de salida, la factura de la vista previa sería de unos 0,55 $: 0,34 $ por la entrada más 0,209 $ por la salida. Si la entrada está en caché, el coste sería de unos 0,244 $: 0,035 $ por la entrada en caché más 0,209 $ por la salida. Antes de migrar tráfico de producción, analiza el reaprovechamiento de la caché, el volumen de salida y la duración del descuento.
El contexto y las capacidades dependen de la ruta
La documentación del modelo de Mistral describe una ventana de contexto de 1 millón de tokens. Es una característica del modelo, no necesariamente el límite que ofrece cada gateway.
La página de AI Gateway de Vercel muestra actualmente un contexto compartido de 524.000 tokens y una salida máxima de 262.000 para su proveedor de Mistral. También indica un tiempo P50 hasta el primer token de 0,9 segundos, 38 tokens por segundo y una tasa de aciertos de caché del 74 %, calculada a partir del tráfico del gateway.
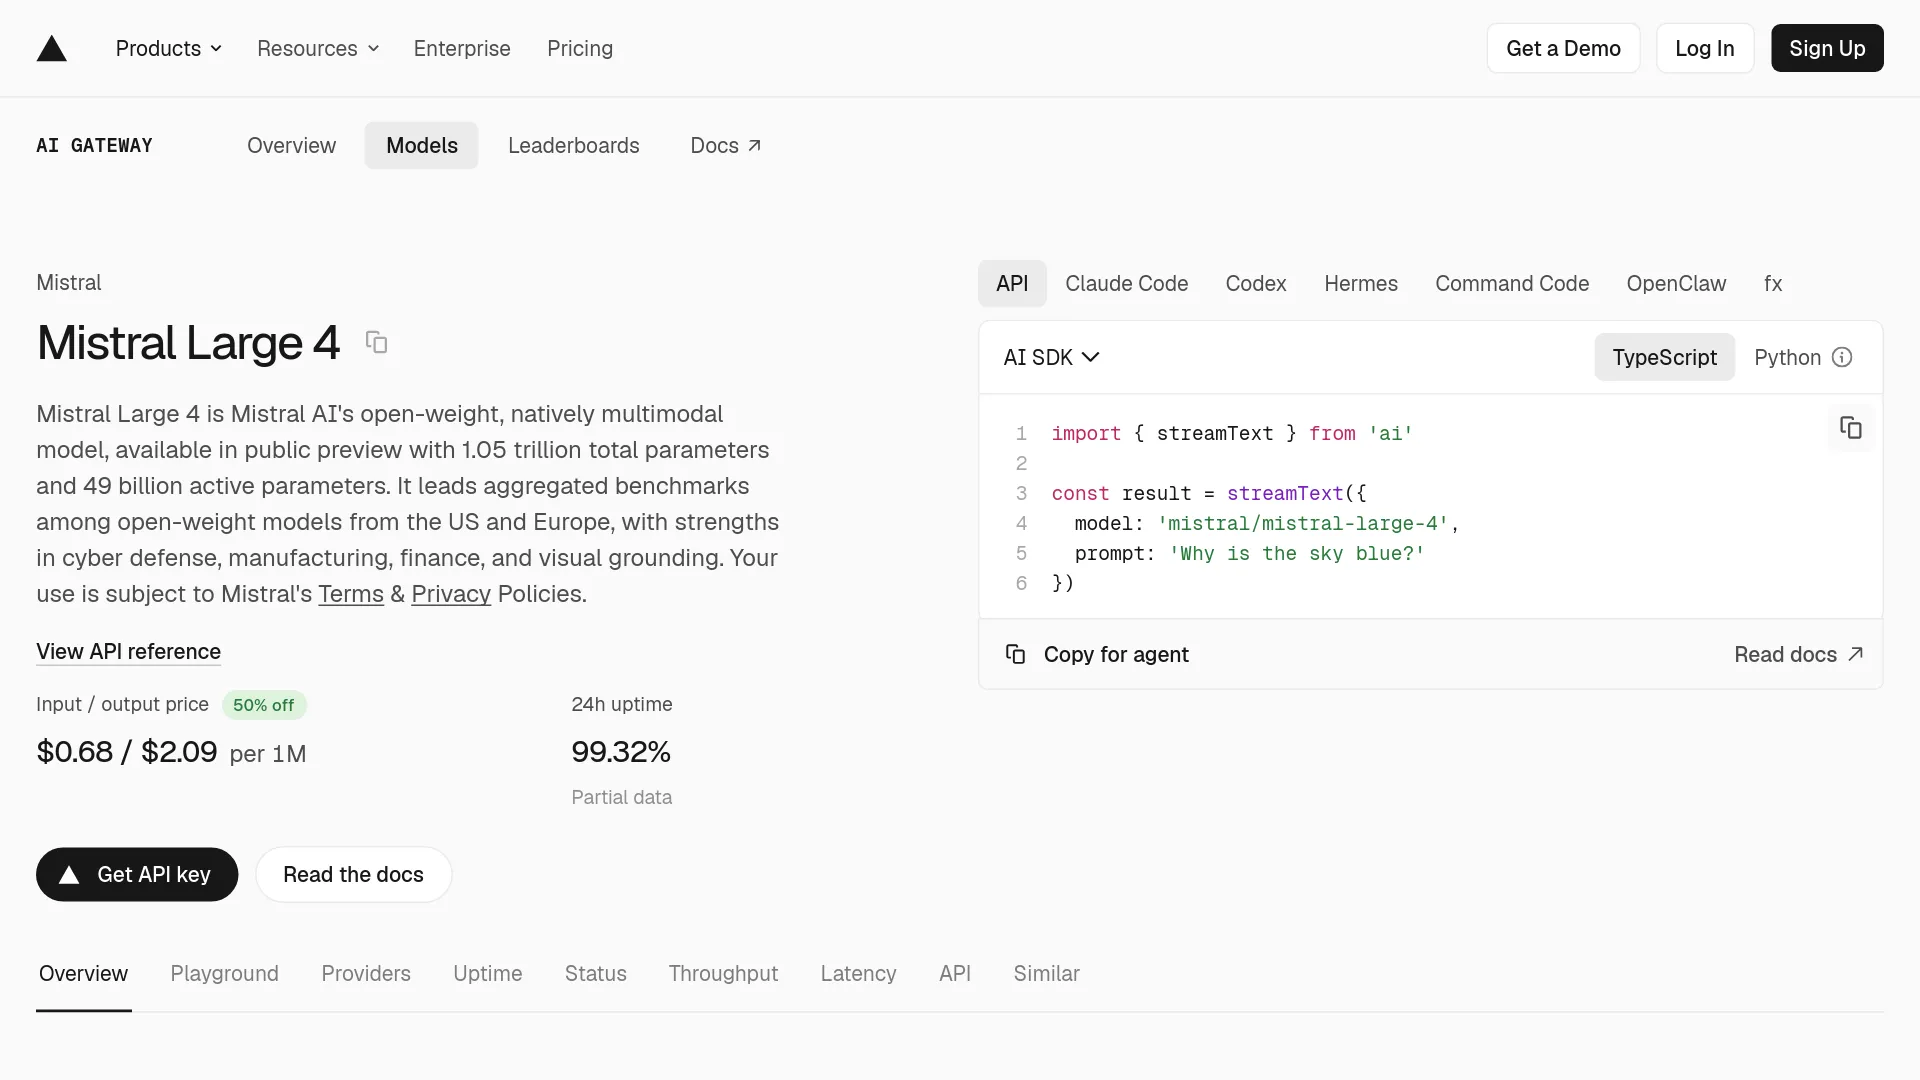
Son cifras específicas de esa ruta, no garantías universales del modelo. La página documenta entrada de imágenes, llamadas a herramientas, APIs Chat Completions y Responses compatibles con OpenAI, y acceso Messages compatible con Anthropic; su identificador de gateway es mistral/mistral-large-4, distinto del identificador cualificado por proveedor de OpenRouter.
Antes de integrar el modelo, verifica el contexto compartido del endpoint, el límite de salida, el recuento de imágenes y tokens, el comportamiento de las herramientas, la política de caché, el enrutamiento entre proveedores y las reglas de fallback. La cifra de 1 millón de tokens sirve para decidir si entra en tu lista corta, pero no basta para dimensionar una aplicación.
Qué conclusiones permiten extraer los benchmarks
El análisis del lanzamiento de TechsCurrent recoge las cifras de Mistral: 61,7 % en DeepSWE v1.1, 28,3 % en Terminal-Bench 4 y 59,9 % en AutomationBench. La comparativa de lanzamiento de CellCog sitúa a DeepSeek V4.1 Flash en 74,2 en DeepSWE y a Mistral Large 4 en 61,7, mientras que la cifra de Mistral en AutomationBench supera a la de las filas comparativas. Son señales comunicadas por el proveedor o recopiladas de distintas fuentes, no resultados de una clasificación estandarizada.
Antes de usar el modelo en agentes de producción, ejecuta una evaluación fija:
- Utiliza el mismo repositorio, prompt, herramientas y tiempo de espera con Mistral Large 4 y el modelo que ya utilizas.
- Mide la finalización de tareas, los errores en los argumentos de las herramientas, los reintentos, la latencia, los tokens de salida y el coste.
- Añade casos de recuperación con contexto largo en los que la respuesta aparezca en la parte central y cerca del final de la entrada.
- Repite la prueba con contexto en caché y sin caché.
- Mantén separados los resultados de la vista previa y los resultados de una futura publicación de los pesos.
Quién debería usarlo ya
Equipos centrados en APIs con mucho contexto recurrente: Prueba Mistral Large 4 ahora. La tarifa de 0,07 $ para entradas en caché puede ser importante cuando un agente envía repetidamente el mismo prefijo de políticas, repositorio o documento. Establece un límite de gasto para el experimento, porque la tarifa más alta sigue siendo una posibilidad real.
Equipos que desarrollan flujos documentales con imágenes: Prueba la entrada de imágenes y la extracción de documentos en la ruta que tengas previsto desplegar. El modelo admite imágenes, pero todavía hay que verificar los límites de archivos y los detalles de facturación específicos de cada ruta.
Equipos que desarrollan agentes de programación: Úsalo como candidato, no como ganador automático. Los benchmarks publicados ofrecen resultados dispares y la fiabilidad real depende de las llamadas a herramientas, los reintentos y la tasa de finalización.
Equipos sensibles a la privacidad o interesados en alojarlo por su cuenta: Espera a que lleguen los pesos y la licencia. La cifra de 49.000 millones de parámetros activos no significa que el checkpoint completo sea pequeño; el modelo total aún debe almacenarse y ejecutarse. El hardware, la cuantización, el rendimiento y los derechos de redistribución siguen sin resolverse.
Preguntas frecuentes sobre la API de Mistral Large 4
¿Mistral Large 4 ya es de código abierto?
No había una licencia definitiva ni pesos descargables en el momento del lanzamiento. Mistral tenía previsto publicar los pesos antes de que terminara octubre de 2026, pero «open weight» por sí solo no define los derechos comerciales ni de redistribución.
¿El precio de 0,68 $ es permanente?
No se indica una fecha de finalización. Presupuesta las pruebas con las tarifas actuales de 0,68 $ para la entrada y 2,09 $ para la salida, y modela también el escenario de 1,36 $ y 4,18 $.
¿La ventana de contexto es de 1 millón o de 524.000 tokens?
Mistral documenta un contexto de modelo de 1 millón de tokens; Vercel indica un contexto compartido de 524.000 para su ruta de gateway. Confirma el límite del proveedor y del formato de API que vayas a utilizar.
¿Ya está disponible en OpenRouter?
Sí, OpenRouter muestra actualmente mistralai/mistral-large-4-0. Comprueba la página activa antes de desplegarlo, porque el enrutamiento de una vista previa puede cambiar.
¿Puede trabajar con imágenes y herramientas?
La documentación oficial y la del gateway describen la entrada de imágenes y las llamadas a herramientas. Prueba el formato de las solicitudes, los límites de imagen, el recuento de tokens y el comportamiento ante llamadas a herramientas mal formadas en la ruta que elijas.
¿Debería alojarlo por mi cuenta cuando lleguen los pesos?
No automáticamente. Espera a conocer la licencia, los formatos de los checkpoints, las opciones de cuantización, los requisitos de memoria, los datos de rendimiento y una configuración de servicio de referencia.
La siguiente prueba que deberías ejecutar
Prepara una evaluación de 20 tareas antes de enviar tráfico real: cinco tareas de recuperación con contexto largo, cinco cambios de código, cinco preguntas sobre imágenes o documentos y cinco tareas de llamadas a herramientas. Registra la tasa de éxito, los reintentos, el tiempo hasta el primer token, la latencia total, los tokens de entrada, caché y salida, y el coste efectivo por tarea completada.
Fuentes: documentación del modelo de Mistral, anuncio de Mistral, Vercel AI Gateway, página del modelo en OpenRouter, TechsCurrent, CellCog.