 AIREITER
Liquid AI LFM3 reúne texto, visión, audio e interacción omni en seis modelos de alrededor de 2.000 millones de parámetros, pero la propia página de precios de Liquid todavía no muestra una tarifa para LFM3 a fecha de 27 de octubre de 2026. Esa ausencia es clave: por ahora, LFM3 parece más un lanzamiento para descargar y alojar por cuenta propia que una familia de especialistas económicos accesibles desde la nube.
LFM3, en resumen: seis especialistas 2B y ninguna tarifa de API por ahora
LFM3 es la familia de modelos fundacionales de tercera generación de Liquid AI para inteligencia especializada en dispositivos, no un único checkpoint. Todos comparten la base LFM3-1.7B-Base, preentrenada con 22 billones de tokens, y la familia incluye seis versiones: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B y d1-Omni-2B (anuncio).
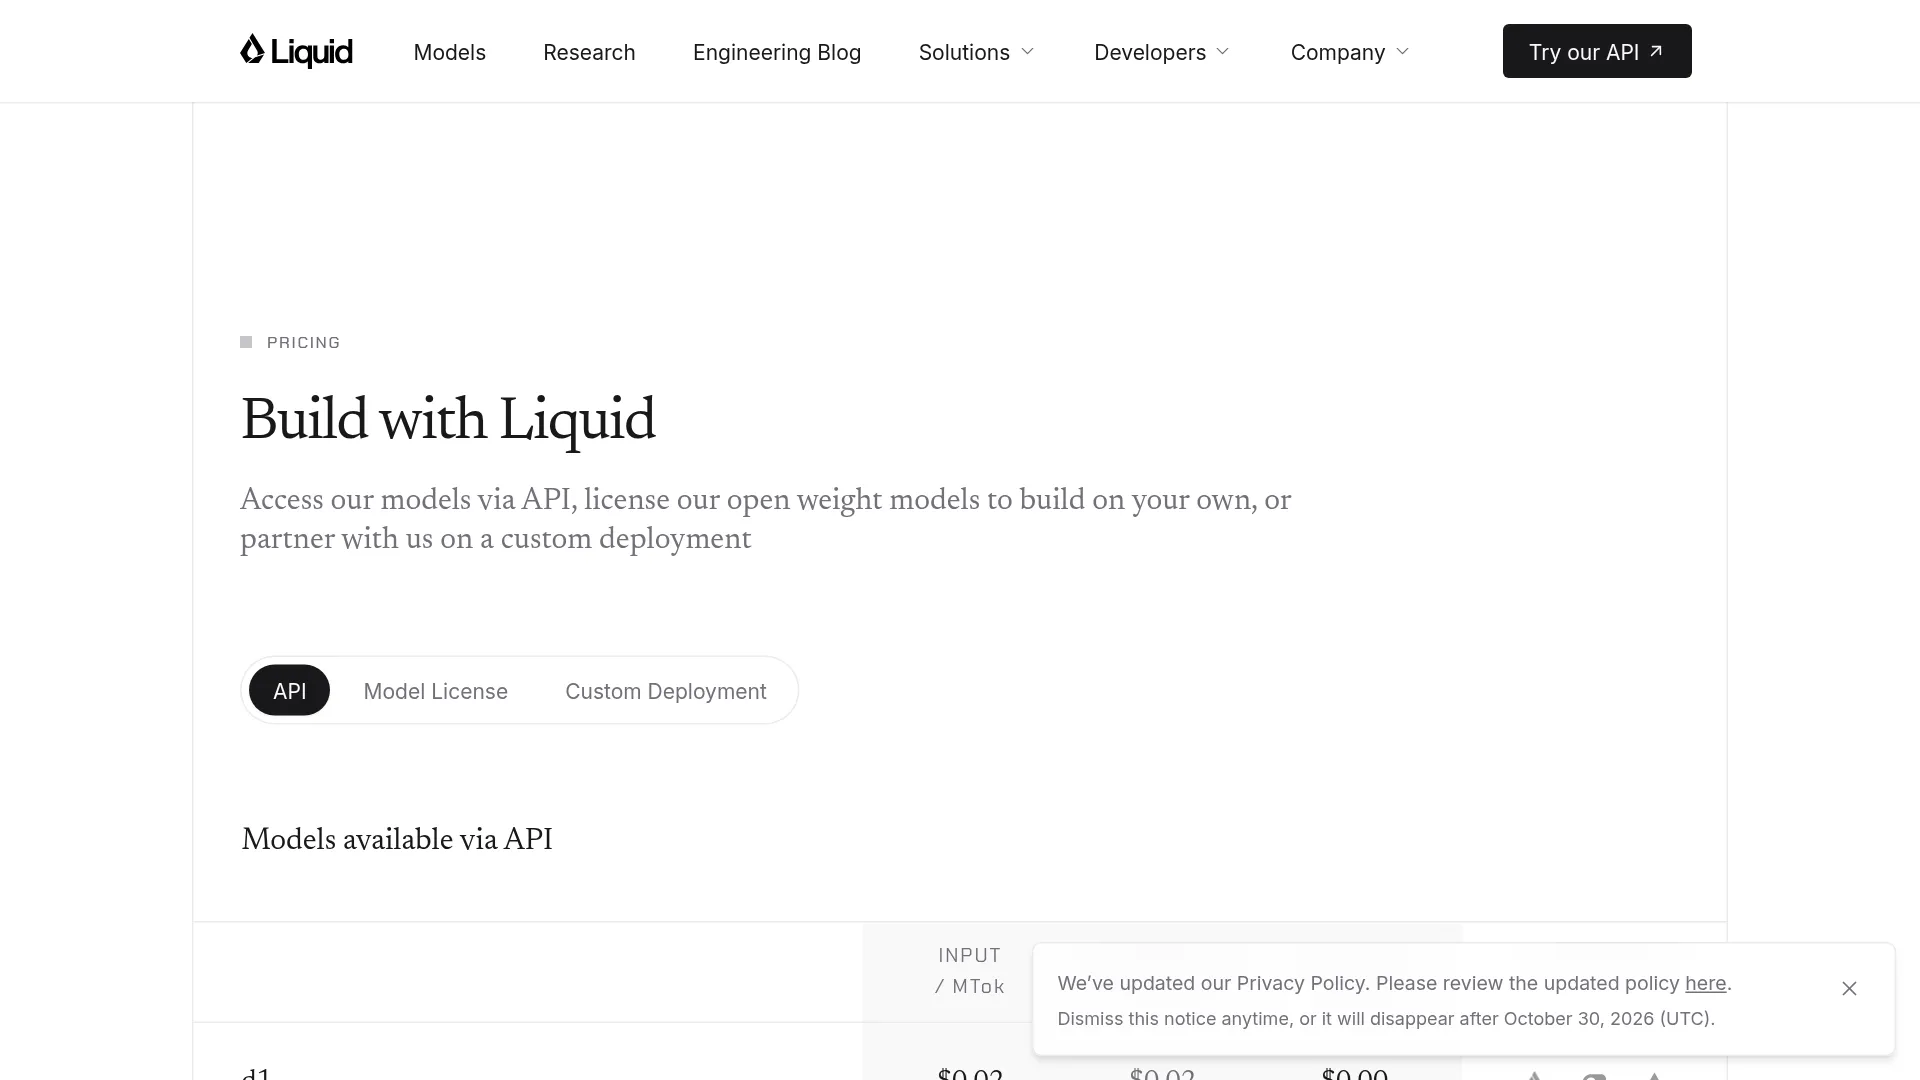
Comprobé la página de precios de Liquid AI el 27 de octubre: no aparece ninguna entrada para LFM3; solo figuran las tarifas de d1, d1-ultra y LFM2.5 que se muestran más abajo. El anuncio de LFM3 indica que los pesos están disponibles a través de Hugging Face, Liquid Playground y Liquid API, aunque hoy solo se pueden comprobar directamente los dos primeros. Las organizaciones nuevas siguen recibiendo $2 de crédito gratuito en Liquid Console (precios).
Los seis modelos de LFM3 y para qué sirve cada uno
Los seis checkpoints de LFM3 comparten la misma base, pero aceptan entradas distintas y generan salidas diferentes.
| Modelo | Tamaño aprox. | Entradas | Salidas | Úsalo para |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | Texto | Texto | Agentes locales, llamadas a herramientas y salidas estructuradas |
| LFM3-VL-2B | 1.9B | Texto, imágenes y vídeo | Texto | Comprensión de imágenes y vídeo, agentes visuales |
| LFM3-Audio-2B | 2B | Texto y audio | Texto y voz | Chat de voz, reconocimiento, síntesis y traducción en 18 idiomas |
| LFM3-Omni-2B | 2B | Texto, imágenes, vídeo y audio | Texto y voz | Asistente multimodal unificado |
| d1-2B | 2B | Texto, imágenes y vídeo | Respuestas calibradas | Clasificación, extracción y decisiones en una sola pasada |
| d1-Omni-2B | 2B | Texto, imágenes, vídeo y audio | Respuestas calibradas | Detección multimodal con puntuaciones de confianza |
LFM3-1.7B ofrece una ventana de contexto de 256K tokens y una arquitectura tri-híbrida de 24 capas: 13 capas de convolución corta con compuertas, 5 capas de atención con ventana deslizante de 256 tokens y 6 capas de atención global (anuncio). La última fase de entrenamiento intermedio, con 3,5 billones de tokens, incorporó trayectorias de agentes y llamadas a herramientas. De ahí que Liquid oriente el modelo de texto a entornos como Hermes Agent, Pi y harnesses del estilo de OpenClaw (anuncio). LFM3-VL-2B es el primer modelo de visión de Liquid con entrada de vídeo, mientras que LFM3-Omni-2B es su primer modelo omni-modal capaz de procesar a la vez la banda sonora y los fotogramas (anuncio).
Los modelos de decisión funcionan de otra manera. d1-2B y d1-Omni-2B no generan texto de forma autorregresiva: devuelven respuestas calibradas con sus probabilidades en una única pasada hacia delante (anuncio). La latencia de decisión declarada por el fabricante es de 5.7 ms en una NVIDIA H100 y 3.8 ms en una AMD MI325X para d1-2B. En d1-Omni-2B sube a 12.4 ms y 8.2 ms, respectivamente, con un clip de audio de 10 segundos (anuncio).
Qué afirma Liquid y qué se puede comprobar de forma independiente
Las cifras de rendimiento de Liquid AI proceden del propio fabricante; conviene tratarlas como afirmaciones de la compañía hasta que aparezcan pruebas independientes. Todos los datos siguientes proceden de el anuncio de Liquid.
| Modelo | Métrica declarada por el fabricante | Cifra de LFM3 | Cifra anterior / rival |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02 (LFM2.5-2.6B) |
| LFM3-1.7B | Tamaño / velocidad | 35% menos parámetros, ~25% más rápido por parámetro a 8K frente a LFM2-1.2B | — |
| LFM3-VL-2B | Media de visión 62 / encoder | 71.4 de media; encoder de 164M con 2.2x menos FLOPs | 57.6 de media; se afirma paridad del encoder con Qwen3.5-2B |
| LFM3-Audio-2B | UTMOSv2 / latencia | 3.83; 50 ms hasta el primer token; 87x tiempo real en la CPU del M4 Max | 3.22 (LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0 (d1-3B) |
Lo que sí pude verificar directamente: la colección LiquidAI LFM3 en Hugging Face incluye las seis versiones, junto con variantes cuantizadas, MLX y ONNX, y el catálogo de LM Studio ya muestra variantes de LFM3 para escritorio. Conviene interpretar las puntuaciones como una señal, no como una garantía. Las medias agregadas esconden el rendimiento concreto en OCR, grounding y vídeo, y la cifra de 1 GB en 4 bits no incluye la caché KV ni la sobrecarga de la aplicación.
«Es una locura lo rápido que se pueden hacer cosas hoy en día». — @Nklockiewicz, ejecutando LFM3 en un iPhone en modo avión mediante MLX/ExecuTorch a 40 tok/s (fuente)
«Normalmente rinden por encima de lo que cabría esperar por su velocidad e inteligencia, pero por mi experiencia todavía no son lo bastante inteligentes para el “trabajo real”». — u/spaceman_, r/LocalLLaMA (fuente)
El límite de $10M de la licencia que debes revisar antes de lanzar nada
La licencia de pesos abiertos de Liquid AI es gratuita hasta que los ingresos anuales de la empresa superan los $10 millones (precios). Los desarrolladores, investigadores, organizaciones sin ánimo de lucro y empresas con menos de $10M de ingresos anuales pueden descargar, ejecutar, ajustar y distribuir en producción cualquier LFM abierto, mantener privados sus fine-tunings y desplegar los modelos en móviles, dispositivos edge o infraestructura local sin obligación de usar copyleft (precios).
Las empresas que superen los $10M necesitan una licencia empresarial de pago, cuyo precio depende de la escala del despliegue y se negocia con el equipo comercial. El uso en investigación, educación y organizaciones sin ánimo de lucro sigue siendo gratuito y no está sujeto a un límite de ingresos (precios). La LFM Open License deja de ofrecer la concesión comercial gratuita al alcanzar ese umbral; antes de integrar los pesos en una aplicación comercial, conviene confirmar con asesoría legal las condiciones de atribución, redistribución y exportación.
Ejecutarlo en local: qué implica realmente esa cifra de 1 GB
LFM3-1.7B necesita alrededor de 1 GB en formato de 4 bits, pero esa cifra solo cubre los pesos (anuncio). El proceso también carga el runtime, la caché KV para contextos largos y cualquier encoder de visión o audio. Por tanto, hay que reservar RAM adicional, especialmente con las versiones VL y Omni al procesar fotogramas de vídeo o clips de audio.
Lo más sensato es empezar con LFM3-1.7B y pasar a VL, Audio u Omni solo cuando sea necesario. Antes de medir el rendimiento, revisa también las dependencias adicionales de la ficha de cada modelo. Las opciones con Ollama, LM Studio, llama.cpp, MLX y ONNX aparecen para LFM3 en la colección de Hugging Face y el catálogo de LM Studio.
Si el ejemplo de una ficha requiere trust_remote_code=True, fija un hash de commit, revisa el código del repositorio o haz la primera ejecución en un entorno aislado: esa opción ejecuta código incluido en el repositorio. Liquid habla de 18 idiomas de audio en su anuncio, pero allí no publica una tabla de calidad por idioma. Comprueba, por tanto, el rendimiento en otros idiomas con tus propios datos.
Acceso a la API ahora mismo: dónde usarlo y cómo se factura
Liquid ha anunciado el acceso a la API de LFM3, pero todavía no le asigna un precio independiente en su página pública. Las llamadas pasan por Liquid Console, OpenRouter y Vercel AI Gateway (precios).
| Modelo de API listado el 27 de octubre | Entrada / MTok | Entrada en caché / MTok | Salida / MTok |
|---|---|---|---|
| d1 | $0.02 | $0.02 | $0.00 |
| d1-ultra | $0.042 | $0.042 | $0.00 |
| LFM2.5-24B-A2B | $0.05 | $0.025 | $0.70 |
| Tarifas de texto de LFM3-1.7B / VL / Audio / Omni | No figura | No figura | No figura |
Por ahora, esa ausencia es la respuesta sobre el precio: calcula LFM3 como computación autoalojada más tiempo de ingeniería, no como una línea de coste por token. Si un proveedor ofrece hoy tokens de LFM3, compáralos con las referencias publicadas de d1 y LFM2.5 y confirma si actúa como proxy de Liquid Console o si sirve sus propios pesos. La tarifa publicada de d1, con $0.00 por millón de tokens de salida, puede resultar atractiva para pipelines de inspección de gran volumen.
Preguntas frecuentes sobre LFM3
¿Cuánto cuesta la API de LFM3?
Liquid AI no muestra un precio independiente por token para LFM3 a fecha de 27 de octubre de 2026; la página pública solo incluye las tarifas de d1, d1-ultra y LFM2.5-24B-A2B.
¿LFM3 es gratuito para uso comercial?
La producción comercial es gratuita para empresas con menos de $10M de ingresos anuales bajo la LFM Open License; las empresas más grandes necesitan una licencia empresarial de pago.
¿Puede LFM3 ejecutarse en un móvil o portátil?
Sí, en el caso de la versión de texto, con unos 1 GB en 4 bits más la sobrecarga del runtime. Hay opciones con Ollama, LM Studio, llama.cpp, MLX y ONNX; las versiones VL, Audio y Omni necesitan más memoria para los encoders y el contenido multimedia.
¿Es LFM3 mejor que Qwen o Gemma para agentes edge?
No encontré ninguna comparación independiente entre los resultados de lanzamiento que revisé. Las supuestas victorias de Liquid frente a Qwen3.5-2B y Qwen2.5-Omni-7B proceden del propio fabricante (anuncio), así que prueba LFM3 frente a Gemma y Qwen en tu propio harness antes de cambiar.
¿Puedo hacer fine-tuning de LFM3 con una sola GPU?
Liquid ofrece notebooks para SFT, DPO, GRPO y preentrenamiento continuado, y afirma que todos los modelos pueden ajustarse con una sola GPU (anuncio), aunque no publica requisitos de VRAM ni de tamaño del conjunto de datos.
¿Especialista privado y económico o generalista pequeño que necesita tu propio harness?
LFM3 tiene sentido cuando los datos deben permanecer en el dispositivo, el contenido multimedia no puede salir del entorno local o el volumen de decisiones hace que la factura por tokens en la nube resulte demasiado cara. Se queda corto en conocimiento general, razonamiento creativo prolongado o calidad lista para usar sin ajustar el harness. Descarga una variante, mídela con tus prompts y tu hardware, y deja que ese resultado —no la gráfica de lanzamiento— decida.