 AIREITER
El 19 de agosto de 2026, Liquid AI añadió un segundo archivo Q4_0 de 1,59 GB junto al anterior en el repositorio de LFM2.5-2.6B. Pesan lo mismo, sus nombres apenas se distinguen y, sin embargo, no son el mismo modelo. El nuevo incorpora QAD, o quantization-aware distillation, una técnica que recupera buena parte de la calidad que suele perderse al cuantizar a 4 bits. Si descargas el archivo equivocado, estarás ejecutando la versión sin este ajuste.
Qué aporta QAD a la cuantización
QAD significa quantization-aware distillation. Liquid AI entrenó cuatro modelos —LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct y LFM2.5-2.6B— para convivir con el redondeo de Q4_0. Durante el entrenamiento, un modelo profesor de alta precisión destila conocimiento en el estudiante cuantizado, de modo que los pesos anticipan el error de cuantización y se adaptan a él.
Los archivos Q4_0 antiguos que siguen en esos repositorios usan cuantización posterior al entrenamiento, o PTQ: primero se termina el modelo BF16 y después se redondean sus pesos, sin ningún mecanismo que compense el error. Según la publicación de lanzamiento de Liquid AI, los cuatro checkpoints QAD «alcanzan aproximadamente el 97% de sus medias en BF16» en una batería que cubre razonamiento, seguimiento de instrucciones, uso de herramientas y comportamiento agéntico; el resultado es la media de cinco ejecuciones. QAD no introduce un formato de archivo nuevo: sigue siendo un GGUF Q4_0 estándar, compatible con llama.cpp.
Dos archivos casi iguales: cómo descargar el correcto
El repositorio LFM2.5-2.6B incluye tanto LFM2.5-2.6B-Q4_0.gguf como LFM2.5-2.6B-QAD-Q4_0.gguf, ambos listados con 1,59 GB. Los fragmentos predeterminados del repositorio apuntan a Q4_K_M, no a QAD; copiar y pegar la instalación no descarga ninguno de los dos Q4_0. Hay que indicar el nombre del archivo de forma explícita.
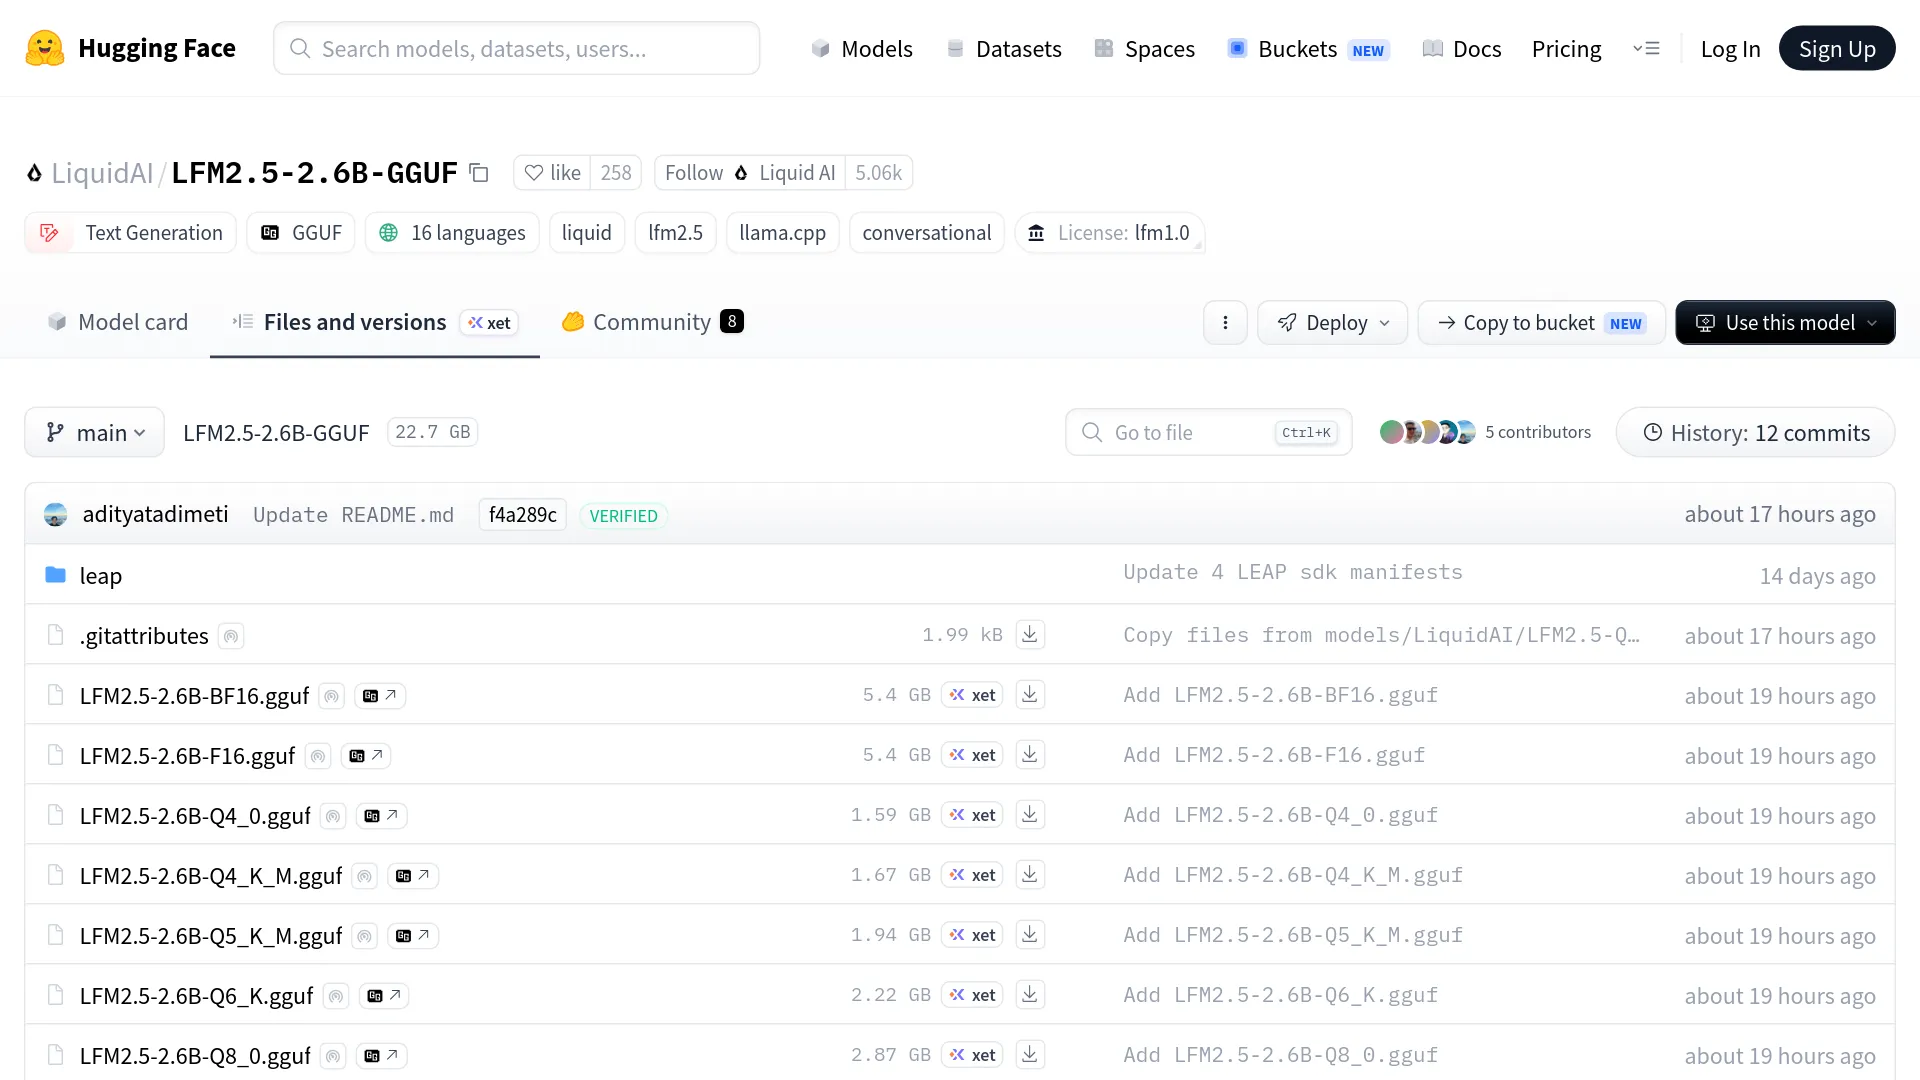
La confusión apareció a las pocas horas del lanzamiento:
«¿Dónde se descarga? Lo veo en Hugging Face, pero no sé si es la versión normal o QAD. ¿Podrías indicarme cómo hacerlo?» - @Chitacc72 en X
Uno de los primeros usuarios, @MarMarLabs, comparó los archivos del repositorio y comprobó que las compilaciones Q4_0 antigua y nueva difieren en unos 4 KB: una diferencia imposible de detectar en un explorador de archivos. La solución consiste en apuntar --hf-file al nombre exacto del archivo QAD:
# official example from Liquid AI's release post
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B, with the sampling flags from the official model card
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
El mismo patrón con --hf-file sirve para los repositorios de 230M y 1.2B-Instruct. Para uso en servidor, @nicolasembleton compartió una forma abreviada funcional tras descubrir que los comandos generados por HF estaban incompletos: llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0. El calificativo tras los dos puntos es lo que selecciona la compilación QAD.
Qué dicen las cifras oficiales y qué no revelan
La tabla de benchmarks de Liquid AI sitúa la retención de cada checkpoint QAD entre el 96,5% y el 97,4% respecto a su referencia BF16. La batería incluye GPQA Diamond, MMLU-Pro, IFEval, IFBench, Multi-IF y BFCLv4, además de GSM8K para los dos modelos pequeños y AIME25 para los dos mayores. Los resultados son promedios de cinco ejecuciones.
| Checkpoint | Calidad BF16 conservada | Comparativa de calidad | Rendimiento de decodificación |
|---|---|---|---|
| LFM2.5-230M | 97,1% | iguala a Q5_K_M dentro de la variabilidad | +4–33% frente a Q5_K_M |
| LFM2.5-350M | 96,5% | iguala a Q5_K_M dentro de la variabilidad | +4–33% frente a Q5_K_M |
| LFM2.5-1.2B-Instruct | 97,4% | iguala a Q4_K_M | +3–14% frente a Q4_K_M |
| LFM2.5-2.6B | 96,6% | iguala a Q4_K_M | +3–14% frente a Q4_K_M |
El rendimiento se midió en cuatro equipos: MacBook Pro y NucBox EVO-X2 usando GPU, además de Samsung Galaxy S26 Ultra y Raspberry Pi 5 con CPU Arm. Para los modelos 230M y 1.2B, Liquid AI también afirma que QAD Q4_0 iguala a UD-Q4_K_XL de Unsloth, un checkpoint PTQ externo que la publicación describe como sólido.
La publicación no ofrece puntuaciones por benchmark, tokens por segundo sin procesar para cada dispositivo, tamaños de archivo, cifras de RAM ni barras de variabilidad. Todo se expresa como intervalos porcentuales y afirmaciones de paridad. La comunidad hizo enseguida las cuentas de tamaño:
«¿Entonces puedo cambiar mi LFM2.5-2.6B local de F16 a QAD Q4_0 y pasar de 5,4 GB a 1,6 GB, de 21 a 64 tok/s… manteniendo alrededor del 97% del rendimiento de BF16?» - @firedUp_Neyu, al interpretar los gráficos de lanzamiento de Liquid
La parte relativa al tamaño sí cuadra: F16 ocupa 5,4 GB y QAD Q4_0, 1,59 GB en el repositorio oficial. Los valores de tok/s son su interpretación de los gráficos, no cifras que Liquid AI haya publicado en texto.
Las incógnitas que deja el lanzamiento
Hay tres ausencias relevantes si estás valorando redeplegar estos archivos.
La cobertura se limita a cuatro checkpoints. A fecha de lanzamiento, no hay compilaciones QAD para LFM2.5-VL-450M ni LFM2.5-8B-A1B, y en el hilo de lanzamiento en X varios usuarios pidieron a Liquid AI una versión de 8B. Si tu dispositivo apunta a uno de esos modelos, QAD no cambia nada por ahora.
La cuestión de imatrix sigue sin respuesta. Los archivos QAD se entrenaron para Q4_0, pero se generaron sin matriz de importancia, algo que quienes siguen de cerca la cuantización señalaron inmediatamente:
«El GGUF QAD Q4_0 se creó sin una imatrix, que también habría ayudado a la calidad de los modelos entrenados con QAD.» - u/Chromix_, r/LocalLLaMA
Un modelo de menos de 3B sigue siendo un modelo de menos de 3B. Recuperar calidad por cuantización no eleva su techo de capacidad, y el hilo de LocalLLaMA deja ejemplos claros. Un usuario de NPU comentaba:
«Acabo de implementar LFM2.5 2.6B en mi NPU para resumir reuniones y, aunque impresiona para su tamaño, los resúmenes son mucho peores que los de modelos más grandes.» - u/DerDave
Ese límite pertenece al modelo, no a la cuantización: el informe de cuantización de KikoCis registró 0 de 6 instancias resueltas en SWE-bench Verified con Q8_0. Los usuarios de 1.2B también informan de resultados muy dependientes del runtime: texto ininteligible en 9 de 10 prompts con una configuración de Ollama, pero funcionamiento productivo por debajo de 5W en un ordenador monoplaca en otro caso. Si la calidad de frontera importa para una tarea concreta, contrastar la salida local con un modelo grande mediante una API de LLM de bajo coste cuesta céntimos para un conjunto de pruebas completo.
QAD Q4_0 frente a Q4_K_M: cuál conviene descargar
En despliegues con llama.cpp y RAM ajustada para estos cuatro checkpoints, QAD Q4_0 es la opción de 4 bits respaldada por el proveedor que conviene probar primero. Mantiene los mismos 1,59 GB que Q4_0 estándar y está entrenada para igualar la calidad de Q4_K_M en 1.2B y 2.6B, o de Q5_K_M en 230M y 350M, con una decodificación respectivamente entre un 3–14% y un 4–33% más rápida. Si ya utilizas Q4_K_M y tienes RAM de sobra, no hace falta cambiar: 80 MB no son el problema que intentas resolver.
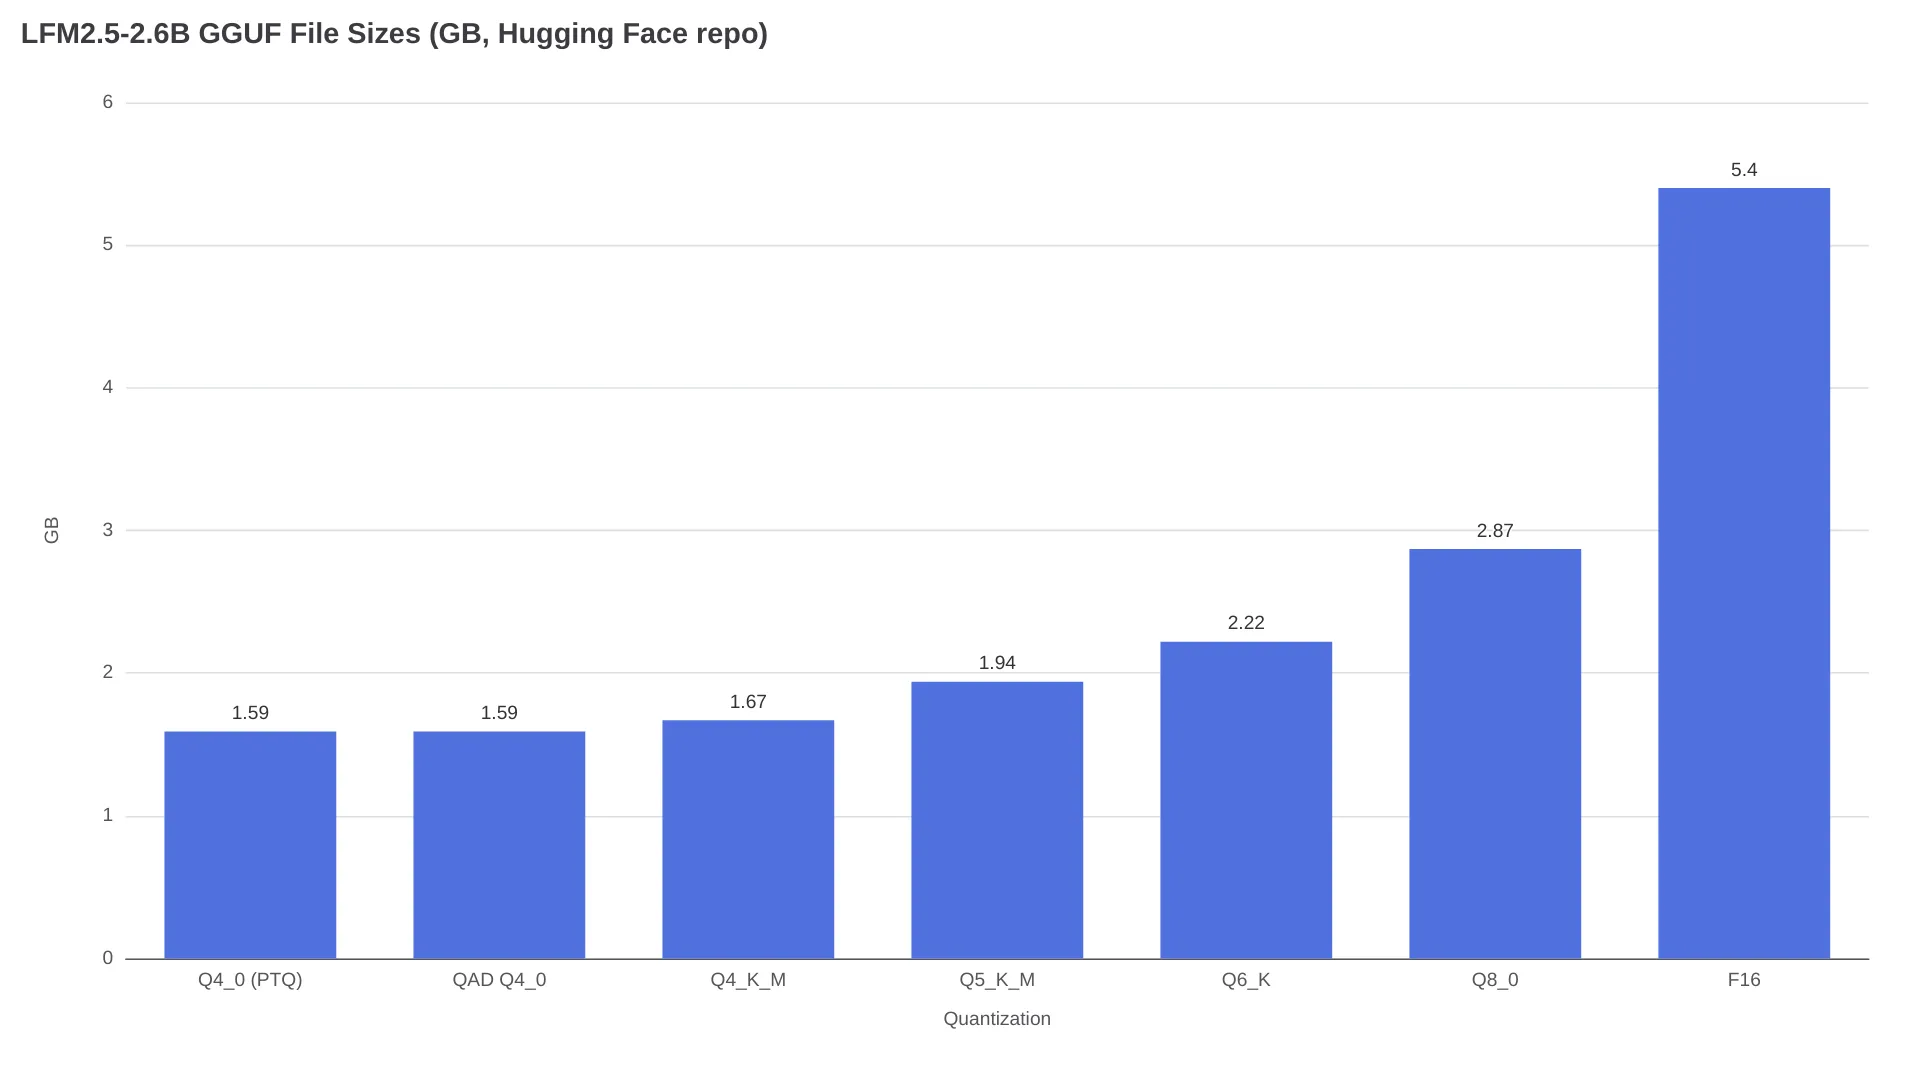
| Archivo (2.6B) | Tamaño | Posicionamiento | Elígelo si |
|---|---|---|---|
| Q4_0 (PTQ antiguo) | 1,59 GB | referencia sin ajuste | sáltatelo; ahora existe QAD |
| QAD Q4_0 | 1,59 GB | 96,6% de BF16, iguala a Q4_K_M | tienes 3–4 GB de RAM, decodificas en CPU o usas móviles o Pi |
| Q4_K_M | 1,67 GB | opción predeterminada en la documentación de Liquid | tu runtime no puede seleccionar el archivo QAD |
| Q5_K_M | 1,94 GB | 91,4% de top-1 frente a F16, según KikoCis | dispones de 6 GB o más de RAM |
| Q6_K / Q8_0 | 2,22 / 2,87 GB | casi sin pérdida | priorizas calidad y tienes 8 GB o más |
Para poner en contexto esas afirmaciones de paridad, la escala PTQ de KikoCis midió un acuerdo de token top-1 del 84,36% para Q4_K_M frente a F16 en este modelo, frente al 95,07% de Q6_K y el 98,23% de Q8_0. Liquid sostiene que QAD cierra la brecha de fidelidad a 4 bits con el mismo tamaño en bytes. Son sus propios datos, basados en cinco ejecuciones y aún sin replicación independiente. Una puntualización de la conversación del día de lanzamiento:
«Esto no significa que “Q4_0 supere a las cuantizaciones K”. Significa que estos cuatro checkpoints se entrenaron para Q4_0.» - @MarMarLabs
No extrapoles esta ventaja. Los archivos Q4_0 de otros modelos siguen siendo PTQ convencional.
Sobre la memoria, la publicación de lanzamiento no proporciona cifras de RAM, así que hay que recurrir a los cálculos del repositorio de KikoCis: la caché KV de 2.6B consume unos 16 KB por token en f16, aproximadamente 0,54 GB con 32K de contexto y 2,15 GB en la ventana nativa de 128K. Con --cache-type-k q8_0 --cache-type-v q8_0, ese consumo se reduce a la mitad. Los pesos de QAD Q4_0, con 1,59 GB, más una ventana de 32K suman cerca de 2,13 GB antes de la sobrecarga del runtime; a 128K superan los 3,7 GB. Considera 4 GB como una cifra ajustada y verifica la asignación en tu runtime objetivo.
Preguntas frecuentes
¿QAD Q4_0 es mejor que Q4_K_M?
Para estos cuatro checkpoints, las cifras de Liquid AI indican que QAD Q4_0 iguala la calidad de Q4_K_M —o la de Q5_K_M en los dos modelos más pequeños— con mayor velocidad de decodificación y un archivo más pequeño. Así que, con RAM limitada, sí. Son mediciones del proveedor, con cinco repeticiones y sin replicación independiente todavía.
¿Ollama o LM Studio detectan el archivo QAD automáticamente?
No. La vía documentada para Ollama es ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M, según la página oficial del repositorio, y los fragmentos predeterminados de Hugging Face también apuntan a Q4_K_M. Cualquier runtime compatible con GGUF puede cargar el archivo QAD, pero debes seleccionarlo mediante el nombre de archivo explícito o el calificativo :QAD-Q4_0.
¿Cuánta RAM necesita LFM2.5-2.6B QAD Q4_0?
Los pesos ocupan 1,59 GB. Los cálculos de KikoCis sitúan la caché KV f16 en alrededor de 0,54 GB para 32K de contexto y unos 2,15 GB para 128K. La suma de pesos y caché queda cerca de 2,13 GB a 32K y de 3,74 GB a 128K antes de la sobrecarga del runtime; la cuantización Q8_0 de la caché KV reduce a la mitad su coste.
¿Qué modelos LFM2.5 tienen checkpoints QAD?
Solo LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct y LFM2.5-2.6B a fecha de 19 de agosto de 2026. Las variantes VL-450M y 8B-A1B no tienen ninguno, aunque usuarios han pedido a Liquid AI una compilación QAD de 8B en el hilo de lanzamiento.
¿Puedo usar comercialmente los checkpoints QAD de LFM2.5?
Los repositorios están etiquetados con LFM Open License v1.0. Los repositorios de la comunidad resumen los términos indicando que permiten el uso comercial a entidades con ingresos anuales inferiores a 10M USD; a partir de ese umbral se requiere una licencia comercial independiente de Liquid AI (resumen de KikoCis). Lee el texto de la licencia antes de lanzar un producto.
¿La afirmación del 97% está verificada de forma independiente?
Todavía no. Las cifras de retención del 96,5–97,4% son medias de cinco ejecuciones publicadas por Liquid AI junto al lanzamiento. Cuando se escribió este artículo, no había aparecido ningún benchmark externo de los archivos QAD, y la cuestión de imatrix seguía abierta en r/LocalLLaMA.
Haz tu propio A/B esta noche
Lo que importa es la tasa de errores de tu tarea, no la media de un benchmark. Reúne diez prompts reales —JSON de llamadas a herramientas, tu esquema de extracción, tu idioma— y ejecuta ambos archivos con los mismos ajustes:
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
Cuenta los fallos de parseo y las selecciones incorrectas de herramientas de cada archivo; no te quedes con sensaciones. La disyuntiva pendiente es real: sobre el papel, los promedios de calidad por gigabyte favorecen a QAD Q4_0, pero los modos de fallo de tu despliegue —respuestas vacías cuando el razonamiento consume el presupuesto de tokens o desviaciones de formato con cierta temperatura— dependen del runtime y de la tarea. Solo tus propios diez prompts pueden ponerles precio.