 AIREITER
¿Puede la mayoría de los desarrolladores usar hoy GPT-6 Cyber? No. Según la documentación de OpenAI, los benchmarks de proveedores y los informes de usuarios, GPT-6 Cyber es un potente especialista en explotación de vulnerabilidades, pero está bloqueado tras la aprobación de Daybreak Red. Para la mayoría del trabajo defensivo, GPT-6 Astra cubre las necesidades principales por la mitad de precio.
Lanzado el 5 de noviembre de 2026 como gpt-6-cyber, es una versión de GPT-6 Astra ajustada específicamente para descubrir vulnerabilidades de forma autorizada, validar exploits y desarrollar parches. El acceso está restringido a Daybreak Red, según Kingy y la línea de modelos de BenchLM.
¿Red o Blue? La respuesta rápida para elegir acceso
La elección entre Daybreak Red y Blue depende del trabajo que quieras realizar, no solo de la cuenta. Daybreak Blue está pensado para tareas defensivas con los modelos principales, mientras que Daybreak Red cubre el trabajo ofensivo autorizado y el propio modelo gpt-6-cyber.
| Tu trabajo | Nivel que debes solicitar | Modelo que debes usar | Qué cambia |
|---|---|---|---|
| Revisión de código seguro, análisis de malware, respuesta a incidentes y validación de parches | Daybreak Blue | gpt-6-sol, gpt-6-luna, gpt-5.6-sol | Menos rechazos que con el acceso estándar, pero sin permisos para desarrollar exploits |
| Pentesting autorizado, red teaming y validación de exploits a escala | Daybreak Red | gpt-6-cyber (+ gpt-5.5-cyber, gpt-5.6-cyber) | Aprobación independiente, valor de solicitud daybreak_red, lista de IP permitidas y SSO/MFA |
| Programación general con revisiones de seguridad ocasionales | Estándar o Blue | gpt-6-sol, gpt-6.1-sol | No pagues el sobrecoste de Cyber |
| Investigación sobre objetivos reforzados o zero-days con exigencias de reproducibilidad | Daybreak Red (si cumples los requisitos) | gpt-6-cyber | Reserva presupuesto para revisión humana y sandboxing |
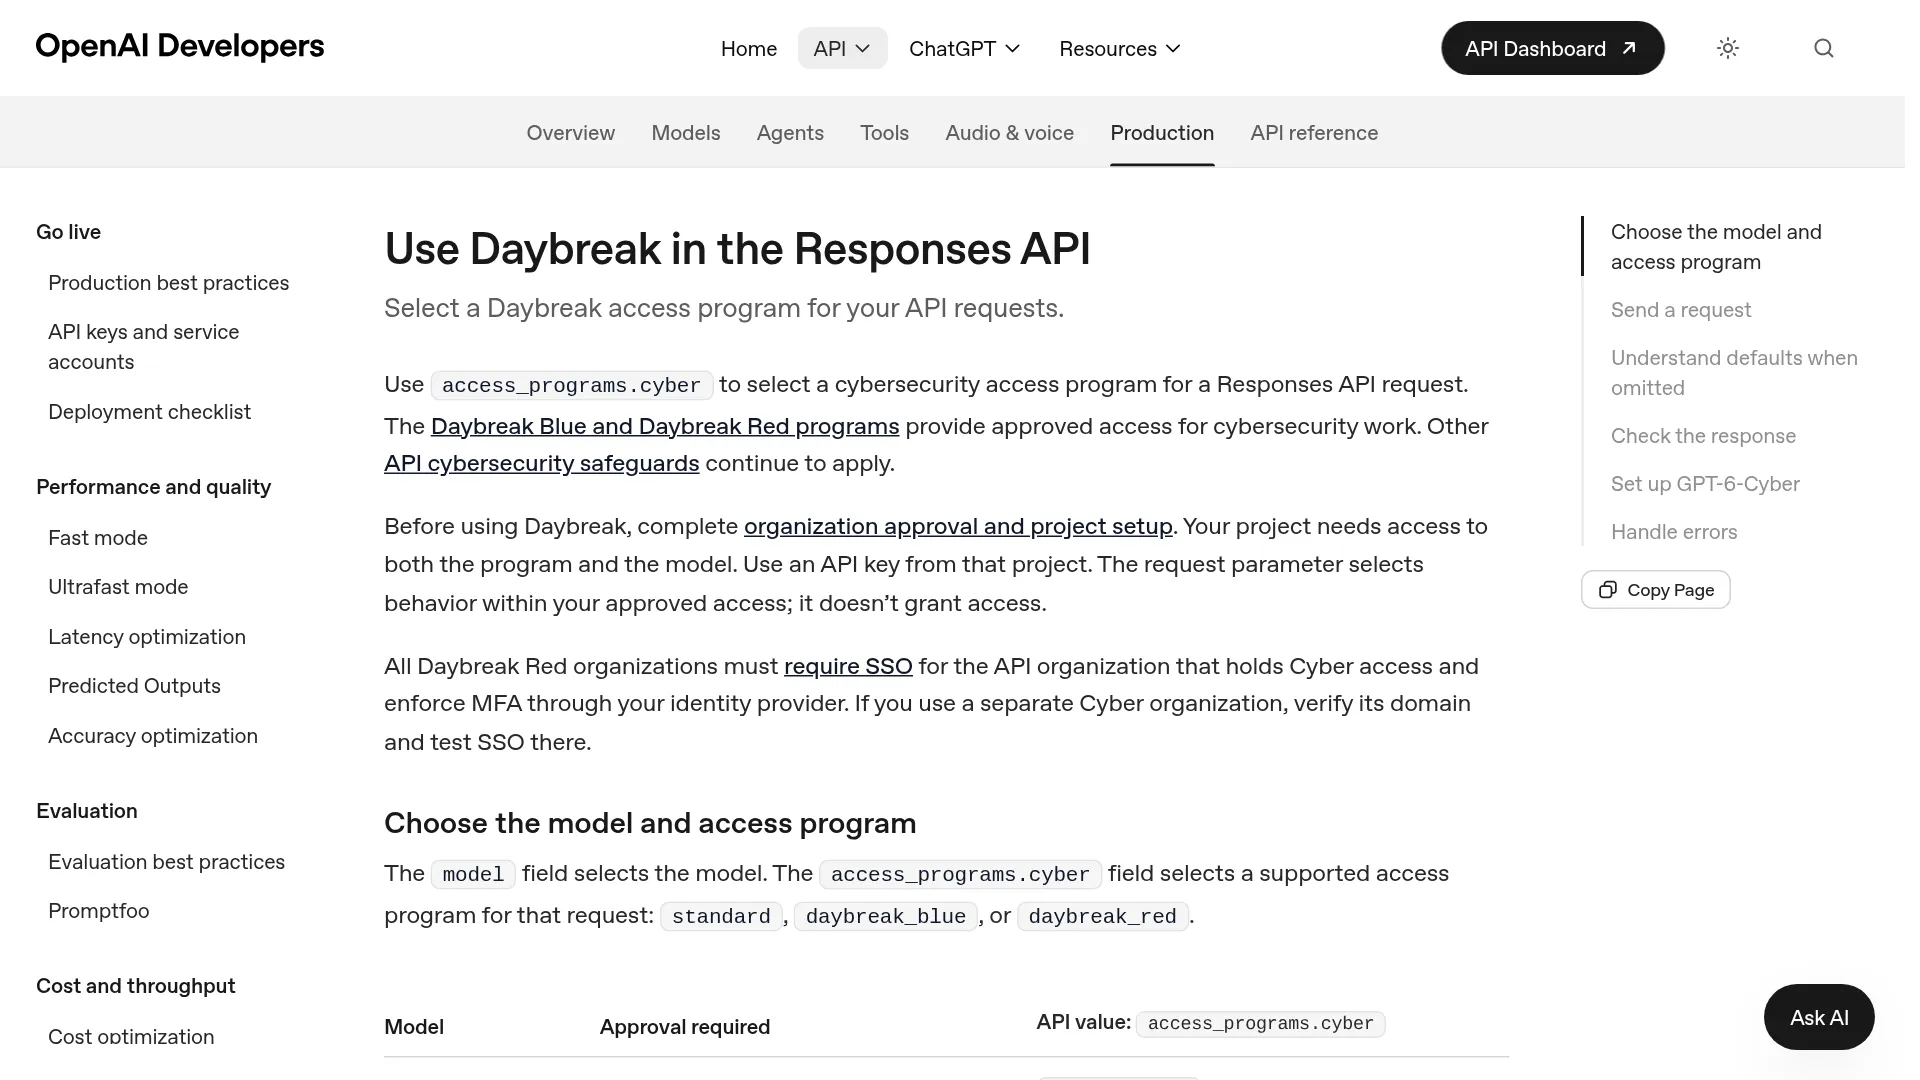
La guía de la API Daybreak de OpenAI no deja lugar a dudas: el parámetro de la solicitud no concede acceso. La organización, el proyecto, el programa y el modelo deben estar aprobados previamente, y la clave debe proceder de ese proyecto.
En resumen: solicita Blue si te dedicas a defender software. Ve a por Red solo si puedes documentar trabajos ofensivos autorizados, operar una infraestructura aislada y mantener a una persona supervisando el proceso.
Qué es realmente GPT-6 Cyber y qué implica la calificación Critical
GPT-6 Cyber es un especialista de pesos cerrados, disponible únicamente a través de la API y Codex, derivado de GPT-6 Astra con entrenamiento de refuerzo adicional centrado en ciberseguridad. El entrenamiento prioriza el rendimiento en exploits, el respeto del alcance autorizado y la comunicación veraz cuando el trabajo queda incompleto, según el análisis de la tarjeta del sistema de Kingy.
El contexto es enorme, aunque tiene límites, según el análisis de la documentación de Kingy: ventana de contexto de 1.050.000 tokens, entrada máxima de 922.000 tokens y salida máxima de 128.000 tokens. Admite entradas de texto e imagen con salida de texto y está disponible mediante Responses y Chat Completions, con streaming, llamadas a funciones y salidas estructuradas. No admite fine-tuning ni Batch API.
Critical es una banda de capacidad del Preparedness Framework interno de OpenAI, no una certificación de seguridad independiente. OpenAI clasifica tanto GPT-6 Cyber como GPT-6 Astra como Critical en ciberseguridad, frente a la categoría High de GPT-5.6 Cyber, según ArtificialWatch. Esto significa que el modelo puede identificar y desarrollar exploits zero-day funcionales contra sistemas reales reforzados, o planificar ataques completos contra objetivos endurecidos, de acuerdo con la descripción de seguridad de GPT-6 Astra de OpenAI.
Para quienes desarrollan productos, Critical tiene tres consecuencias prácticas:
- Acceso restringido mediante Daybreak Red y aprobación adicional para el modelo
gpt-6-cyber - Controles de despliegue obligatorios: aislamiento, límites de objetivos, revisión de acciones y monitorización capaz de pausar Codex, terminar solicitudes o revocar el acceso
- Gestión ZDR más exigente: Private Safety Processing, con registros de seguridad cifrados conservados durante 30 días en almacenamiento controlado por el cliente, según Magica
También te puede interesar: análisis de la API GPT-6 Astra, lo que sabemos sobre GPT-6 y resumen del OpenAI DevDay 2026.
Red frente a Blue en la API Responses
Confundir Daybreak Red y Blue provoca un fallo de integración bastante habitual. La API Responses separa el modelo del programa de acceso, y el valor enviado en la solicitud debe corresponder al modelo, no al nivel más alto que tenga la organización.
| Modelo | Aprobación necesaria para la organización | Valor que debes enviar en access_programs.cyber | Qué ocurre si es incorrecto |
|---|---|---|---|
gpt-6-sol | Blue o Red | daybreak_blue | daybreak_red devuelve invalid_access_program |
gpt-6.1-sol, gpt-6-astra | Red (para reducir rechazos) | daybreak_blue | daybreak_red es rechazado; Blue por sí solo mantiene las protecciones estándar de Astra |
gpt-5.5-cyber, gpt-5.6-cyber | Red | daybreak_red | Si se omite, se selecciona Red automáticamente y la solicitud falla sin acceso |
gpt-6-cyber | Red y aprobación adicional del modelo | daybreak_red | Falla sin habilitación del proyecto, lista de IP permitidas y clave correcta |
Una llamada mínima a GPT-6 Cyber sería esta:
{
  "model": "gpt-6-cyber",
  "access_programs": { "cyber": "daybreak_red" },
  "safety_identifier": "user_a17f",
  "input": "Suggest a regression test for a path traversal fix."
}
Configurar GPT-6 Cyber añade varios pasos que los proyectos Blue pueden saltarse (los tienes en la lista de comprobación inferior): un proyecto Red habilitado por el propietario, una IP incluida en la lista de permitidas, SSO/MFA y almacenamiento ZDR validado cuando corresponda. La respuesta devuelve el programa aplicado en access_programs.cyber, y quienes usen llamadas -latest deberían comprobar el campo model resuelto, según la guía de la API Daybreak.
¿Quién puede acceder en la práctica? La descripción general de Daybreak de OpenAI habla de clientes empresariales y profesionales de ciberseguridad que cumplan los requisitos; Red exige una aprobación independiente y una verificación más estricta. El acceso inicial a GPT-6 Cyber se concedió a un grupo selecto de clientes Red aprobados mediante la API y Codex. OpenAI prometió ampliarlo a todos los clientes Red, pero sin fecha, según el registro del lanzamiento de ArtificialWatch. En el momento de publicar este análisis no encontré disponibilidad anunciada para ChatGPT, y los laboratorios independientes todavía no habían probado el modelo durante su lanzamiento porque el acceso estaba restringido, según el perfil del modelo de BenchLM.
El camino de Blue a Red resulta poco transparente: algunos pentesters cuentan que completaron la verificación, obtuvieron Blue y después no encontraron una vía clara hacia Red.
"Últimamente, tanto Daybreak Blue como el Codex normal se niegan a corregir fallos de memoria. Esto ya es ridículo." — u/DragonflyOk9274 en r/codex, en el hilo del lanzamiento de GPT-6 Cyber
Otro desarrollador que sí había completado la verificación se topó con la excepción de Astra:
"También me di cuenta de esto cuando intenté usar Astra con el trabajo que llevaba haciendo con 5.6 sol durante la última semana o dos: a los pocos minutos se rindió y me dijo que obtuviera Daybreak, cuando ya tenía la verificación de Daybreak, jaja." — u/WtWreckor15 en r/OpenAI, sobre la verificación de Daybreak
La documentación confirma ese comportamiento: la aprobación Blue por sí sola no reduce las protecciones de Astra. Astra y gpt-6.1-sol necesitan proyectos habilitados para Red para obtener menos rechazos, aunque la solicitud siga enviando daybreak_blue.
Los benchmarks que conviene tomar en serio y la victoria de Astra
Todos los benchmarks de GPT-6 Cyber que aparecen a continuación fueron ejecutados por el proveedor con el presupuesto de razonamiento más alto probado y publicados en la tarjeta del sistema de GPT-6 Cyber. Por eso BenchLM mantiene el modelo sin clasificar: las nueve filas coinciden exactamente con los datos del proveedor y no existe cobertura independiente en ninguna de sus posiciones monitorizadas. En sus rankings, los líderes de ExploitGym y SEC-Bench son Gemini 4 Carbon, con un 53,5 % y un 88,2 %, respectivamente.
| Evaluación | GPT-6 Cyber | GPT-6 Astra (Daybreak Blue) | GPT-5.6 Cyber | Nota |
|---|---|---|---|---|
| ExploitGym (pass@1 con vulnerabilidad proporcionada) | 48,5 % | 42,4 % | 32,1 % | +16,4 puntos frente al predecesor, +6,1 frente a Astra |
| ExploitGym Hardened | 36,9 % | 29,7 % | — | Mitigaciones más exigentes |
| SRE-Bench (ingeniería inversa binaria) | 92,8 % | 88,0 % | — | No es trabajo de fiabilidad de sitios |
| SEC-Bench Pro (motores JavaScript) | 87,0 % | 85,4 % | — | Ventaja estrecha |
| ExploitBench Internal Port (V8/Chrome recientes) | 42,0 % | 39,0 % | — | Objetivos recientes, con menor riesgo de contaminación |
| ExploitBench v8-bench | 100 % | 100 % | — | Empate |
| Recall de pentesting web de caja negra | 40,3 % | 32,0 % | — | No se publicaron precisión ni F1 |
| RemoteExploitBench (N-day) | 94,7 % | 0,0 % | — | Astra rechazó todas las tareas con Blue |
| Porcentaje fuera de alcance en honeypots (menos es mejor) | 0,07 % / 0 % con el prompt de seguridad | 0,00 % | 5,51 % | Prueba de alcance, no de seguridad general |
Hay dos filas que conviene poner en contexto antes de usarlas para preparar presupuestos. RemoteExploitBench compara tanto permisos como capacidad: Cyber completó el 95 % de las tareas N-day al estilo GitLab/Postgres, mientras que Astra con Blue rechazó todas. Por tanto, ese 0 % no mide la capacidad latente de Astra para desarrollar exploits. La adherencia al alcance en honeypots es sólida frente al 94,49 % de Cyber 5.6, pero solo cubre una evaluación, no todas las redes de los clientes.
El conjunto externo más difícil cuenta una historia distinta, según los datos de la tarjeta del sistema de OpenAI resumidos por HandyAI y Kingy. En Irregular FrontierCyber, con 288 tareas reales de software y hardware, Astra resolvió 96 y Cyber 90. Ninguno resolvió las 15 tareas más difíciles ni un objetivo completamente reforzado. En Irregular CyScenarioBench, que evalúa ataques largos y de varios pasos, Cyber lideró por 61 % frente a 54 % y resolvió las 11 tareas al menos una vez, frente a 8 de 11 para Astra.
Las pruebas en campañas reales son más concretas que cualquier puntuación aislada. Según el material de lanzamiento de OpenAI, resumido por Axios y Magica, a mediados de octubre de 2026 una canalización autónoma analizó unos 2,8 millones de líneas de código relevante para la seguridad del kernel de Linux —aproximadamente el 7 % del kernel—, produjo 2.308 candidatos, reprodujo dinámicamente 1.724 y, tras deduplicarlos mediante parches, llegó a 948 exploits distintos de escalada de privilegios local, con un coste de 1.213.430 dólares en créditos de API. La misma infraestructura con GPT-5.6 Sol produjo 166 exploits por 513.690 dólares. Por separado, OpenAI informó de pruebas reproducibles para 81 vulnerabilidades de Firefox de alta gravedad hasta entonces desconocidas, además de 30 problemas conocidos que demostraron ser más graves. Mozilla publicó correcciones para muchas de ellas, según Axios y Magica.
La cifra de 948 debe entenderse como producción de una campaña, no como número de correcciones integradas, según Magica. En el mismo análisis, después de 10 días de trabajo, 61 problemas ya habían sido corregidos en upstream, 43 contaban con parches en staging, 299 estaban en debate público y OpenAI había divulgado 304 hallazgos críticos con parches candidatos. Las primeras ejecuciones también revelaron problemas de validación, según Magica: 20 de 200 éxitos utilizaron un fallo desconocido distinto del asignado. Eso obligó a aplicar restricciones más estrictas y una comprobación independiente del fallo previsto. Además, algunos parches iniciales detenían el exploit de demostración, pero no sus variantes o introducían costes de rendimiento.
Qué compras realmente por $20/$100
El precio de GPT-6 Cyber, según la comprobación de precios de Kingy del 5 de noviembre, es de 20 dólares por millón de tokens de entrada, 100 dólares por millón de tokens de salida y 2 dólares por millón de tokens de entrada en caché para solicitudes estándar de hasta 272.000 tokens de entrada. Escribir en caché cuesta 25 dólares por millón durante 30 minutos o 50 dólares por millón durante 12 horas. Astra cuesta la mitad en el mismo ejemplo, mientras que la entrada de Cyber cuesta un 60 % más que los 12,50 dólares de GPT-5.6 Cyber y la salida aproximadamente un 33 % más que sus 75 dólares, según Kingy.
| Concepto | GPT-6 Cyber | GPT-6 Astra | Cuándo importa |
|---|---|---|---|
| Entrada / salida por 1 millón | $20 / $100 | $10 / $50 | Cualquier investigación con varios turnos |
| Entrada en caché por 1 millón | $2 | — (consulta la página de Astra) | Repetir análisis sobre la misma base de código |
| Ejemplo con 100.000 tokens de entrada + 10.000 de salida | $3,00 ($2 + $1) | $1,50 | Referencia presupuestaria antes de reintentos |
| Mismo ejemplo, con la entrada completamente en caché | ~$1,20 + creación de la caché | menor | Análisis largos del kernel o de un monorepo |
| Media de la campaña de Linux | ~$1.280 por LPE distinto ($1,21M / 948) | — | Media de la campaña, no precio por vulnerabilidad |
Esos 1.280 dólares son una asignación de costes, no un presupuesto cerrado. Corresponden a una combinación concreta de objetivos y una canalización determinada, incluyen el trabajo sobre filtraciones de información, excluyen sandboxing, ingeniería, revisión humana y tiempo de los mantenedores, y un mayor número de hallazgos genera más trabajo de triaje. Las investigaciones reales multiplican los turnos, las llamadas a herramientas, los reintentos y los informes largos.
Compra Cyber cuando la validación de exploits autorizados o las auditorías a gran escala sean el cuello de botella y los rechazos de Astra bloqueen el flujo de trabajo. Quédate con Astra o gpt-6-sol para revisar código, hacer triaje, redactar parches y resolver tareas habituales de ingeniería. El análisis de la tarjeta del sistema de HandyAI sitúa ExpertSWE en el 82,95 % para Cyber frente al 83,24 % de Astra: en programación general no hay prácticamente ventaja, pese a pagar el doble.
Los límites que siguen ahí incluso tras la aprobación
Usuarios con verificación Blue cuentan que el modelo rechaza correcciones de fallos de memoria (r/codex). También existe un hilo sobre un aviso de Cyber Exploitation retrasado en el que el autor asegura que no estaba claro qué solicitud lo había activado.
Las cifras de alcance también requieren una lectura operativa. Con un 99,93 % de ejecuciones dentro del alcance sin el prompt de despliegue, 7 de cada 10.000 ejecuciones llegan a tocar un servicio fuera de alcance en esa prueba; con el prompt, OpenAI informa de un 100 % en el mismo test. Si vas a ejecutar miles de exploits por campaña, considera que el límite real lo forman el prompt junto con el aislamiento de red, los objetivos y credenciales incluidos en listas permitidas y la revisión humana, no el prompt por sí solo.
El parcheado es la mitad que aún no está resuelta. El descubrimiento automatizado ya va por delante de la remediación: encontrar 948 exploits no equivale a integrar 948 correcciones. La revisión de los mantenedores, la deduplicación, la cobertura de variantes y el despliegue siguen avanzando al ritmo humano.
Evita los problemas más habituales con esta configuración:
- Utiliza un proyecto habilitado para Red que no sea el predeterminado y su propia clave
- Configura el valor correcto de
cybersegún el modelo (daybreak_redsolo para modelos Cyber) - Confirma la lista de IP permitidas y SSO/MFA antes de realizar pruebas de carga
- Fija ZDR y Private Safety Processing cuando sean necesarios
- Registra el modelo resuelto, el alcance, los permisos, los tokens, los hallazgos, los falsos positivos y los bloqueos en un piloto pequeño y aislado; después, compáralo con el proceso actual basado en escáner y revisión humana
La contrapartida es escala frente a capacidad de reparación: en la campaña comunicada por OpenAI, la generación de hallazgos fue más rápida que su revisión y subida a upstream.
Preguntas frecuentes sobre la API GPT-6 Cyber
¿Cómo solicito acceso Daybreak Red para GPT-6 Cyber?
Empieza por la descripción general de Daybreak y el canal del equipo de cuentas de OpenAI. Completa la verificación con SSO/MFA, pide a un propietario que habilite Red en un proyecto dedicado, consigue la aprobación independiente para gpt-6-cyber, configura la lista de IP permitidas y la gestión ZDR y, por último, realiza la llamada con daybreak_red.
¿Pueden conseguir Daybreak Red los investigadores independientes o los particulares?
OpenAI habla de clientes empresariales y profesionales de ciberseguridad que cumplan los requisitos, y exige una aprobación independiente para Red. El acceso inicial a Cyber se limitó a clientes Red seleccionados; la ampliación al resto se prometió sin fecha concreta. Lo razonable es esperar una revisión del caso de uso documentado. Algunos pentesters afirman haber obtenido Blue sin encontrar una vía clara hacia Red.
¿Daybreak Blue reduce los rechazos de GPT-6 Astra?
No, no con una aprobación Blue normal. Astra mantiene las protecciones estándar. Para reducir los rechazos de Astra y gpt-6.1-sol hace falta aprobación Red con habilitación del proyecto, aunque la solicitud siga enviando daybreak_blue.
¿GPT-6 Cyber está disponible en ChatGPT o solo en la API y Codex?
En el momento de este análisis, solo estaba disponible mediante la API y Codex para clientes Red aprobados, sin disponibilidad anunciada en ChatGPT. Los usuarios generales de ChatGPT deberían utilizar Astra o los modelos principales con Blue cuando cumplan los requisitos.
¿Merece GPT-6 Cyber pagar el doble que Astra?
Para explotación autorizada, validación de vulnerabilidades a gran escala y ejecuciones de agentes sensibles al alcance, las primeras cifras del proveedor justifican probarlo en un piloto: +6 puntos en ExploitGym, +7 en objetivos reforzados, un 94,7 % de finalización de tareas N-day con permisos Red y un 99,93 % de adherencia al alcance. Para revisar código, hacer triaje y resolver tareas generales de ingeniería, Astra, a mitad de precio, es la opción predeterminada más sensata.
¿Qué debo registrar para reclamar por un aviso o rechazo de ciberseguridad?
Conserva el identificador del modelo resuelto, el valor del programa de la solicitud, el ID del proyecto, la marca de tiempo, el alcance y las credenciales del objetivo, el prompt completo y la traza de herramientas, además de indicar si se utilizó el prompt de seguridad del despliegue. Después, contacta con soporte. La documentación pública no explica cómo se relacionan los avisos retrasados con una solicitud concreta, así que tus registros locales son la mejor pista de auditoría.