 AIREITER
En r/codex se repite una duda: «Usaba GPT-5.5 en extra-high; ¿Sol o Terra son su equivalente?». La respuesta corta es que GPT-5.6 Sol mantiene exactamente el mismo precio de API que GPT-5.5 y lo supera en benchmarks de agentes. Para tareas prolongadas con agentes o navegación, cambiar de modelo puede salir prácticamente gratis.
Sin embargo, que la tarifa sea la misma no significa que la factura lo sea. Sol cobra las escrituras de caché que GPT-5.5 no cobraba y dedica más tiempo a razonar, cuyos tokens se facturan como salida. El coste por tarea puede multiplicarse aunque el tarifario no se haya movido.
La tarifa no cambia, pero la factura sí
GPT-5.6 Sol y GPT-5.5 comparten la misma tarifa estándar de API: $5.00 por millón de tokens de entrada, $30.00 por millón de tokens de salida y $0.50 por entrada en caché. Consulté ambas filas en la página de precios de OpenAI el 29 de julio de 2026:
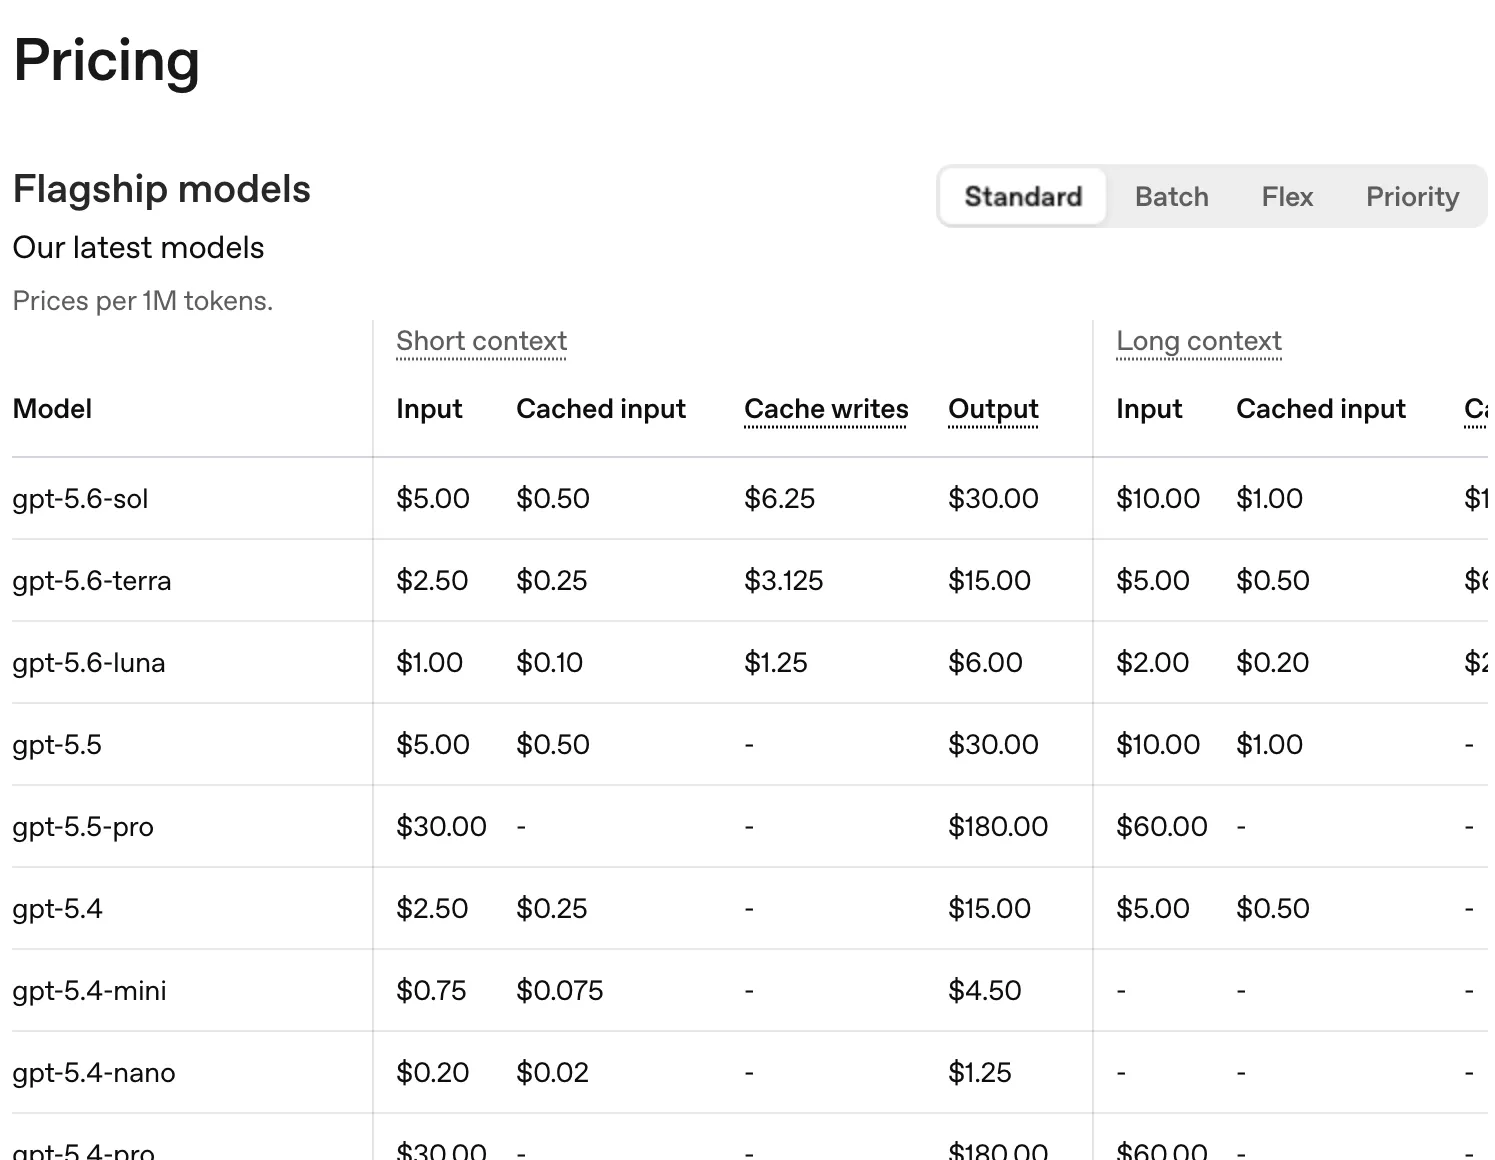
Hay tres conceptos en esa tabla que marcan la diferencia entre ambos modelos:
| Concepto | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| Entrada / salida (por 1M de tokens) | $5.00 / $30.00 | $5.00 / $30.00 |
| Entrada en caché | $0.50 | $0.50 |
| Escrituras de caché | $6.25 | sin coste |
| Contexto largo (>272K), entrada / salida | $10.00 / $45.00 | $10.00 / $45.00 |
La línea de escritura de caché es la que más puede pesar durante una migración. GPT-5.6 incorpora puntos de corte explícitos para la caché con una vida mínima de 30 minutos (el desglose de Vellum explica su funcionamiento). Escribir cuesta 1.25 veces la tarifa de entrada sin caché, mientras que las lecturas conservan un descuento del 90%. Las cuentas de la tabla son claras: un segmento en caché cuesta $6.25 al escribirlo y $0.50 en cada lectura, frente a $5.00 por volver a enviarlo sin caché. La caché empieza a compensar a partir del segundo uso; en cambio, un pipeline que escribe más de lo que lee asume un cargo que GPT-5.5 no tenía.
El segundo coste depende del tiempo de razonamiento. Sol piensa más antes de responder, y esos tokens de razonamiento se cobran como salida. Usuarios de Codex que ya migraron describen el efecto de forma directa:
«5.6 sol médium es tres veces más caro que 5.5-xhigh y ofrece la misma calidad de código (al menos comparado con el lanzamiento de 5.5)». — r/codex, «GPT 5.5 and 5.6 conversion table»
La tarifa es idéntica, pero el coste por tarea se triplica porque el modelo consume tres veces más tokens para llegar al resultado. El anuncio de GPT-5.6 de OpenAI apunta en la dirección contraria: en sus comparativas internas, registra un 22% menos de tokens de entrada y un 23% menos de salida que GPT-5.5. Ambas cosas pueden ser ciertas: la eficiencia por unidad de razonamiento mejora, pero los ajustes de esfuerzo más altos hacen que razone mucho más. La experiencia final depende del nivel de esfuerzo elegido.
En qué mejora realmente según los datos
En evaluaciones independientes, GPT-5.6 Sol y GPT-5.5 están casi empatados en inteligencia bruta. Artificial Analysis asigna 54 puntos a Sol en nivel medio y 53 a GPT-5.5 en nivel alto dentro de su Intelligence Index v4.1, con un coste combinado idéntico de $4.35 por millón de tokens. Las mejoras relevantes están en otros frentes:
- Latencia hasta el primer token: 4.13 segundos en Sol frente a 16.67 segundos en GPT-5.5 (high), una diferencia de 4x. En herramientas interactivas y bucles de agentes que encadenan decenas de llamadas, es probablemente la mejora más perceptible en el día a día.
- Benchmarks de agentes: Sol alcanza un 88.8% en Terminal-Bench 2.1 y un 92.2% en BrowseComp. Las mayores ganancias de esta versión se concentran en el uso de herramientas a largo plazo.
- Contexto: Sol llega a 1M de tokens, frente a los 922K de GPT-5.5, y además mantiene el razonamiento entre turnos de conversación, como documenta el análisis de Vellum enlazado anteriormente.
- Velocidad de salida: es la regresión. Sol transmite 65 tokens por segundo frente a los 77.3 de GPT-5.5. Los trabajos de generación masiva serán más lentos, no más rápidos.
La suite de programación de largo recorrido de CodeRabbit, con más de 100 tareas en cinco lenguajes, sitúa a Sol en un 63.7% de aciertos. Su benchmark de revisión de código muestra que Sol añade 7.4 puntos porcentuales respecto a una integración base, aunque con una advertencia: su precisión de revisión fue del 31.6%. Detecta más problemas reales, pero también añade más ruido. Los mismos evaluadores registraron que Sol consumió 8 rondas en un cambio sencillo tras comprometerse con un enfoque equivocado. Rendir mejor en tareas de maratón no lo hace inmune a los callejones sin salida.
Probé los mismos tres prompts en ambos
Los benchmarks premian el trabajo de largo recorrido, pero la mayoría de llamadas a una API son breves. Por eso envié los mismos tres prompts a gpt-5.6-sol y gpt-5.5 el 29 de julio de 2026: una corrección de un bug de manejo de fechas en Python, un rompecabezas de lógica con exactamente dos respuestas válidas y una extracción JSON estricta con trampa: una fecha sin año que, según las reglas, debía convertirse en null, nunca en una estimación. Hice una llamada de API por tarea, con esfuerzo de razonamiento predeterminado, sin herramientas ni reintentos. Es una muestra pequeña, no un benchmark.
Ambos modelos acertaron las tres. GPT-5.5 corrigió el fallo de diciembre con calendar.monthrange; Sol implementó manualmente una tabla correcta de años bisiestos. Los dos encontraron exactamente los dos órdenes de despliegue válidos, devolvieron un JSON idéntico byte a byte en la extracción y se negaron a inventar un año para «el 14 de julio».
El gasto de tokens y la velocidad repartieron las ventajas:
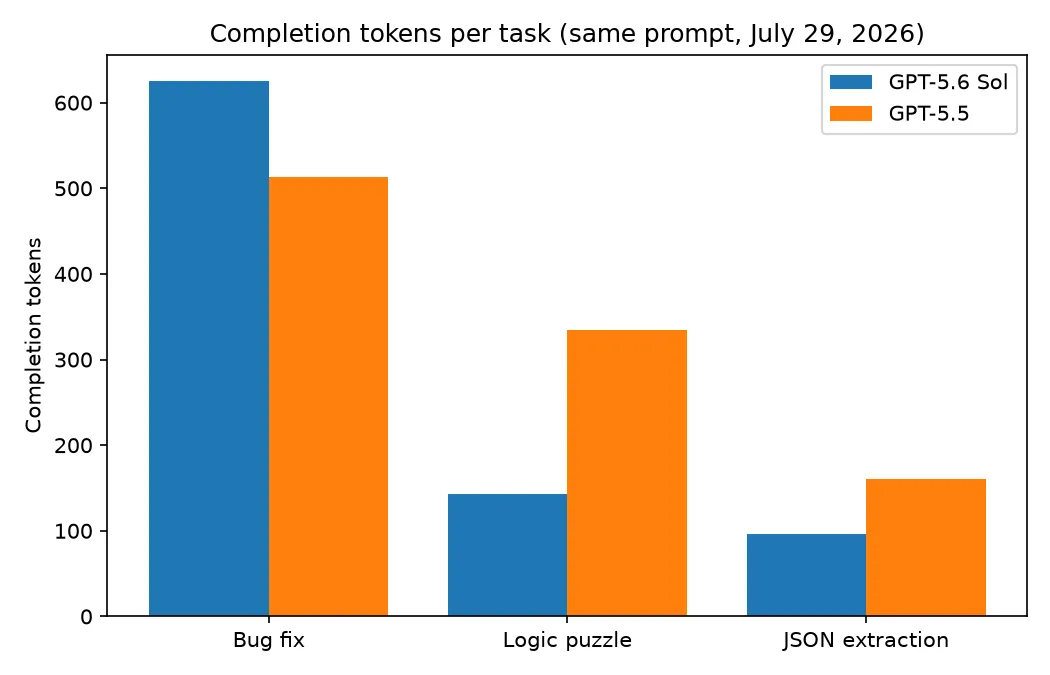
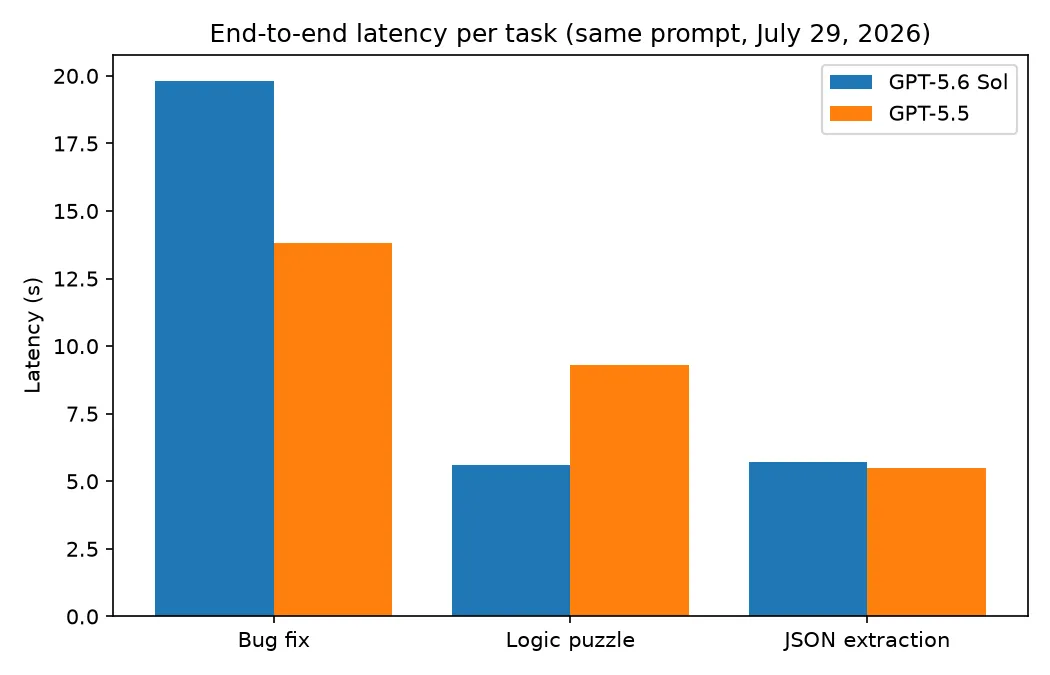
Sol consumió menos tokens de completado en total, 864 frente a 1,007, pero resultó más lento y más verboso en la tarea de código: 19.8 segundos y 625 tokens, frente a 13.8 segundos y 513. En el problema de lógica ocurrió lo contrario: Sol respondió en 5.6 segundos con 143 tokens, mientras que GPT-5.5 tardó 9.3 segundos y usó 334. Tras observar ambos resultados, mi conclusión es que los modelos son intercambiables en tareas cortas y bien definidas; esta prueba, por sí sola, no justificaría una migración. El argumento para actualizar depende por completo del trabajo con agentes y contextos largos de la sección de benchmarks.
Qué nivel de GPT-5.6 equivale a tu esfuerzo en GPT-5.5
Según el desglose de Vellum enlazado antes, el ID de modelo sin sufijo gpt-5.6 dirige por defecto a gpt-5.6-sol. Quien actualice simplemente cambiando el alias obtendrá la gama principal, con la factura propia de esa gama, sin haberla elegido expresamente. Si vas a migrar de forma deliberada, hay tres datos que sirven de referencia:
- GPT-5.5 xhigh → Sol medium es la equivalencia práctica que maneja la comunidad. El informe de r/codex citado arriba habla de paridad de calidad con 5.5 y de un coste por tarea aproximadamente 3x mayor cerca del lanzamiento. Tómalo como una hipótesis inicial que debes validar con tus propios prompts, no como una garantía. Las cargas sensibles al presupuesto que funcionaban con 5.5 high encajan más con GPT-5.6 Terra, cuya tarifa de $2.50/$15 es la mitad que la de Sol.
- El tiempo de razonamiento se dispara en el extremo superior. Usuarios de ChatGPT Pro informan de que GPT-5.6 dedica entre 20 y 50 minutos a tareas para las que 5.5 Pro empleaba entre 5 y 10. Es una observación de ChatGPT, pero la misma pila de razonamiento se factura como tokens de salida en la API. El ajuste
reasoning.mode: "pro"está disponible en las tres gamas de 5.6, así que ese techo es opcional. - Tus prompts antiguos pueden perjudicar al modelo nuevo. El equipo de pruebas de Every.to comprobó que la salida de Sol mejoraba de forma notable al eliminar instrucciones defensivas escritas para modelos anteriores: reglas como «comprueba siempre X» que llevaban a Sol a verificar y construir de más. Migra el modelo y vuelve a auditar el prompt de sistema; la capa de precauciones que GPT-5.5 necesitaba ahora puede convertirse en un coste.
Cuándo cambiar y cuándo quedarse en GPT-5.5
Cambia a GPT-5.6 Sol si tu carga de trabajo es agéntica: uso de herramientas en varios pasos, investigación mediante navegación o sesiones de programación a escala de repositorio. Ahí es donde importan el 88.8% de Terminal-Bench, el 92.2% de BrowseComp y la reducción de 4x en la latencia hasta el primer token, que se acumula en cada iteración del bucle. Con la misma tarifa de $5/$30, el salto de capacidad no añade coste, siempre que los tokens extra de razonamiento y las escrituras de caché no se coman la diferencia. El contexto de 1M y la persistencia del razonamiento entre turnos eliminan dos soluciones alternativas que los pipelines de 5.5 tenían que construir.
Quédate en GPT-5.5, por ahora, si tu tráfico consiste en llamadas cortas y bien especificadas: extracción, clasificación, correcciones de código de una sola pasada o generación a gran volumen. Mi prueba de tres prompts dejó a los modelos empatados precisamente en este tipo de trabajo, y el streaming más lento de Sol, 65 frente a 77.3 tokens por segundo, empeora objetivamente los trabajos masivos. Los pipelines con muchas escrituras de caché deberían calcular primero la línea de $6.25. Y si buscas una factura menor con una calidad similar, la respuesta es Terra, no Sol.
Hice mi comparativa directa con AIReiter, que ofrece gpt-5.6-sol y gpt-5.5 bajo una misma clave de API. Así, cambiar el string del modelo basta para hacer la prueba A/B: compara la tasa de éxito, la latencia total y los tokens de completado por tarea con tu propio tráfico.
Preguntas frecuentes
¿GPT-5.6 Sol es mejor que GPT-5.5?
En tareas de agentes, claramente: 88.8% en Terminal-Bench 2.1, 92.2% en BrowseComp y una latencia hasta el primer token 4x inferior. En tareas cortas de una sola pasada, las evaluaciones independientes los separan por un punto, 54 frente a 53 en Artificial Analysis, y mis pruebas con los mismos prompts no encontraron diferencias de corrección.
¿GPT-5.6 Sol cuesta más que GPT-5.5?
El precio de lista es idéntico: $5 de entrada y $30 de salida por millón de tokens. Sol añade una tarifa de $6.25 por escritura de caché que GPT-5.5 no cobraba y, en niveles de esfuerzo altos, consume más tokens de razonamiento por tarea. Usuarios de r/codex midieron un coste por tarea de aproximadamente 3x con paridad de calidad respecto a 5.5 xhigh.
¿Cuál es el equivalente de GPT-5.5 xhigh en GPT-5.6?
Sol con esfuerzo medio ofrece una calidad de código comparable con un coste por tarea de alrededor del triple. Si la paridad de costes importa más que el techo de capacidad, Terra es la alternativa económicamente más cercana.
¿Puedo seguir usando GPT-5.5 después de actualizar?
Sí. GPT-5.5 sigue apareciendo en la página de precios de OpenAI con las mismas tarifas, verificadas el 29 de julio de 2026; consulta la captura anterior. Por ahora, nada obliga a migrar.
La decisión, resumida en una tabla
| Tu carga de trabajo | Elige | Dato decisivo |
|---|---|---|
| Agentes de varios pasos, navegación, programación a escala de repositorio | GPT-5.6 Sol | 88.8% en Terminal-Bench, latencia al primer token 4x menor, misma tarifa |
| Extracción, clasificación o correcciones puntuales cortas | GPT-5.5 (por ahora) | Paridad en las pruebas con los mismos prompts; 5.5 transmite un 19% más rápido |
| Muchas escrituras de caché de prompts | GPT-5.5, o rediseña primero | La nueva tarifa de Sol es $6.25/1M por escritura de caché |
| Misma calidad, factura más baja | GPT-5.6 Terra | $2.50/$15, la mitad del precio de Sol; consulta arriba la comparativa Terra vs. 5.5 |
| Máxima profundidad de razonamiento | Sol con reasoning.mode: "pro" | Entre 20 y 50 min de deliberación donde 5.5 dedicaba entre 5 y 10 |