 AIREITER
Con el mismo precio por token, GPT-5.6 Sol puede acabar costando más del doble por tarea. En 1.715 sesiones de Codex, consumió 16,45 millones de tokens por sesión, frente a los 7,30 millones de GPT-5.5 en una ventana comparable de 1.667 sesiones: 2,25 veces más. Además, un fallo documentado de la Responses API parece inflar en 6 veces o más los output_tokens facturados de Sol. Si la factura de GPT-5.6 no te cuadra, probablemente haya una razón.
El consumo real de tokens de GPT-5.6 Sol
El desarrollador Vincent Schmalbach registró el consumo de tokens en dos periodos de 14 días de uso de Codex. Comparó GPT-5.5 xhigh con GPT-5.6 Sol xhigh, con un número de sesiones casi idéntico:
| Métrica | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| Sesiones | 1,667 | 1,715 |
| Tokens totales | 12.17B | 28.22B |
| Tokens por sesión | 7.30M | 16.45M |
El número de sesiones aumentó un 2,9%, pero los tokens por sesión subieron un 125%. El consumo total pasó de 12,17 mil millones a 28,22 mil millones de tokens: un incremento de 2,32 veces para una carga de trabajo prácticamente equivalente.
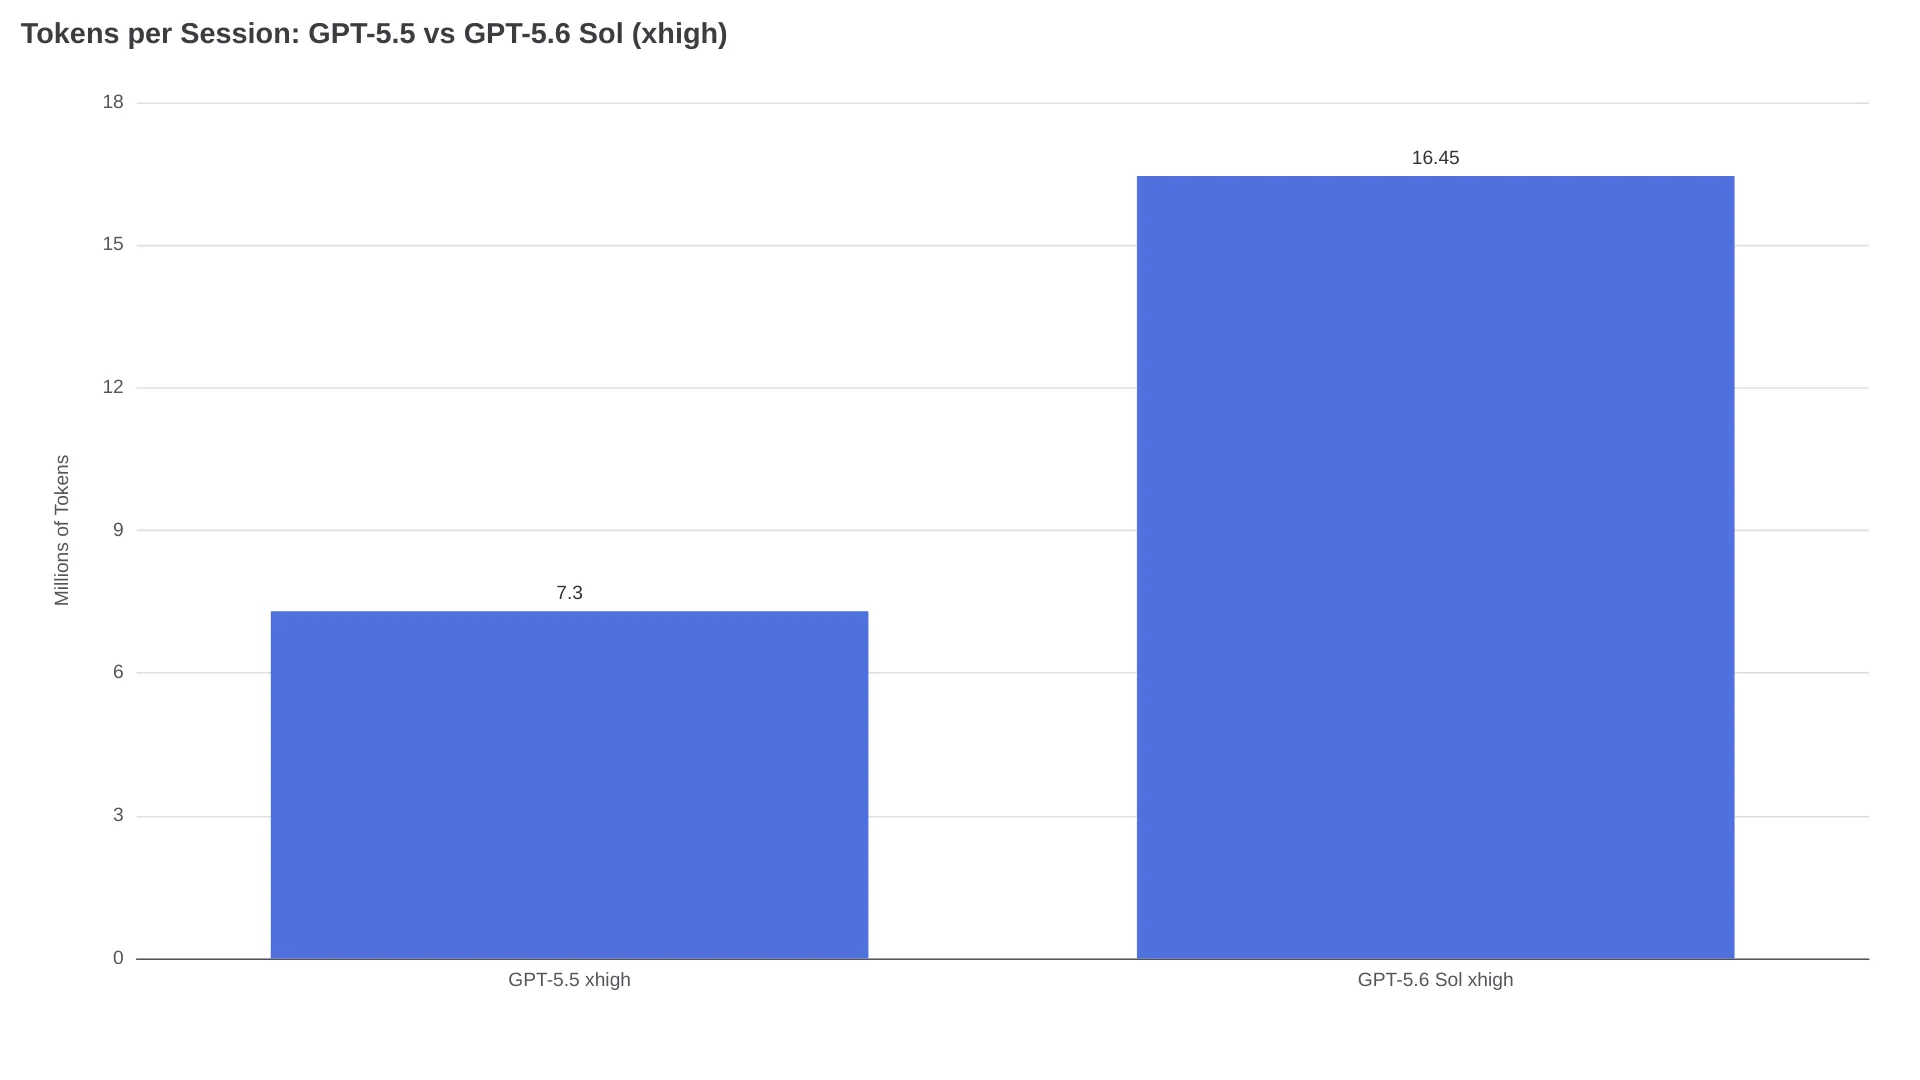
La página de precios de OpenAI fija para GPT-5.6 Sol una tarifa de $5/1M en entrada y $30/1M en salida, exactamente la misma que GPT-5.5. A igual tarifa, 2,25 veces más tokens equivalen a un coste por tarea aproximadamente 2,25 veces mayor. GPT-5.6 Sol también introduce un recargo por escritura de caché —1,25 veces la tarifa de entrada— que no existía en GPT-5.5.
"GPT 5.6 Sol es un horno de tokens. Incluso Sol en medium o high parece devorar tokens. 5.6 solo se usará para planificación compleja o bugs difíciles." — usuario de r/codex
Las tres suscripciones de Schmalbach, que antes le duraban una semana de trabajo intensivo, ahora se agotan en aproximadamente un día de uso medio.
Por qué Sol consume más tokens
Sol es más eficiente por punto de benchmark que sus rivales. En el Artificial Analysis Coding Agent Index, utiliza menos tokens de salida que Claude Fable 5 para obtener puntuaciones equivalentes. Sin embargo, en sesiones reales razona con más intensidad: planifica, retrocede, valida y explora alternativas. El intercambio es un mayor consumo de tokens por tarea, aunque cada token aporte un trabajo más útil.
Un fallo de facturación reportado infla los tokens de salida
Al mayor consumo real se suma un fallo documentado de contabilización en la Responses API. Al parecer, infla el campo output_tokens, que es el utilizado para calcular la facturación. OpenAI está investigándolo, aunque todavía no ha confirmado públicamente la causa raíz.
Un desarrollador documentó el problema en 710 llamadas a GPT-5.6 y 22.922 llamadas de razonamiento en total. GPT-5.6 es la primera familia de modelos que emite varios elementos reasoning por respuesta: la mediana es k=9 en Sol y k=4 en Terra. Durante la generación, un acumulador de la API suma el total acumulado de razonamiento una vez por cada elemento de razonamiento, además del recuento final correcto.
La fórmula es:
output_tokens ≈ R × (k + 3) / 2R representa los tokens reales de razonamiento y k el número de elementos de razonamiento. Para Sol, con una mediana k=9, el recuento facturado se infla aproximadamente 6 veces. Para Terra, con k=4, unas 3,6 veces.
Cómo se refleja en una factura real
El caso documentado más extremo fue una única llamada a GPT-5.6 Terra que devolvió una respuesta de cuatro caracteres, d1d4, y se facturó como si hubiera generado 466.818 tokens de salida, pese a haber usado solo 21.064 tokens reales de razonamiento.
| Dato reportado por la API | Valor |
|---|---|
output_tokens (facturados) | 466,818 |
reasoning_tokens (reales) | 21,064 |
| Salida visible | d1d4 (4 caracteres) |
| Elementos de razonamiento (k) | 41 |
Con k=41, la fórmula predice R × (41+3)/2 = 21,064 × 22 = 463,408, una diferencia de menos del 0,7% respecto al importe facturado. El autor del informe lo verificó en su panel de facturación: al sumar los output_tokens de la API y aplicar las tarifas publicadas, las cifras reproducían los cargos del panel hasta la décima de céntimo. En sus llamadas a GPT-5.6, aproximadamente $284 de los cerca de $320 facturados correspondían a sobrecobros.
El error es anterior a GPT-5.6
Con k=1 —un único elemento de razonamiento, como emiten los modelos anteriores a 5.6— la fórmula queda en R × 4/2 = 2R: un sobrecargo fijo de 2 veces. El autor del informe lo confirmó con la propia exportación de uso de OpenAI correspondiente a mayo de 2026:
| Modelo | Tokens de salida facturados | Recuento real | Proporción |
|---|---|---|---|
| o3-mini | 25,408,973 | 12,376,132 | 2.02x |
| gpt-5.4-nano | 11,718,610 | 5,844,140 | 2.00x |
| o1 | 778,989 | 335,944 | 2.01x |
| o4-mini (control) | 12,054,680 | 9,160,567 | 1.01x |
GPT-5.6 no introdujo el fallo. Es el primer modelo que divide el razonamiento en muchos elementos, y eso transforma un discreto sobrecargo de 2 veces en un multiplicador mucho mayor. La razón es que el razonamiento se emite en fragmentos de unos 512 tokens, por lo que k ≈ ceil(R/512). Al sustituirlo en la fórmula obtenemos output_tokens ≈ R²/1024 + 3R/2: el sobrecargo crece de forma cuadrática con la longitud del razonamiento. Duplicar el tiempo de pensamiento supone, aproximadamente, cuadruplicar la factura.
En el momento de publicar este artículo, en agosto de 2026, personal de OpenAI ha respondido al informe del error solicitando más datos, pero no se ha confirmado públicamente ni una corrección ni un ajuste de facturación.
Precios actuales de GPT-5.6 tras la rebaja del 30 de julio
El 30 de julio de 2026, OpenAI redujo el precio de Luna un 80% y el de Terra un 20%. La tarifa de Sol no cambió. Estos son los precios actuales según la página de precios de OpenAI:
| Modelo | Entrada (corta) | Entrada en caché | Escrituras de caché | Salida (corta) | Salida (larga) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
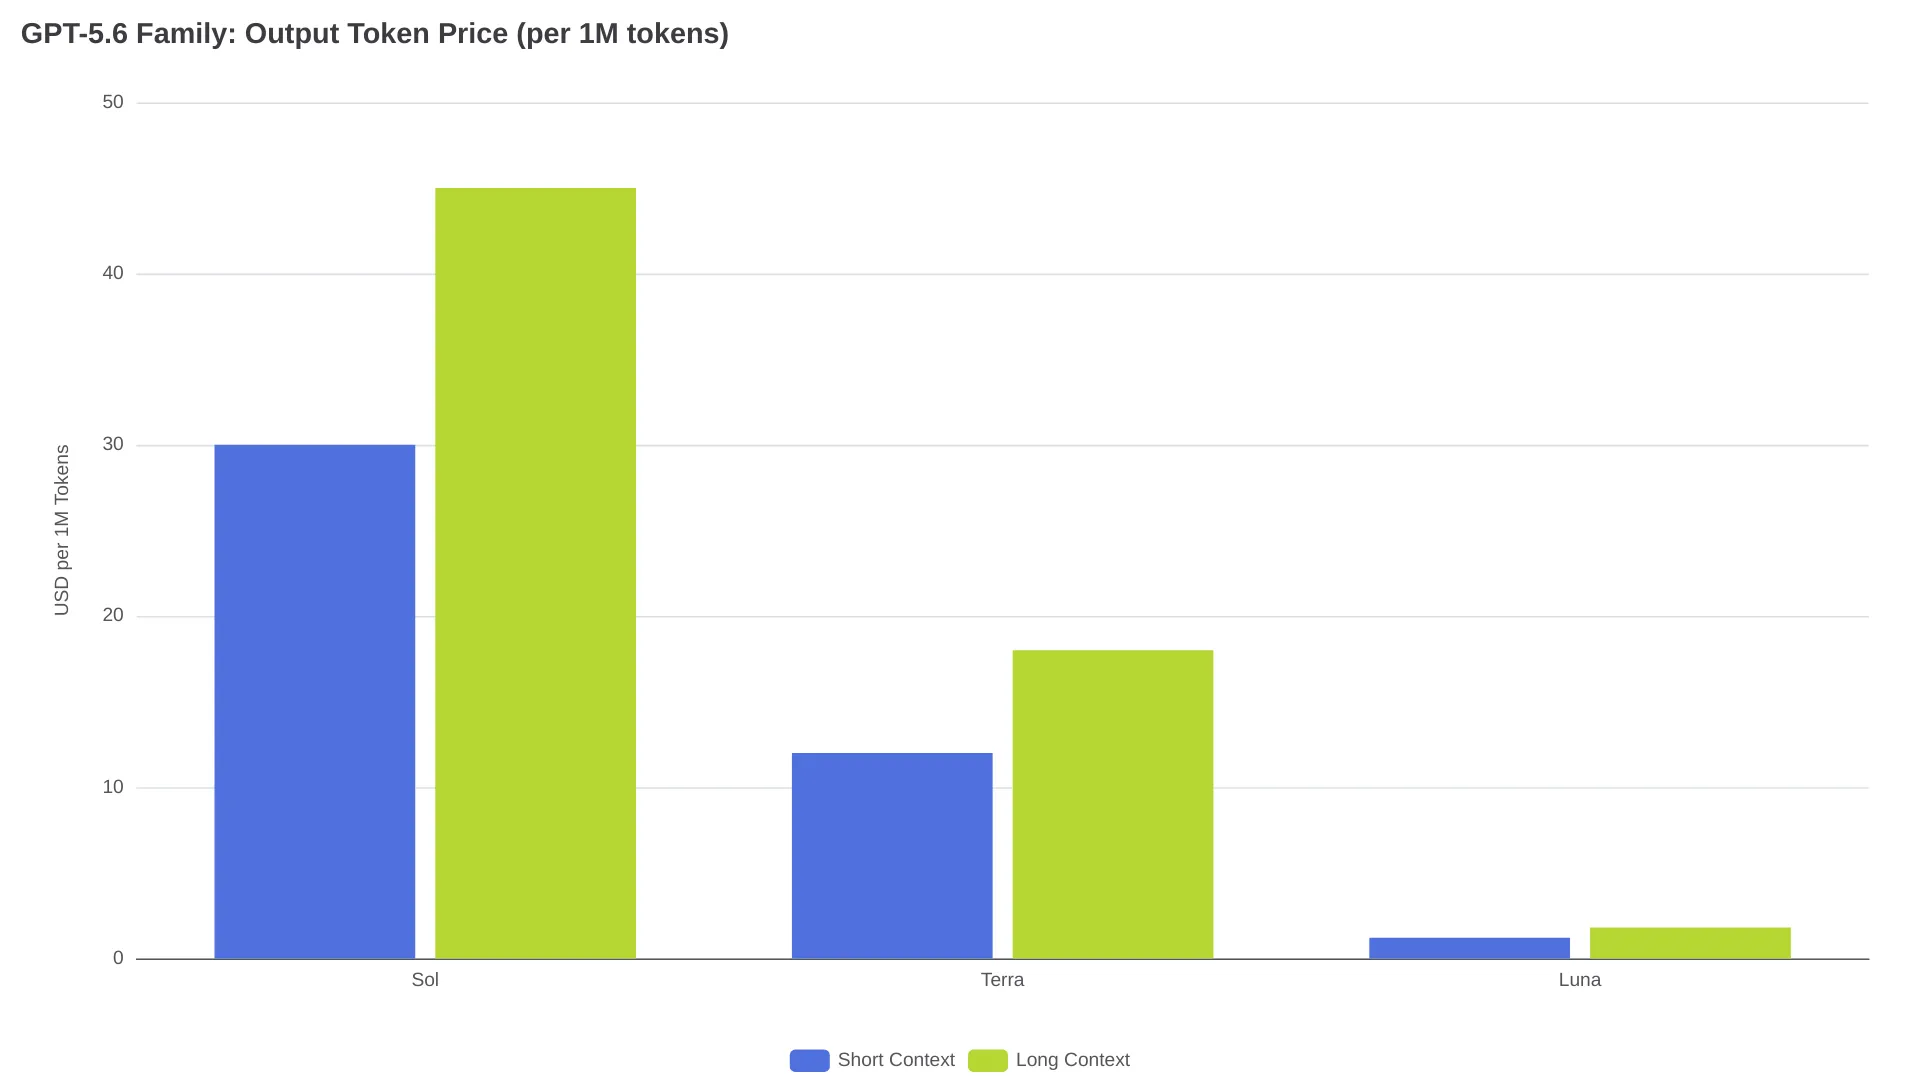
Sol cuesta lo mismo por token que GPT-5.5, pero utiliza 2,25 veces más tokens por tarea; por tanto, el coste efectivo por tarea aproximadamente se duplica.
Las escrituras de caché son un nuevo concepto de coste. GPT-5.6 cobra por ellas 1,25 veces la tarifa de entrada ($6.25/1M en Sol). GPT-5.5 no tenía esta tarifa. Si tu carga de trabajo tiene una baja tasa de aciertos de caché, añade un recargo del 25% sobre los costes de entrada que antes no existía.
Luna ya es más barato que GPT-5.4 nano. Con $0.20/$1.20 frente a los $0.20/$1.25 de nano, Luna se convierte, tras la rebaja, en el modelo más económico del catálogo de OpenAI.
Tres formas de reducir la factura de tokens de GPT-5.6
Usa Terra para las tareas rutinarias
La salida de Terra cuesta $12/1M, un 60% menos que los $30/1M de Sol. En el Artificial Analysis Coding Agent Index, Terra puntúa ligeramente por encima de Claude Fable 5. Tras la rebaja del 20% de julio, Terra a $2.00/$12.00 también queda por debajo de la antigua tarifa de GPT-5.5.
¿Cuándo sigue teniendo sentido Sol? En sesiones de depuración con varios pasos, planificación de arquitectura sobre grandes bases de código y análisis de seguridad. Son tareas que se benefician de cadenas de razonamiento más extensas. Para programación convencional, análisis y generación de contenido, Terra ofrece resultados comparables con una fracción del consumo de tokens.
Reduce el nivel de esfuerzo
El parámetro reasoning.effort determina cuántos tokens de razonamiento genera el modelo, y el fallo de facturación reportado escala directamente con el número de elementos de razonamiento (k). Con medium, Sol emite menos elementos que con xhigh, por lo que la inflación de la factura se reduce en la misma proporción.
"Uso Terra Ultra y el consumo de tokens parece en realidad mucho más eficiente que con GPT 5.5." — usuario de r/codex
El comportamiento de «horno de tokens» se concentra en Sol con niveles de esfuerzo altos. Cambiar reasoning.effort de xhigh o max a medium o high es el ajuste individual con mayor impacto que puedes hacer.
Maximiza los aciertos de caché
GPT-5.6 incorpora puntos de corte de caché explícitos y una duración mínima de caché de 30 minutos. Las lecturas desde caché reciben un descuento del 90%, lo que reduce el coste de entrada de Sol de $5.00 a $0.50 por 1M. Las escrituras de caché, en cambio, cuestan 1,25 veces la tarifa de entrada: $6.25/1M en Sol.
Estructura los prompts de forma que el mensaje de sistema y el contexto estático queden antes de un punto de corte de caché. El punto de equilibrio depende de tu carga de trabajo concreta: el sobreprecio de escritura representa el 25% de la tarifa de entrada, mientras que el ahorro en lecturas es del 90%; por tanto, necesitas una tasa de aciertos en la que el ahorro de las lecturas compense el recargo de escritura. En cargas donde la mayoría de solicitudes comparten un prompt de sistema largo, el balance pasa rápidamente a tu favor.
Preguntas frecuentes
¿OpenAI ha reconocido el fallo de facturación?
Un miembro del equipo de OpenAI, Mark G., respondió al informe en el foro de la comunidad el 12 de julio de 2026 y solicitó IDs de solicitudes y marcas de tiempo para investigarlo. Hasta agosto de 2026, no se ha confirmado públicamente ninguna corrección ni ajuste retroactivo de facturación.
¿Cómo compruebo si el fallo afecta a mi cuenta?
En cualquier respuesta con varios elementos de razonamiento, suma usage.output_tokens_details.reasoning_tokens y los tokens visibles de la finalización. Si usage.output_tokens supera esa suma en más de unos pocos puntos porcentuales, es probable que el comportamiento de resuma acumulativa documentado en el informe del foro esté afectando a tu factura. Descarga el CSV de uso desde el panel de OpenAI y revísalo por modelo.
¿Debería pasar de Sol a Terra?
Para la mayoría de cargas de trabajo de API, Terra cuesta menos y obtiene resultados competitivos en benchmarks de programación. La ventaja de Sol aparece en las tareas más difíciles: los propios benchmarks de OpenAI muestran que Sol supera más a Terra en razonamiento de varios pasos e investigación de seguridad, donde dedicar más tiempo a pensar ofrece el mayor retorno.