 AIREITER
Con los mismos prompts, GPT-5.6 Luna y DeepSeek V4 Pro acertaron las tres pruebas de nuestra evaluación por API. La capacidad bruta, por tanto, difícilmente será lo que decante la elección. Aquí pesan más el precio y la latencia, especialmente porque la propia página de tarifas de DeepSeek advierte oficialmente de una próxima subida importante. Esto es lo que medimos el 10 de agosto de 2026 y cómo elegir entre ambos.
Pruebas idénticas en ambas APIs: resultados
El 10 de agosto de 2026 enviamos tres tareas idénticas a GPT-5.6 Luna y DeepSeek V4 Pro mediante el mismo pipeline de API, con la configuración predeterminada de cada modelo: corregir un error de Python con una instrucción deliberadamente escueta ("reply with the corrected function only"), resolver un problema de asignación de camiones a tres muelles con una única respuesta correcta (10:10) y extraer datos en JSON estricto con un campo anulable. Los dos modelos resolvieron correctamente las tres.
| Tarea | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
Corrección de error en Python merge_intervals | Correcta (arreglo con max()), 10.7 s | Correcta (arreglo con max()), 16.1 s |
| Razonamiento de asignación de muelles | Correcto (10:10), 8.0 s | Correcto (10:10), 27.2 s |
| Extracción JSON estricta | Válido, esquema exacto, 3.0 s | Válido, esquema exacto, 7.6 s |
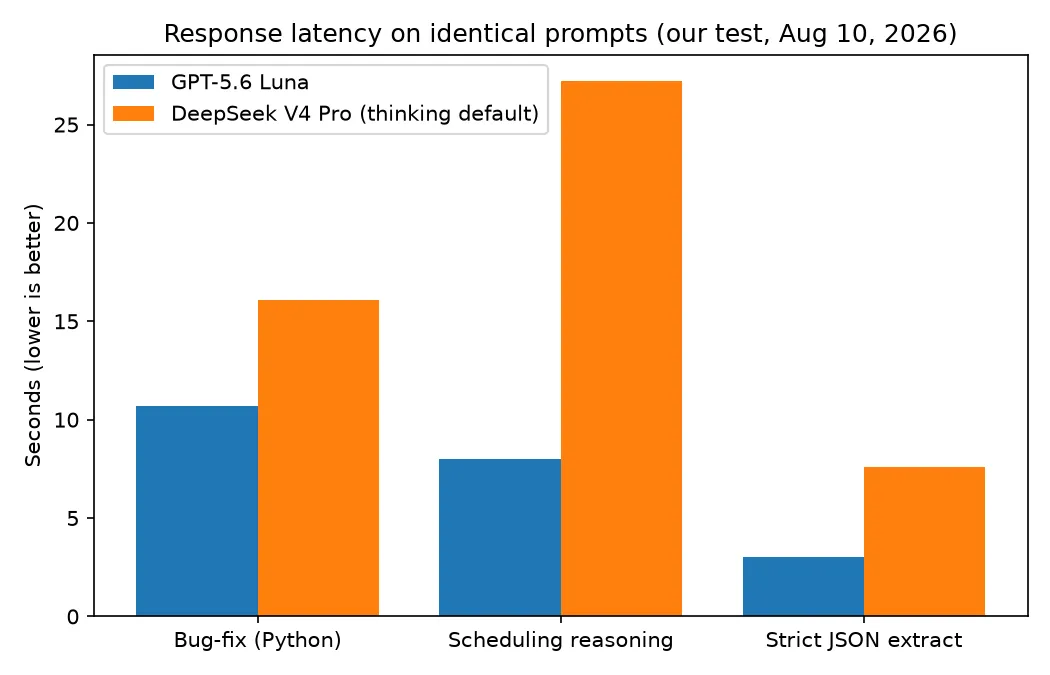
Conviene matizar dos cosas y tener presentes otros dos detalles. Es una comprobación puntual de tres tareas, no un benchmark. V4 Pro usa por defecto el modo de razonamiento, lo que explica buena parte de su diferencia de latencia de 2–3x en esta prueba; puede desactivarse por solicitud, a cambio de empeorar en razonamiento complejo. En seguimiento de instrucciones, Luna devolvió únicamente la función, tal como se le pidió, mientras que V4 Pro la incluyó dentro de un bloque de código Markdown. En un chat no supone problema, pero en un pipeline añade un paso de parsing. Repetimos una vez la tarea de planificación para comprobar la estabilidad: ambos volvieron a responder 10:10.
Precios oficiales verificados y la próxima subida de DeepSeek
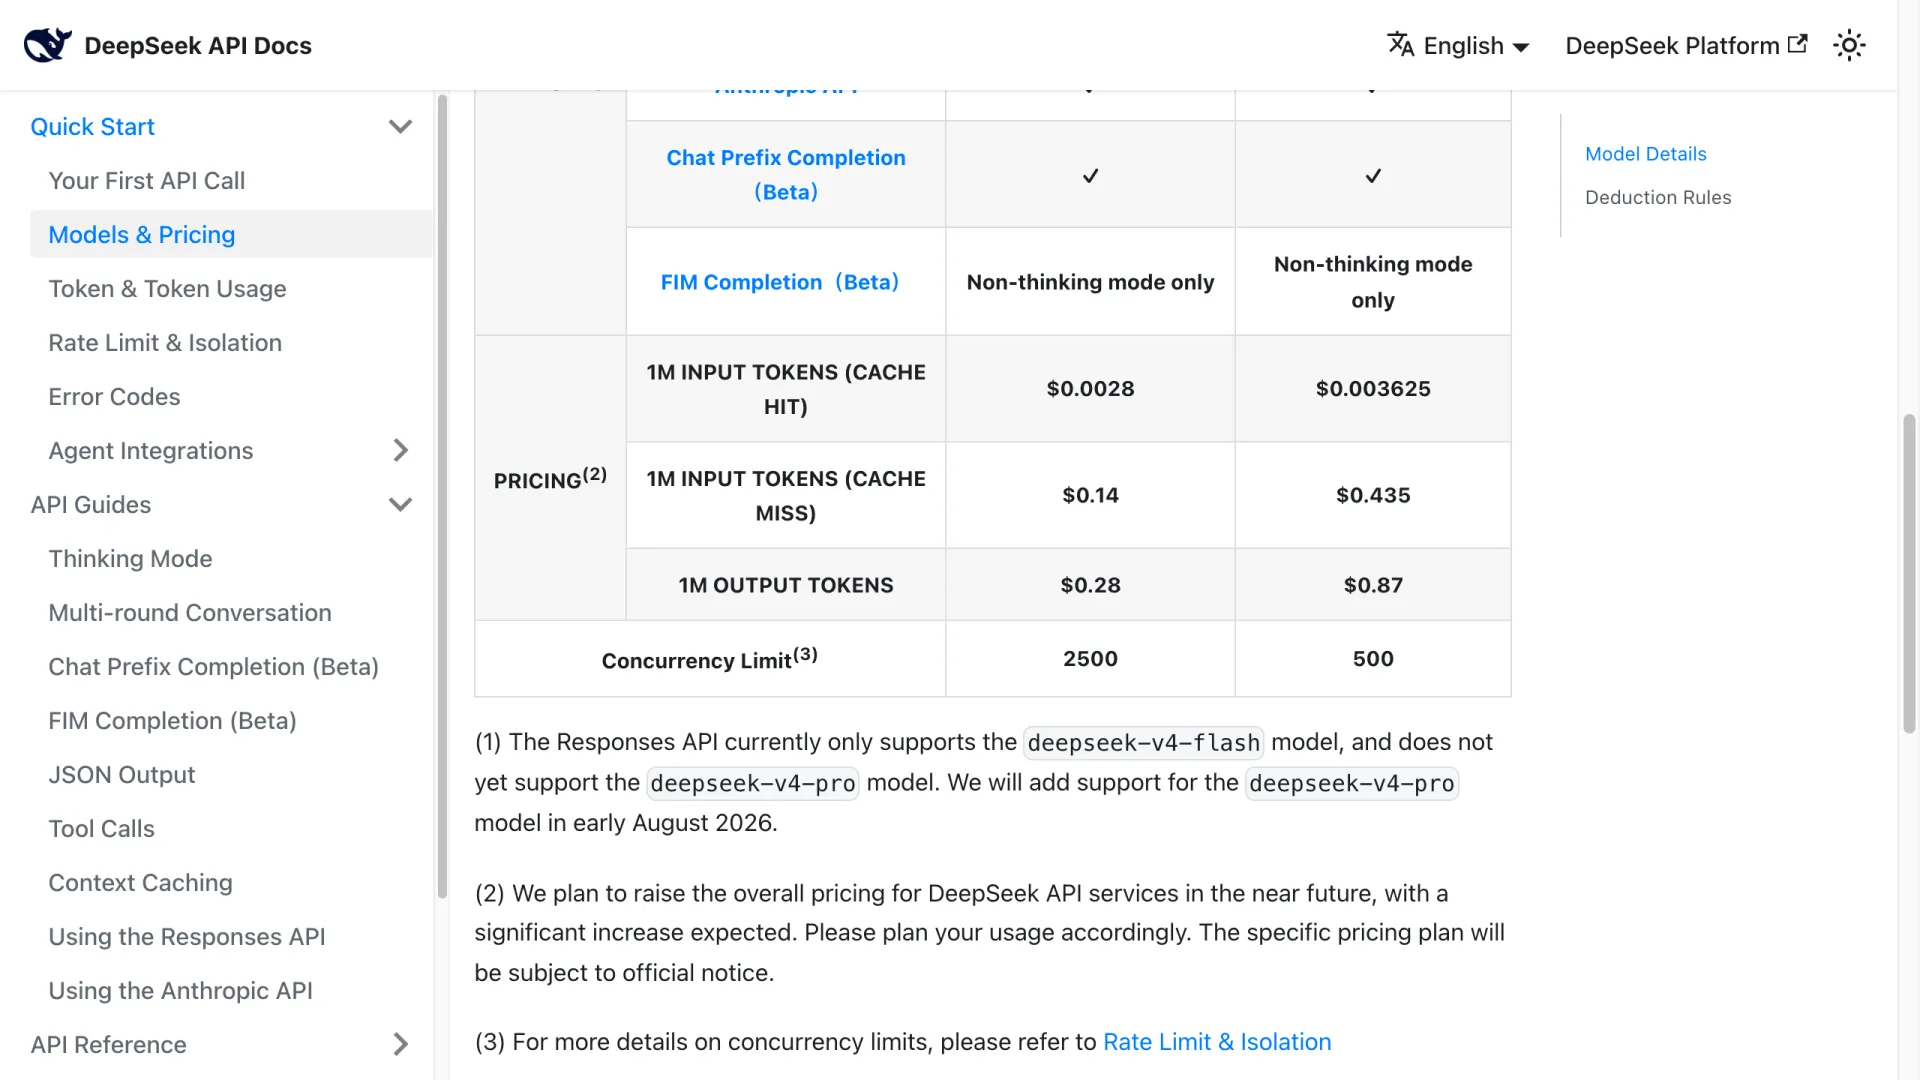
Comprobado en las páginas oficiales de ambos proveedores el 10 de agosto de 2026: GPT-5.6 Luna cuesta $0.20 por millón de tokens de entrada, $0.02 en caché y $1.20 de salida (página del modelo de OpenAI); DeepSeek V4 Pro cuesta $0.435 por millón de tokens de entrada sin acierto de caché, $0.003625 con acierto de caché y $0.87 de salida (página de precios de DeepSeek).
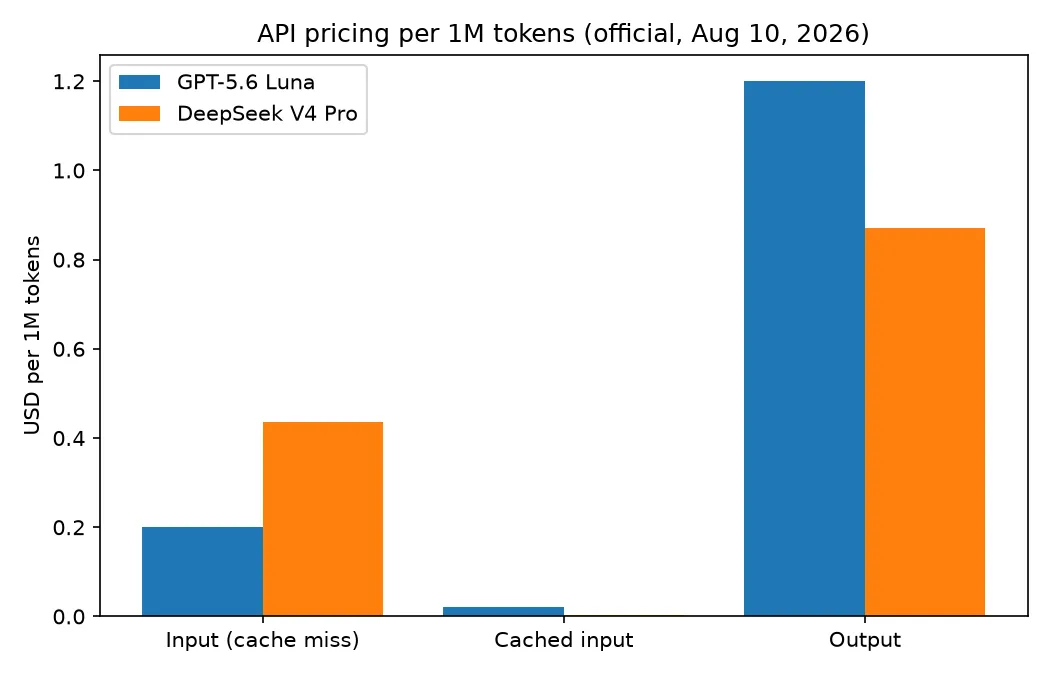
Así que ninguno es «más barato» en todos los escenarios: la entrada sin caché de Luna es un 54% más barata; la salida de V4 Pro cuesta un 27% menos; y los aciertos de caché de V4 Pro son 5.5x más baratos que los de Luna. Todo depende de cómo se distribuyan tus tokens:
- Chat interactivo (1K de entrada + 500 de salida por llamada): Luna $0.0008 frente a V4 Pro $0.00087, prácticamente empate.
- Revisión de repositorio (50K de entrada nueva + 3K de salida): Luna $0.0136 frente a V4 Pro $0.0244; Luna es un 44% más barata.
- Bucle de agente (200K en caché + 20K de entrada nueva + 10K de salida por iteración): Luna $0.020 frente a V4 Pro $0.018. V4 Pro toma ventaja aquí, y la diferencia crece con cada iteración adicional que aprovecha la caché.
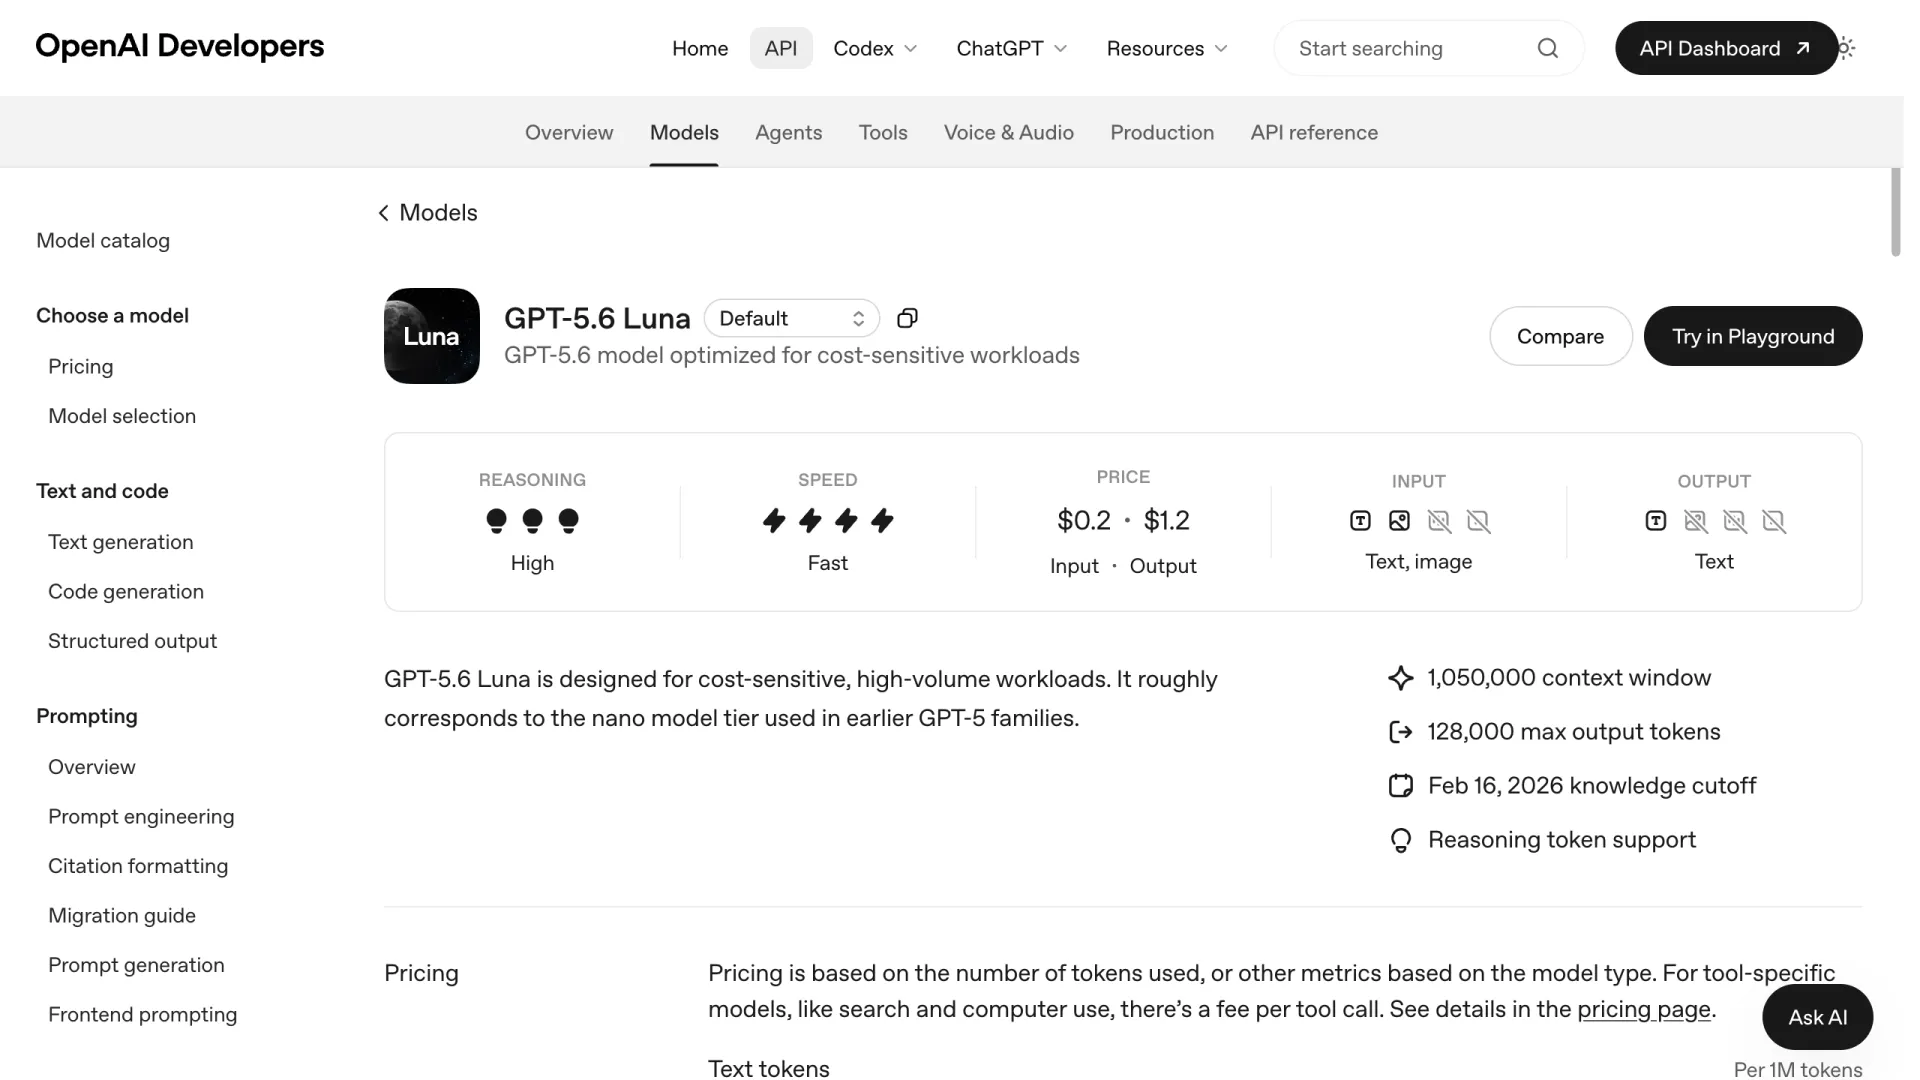
Hay otro dato que limita la vigencia de estos cálculos. La nota al pie 2 de la página de precios de DeepSeek dice: «We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected.» No aporta fecha ni cifras. Pero si V4 Pro te convence por precio, hay una advertencia oficial de que esa ventaja puede caducar. La tarifa de Luna, en cambio, llegó junto con la rebaja de precio de GPT-5.6 de OpenAI en agosto.
La economía de la caché: la baza de V4 Pro
DeepSeek V4 Pro cobra $0.003625 por millón de tokens de entrada en caché, frente a los $0.02 de Luna: una diferencia de 5.5x que domina el coste de las cargas de agentes, donde cada iteración vuelve a leer un prefijo largo que no cambia. Los desarrolladores que ejecutan agentes ya lo han señalado:
DeepSeek v4 Pro & MiMo v2.5 Pro ... son increíblemente baratos para trabajo dirigido por agentes gracias a sus precios bajísimos de entrada en caché ($0.0036/mtok). Para Luna, el precio de entrada en caché ... la página de precios lo sitúa en $0.02/mtok, & eso es 5x más caro. — comentarista de Hacker News, en el hilo de lanzamiento de GPT-5.6
Ten también en cuenta el recargo por escritura de caché de Luna: las escrituras se facturan a 1.25x la tarifa de entrada sin caché (página del modelo de OpenAI), y los prompts que superan los 272K tokens de entrada se cobran a 2x la entrada y 1.5x la salida para toda la solicitud. Si el contexto de tu agente supera habitualmente los 272K tokens, el precio efectivo de Luna se duplica aproximadamente justo donde la caché de V4 Pro resulta más potente.
Antes de calcular costes, confirma las tarifas en la documentación oficial
Durante la investigación encontramos cifras publicadas por terceros para estos dos modelos que situaban la entrada de V4 Pro entre $0.435 y $1.74 por millón de tokens, además de ventanas de contexto para Luna que iban desde 400K hasta 1.05M. Tres comprobaciones llevan menos de un minuto: consulta los precios solo en las dos páginas oficiales enlazadas arriba, confirma la cadena de versión del modelo —la API actual sirve DeepSeek-V4-Pro; Flash está fijado en -0731— y verifica si el «precio de entrada» citado corresponde a un acierto o un fallo de caché; en V4 Pro, ambas tarifas difieren en 120x.
Las especificaciones que realmente cambian el encaje
Más allá del precio, hay cuatro diferencias que determinan qué carga de trabajo conviene a cada modelo: límite de salida, modalidad, apertura y superficie de API. Ambos anuncian una ventana de contexto de alrededor de 1M tokens —Luna: 1,050,000 tokens; V4 Pro: 1M—, así que el contexto por sí solo no los separa.
| Especificación (verificada el 10 de agosto de 2026) | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
| Ventana de contexto | 1,050,000 | 1M |
| Máximo de tokens de salida | 128K | 384K |
| Modalidad de entrada | Texto + imagen | Solo texto |
| Control del razonamiento | Niveles de esfuerzo (bajo→máximo) | Thinking activado (predeterminado) / desactivado |
| Pesos abiertos | No | Sí (autoalojable) |
| Responses API | Sí | Aún no (oficial: principios de agosto de 2026) |
| Límite de concurrencia | Según nivel de uso | 500 |
| Corte de conocimiento | 16 de febrero de 2026 | No indicado en la página de precios |
El límite de 384K tokens de salida de V4 Pro triplica los 128K de Luna. Es relevante para generar una base de código de una sola vez, traducciones extensas o extracción estructurada masiva, casos en los que dividir el trabajo en fragmentos añade posibles puntos de fallo. La entrada de imágenes de Luna importa por otra razón, y los usuarios de DeepSeek lo mencionan sin que nadie se lo pregunte:
Mi única queja real es que no pueden trabajar con imágenes, lo que limita su capacidad para depurar de forma autónoma algunos tipos de problemas. — comentarista de Hacker News, sobre usar DeepSeek en proyectos personales
Los pesos abiertos inclinan la balanza en la otra dirección: V4 Pro se puede descargar y autoalojar, por lo que es la única opción de estas dos para requisitos de residencia de datos. Eso sí, servir un modelo de este tamaño exige hardware serio con varias GPU; no es un proyecto para un fin de semana.
Los benchmarks dependen más del modo de esfuerzo que del modelo
Las puntuaciones publicadas de GPT-5.6 Luna frente a DeepSeek V4 Pro pueden cambiar de ganador según el modo de esfuerzo usado en cada prueba. Los mismos dos modelos obtienen 33.3 frente a 44.3 —gana V4 Pro— en un rastreador que ejecuta Luna con esfuerzo bajo y V4 Pro con esfuerzo máximo, y 52 frente a 45 —gana Luna— en Artificial Analysis, que ejecuta ambos al máximo. Ninguna cifra es incorrecta: miden configuraciones distintas.
La misma trampa aparece en los datos de latencia. Artificial Analysis sitúa el tiempo de Luna hasta el primer token de respuesta con esfuerzo máximo en 132 segundos: en ese modo, Luna razona durante unos dos minutos antes de contestar. En nuestra prueba con los ajustes predeterminados, Luna respondió en 3–10.7 segundos. Ambos datos son reales; solo uno se parece a tu configuración de producción. Una vez empieza a emitir, Luna gana claramente en rendimiento: 202 tokens/s frente a 78 (Artificial Analysis).
Los modos de esfuerzo también alteran enormemente las puntuaciones de un mismo modelo: V4 Pro logra 90.1% en GPQA Diamond con thinking al máximo, pero 72.9% con thinking desactivado. En benchmarks compartidos a esfuerzo máximo, Luna lidera SWE-Bench Pro por 62.7% frente a 55.4%, y empatan en BrowseComp (83.3 frente a 83.4). Antes de confiar en cualquier tabla de resultados, plantea tres preguntas: ¿qué modo de esfuerzo se usó?, ¿la latencia incluye el tiempo de razonamiento? y ¿las versiones del benchmark son idénticas? La diferencia de 84.7 frente a 67.9 en Terminal-Bench de un rastreador compara v2.1 con v2.0.
¿Cuál deberías usar?
Elige GPT-5.6 Luna para productos orientados al usuario: en nuestra prueba fue 2–3x más rápido en las tres tareas con los ajustes predeterminados, su entrada sin caché cuesta la mitad que la de V4 Pro y acepta imágenes. Elige DeepSeek V4 Pro para bucles de agentes que reutilizan mucha caché, salidas de más de 128K tokens o cualquier caso que deba ejecutarse en tu propio hardware, pero incorpora la advertencia oficial de subida de precios a cualquier compromiso a largo plazo. Ambos están a un simple cambio de endpoint en GPT-5.6 Luna y DeepSeek V4 Pro, así que puedes repetir nuestros tres prompts sobre tu propia carga de trabajo antes de decidir.
| Tu carga de trabajo | Elige | Dato decisivo |
|---|---|---|
| Chatbots y aplicaciones orientadas al usuario | Luna | Latencia de 3.0–10.7 s frente a 7.6–27.2 s en nuestra prueba; 202 frente a 78 tok/s |
| Procesamiento masivo de entrada nueva | Luna | $0.20 frente a $0.435 por 1M de entrada sin caché |
| Bucles de agentes sobre contexto estable | V4 Pro | $0.003625 frente a $0.02 por 1M de entrada en caché |
| Salidas largas en una sola generación | V4 Pro | 384K frente a 128K de salida máxima |
| Visión (capturas de pantalla, PDF como imágenes) | Luna | V4 Pro solo admite texto |
| Autoalojamiento / residencia de datos | V4 Pro | Pesos abiertos; Luna solo está disponible por API |
| Certeza presupuestaria hasta 2027 | Luna | Aviso oficial de DeepSeek sobre la subida de precios |
Preguntas frecuentes
¿Cuál es más barato, GPT-5.6 Luna o DeepSeek V4 Pro?
Ninguno en todos los casos. La entrada sin caché de Luna es un 54% más barata ($0.20 frente a $0.435 por 1M de tokens); la entrada en caché de V4 Pro es 5.5x más barata ($0.003625 frente a $0.02) y su salida cuesta un 27% menos ($0.87 frente a $1.20). Los agentes con mucha caché salen más baratos en V4 Pro; las cargas con entrada nueva, en Luna.
¿Los dos modelos admiten una ventana de contexto de 1M tokens?
Sí: Luna ofrece 1,050,000 tokens y V4 Pro ofrece 1M. Ten presente que las solicitudes de Luna que superan los 272K tokens de entrada se facturan a 2x la entrada y 1.5x la salida para toda la solicitud.
¿DeepSeek V4 Pro es de código abierto y se puede autoalojar?
Sí. V4 Pro ofrece pesos abiertos y se puede autoalojar, a diferencia de Luna, que solo funciona por API; pero cuenta con hardware de servicio con varias GPU, no con una única estación de trabajo.
¿GPT-5.6 Luna admite entrada de imágenes?
Sí, Luna acepta entrada de texto e imágenes. DeepSeek V4 Pro solo admite texto. Sus propios usuarios citan la falta de soporte visual como la principal limitación para flujos de depuración autónoma.
¿Cuál es el máximo de tokens de salida de cada modelo?
DeepSeek V4 Pro puede emitir hasta 384K tokens por respuesta; GPT-5.6 Luna tiene un límite de 128K. Para generar de una sola vez documentos largos o archivos de código grandes, el límite de V4 Pro es 3x superior.
Lecturas relacionadas
- DeepSeek V4 Pro vs GPT-5.6 Sol: el mismo buque insignia de DeepSeek frente a la gama media de OpenAI
- Análisis de GPT-5.6 Luna: Luna por sí solo, más allá de esta comparativa
- DeepSeek V4 Flash vs V4 Pro: si el riesgo de precio de V4 Pro te lleva a bajar de gama