 AIREITER
Los $0.15 por millón de tokens de entrada son solo el punto de partida con GLM-5.3-Flash. Los aciertos de caché, los tokens de salida, el razonamiento forzado y un checkpoint de aproximadamente 320B parámetros son los factores que deciden si conviene usar la API o desplegar los pesos abiertos en un caso real.
El precio vigente de GLM-5.3-Flash
La página oficial de precios de Z.AI fija para GLM-5.3-Flash una tarifa de $0.15 por 1 millón de tokens de entrada, $0.03 por 1 millón de tokens de entrada en caché y $0.50 por 1 millón de tokens de salida. También muestra una promoción temporal del 50%, que termina a las 24:00 del 9 de septiembre de 2026, hora UTC+8 (Singapur).
| Concepto de GLM-5.3-Flash | Precio de lista / 1M tokens | Promoción / 1M tokens |
|---|---|---|
| Entrada nueva | $0.15 | $0.075 |
| Entrada en caché | $0.03 | $0.015 |
| Salida | $0.50 | $0.25 |
| Almacenamiento de entrada en caché | Gratis por tiempo limitado | Gratis por tiempo limitado |
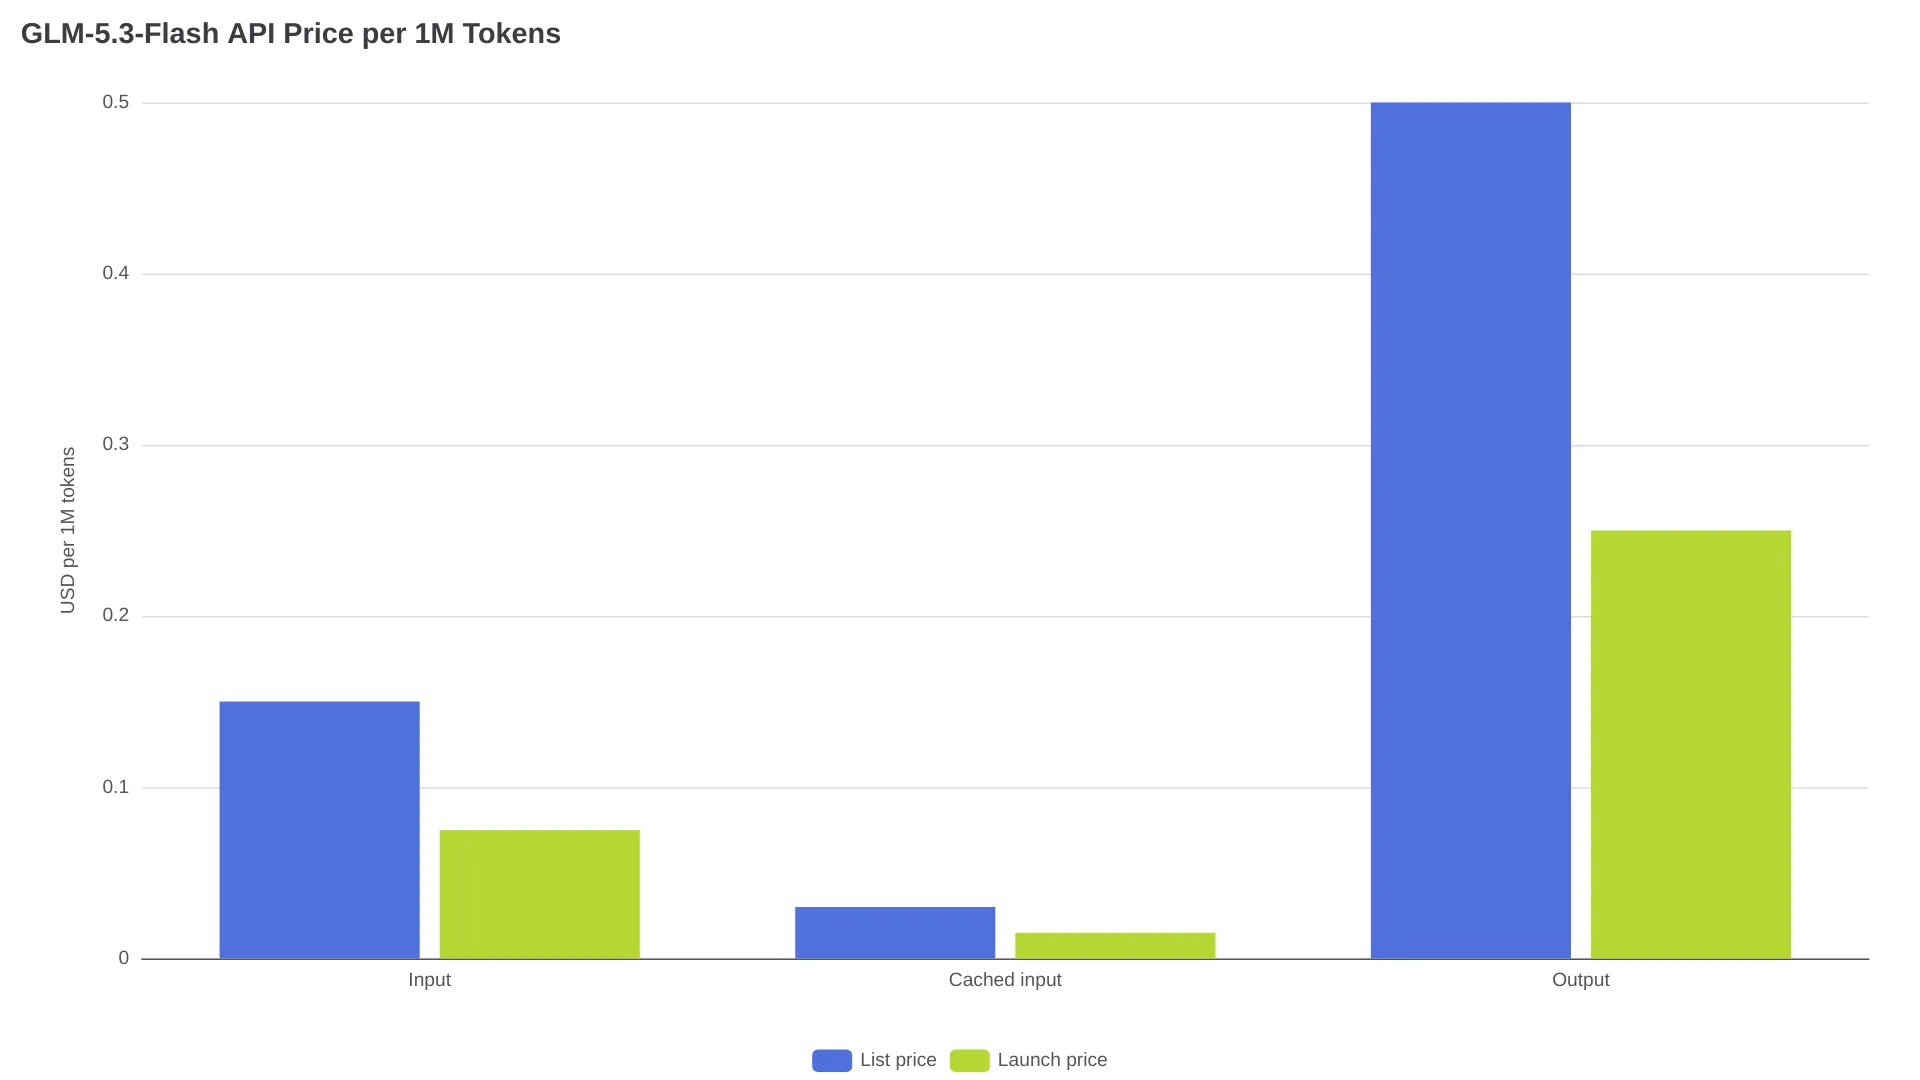
Conviene tratar esa rebaja del 50% como un precio promocional temporal, no como la base de un presupuesto de producción. El anuncio de lanzamiento de Z.AI identifica ox-alpha como la denominación de la vista previa anterior.
La misma tabla oficial sitúa a GLM-5.3 estándar en $1.40 por entrada, $0.26 por entrada en caché y $4.40 por salida, todo por 1 millón de tokens. A precio de lista, Flash cuesta aproximadamente un 89% menos tanto en entrada como en salida. Es una comparación de precios, no una afirmación de que ambos modelos ofrezcan la misma calidad, latencia o comportamiento operativo.
Qué compras realmente: acceso por API, no un modelo local más pequeño
GLM-5.3-Flash es un modelo multimodal de pesos abiertos con licencia MIT, 320B parámetros totales y 18B parámetros activos por token. La ficha oficial del modelo en Hugging Face documenta el checkpoint público zai-org/GLM-5.3-Flash y las opciones de servicio local; en su material de lanzamiento, Z.AI describe una ventana de contexto de 1 millón de tokens y entradas de texto, imagen y vídeo.
Que tenga “18B activos” se refiere al cálculo de expertos seleccionados, no a la memoria total necesaria. Los pesos completos, la caché KV, la sobrecarga de ejecución, el procesamiento multimodal y la longitud de contexto siguen determinando si el despliegue local es viable.
| Vía de acceso | Qué ofrece | Principal limitación |
|---|---|---|
| API de Z.AI | Inferencia alojada, facturada por tokens de entrada, entrada en caché y salida | Límites de cuenta y latencia de razonamiento |
| Checkpoint oficial | Pesos con licencia MIT para autoalojamiento o adaptación | Infraestructura de alta memoria, según precisión y cuantización |
| Build cuantizada de la comunidad | Archivos más pequeños para algunos runtimes locales | La calidad del build, las modalidades admitidas, la velocidad y la compatibilidad varían |
Un precio por token bajo y un coste de alojamiento bajo no son la misma afirmación: con tráfico irregular, se paga la API según llegan las peticiones; al autoalojar, se reserva capacidad de servicio incluso durante los periodos inactivos.
Cómo se factura la API en cargas reales
El coste de GLM-5.3-Flash depende de la mezcla de entrada nueva, entrada que se reconozca como caché y salida generada:
coste = (tokens_entrada_nueva / 1,000,000 × tarifa_entrada)
      + (tokens_entrada_cache / 1,000,000 × tarifa_cache)
      + (tokens_salida / 1,000,000 × tarifa_salida)
A precio de lista, 10 millones de tokens de entrada nueva y 2 millones de salida cuestan $2.50: $1.50 por la entrada y $1.00 por la salida. Durante la promoción, ese mismo volumen cuesta $1.25.
| Carga de trabajo | Cálculo a precio de lista | Total a precio de lista | Total promocional |
|---|---|---|---|
| 10M de entrada nueva + 2M de salida | $1.50 + $1.00 | $2.50 | $1.25 |
| 2M de entrada nueva + 8M de entrada en caché + 2M de salida | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 100K de entrada nueva + 10K de salida | $0.015 + $0.005 | $0.020 | $0.010 |
La cifra combinada de $0.10 por millón que muestra Artificial Analysis parte de una mezcla definida de 7:2:1 entre aciertos de caché, entrada y salida. Sirve para comparar una carga concreta, pero no representa una tarifa universal de GLM-5.3-Flash.
El ahorro de caché exige un acierto de caché real. El esquema de respuesta de Chat Completion de Z.AI expone usage.prompt_tokens_details.cached_tokens, por lo que la contabilidad en producción debería registrar ese campo en lugar de dar por hecho que los prompts parecidos o repetidos recibirán descuento. Un usuario de r/opencodeCLI resumió así la economía del lanzamiento:
“There's a 50% discount offer until September 9th, and its context consumption is much better than in dsv4f...” — u/CriteriumA, discusión en Reddit
La fecha del descuento está confirmada en la tabla de tarifas de Z.AI; la comparación y la experiencia de uso son la opinión de ese comentarista. Un contexto repetido y estable puede mejorar la reutilización de caché, pero no elimina los costes de salida, reintentos, herramientas o límites de cuenta.
Una plantilla breve para calcular el presupuesto
Proyecta cuatro partidas separadas: entrada nueva, entrada en caché, salida y herramientas de pago. Z.AI cobra $0.01 por uso de Web Search, así que las búsquedas repetidas de un agente pueden superar una estimación basada únicamente en tokens.
| Supuesto de uso mensual | Fórmula a precio de lista | Coste mensual |
|---|---|---|
| 100M de entrada nueva + 20M de salida | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 20M de entrada nueva + 80M de entrada en caché + 20M de salida | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| 100 llamadas a Web Search | 100 × $0.01 | $1.00 |
Son ejemplos aritméticos, no una cuota. Añade por separado los reintentos y las ejecuciones de agentes abandonadas. Si el volumen de salida es elevado, fijar un valor realista de max_tokens y utilizar un reasoning_effort inferior cuando encaje puede importar más que optimizar un pequeño prefijo del prompt.
Limitaciones de la API de Z.AI antes de migrar
La API oficial de Z.AI usa https://api.z.ai/api/paas/v4/ como URL base general y https://api.z.ai/api/paas/v4/chat/completions para las completions de chat. La autenticación se realiza con una clave API Bearer. En su introducción a la API, Z.AI documenta patrones de cliente compatibles con OpenAI para Python, Node.js y Java mediante una URL base personalizada.
La referencia actual de Chat Completion menciona GLM-5.3-FLASH en las descripciones de thinking y razonamiento, pero el enum de modelos renderizado no muestra glm-5.3-flash; tanto la página oficial de precios como los materiales de lanzamiento sí incluyen la SKU Flash. Antes de redirigir tráfico de producción, prueba el ID exacto del modelo alojado con una solicitud pequeña.
| Detalle de integración | Limitación verificada |
|---|---|
| ID de modelo alojado para probar | glm-5.3-flash; confirma que lo acepta el esquema activo de la cuenta |
| Endpoint alojado | https://api.z.ai/api/paas/v4/chat/completions |
| Autenticación | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASH utiliza thinking activado; la profundidad se controla con reasoning_effort |
| Esfuerzo de razonamiento | low, high o max |
Máximo de max_tokens | 131,072 en la referencia actual de parámetros |
| Coding Plan | Clave, endpoints y sistema de créditos independientes; no equivale a un saldo de API general. Consulta la guía de inicio rápido de Coding Plan de Z.AI |
Z.AI establece max como nivel de esfuerzo de razonamiento predeterminado. La tarifa por token no cambia según el nivel de esfuerzo, pero el razonamiento puede modificar el uso de salida y el tiempo de espera. Para los límites de cuenta, Z.AI remite a un panel de límites de tasa específico de cada cuenta; su guía pública no establece un límite numérico universal para todas las cuentas de API.
Pesos abiertos o API alojada: qué cambia en el despliegue
La ficha oficial del modelo incluye recetas de servicio local para Transformers, vLLM, SGLang, TokenSpeed y KTransformers, pero esas recetas no demuestran que el despliegue sea práctico en una GPU de consumo.
Usa la API alojada cuando el tráfico sea intermitente o no dispongas de hardware de inferencia con mucha memoria. Considera un servicio distribuido o local cuando la utilización sea sostenida, o cuando el control sobre el tratamiento de datos justifique el coste operativo. Una build de texto con precisión reducida puede no reproducir la configuración multimodal oficial.
Cuándo empieza a compensar el autoalojamiento
Una estimación de GetDeploying sitúa un despliegue de 4 bits en torno a 192 GB de memoria GPU, cerca de 384 GB para 8 bits y 768 GB para BF16. Estima que una configuración MI300X a $2.90 por hora cuesta aproximadamente $2,088 al mes si funciona de forma continua, y que el punto de equilibrio entre API y autoalojamiento ronda los 14 millones de tokens por hora con una proporción de entrada a salida de 5:1.
Son estimaciones de terceros, no garantías de hardware de Z.AI. La configuración de 192 GB a 4 bits se califica como ajustada; la caché KV, la sobrecarga de ejecución, el procesamiento multimodal, el batching y el tiempo inactivo pueden desplazar el punto de equilibrio. Antes de optar por inferencia local, compara el coste de infraestructura por hora, la utilización, los tokens efectivos por hora, la tasa de aciertos de caché y el coste por tarea completada.
GLM-5.3-Flash frente a GLM-5.3: dónde está la diferencia
Flash y GLM-5.3 estándar tienen tablas de tarifas y posiciones de despliegue distintas.
| Pregunta | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Precio de lista de entrada | $0.15 / 1M | $1.40 / 1M |
| Precio de lista de entrada en caché | $0.03 / 1M | $0.26 / 1M |
| Precio de lista de salida | $0.50 / 1M | $4.40 / 1M |
| Promoción temporal | 50% de descuento hasta el 9 de septiembre de 2026 UTC+8 | No aparece una promoción equivalente a la de Flash |
| Checkpoint de pesos abiertos | Figura un checkpoint oficial con licencia MIT | Listado de modelo independiente; no infieras que los pesos sean idénticos |
| Posicionamiento multimodal | Multimodal nativo; Z.AI describe entrada de imagen y vídeo | Evalúa por separado la cobertura de GLM-5.3 estándar |
| Despliegue local | Requiere un checkpoint grande y servicio con mucha memoria | Usa su propia documentación de modelo y despliegue |
Elige Flash primero cuando importe el coste por token, la entrada multimodal o una vía de pesos abiertos, y la aplicación pueda asumir el razonamiento forzado y las limitaciones del proveedor. Opta por GLM-5.3 estándar solo después de medir si su tarifa más alta aporta una diferencia de capacidad o fiabilidad relevante para la aplicación.
Preguntas frecuentes
¿Cuál es el precio actual de la API de GLM-5.3-Flash?
Las tarifas oficiales de lista son $0.15 por entrada, $0.03 por entrada en caché y $0.50 por salida por cada 1M de tokens; la tabla anterior muestra los precios temporales con el 50% de descuento.
¿La entrada en caché se cobra a $0.03?
Sí, cuando Z.AI reconoce esos tokens como almacenados en caché. El almacenamiento de entrada en caché aparece por separado como gratuito por tiempo limitado, así que no deben confundirse el estado del almacenamiento y la facturación por aciertos de caché.
¿GLM-5.3-Flash es open source?
La descripción precisa es que se trata de un checkpoint de pesos abiertos con licencia MIT. La licencia permite un uso amplio, pero el modelo de 320B parámetros totales sigue requiriendo mucha memoria, software compatible y capacidad de servicio.
¿Puedo ejecutar GLM-5.3-Flash en un portátil normal?
No como despliegue práctico a precisión completa. Incluso las estimaciones de terceros para 4 bits rondan los 192 GB de memoria GPU, y los 18B parámetros activos no eliminan el coste de almacenamiento y ejecución del checkpoint completo.
¿GLM-5.3-Flash es más rápido que GLM-5.3?
“Flash” está respaldado como una posición de coste y cálculo activo, no como una garantía universal de latencia. Artificial Analysis informa de 48.7 tokens de salida por segundo a través de Z.AI y 42.57 segundos hasta el primer token de respuesta en su configuración medida; el tiempo de razonamiento y la forma de la carga pueden dominar el tiempo de respuesta percibido.
¿Coding Plan ofrece el mismo saldo de API?
No. La guía de inicio rápido de Coding Plan de Z.AI documenta una clave de Coding Plan independiente, endpoints separados y acceso limitado a herramientas y productos compatibles oficialmente. Una suscripción a Coding Plan no debe convertirse directamente en un presupuesto de API pública en dólares por token.
La API es la opción de menor riesgo cuando el tráfico es intermitente y el hardware no está ya amortizado; el servicio local es una decisión económica distinta, dependiente de una utilización sostenida, la memoria y los requisitos de control de datos.