 AIREITER
Gemini 3.5 Flash produce 2,6 veces más tokens de salida por segundo que Gemini 3.1 Pro, cuesta un 25% menos por token y le gana por poco en el Intelligence Index de Artificial Analysis (50 frente a 46). Sin embargo, Gemini 3.1 Pro mantiene una ventaja de 5 puntos en ARC-AGI-2 (77,1% frente a 72,1%), y el rendimiento de Flash en recuperación con contexto largo cae del 84,9% al 77,3% al superar los 128k tokens. La elección depende de la carga de trabajo: Flash prioriza el rendimiento y la latencia de las llamadas a herramientas; Pro, la profundidad de razonamiento en procesos de varios pasos. Los benchmarks agregados condensan ambas prioridades en una cifra que puede ocultar cuál necesita realmente tu caso de uso.
Benchmarks: dónde destaca realmente cada modelo
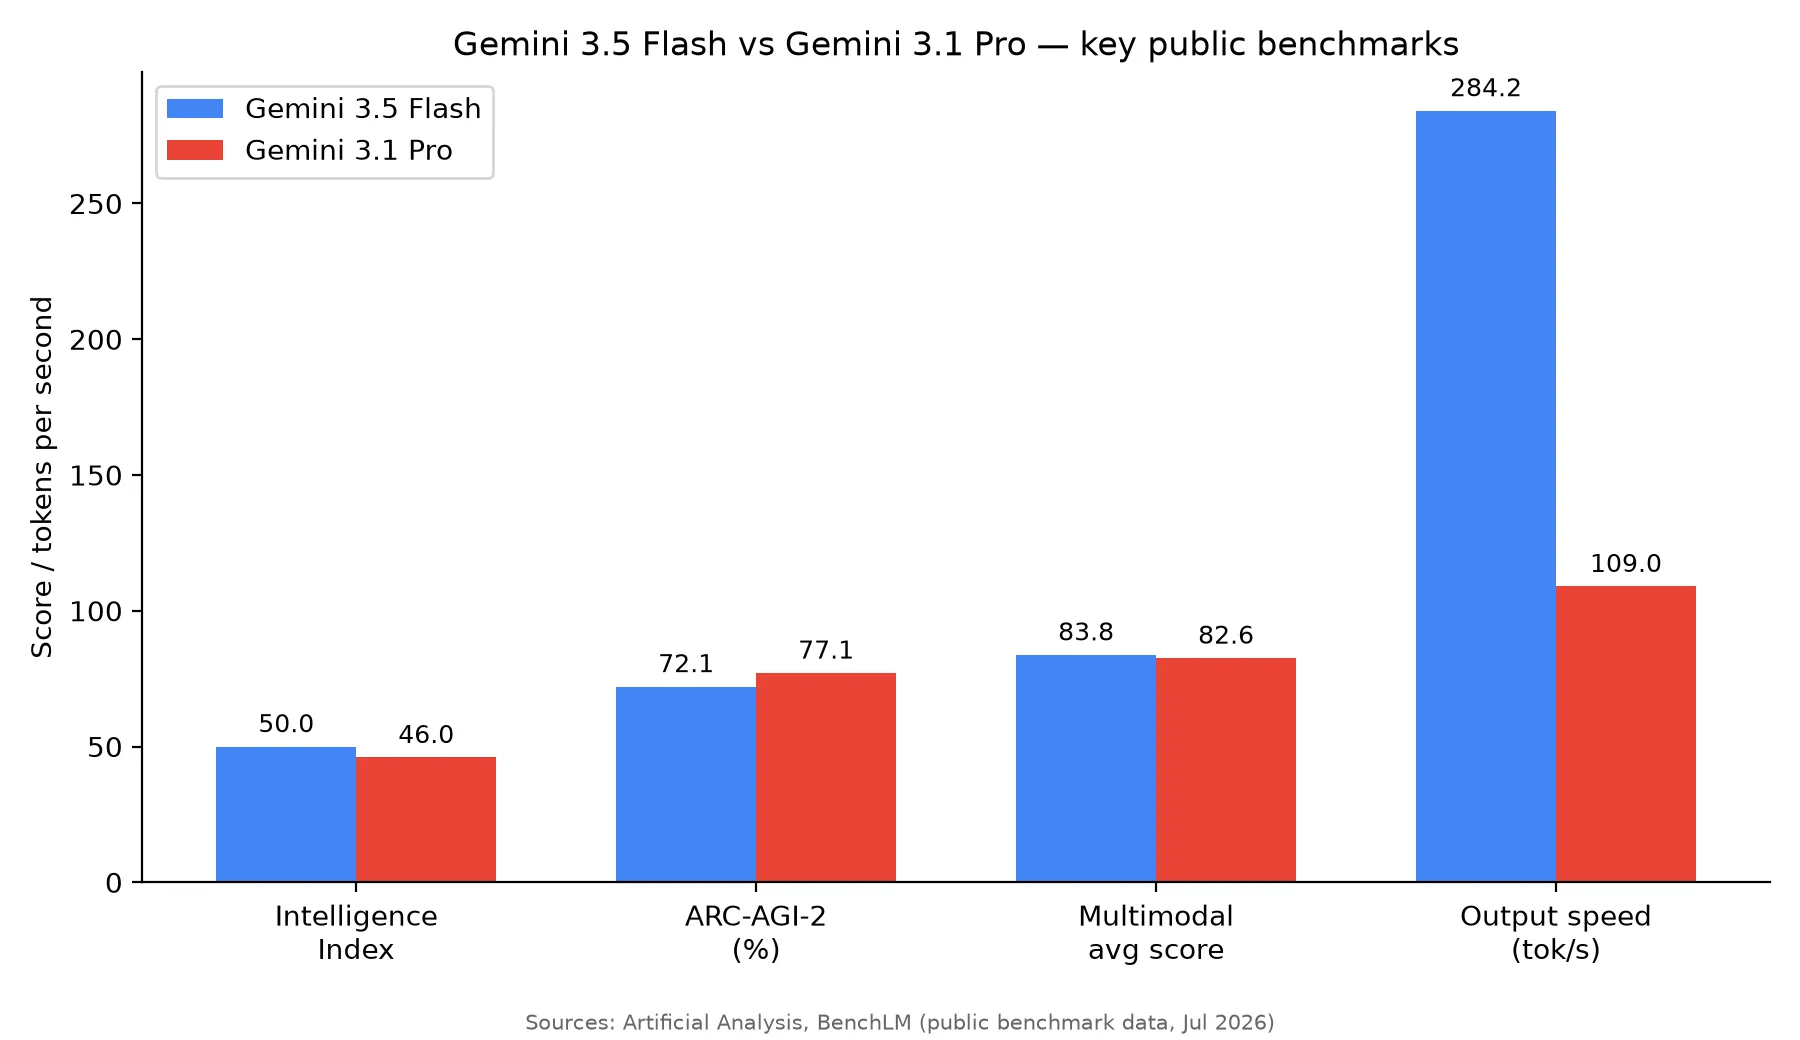
| Métrica | Gemini 3.5 Flash | Gemini 3.1 Pro | Ganador |
|---|---|---|---|
| Intelligence Index (Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2, razonamiento abstracto (BenchLM) | 72,1% | 77,1% | Pro |
| MRCR v2 con 128k de contexto (nxcode) | 77,3% (frente al 84,9% con contexto más corto) | no publicado para la misma longitud | Datos insuficientes |
| Puntuación media multimodal (BenchLM) | 83,8 | 82,6 | Flash |
| Velocidad de salida (BenchLM) | 284,2 tok/s | 109 tok/s | Flash (2,6x) |
| Elo de GDPval-AA, tareas de agentes en el mundo real (apiyi) | 1656 | 1314 | Flash |
Flash domina las métricas centradas en rendimiento y ejecución de tareas generales. Pro cuenta con una ventaja clara y documentada en la profundidad de razonamiento que mide ARC-AGI-2. En recuperación con contexto largo, Flash muestra una regresión documentada más allá de los 128k tokens, pero no hay una puntuación pública equivalente de Pro; lo correcto es considerarlo inconcluso, no una victoria de Pro. Esta división encaja directamente con el tipo de tarea que ejecutas y aporta más información que el número agregado del Intelligence Index.
Hay una salvedad metodológica que señala la propia comparación de BenchLM: de los aproximadamente 34 benchmarks con resultados publicados para ambos modelos, solo 3 categorías son comparables de forma directa. Pro tiene resultados exclusivos en 14 benchmarks y Flash en 17, y los ajustes de presupuesto de razonamiento no siempre coinciden entre ambos. La tabla anterior es fiable como orientación general; las diferencias en ARC-AGI-2 y MRCR v2 son lo bastante amplias para tomarlas en serio, pero una distancia de 1 o 2 puntos en una métrica compartida no debería interpretarse como concluyente.
Los puntos débiles de la ventaja de Flash
La diferencia de 5 puntos en ARC-AGI-2 es la mayor brecha en una categoría individual que encontró la comparativa de BenchLM entre los dos modelos. ARC-AGI-2 está diseñado específicamente para resistir atajos basados en la detección de patrones, de modo que una ventaja de 5 puntos aquí es una señal más sólida de profundidad de razonamiento que una diferencia similar en un benchmark convencional. El resultado de nxcode en MRCR v2 apunta en la misma dirección: la precisión de recuperación de Flash baja del 84,9% al 77,3% a medida que el contexto se acerca a 128k tokens. La puntuación de Pro a esa misma longitud no se ha publicado, por lo que no es una derrota directa documentada frente a Pro; sí es una regresión documentada de Flash que no aparece en la tabla de benchmarks de Pro.
Apunte anecdótico, no evidencia de benchmark: en un hilo de Reddit r/GeminiAI donde se preguntaba qué modelo preferían los usuarios para tareas difíciles, varios comentarios describían a Flash como superior a Pro «en todo salvo en contexto largo y razonamiento abstracto». Son unas pocas opiniones, no datos, pero coinciden precisamente con las dos excepciones que muestran los benchmarks. Sirve como una comprobación de cordura ligeramente útil, no como prueba de nada por sí sola.
Precio y caché: cuánto cuesta realmente cada uno
La diferencia de precio base es menos amplia de lo que parece inicialmente:
- Gemini 3.5 Flash: $1.50 / millón de tokens de entrada, $9 / millón de tokens de salida
- Gemini 3.1 Pro: $2 / millón de tokens de entrada, $12 / millón de tokens de salida
Sobre el papel, el descuento es del 25%, no la diferencia de 4-8x que Flash tuvo anteriormente frente a modelos Pro más antiguos. El factor decisivo está en la caché:
- Las escrituras de caché de Flash son gratuitas; la entrada desde caché cuesta $0.15/millón de tokens
- Las escrituras de caché de Pro cuestan $0.38/millón de tokens; la entrada desde caché cuesta $0.50/millón de tokens, más de 3 veces la tarifa de entrada en caché de Flash
En cualquier flujo que reenvíe el mismo prompt de sistema o contexto documental en varios turnos —agentes conversacionales, asistentes de programación con contexto persistente del código o bots de soporte multivuelta—, esa diferencia de caché se acumula rápido. En una única solicitud apenas se aprecia; en una sesión de agente de mil turnos, sí.
La brecha tampoco es constante. El desglose de precios de apiyi indica que, al superar aproximadamente los 200k tokens de contexto, la diferencia de precio entre ambos modelos se reduce al 25-50%, porque la economía por token de los dos converge a esa escala. Si tu carga de trabajo está dominada por documentos muy largos procesados en una sola llamada, en lugar de llamadas cortas repetidas, el argumento de precio a favor de Flash pierde fuerza.
Un ejemplo concreto: un bot de soporte que envía 1M de tokens de entrada en caché y genera 500K tokens de salida al día. Con Flash, serían $0 por la escritura de caché más $0.15 x 1 (entrada en caché) + $9 x 0.5 (salida) = $4.65/día. Con Pro, la misma carga cuesta $0.38 (escritura de caché, una sola vez) + $0.50 x 1 (entrada en caché) + $12 x 0.5 (salida) = aproximadamente $6.88/día el primer día, estabilizándose en $6.50/día tras la primera escritura. En un mes, la diferencia ronda los $140 frente a $195, antes de considerar el razonamiento más profundo de Pro en las solicitudes que realmente lo necesiten.
Bucles de agentes: Flash gana en velocidad, no siempre en fiabilidad
El benchmark de bucles de agentes de nxcode ejecutó un ciclo de 8 pasos: Flash completó toda la secuencia en unos 25 segundos, frente a los 100 segundos de Pro. Es una diferencia de 4x que se multiplica con cada paso adicional. En GDPval-AA, un benchmark de tareas de agentes de trabajo intelectual del mundo real, el Elo de Flash (1656) supera al de Pro (1314) por 342 puntos, la mayor distancia de toda la tabla de benchmarks.
La salvedad es que esa ventaja de velocidad y puntuación presupone que el bucle del agente funciona sin incidencias. Las diferencias en ARC-AGI-2 y MRCR v2 observadas en tareas de razonamiento y contexto largo permiten inferir razonablemente que Flash también será menos tolerante cuando una llamada a una herramienta devuelva algo inesperado a mitad del ciclo y el agente deba replantear el plan. Es una inferencia a partir de los datos de profundidad de razonamiento anteriores, no una afirmación respaldada por un benchmark independiente. Si el agente está supervisado y una persona revisa la salida entre pasos, la velocidad de Flash es una ventaja casi gratuita. Si funciona sin supervisión durante muchos pasos y sin una persona en el circuito, el margen de razonamiento de Pro es la apuesta más segura hasta que se publiquen datos de tasas de fallo para ambos.
Qué modelo elegir según la tarea
| Tipo de tarea | Modelo recomendado | Motivo |
|---|---|---|
| Programación cotidiana (tests, revisión de PR, traducción entre lenguajes) | Flash | Gana en velocidad y coste; la profundidad de razonamiento no es el cuello de botella |
| Refactorizaciones profundas, diseño de algoritmos novedosos | Pro | La diferencia en ARC-AGI-2 se refleja directamente en el razonamiento lógico de varios pasos |
| Recuperación en documentos largos (contratos, corpus de investigación de más de 128k tokens) | Pro | Flash presenta una regresión documentada en MRCR v2 a esta longitud; el resultado de Pro no está publicado, pero el valor por defecto más seguro es el modelo sin un punto débil conocido |
| Generación por lotes a gran volumen | Flash | Las escrituras de caché gratuitas y un rendimiento 2,6x mayor pesan más a escala |
| Flujos de agentes supervisados con una persona revisando la salida | Flash | Ventaja de velocidad sin el riesgo de fiabilidad de un agente sin supervisión |
| Cadenas de agentes sin supervisión y de alto riesgo | Pro | El margen de profundidad de razonamiento es una apuesta más segura sin una persona que detecte errores a mitad del proceso |
| Llamadas frecuentes de varios turnos que reutilizan el mismo contexto | Flash | El precio de la entrada en caché es aproximadamente un tercio del de Pro |
Una regla sencilla cubre la mayor parte de la matriz: envía las solicitudes a Flash salvo que se cumpla una de estas tres condiciones: el contexto supera los 128k tokens y la precisión de recuperación importa; la tarea exige razonamiento abstracto o de varios pasos —algoritmos novedosos, síntesis jurídica o de investigación—; o el agente funciona sin supervisión durante más que unos pocos pasos. Cualquiera de estas tres condiciones inclina la decisión hacia Pro. Si no se cumple ninguna, la velocidad y el precio de caché de Flash lo convierten en la opción predeterminada más barata.
Preguntas frecuentes
¿Es Gemini 3.5 Flash mejor que 3.1 Pro?
En velocidad, coste y benchmarks de propósito general, sí. En razonamiento abstracto (ARC-AGI-2), Gemini 3.1 Pro conserva una ventaja de 5 puntos. En recuperación con contexto largo por encima de 128k tokens, Flash tiene una regresión documentada y no se ha publicado una puntuación equivalente de Pro, así que conviene tratar la comparación como no resuelta, no como una victoria confirmada de Pro. Cuál es «mejor» depende de la categoría en la que encaje tu tarea.
¿Cuánto más barato es Gemini 3.5 Flash que 3.1 Pro?
Alrededor de un 25% más barato en el precio base de entrada y salida ($1.50/$9 frente a $2/$12 por millón de tokens). El ahorro más importante aparece en la caché: las escrituras de caché de Flash son gratuitas y su entrada en caché cuesta aproximadamente un tercio de la tarifa de Pro, algo especialmente relevante en cargas de trabajo multivuelta o de gran volumen.
¿Gemini 3.5 Flash sirve para programar?
Sí, para el trabajo diario: generación de tests, revisión de PR y traducción de código entre lenguajes. Para refactorizaciones profundas o el diseño de algoritmos novedosos, la ventaja de Pro en benchmarks de razonamiento abstracto suele trasladarse a una mejor calidad de salida.
¿Gemini 3.5 Flash maneja bien el contexto largo?
Sí, con contextos más cortos: la precisión de recuperación de MRCR v2 se mantiene en el 84,9%. Por encima de los 128k tokens, cae al 77,3%, una diferencia relevante para tareas como la revisión de contratos en varios documentos. La puntuación de Gemini 3.1 Pro a esa misma longitud no se ha publicado, así que debe considerarse una limitación conocida de Flash, no una ventaja confirmada de Pro.
Conclusión
Gemini 3.5 Flash es la mejor opción predeterminada para la mayoría de tareas cotidianas y de gran volumen: es más rápido, más barato en caché y está lo bastante cerca en los benchmarks generales como para que la diferencia rara vez importe. Gemini 3.1 Pro justifica su mayor coste en razonamiento abstracto y cadenas de agentes sin supervisión. En documentos de más de 128k tokens, los propios datos de Flash muestran un punto débil que los de Pro no confirman ni descartan, por lo que conviene probarlo por cuenta propia antes de decidirse definitivamente por uno u otro.
Esta comparativa se basa en datos públicos de benchmarks (Artificial Analysis, BenchLM, nxcode y apiyi), no en pruebas directas de las API. Gemini 3.1 Pro se lanzó con un posicionamiento centrado en el razonamiento, distinto del enfoque de Flash en la velocidad. En el momento de redactar este artículo, Gemini 3.5 Pro todavía no se ha lanzado; los informes apuntan a un lanzamiento en julio de 2026. Por tanto, esta es una fotografía puntual: ambos modelos, y esta comparativa, deberán revisarse cuando llegue la próxima versión de Pro.