 AIREITER
Eleven v3 salió de alpha el 2 de febrero de 2026. Si lo invocas desde la API de ElevenLabs, el identificador de modelo es eleven_v3. Tanto ElevenLabs como fal.ai cobran $0.10 por cada 1.000 caracteres, así que el coste unitario no sirve para decidir: la diferencia está en el modelo de facturación, la concurrencia y el acceso a voces. La disponibilidad general también corrigió problemas importantes: según el anuncio de GA, los errores con texto estructurado bajaron del 15.3% al 4.9% en un benchmark de 27 categorías y 8 idiomas. Hay dos límites duros que conviene tener presentes: 5.000 caracteres por petición y un modelo que su propio fabricante no considera apto para tiempo real.
Qué ofrece la API de ElevenLabs Eleven v3
La API de Eleven v3 cuenta con cuatro vías: generar voz, generarla en streaming y endpoints independientes para crear y transmitir diálogos con varios hablantes. El modelo habla más de 70 idiomas, acepta etiquetas de audio integradas en el texto para controlar la emoción y la interpretación, y en su lanzamiento general alcanzó una estabilidad tal que, en las pruebas de ElevenLabs, se prefirió frente a la versión alpha el 72% de las veces.
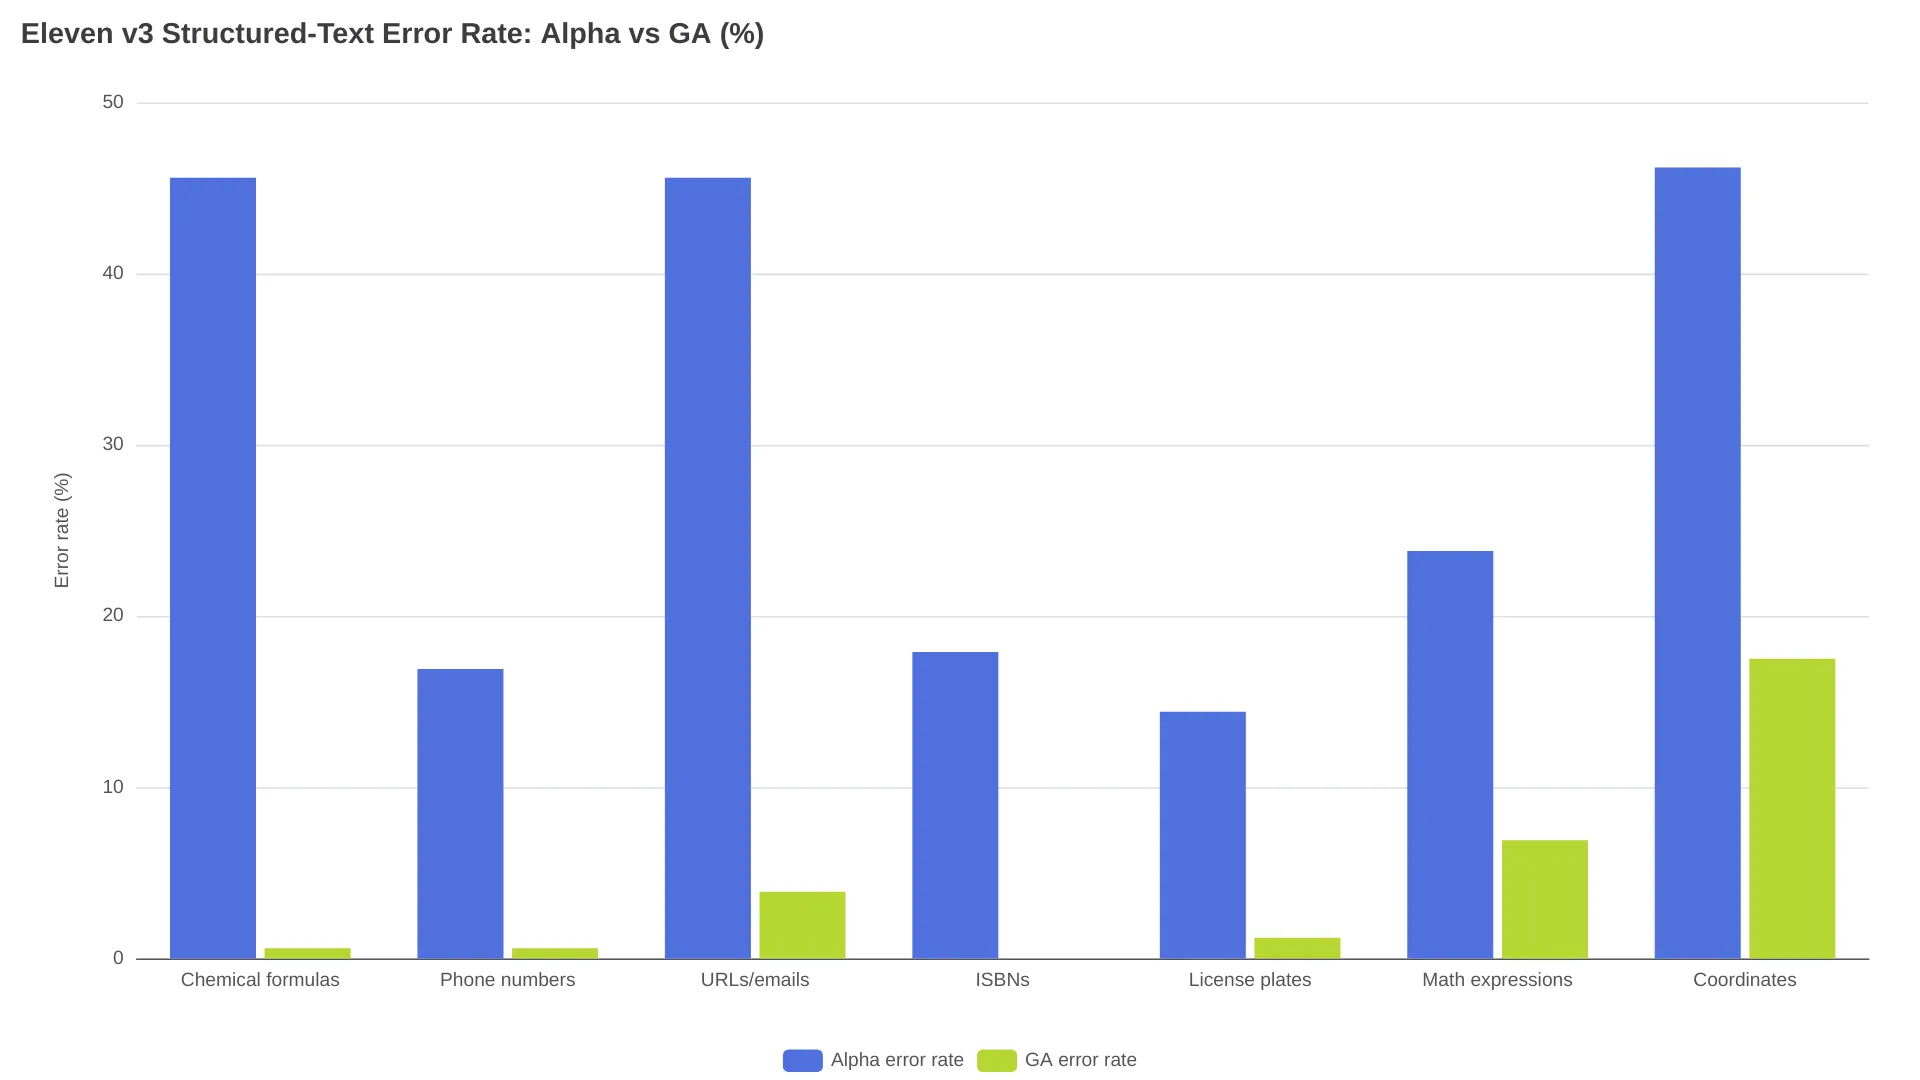
Antes de confiarle texto estructurado a v3, merece la pena revisar el desglose por categorías del benchmark. Los errores en fórmulas químicas pasaron del 45.6% al 0.6%; en números de teléfono, del 16.9% al 0.6%; y en ISBN llegaron a cero. Las coordenadas geográficas siguen siendo su punto débil, con un 17.5%, mientras que las expresiones matemáticas se sitúan en el 6.9%: suficiente para narración, pero arriesgado si el contenido depende mucho de coordenadas.
Según la referencia oficial de modelos, esta es la posición de v3 frente a sus modelos hermanos:
| Modelo | ID del modelo | Idiomas | Máx. caracteres/petición | Latencia indicada | Precio / 1.000 caracteres |
|---|---|---|---|---|---|
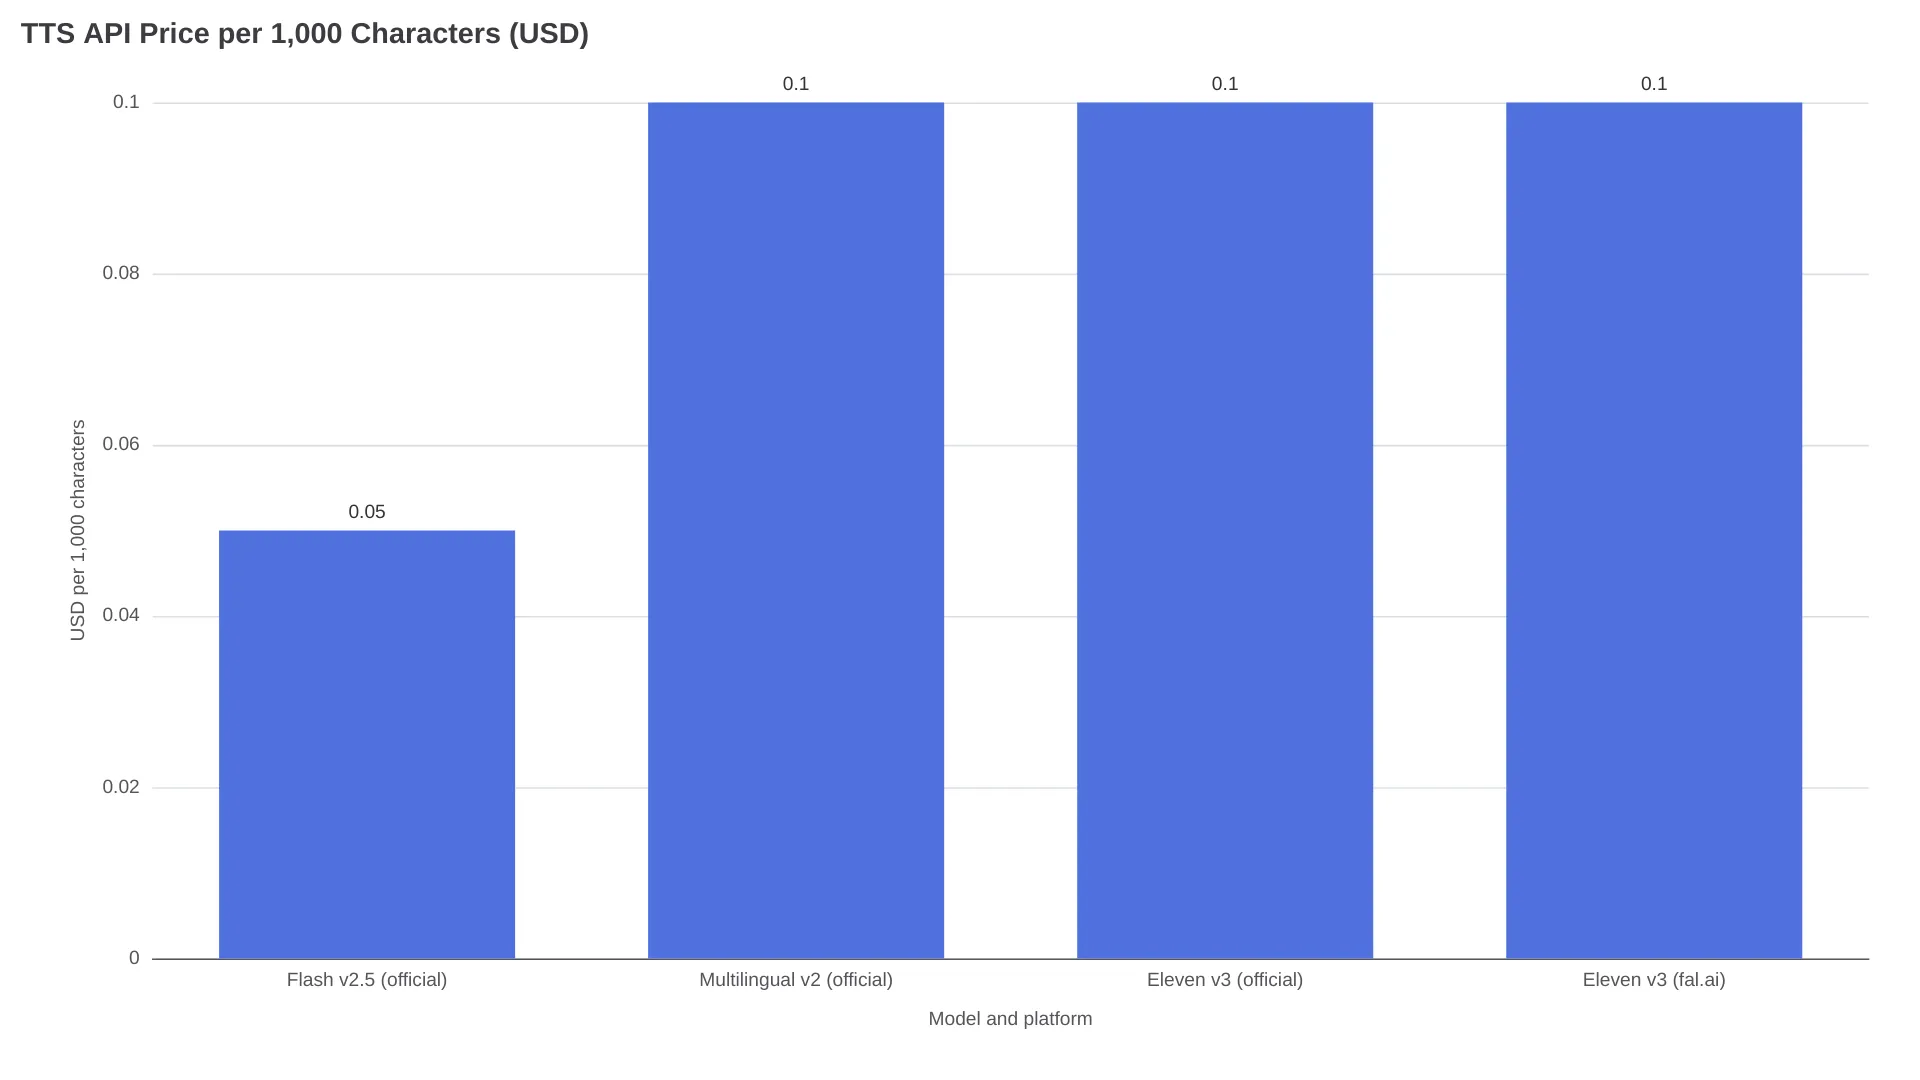
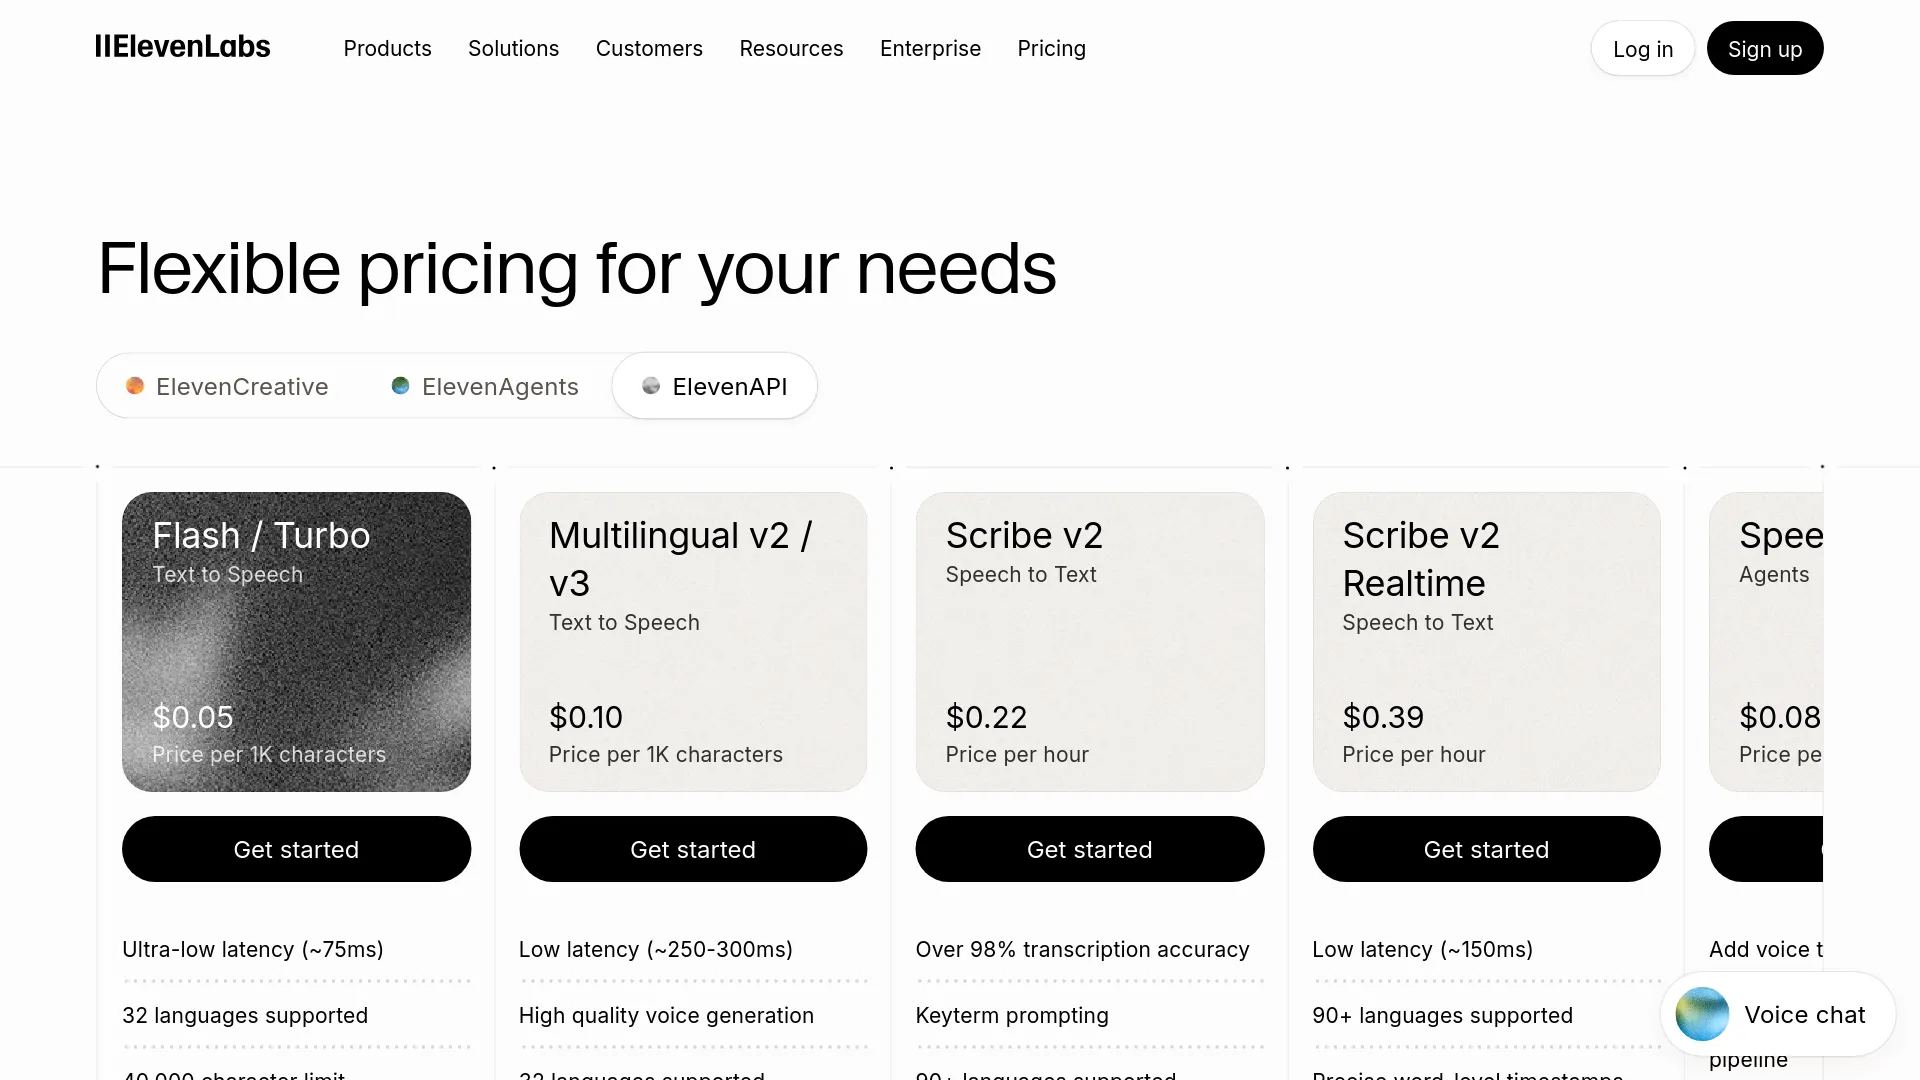
| Eleven v3 | eleven_v3 | 70+ | 5.000 (~5 min) | ~250–300 ms (nivel) | $0.10 |
| Eleven v3 Conversational | mediante Text-to-Dialogue WebSocket | 70+ | n/a | ~280 ms | $0.10 |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10.000 (~10 min) | ~250–300 ms | $0.10 |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40.000 (~40 min) | ~75 ms | $0.05 |
Hay una discrepancia documental que conviene conocer: la página de precios agrupa «Multilingual v2/v3» bajo un límite de nivel de 40.000 caracteres, pero la referencia de modelos fija el máximo de Eleven v3 en 5.000 caracteres por petición. Para v3, toma 5.000 como la cifra real: es el límite específico del modelo, y cualquier pipeline de contenido largo que asuma 40.000 fallará.
Precios: ElevenLabs oficial frente a fal.ai
El precio unitario es idéntico: $0.10 por cada 1.000 caracteres. Dentro de esta familia, solo Flash v2.5 resulta más barato, a $0.05/1.000. Lo relevante está en cómo se factura y en el paralelismo disponible:
| ElevenLabs oficial | fal.ai | |
|---|---|---|
| Precio unitario (Eleven v3) | $0.10 / 1.000 caracteres | $0.10 / 1.000 caracteres |
| Facturación | Planes de suscripción con créditos incluidos o pago por uso | Solo pago por uso; «sin licencias por puesto, suscripciones ni mínimos» |
| Plan gratuito | 10.000 caracteres Multilingual/mes (20.000 Flash) | No se indica ninguno en la página del modelo |
| Plan de ejemplo | Creator $22/mes (primer mes $11), 220.000 caracteres Multilingual | n/a |
| Plan superior | Business $990/mes, 9.9M caracteres Multilingual | n/a |
| Concurrencia | Según el plan: 2 peticiones Multilingual simultáneas en Free, 15–30 en Scale/Business y personalizada en Enterprise | Cola serverless; la página del modelo no documenta un límite por cuenta |
| Penalización por cola | Al superar el límite, las peticiones entran en cola y añaden «normalmente» ~50 ms | API de cola con webhooks para trabajos por lotes |
| Controles (esquema documentado y reportes de usuarios) | Voz por ID; estabilidad (los usuarios reportan 3 posiciones en v3) | Voz, stability, similarity_boost, speed, language_code, apply_text_normalization, seed, timestamps, output_format |
| Programa para startups | 12 meses gratis, 33M caracteres y mayor concurrencia | n/a |
La ruta oficial establece la concurrencia por nivel de plan. Una clave Free que haga llamadas paralelas a v3 dispone de 2 peticiones simultáneas, una restricción severa para trabajo por lotes. fal, en cambio, envía todos los trabajos a una cola serverless con callbacks por webhook, justo el caso de uso de los lotes. La documentación de precios de ninguna plataforma aclara si los espacios en blanco o las etiquetas de audio entre corchetes computan como caracteres facturables; presupuesta como si lo hicieran.
Si solo necesitas v3 de vez en cuando y ya utilizas otros modelos mediante fal, nuestro análisis de fal.ai cubre el caso de uso de la plataforma.
Etiquetas de audio: cómo dirigir la interpretación desde el texto
Las etiquetas de audio son instrucciones entre corchetes que se insertan directamente en el texto. El modelo las interpreta como indicaciones de actuación, no como palabras que deba pronunciar. Este es un ejemplo mínimo de la página del modelo en fal:
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| Categoría | Ejemplos que funcionan |
|---|---|
| Emociones | [happy], [sad], [excited], [angry], [sarcastically], [nervous], [happily] |
| Interpretación | [whispers], [shouting], [shouts], [slowly], [quickly], [softly] |
| Sonidos no verbales | [laughs], [chuckles], [sighs], [gasps], [coughs], [gulps], [clears throat], [applause] |
| Acentos | [british accent], [southern accent], [strong canadian accent] |
La documentación oficial sobre prompting establece tres reglas para estas etiquetas. No existe una lista canónica: son indicaciones en lenguaje natural y ElevenLabs afirma que seguramente haya etiquetas eficaces más allá de los ejemplos publicados, por lo que probar vale más que memorizar. Las etiquetas de pausa de SSML no son compatibles; el ritmo se controla mediante puntuación, puntos suspensivos y saltos de línea. Por último, su efectividad depende de la voz y del contexto. Y ahí es donde empiezan los problemas:
«V3 is amazing, certainly the most human sounding» «it still feels like a Beta release to me» — u/ConcertNeat8147, ambas frases en la misma publicación, informe de campo sobre v3 en r/ElevenLabs
En ese mismo hilo, u/poundingCode, ingeniero de software con dos décadas de experiencia, cuenta que añadir etiquetas emocionales puede cambiar por completo el acento del hablante en ocasiones. Una cuenta del equipo de ElevenLabs respondió que «these are all things we're currently working on.»
Creadores de ese mismo hilo comparten estas soluciones alternativas; son experiencias de la comunidad, no indicaciones oficiales:
- Frase de calentamiento. Añade al principio una frase prescindible que marque el tono y el registro, y recórtala después en edición. Las voces a menudo «se asientan» unos segundos después de iniciar la generación.
- Un
end.al final. Añade un salto de línea y la palabra «end.» tras el texto para evitar que se corten las últimas palabras; luego elimínalo del audio. - Cierra con puntos suspensivos. Según los reportes, los cortes al final de las palabras disminuyen cuando las frases terminan en «...».
- Lleva la estabilidad al máximo. El control de estabilidad de v3 tiene tres posiciones; la más alta reduce la deriva de voz al comienzo de las generaciones.
Límites que condicionan la integración
- El límite de 5.000 caracteres es el principal. Una petición alcanza aproximadamente 5 minutos de audio, así que los pipelines de audiolibros y contenido largo deben dividir el texto. Hazlo por límites de frase o párrafo, nunca a mitad de una oración, y mantén las etiquetas en el mismo fragmento que dirigen. Multilingual v2 permite 10.000 caracteres si necesitas menos llamadas de mayor tamaño.
- En la API oficial, la concurrencia depende del plan. Según la referencia de modelos, las claves Free tienen 2 peticiones simultáneas de nivel Multilingual (4 Flash); Scale y Business ofrecen 15–30; y Enterprise negocia límites personalizados. Al superar el límite, la cola añade «normalmente» ~50 ms. La misma página ofrece esta estimación de capacidad de ElevenLabs: un límite de concurrencia de 5 permite aproximadamente 100 emisiones de audio simultáneas en una carga de trabajo conversacional. La penalización es pequeña por llamada, pero a escala de lotes resulta devastadora si te quedas corto de capacidad.
- fal no documenta ningún tamaño máximo de entrada. Su página de Eleven v3 especifica el endpoint, los parámetros y los formatos, pero no un límite de entrada, retención en cola ni comportamiento de reintentos. Nada te impide enviar texto largo; nada garantiza que funcione tampoco.
- Las marcas de tiempo se reparten entre plataformas. El esquema de entrada de fal incluye el booleano
timestamps, que devuelve datos de alineación por palabra útiles para subtítulos y sincronización labial. En la API oficial, la salida de diálogos de v3 llega sin marcas de tiempo, una carencia que desarrolladores han señalado públicamente (r/ElevenLabs: "v3 API, no timestamps?"). El parámetro de fal es actualmente la vía documentada para obtener datos de alineación.
- El tiempo real sigue descartado. ElevenLabs indica que v3 no es adecuado para uso en tiempo real ni conversacional debido a su mayor latencia y consistencia variable. Las alternativas recomendadas son Flash v2.5, con ~75 ms para agentes, o Eleven v3 Conversational, con ~280 ms mediante WebSocket cuando necesitas mantener la expresividad en un contexto interactivo. Hay una variante de v3 para tiempo real en la hoja de ruta («we're working on a real-time version»), pero no se había lanzado en el anuncio de GA.
- Uso comercial. Durante la alpha, los desarrolladores preguntaban públicamente si la salida de v3 podía utilizarse con fines comerciales. El anuncio de GA abrió el modelo en todas las plataformas, y fal etiqueta expresamente su endpoint como apto para uso comercial.
Primera petición: SDK oficial y cliente de fal
La vía oficial, tomada literalmente del quickstart:
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # or ELEVENLABS_API_KEY env var
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)La vía de fal usa fal-client contra el endpoint fal.run:
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # default voice
"stability": 0.5, # 0–1, lower = more expressive variation
"timestamps": True, # per-word alignment data
},
)
print(result["audio"]["url"]) # hosted MP3 URLAmbas plataformas advierten explícitamente que no debes incluir claves API en código del lado del cliente, así que canaliza las peticiones a través de tu propio servidor. Para streaming, la API oficial tiene un endpoint de voz en streaming, mientras que fal ofrece fal.stream y una API de cola con webhooks para trabajos por lotes.
Qué endpoint debes usar según tu caso
| Tu situación | Qué usar |
|---|---|
| Necesitas tus propias voces clonadas (PVC/IVC) o voces diseñadas por ID | Oficial: las voces personalizadas se referencian por ID en tu espacio de trabajo; la página de fal solo documenta nombres de voces predefinidas |
| Ya pagas un plan de ElevenLabs con créditos incluidos | Oficial: los caracteres incluidos ya son un coste asumido y cada llamada a fal implica gasto nuevo |
| Trabajos por lotes de audiolibros o doblaje, sin suscripción y con webhooks al terminar | fal: su cola de pago por uso y flujo de webhooks se ajustan exactamente a este caso |
| Una única clave API para modelos de imagen, vídeo y TTS en el mismo stack | fal: v3 utiliza el mismo cliente que el resto de tus modelos de fal |
| Agentes de voz o cualquier caso condicionado por la latencia | Ningún endpoint TTS de v3: usa Flash v2.5 (~75 ms) o Eleven v3 Conversational (~280 ms) |
| Necesidades Enterprise (SOC 2, HIPAA BAA, límites de tasa personalizados, listas de IP permitidas) | Oficial: funciones Enterprise documentadas en la página de precios; la página del modelo de fal no indica qué certificaciones cubren su endpoint |
Preguntas frecuentes
¿Cuál es el ID de modelo de Eleven v3?
eleven_v3, que se pasa como model_id en los endpoints estándar de texto a voz. Los diálogos con varios hablantes usan endpoints Text-to-Dialogue independientes, no un parámetro de modelo.
¿La API de Eleven v3 admite streaming?
Sí. La API oficial ofrece un endpoint de voz en streaming que devuelve audio mientras se genera, y fal expone fal.stream para el mismo modelo. El streaming no hace que v3 sea seguro para tiempo real: la guía oficial sigue reservando el uso conversacional para Flash v2.5 o Eleven v3 Conversational.
¿Cuál es el límite de caracteres de Eleven v3?
5.000 caracteres por petición, aproximadamente 5 minutos de audio, según la referencia oficial de modelos. La cifra de 40.000 caracteres de la página de precios corresponde a la agrupación del nivel Multilingual, no específicamente a v3.
¿Cuánto cuesta la API de Eleven v3?
$0.10 por cada 1.000 caracteres en ambas rutas: $1.00 por una historia de 10.000 caracteres y $100 por un audiolibro de 1M caracteres. Los créditos de los planes reducen el coste oficial (Creator $22/mes incluye 220.000 caracteres Multilingual); fal no tiene suscripción.
¿Puedo usar voces clonadas con Eleven v3?
En la API oficial, sí: las voces profesionales, clonadas y diseñadas se referencian mediante ID de voz. En la práctica, la compatibilidad varía. Usuarios de r/ElevenLabs reportan que las Professional Voice Clones existentes a veces suenan como hablantes distintos en v3, mientras que las PVC cuyos creadores indican compatibilidad con V3 suelen responder mejor. El esquema de fal acepta un nombre o ID de voz, pero solo documenta voces predefinidas, así que los IDs de voces privadas de ElevenLabs son terreno no documentado allí.
¿Eleven v3 sirve para agentes de voz en tiempo real?
No. ElevenLabs enumera expresamente el uso en tiempo real y conversacional como no adecuado para v3 por su mayor latencia y consistencia variable. Usa Flash v2.5 (~75 ms, 32 idiomas) o Eleven v3 Conversational (~280 ms, más de 70 idiomas y control mediante etiquetas de audio).
¿Por qué Eleven v3 suena diferente en la API que en la web?
Las previsualizaciones de voz no representan necesariamente el resultado con tu propio texto, una queja recurrente en los informes de campo de r/ElevenLabs, y la salida de v3 varía de forma apreciable entre generaciones. Antes de decidirte, prueba cada voz candidata con un fragmento de guion real y con el ajuste de estabilidad que usarás en producción.
Lecturas relacionadas: guía de la API de Qwen Audio 3 TTS · precios y alternativas de Replicate · análisis de fal.ai 2026