 AIREITER
Edge0-145B promete 145.000 millones de parámetros en un portátil y velocidades de 80 tokens por segundo. Los pesos se pueden descargar, pero la letra pequeña apunta a un equipo NVIDIA con CUDA 13 y unos 105 GB de espacio en SSD.
Este análisis de Edge0-145B contrasta las promesas del lanzamiento con el blog de presentación, la documentación del modelo y la ficha de Q3_K, además de las primeras pruebas de la comunidad. La idea es que puedas decidir, antes de descargarlo, si te compensa ejecutarlo en local o recurrir a una API.
Qué llegó el 12 de noviembre: pesos, motor y limitaciones
Edge0 publicó Edge0-145B y Edge0-120B el 12 de noviembre de 2026, con los pesos en Edge0-145B-q3k y Edge0-145B-NVFP4, y el motor edge0-strata dentro de Edge0-AI/Edge0. Edge0-145B es un modelo de texto basado en una arquitectura Mixture-of-Experts latente, con contexto de 256K, derivado de Qwen3.8-Flash-Next y entrenado de forma nativa a 4 bits. En cada token se activan unos 10.120 millones de parámetros, así que sus 145.000 millones totales no tienen que caber íntegramente en la VRAM.
El modelo se divide en unos 84.600 millones de parámetros expertos, una tabla PLE de n-gramas de 51.200 millones que se mapea desde el SSD, una cabeza de borrador de 1.260 millones para la decodificación especulativa y un esqueleto de 6 GB. Q3_K incluye 40,81 GiB de pesos dentro de un repositorio de 105,4 GB, mientras que NVFP4 incluye 47,79 GiB en 112,9 GB. Los expertos enrutados se distribuyen en un paquete personalizado experts.bin, no en un GGUF portátil.
La cifra de 29 GB no significa que solo necesites 29 GB
El blog habla de un pico de 29 GB en una sección y de 28 GB en otra, junto con más de 1.100 tokens por segundo de prellenado, más de 80 en decodificación y un consumo de 120 W. La ficha de Q3_K registra 23,14 GiB de VRAM más 31,28 GiB de RAM del sistema en una RTX 5090 D, mientras que NVFP4 necesita 23,25 y 38,27, respectivamente. La biblioteca de expertos ocupa unos 40 GB en RAM y la implementación transmite unos 48 GB de vocabulario desde el SSD.
Los expertos más activos permanecen en la VRAM, los que se usan con menor frecuencia se quedan en la RAM y la tabla PLE de 51,2 GB se lee bajo demanda desde el SSD. La memoria activa puede acercarse a 29 GB si se mide de forma estricta, pero para descargar el repositorio completo y mantener el flujo de datos sigue haciendo falta todo el almacenamiento indicado.
| Qué representa la cifra | Tamaño | Ubicación |
|---|---|---|
| Pico de memoria indicado en el blog | 28-29 GB | Memoria activa; metodología no documentada |
| Descarga del repositorio Q3_K | 105,4 GB | SSD NVMe, 51,2 GB de PLE + 40,1 GB de experts.bin |
| Descarga del repositorio NVFP4 | 112,9 GB | SSD NVMe, 51,2 GB de PLE + 47,6 GB de experts.bin |
| Memoria medida en una 5090 D con Q3_K | 23,14 GiB de VRAM + 31,28 GiB de RAM | VRAM + RAM del sistema durante la inferencia |
| Memoria medida en una 5090 D con NVFP4 | 23,25 GiB de VRAM + 38,27 GiB de RAM | VRAM + RAM del sistema durante la inferencia |
Qué necesitas realmente para ejecutar Edge0-145B
Edge0-145B funciona en Linux o Windows con una GPU NVIDIA y CUDA 13 mediante edge0-infer. Los archivos publicados no ofrecen una vía de carga para llama.cpp, Ollama o LM Studio sin modificaciones: el GGUF del esqueleto no contiene los pesos de los expertos enrutados y Edge0 solo documenta edge0-infer (consulta las instrucciones del repositorio). Por eso el flujo de trabajo de la guía de llama.cpp v1.0 no sirve en este caso. El blog menciona macOS y MacBook Pro como plataformas compatibles desde el primer día, pero la tabla de plataformas solo enumera Linux y Windows con CUDA 13 para 145B y 120B.
La configuración mínima probada es de 16 GiB de VRAM y 20 GiB de RAM, con 44,9 tokens por segundo en la decodificación de agentes con Q3_K. La recomendada sube a una tarjeta NVIDIA de 24 GB, 32 GB de RAM del sistema —48 GB ofrecen más margen—, 120 GB libres en NVMe y CUDA 13, además de CMake, Ninja y uv. Para compilar y ponerlo en marcha, sigue las instrucciones del repositorio:
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
En Windows también puedes descargar la aplicación Edge0 Chat v0.2.0 desde GitHub Releases. AMD requiere ajustes manuales: u/UghrUghr informa de unos 35 cambios en la compilación y en tiempo de ejecución sobre una RX 7900 XTX con Windows 11 en este hilo de r/LocalLLaMA, con kernels fusionados para CUDA ejecutándose sobre una ruta alternativa más lenta.
Q3_K frente a NVFP4: qué archivo descargar
Q3_K ocupa 105,4 GB y es la opción predeterminada. En la tabla de Edge0 alcanza 121,2 tokens por segundo en la decodificación de agentes sobre una 5090 D. NVFP4 ocupa 112,9 GB y está pensado para aprovechar la aceleración de Blackwell, con 98,3 tokens por segundo en la misma tarjeta. Si no tienes hardware Blackwell, empieza por Q3_K.
Qué velocidad ofrece en tarjetas reales
Las cifras siguientes corresponden a Q3_K según Edge0, con un prellenado de 16K salvo que se indique lo contrario. La fila del M2 Ultra es una medición con Metal y no demuestra que exista una versión publicada para macOS.
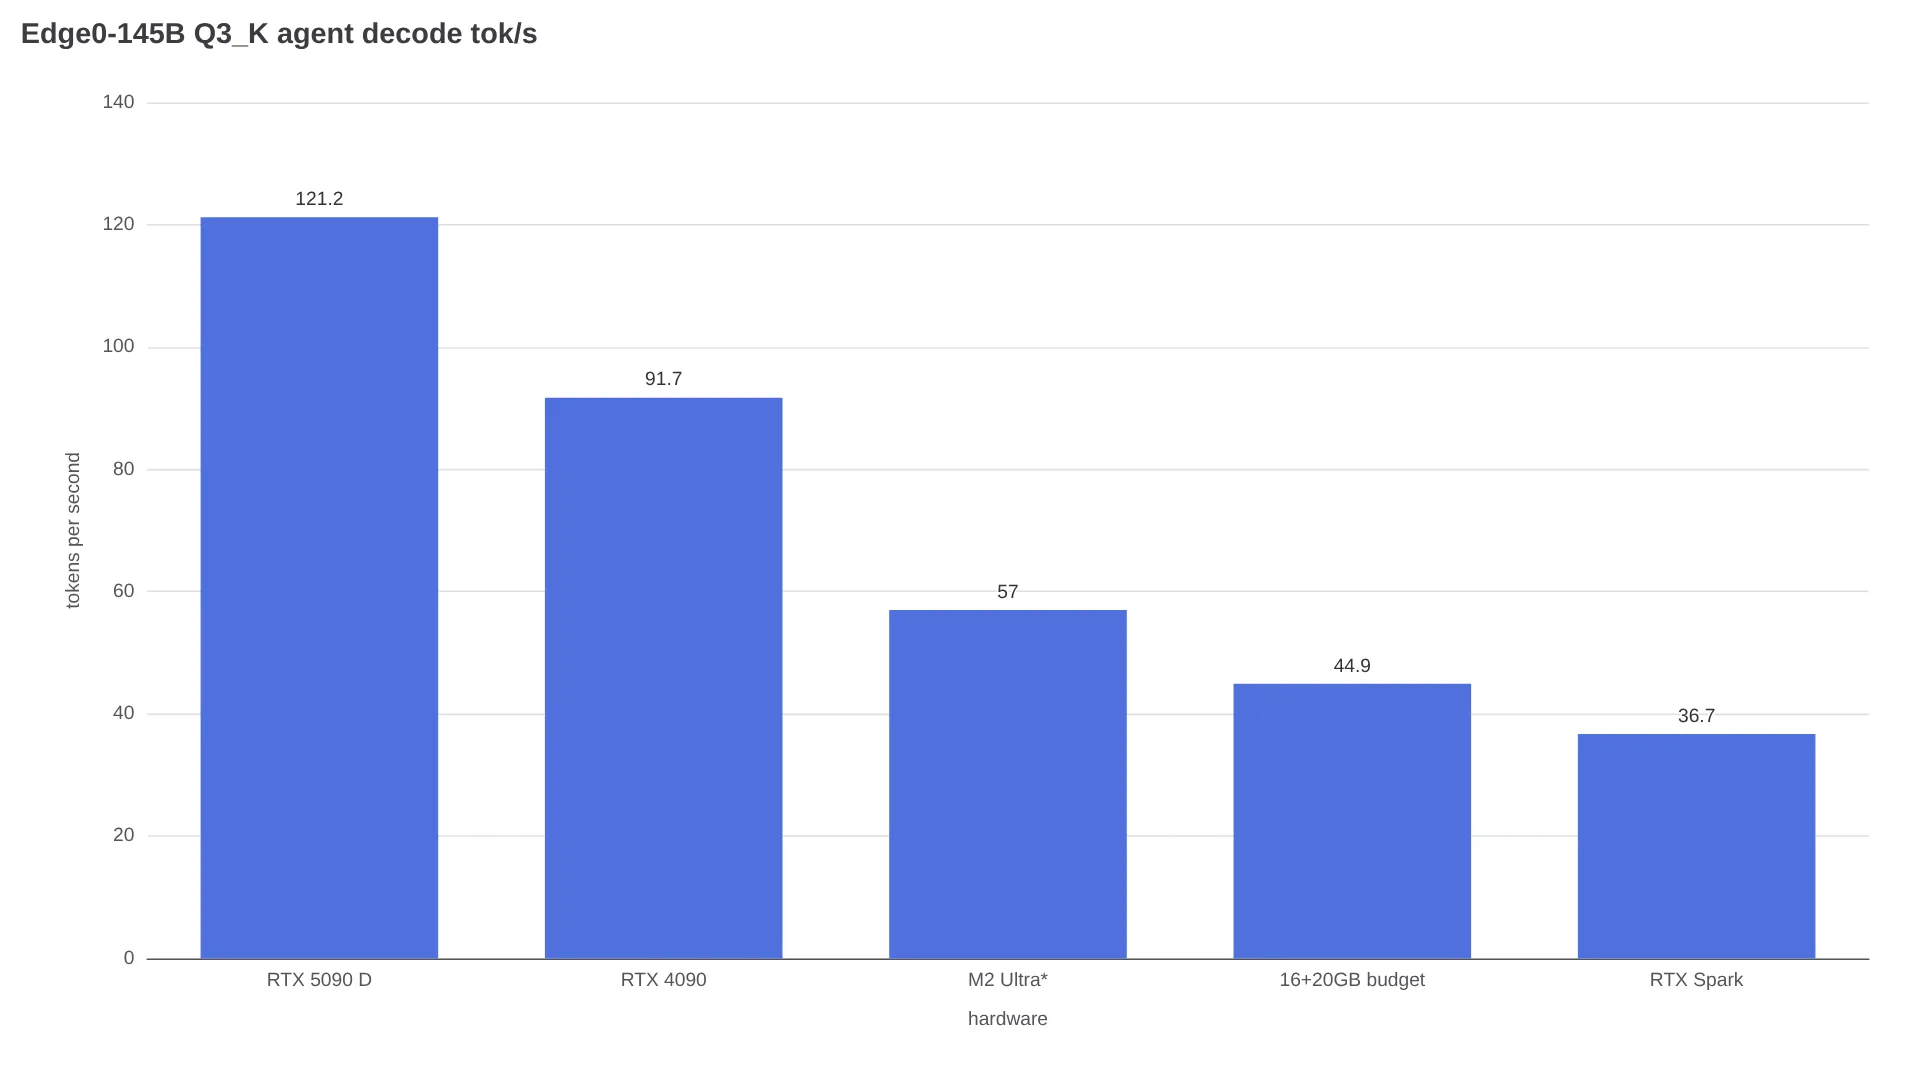
| Hardware | Decodificación de chat | Decodificación de agentes | Prellenado de 16K |
|---|---|---|---|
| RTX 5090 D de 24 GB Q3_K | 99,7 | 121,2 | 3.554,9 |
| RTX 4090 de 24 GB Q3_K | 69,9 | 91,7 | 3.179,4 |
| Apple M2 Ultra Metal Q3_K | 60,9 | 57,0 | 800,3 |
| Presupuesto de 16 GiB de VRAM + 20 GiB de RAM Q3_K | 36,8 | 44,9 | 335,0 |
| RTX Spark de 60 GiB Q3_K | 37,7 | 36,7 | 770,3 |
Un usuario de una RTX 3090 comunica 20,1 segundos hasta el primer token, 1.583 tokens por segundo de prellenado y 56,2 en decodificación con Q3_K, lo que apunta a un rendimiento inferior al de las tarjetas insignia:
Lo acabo de probar en mi equipo con una 3090: 20,1 s de TTFT, 1583 tokens/s de prellenado y 56,2 tokens/s de decodificación para Edge0-145B Q3_K.
En la configuración de AMD mencionada arriba, u/UghrUghr informa de unos 40 tokens en decodificación, unos 54 con ROUTE_TAIL_SKIP=7 y ROUTE_PRIOR=1.5, y unos 320 en el procesamiento del prompt. Son mediciones de un solo usuario, no reproducciones controladas, y se sitúan aproximadamente entre la mitad y dos tercios del ritmo de una 5090 D.
Benchmarks: dos victorias y cuatro advertencias
La tabla de Edge0 mezcla pruebas internas de Edge0, Qwen, DeepSeek y Claude con cifras de terceros para los demás modelos, según la documentación del modelo. Edge0-145B lidera las dos pruebas de agentes de programación, pero queda por detrás de su base Qwen en conocimiento y seguimiento de instrucciones. No he encontrado ninguna reproducción independiente enlazada a fecha del 13 de noviembre de 2026, y las puntuaciones describen el modelo completo, no las descargas cuantizadas.
| Benchmark | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64,6 | 58,7 | 54,4 | — |
| Terminal-Bench 2.1 | 86,52 | 83,3 | 82,7 | 78,2 |
| HLE | 35,4 | 35,9 | 33,8 | 40,0 |
| GPQA-Diamond | 90,4 | 91,7 | 90,8 | 91,3 |
| IFBench | 80,6 | 81,3 | 79,2 | 62,5 |
| AA-LCR | 79,3 | 79,1 | 79,7 | 78,0 |
La media es de 72,8 para Edge0-145B, frente a 71,7 para Qwen3.8-Flash-Next y 70,1 para DeepSeek-V4-Flash según los cálculos de Edge0, mientras que 120B obtiene 68,9. Mi conclusión es sencilla: con promesas de consumo máximo similares en ambos tamaños, elegiría 145B salvo que el espacio en disco sea un problema.
Licencia: pesos abiertos no significa código abierto
El framework usa Apache 2.0 y la base Strata usa MIT, pero los pesos están sujetos a la Edge0 Community Model License 1.0, además de aplicarse los términos de Qwen. Se permite el uso personal, académico, empresarial interno y comercial de las salidas. Sin embargo, vender o integrar el modelo en un producto, ofrecer un servicio de pago o distribuir un asistente comercial de programación u oficina requiere un permiso escrito independiente.
¿Descargarlo o usar una API?
Descárgalo si tienes el hardware necesario y necesitas que el código permanezca en tu dispositivo. Para una prueba puntual, compara antes los precios de las API alojadas con el coste de comprar hardware. Si estás valorando la inferencia en la nube, puedes consultar la página de la API de DeepSeek V4.1 Flash antes de reservar 105 GB de disco.
| Tu situación | Opción recomendada |
|---|---|
| NVIDIA de 24 GB + 32-48 GB de RAM + 120 GB de NVMe, Linux/Windows | Descargar Q3_K y servirlo mediante edge0-infer |
| Tarjeta Blackwell y preferencia por la ruta NVFP4 | Descargar la compilación NVFP4 |
| Solo Mac, portátil de 8-16 GB o necesidad de usar Ollama/LM Studio | No descargar todavía; usar una API alojada |
| Publicar una API de pago o un asistente basado en estos pesos | Esperar a obtener permiso escrito; usar una API |
| Quieres esas puntuaciones sin ocuparte de la operación | Usar APIs de Qwen o de modelos punteros; volver a valorar la opción cuando haya reproducciones |
La contrapartida está entre procedencia y practicidad: la transmisión de expertos reduce la barrera de VRAM para modelos de más de 100.000 millones de parámetros, pero las referencias al portátil, macOS y los 29 GB van por delante del código publicado. Además, la tabla de Edge0 no ofrece cifras de calidad separadas para Q3_K.
Preguntas frecuentes
¿Puede Edge0-145B funcionar en un portátil?
Solo en un portátil NVIDIA de gama alta con unos 24 GB de VRAM, más de 32 GB de RAM y 120 GB de NVMe, con Linux o Windows y CUDA 13. Un ultrabook de 8 o 16 GB no puede ejecutar la compilación 145B, que requiere una descarga de 105,4 GB y más de 23 GiB de VRAM residente.
¿Edge0-145B funciona en Mac?
A fecha del 13 de noviembre de 2026, la tabla de plataformas no muestra ninguna versión compatible con macOS. Las cifras del M2 Ultra son únicamente mediciones con Metal.
¿Funciona con Ollama, llama.cpp o LM Studio?
No. Las compilaciones estándar no pueden cargar paquetes personalizados experts.bin y el GGUF del esqueleto carece de los pesos de los expertos enrutados. Hay que usar edge0-infer serve o la aplicación Chat para Windows.
¿Es Edge0-145B mejor que Qwen3.8-Flash-Next?
Está por delante en DeepSWE, con 64,6 frente a 58,7, y en Terminal-Bench, con 86,52 frente a 83,3, según las pruebas de Edge0. Queda por detrás en HLE, con 35,4 frente a 35,9, y en GPQA-Diamond, con 90,4 frente a 91,7. Todavía faltan pruebas independientes.
¿Puedo usar Edge0-145B con fines comerciales?
Las salidas sí, pero vender el modelo, ofrecer un servicio de pago o distribuir un asistente comercial de programación u oficina requiere un permiso escrito independiente según la licencia comunitaria. Además, también se aplican los términos de Qwen.