 AIREITER
"Sonnet 5 está cerca de Opus 4.8, pero es más barato" es la propia propuesta de Anthropic. Queríamos saber dónde deja de ser cierto, así que ejecutamos cuatro tareas idénticas en ambos modelos a través de la CLI de Claude Code y registramos el costo real, la duración y los recuentos de llamadas a herramientas de cada respuesta de la API. La que más importaba: llevar Sonnet 5 a un nivel de esfuerzo xhigh para igualar lo que Opus 4.8 hace de forma predeterminada, y la diferencia de precio que medimos casi desapareció, mientras que Opus 4.8 terminó en aproximadamente la mitad del tiempo.
Sonnet 5 vs Opus 4.8 de un vistazo
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
Lanzamiento | 30 de junio de 2026 | |
Ventana de contexto | 1M tokens | 1M tokens |
Salida máxima | 128K tokens | 128K tokens |
Precios (entrada/salida por 1M tokens) | $5/$25 | |
Modo rápido | No compatible | Compatible (vista previa de investigación), hasta ~2.5x de velocidad de salida con precio premium |
Niveles de esfuerzo | bajo / medio / alto / xhigh / max | bajo / medio / alto / xhigh / max |
Posicionamiento | Modelo de nivel Sonnet más barato, enfocado en agentes | La opción insignia de Anthropic, con la mayor precisión |
La ventana de contexto y la salida máxima son idénticas: aquí no hay diferenciación. Una cosa sí lo es: Sonnet 5 funciona con un nuevo tokenizador que, según Anthropic, produce "aproximadamente un 30% más de tokens" que Sonnet 4.6 para el mismo texto, así que un presupuesto de max_tokens o una estimación de costo heredados de Sonnet 4.6 no se trasladarán directamente.
Comparación oficial de benchmarks
Según las propias divulgaciones de Anthropic, compiladas junto con un análisis de terceros por llm-stats.com, el patrón es consistente: Sonnet 5 gana o empata en un par de benchmarks, y Opus 4.8 lidera en la mayoría de los demás, normalmente por un solo dígito.
Punto de referencia | Sonnet 5 | Opus 4.8 | Diferencia |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
El último examen de la humanidad (con herramientas) | 57.4% | 57.9% | Casi empate |
El último examen de la humanidad (sin herramientas) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (uso del ordenador) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
Problemas USAMO 2026 | 79.5% | 96.7% | Opus +17.2 |
Dos cosas destacan. La mayor ventaja de Opus 4.8 está en matemáticas difíciles (USAMO), no en programación — las brechas en programación (SWE-bench, Terminal-Bench) están todas en un solo dígito, y Sonnet 5 en realidad gana una de ellas de forma directa. En razonamiento general con herramientas (HLE con herramientas), ambos están lo bastante cerca como para considerarlo un empate.
También hay un número de seguridad que merece señalarse aunque no sea un indicador de capacidad: según las mismas divulgaciones, en escenarios de uso del navegador sin salvaguardas adicionales, la tasa medida de éxito de ataques de inyección de prompts de Sonnet 5 fue del 0,93%, frente al 31,5% de Opus 4.8. Anthropic no ha publicado una explicación detallada para esa brecha específica. Si estás creando algo agéntico que navega la web abierta sin supervisión, vale la pena probar tus propias salvaguardas en lugar de asumir que el modelo insignia es automáticamente la opción predeterminada más segura.
Realizamos nosotros mismos cuatro pruebas cara a cara
La mayor parte de lo que hay ahora mismo o bien compila la tabla oficial de benchmarks anterior o comparte impresiones subjetivas de un solo modelo. No encontramos una comparación controlada de costo y latencia con el mismo prompt, así que realizamos la nuestra.
Metodología: cuatro tareas, ejecutadas el 2026-07-01, el mismo prompt enviado a claude-sonnet-5 y claude-opus-4-8 cada vez mediante la CLI de Claude Code (claude -p --model <id> --effort <level> --output-format json). El coste, la duración y el número de turnos se leen directamente de la respuesta de la API de cada ejecución, no se estiman a partir del recuento de tokens. Cada configuración de modelo/effort se ejecutó una vez por tarea — cifras reales de una sola ejecución, no una muestra promediada estadísticamente. Trate el tamaño de cada diferencia como orientativo y no exacto; la dirección fue consistente en todas las pruebas que ejecutamos.
Prueba 1: La comprobación de reversión de costos
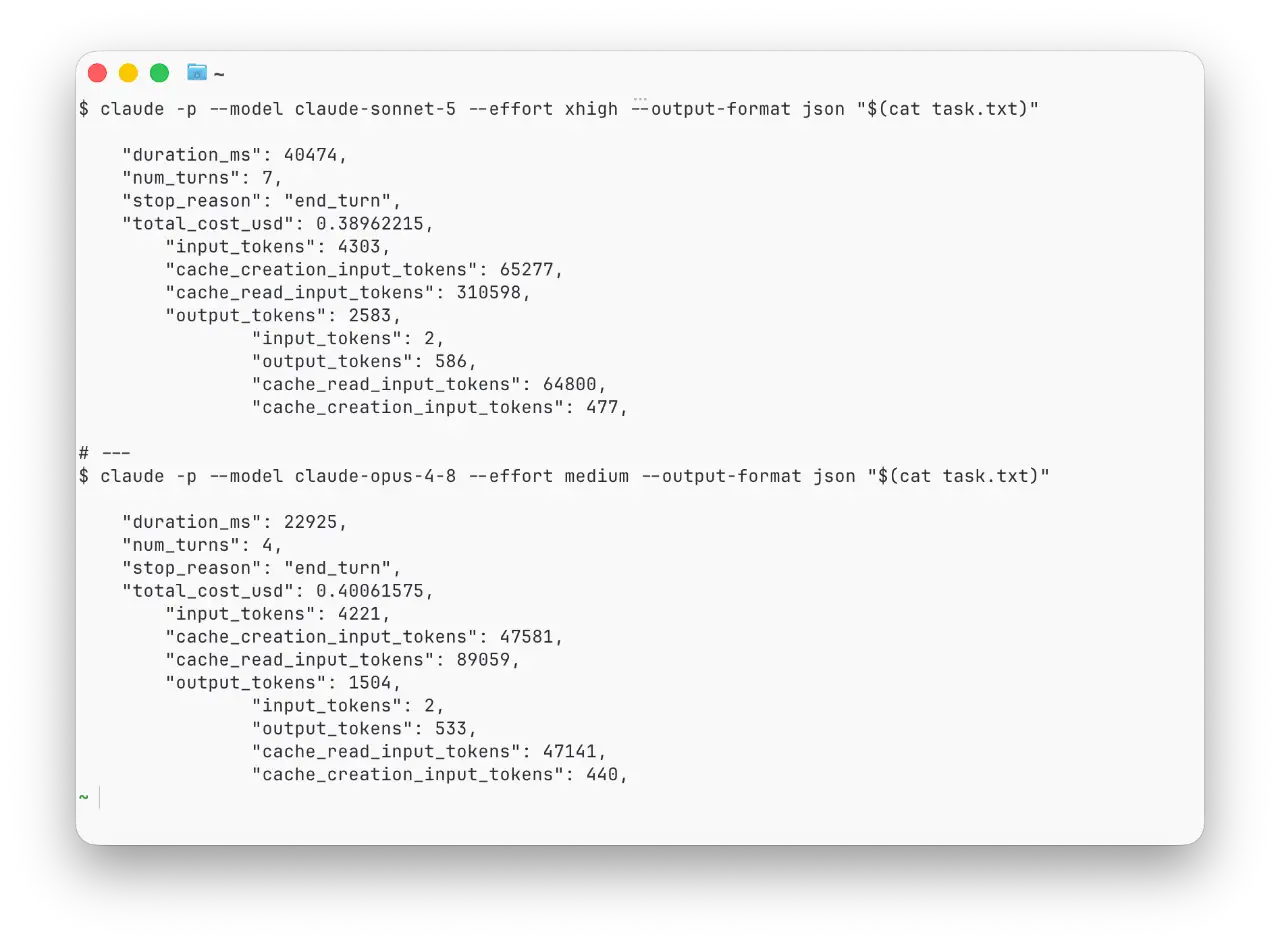
La pregunta que más queríamos responder: ¿Sonnet 5 sigue siendo más barato una vez que aumentas su nivel de esfuerzo para compensar una tarea más difícil? Ejecutamos la misma tarea de programación que en la Prueba 2 (abajo) con Sonnet 5 xhigh frente a Opus 4.8 medium.
Configuración | Costo | Duración | Turnos | Resultado |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
Una diferencia de costo del 3% — esencialmente un empate — y Opus 4.8 en su configuración de esfuerzo inferior terminó en el 57% del tiempo usando casi la mitad de las vueltas. Ambos produjeron código correcto y funcional. Esto coincide con lo que la gente ya está señalando en Hacker News: un comentarista allí estimó que Opus 4.8 costaba aproximadamente $0.45 en razonamiento medio frente a Sonnet 5 con aproximadamente $0.52 en xhigh/max para un trabajo comparable.
Prueba 2: Tarea de codificación con esfuerzo equivalente
Mismo prompt, ambos modelos con esfuerzo high: escribe una función eficiente de la subcadena palindrómica más larga, genera casos de prueba que cubran los casos límite, ejecútalos, corrige cualquier cosa que falle.
Configuración | Costo | Duración | Turnos | Resultado |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
Ambos llegaron al mismo enfoque de expandir desde el centro y aprobaron todas las pruebas en el primer intento. Opus 4.8 llegó allí más rápido y en menos turnos, por alrededor de un 16% más de dinero. Cuando la calidad es idéntica, este punto se lo lleva Opus solo por velocidad.
Prueba 3: Escritura / Trabajo del conocimiento
Un prompt de juicio empresarial sin una única respuesta correcta: asesora a una empresa SaaS de 12 personas sobre si gastar 3-4 semanas migrando a una segunda región de AWS para recuperación ante desastres, seis semanas antes de que cierre su Serie A.
Configuración | Costo | Duración | Turnos |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
Ambos dieron esencialmente la misma recomendación — omitir la migración completa, enviar en su lugar una solución ligera de respaldo/runbook — con una calidad de razonamiento comparable. Sonnet 5 llegó a eso en aproximadamente dos tercios del tiempo y costó un 14% menos. Esta es la única prueba en la que “Sonnet 5 se defiende bien en trabajo del conocimiento” quedó demostrado con claridad.
Prueba 4: Búsqueda agentiva — ¿Realmente Sonnet 5 "sobrepiensa"?
Algunos hilos de Reddit describen a Sonnet 5 como más propenso a sobrepensar solicitudes simples que Opus 4.8. Probamos una realmente simple: sumar el tamaño en bytes de cada archivo .py en un árbol de directorios e informar qué subdirectorio tiene más de ellos.
Configuración | Costo | Duración | Turnos |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
Ambos llegaron a la misma respuesta correcta. El costo fue prácticamente idéntico, con una diferencia apenas de redondeo, pero Sonnet 5 necesitó una llamada adicional a una herramienta y tardó aproximadamente un 50% más. Ese es un dato real, aunque modesto, para la queja de "sobrepensar" — y coincide con la Prueba 1: Sonnet 5 tiende a dar más pasos para llegar al mismo lugar.
Entonces, ¿cuál deberías usar realmente?
Elige Opus 4.8 para tareas de programación donde la velocidad importa, flujos de trabajo agénticos con muchas llamadas a herramientas, o cualquier cosa en la que de otro modo te sentirías tentado a subir el esfuerzo de Sonnet 5 por encima de
highpara confiar en la salida — esa es בדיוק la situación en la que desaparece la ventaja de coste de Sonnet 5.Elige Sonnet 5 para trabajos de gran volumen y sensibles al presupuesto, y para tareas generales de conocimiento/escritura, pero mantenlo en
mediumohighde esfuerzo. No lo subas reflexivamente axhigh“solo para ir sobre seguro” — ahí es donde se desmorona la historia de precios.Cualquiera de los dos funciona para búsquedas simples y solicitudes de una sola intervención; la diferencia práctica que medimos fue una intervención adicional y unos pocos segundos, no una respuesta incorrecta.
Preguntas frecuentes
¿Claude Sonnet 5 es realmente más barato que Opus 4.8?
A niveles de esfuerzo equivalentes, sí — notablemente. Pero pon Sonnet 5 en xhigh para compensar una tarea más difícil y la diferencia puede reducirse a unos pocos por ciento, mientras que Opus 4.8 en un ajuste de esfuerzo más bajo termina más rápido. Comprueba qué nivel de esfuerzo estás ejecutando realmente antes de asumir que estás ahorrando dinero. Para la lista completa de precios de Haiku, Sonnet y Opus, consulta nuestra guía de precios de la API de Claude.
¿Qué hay de Claude Sonnet 5 frente a Sonnet 4.6?
Una mejora generacional, no una elección de nivel de modelo — y el coste tampoco se mueve en la misma dirección ahí. Sonnet 5 supera a Sonnet 4.6 por dos dígitos en Terminal-Bench, pero en nuestras propias pruebas directas de coste, Sonnet 5 resultó más caro que Sonnet 4.6 en todos los niveles de esfuerzo que probamos, principalmente debido al nuevo tokenizer. Pruebas completas y cifras en Sonnet 5 vs Sonnet 4.6: ¿Es realmente más barato?
¿Es una comparación justa Claude Sonnet 5 vs Opus 4.6?
En realidad no: Opus 4.6 está una generación por detrás de Opus 4.8. Si estás decidiendo qué usar hoy, compáralo con Opus 4.8, no con su predecesor.
¿Difiere la ventana de contexto entre los dos?
No — ambos ofrecen una ventana de contexto de 1M tokens y un máximo de salida de 128K.
¿Por qué la tasa de inyección de prompts de Opus 4.8 es mucho más alta en el uso del navegador?
Según las divulgaciones de Anthropic, 31.5% sin salvaguardas adicionales frente al 0.93% de Sonnet 5, específicamente en escenarios de uso de navegador sin supervisión. Anthropic no ha publicado una explicación detallada. Trátelo como una razón para probar sus salvaguardas específicas en lugar de asumir que el modelo insignia es automáticamente la opción predeterminada más segura.
Apéndice: Prompts Exactos y Salida en Bruto
Para cualquiera que quiera reproducir esto, aquí están las indicaciones exactas que enviamos para cada prueba (la Prueba 1 y la Prueba 2 usaron la misma indicación de programación, solo en distintos niveles de esfuerzo).
Pruebas 1 & 2 — indicación de codificación:
Escribe una función de Python `longest_palindromic_substring(s: str) -> str` que devuelva
la subcadena palindrómica más larga de s, usando un enfoque más eficiente que
fuerza bruta O(n^3) (por ejemplo, expandir alrededor del centro o el algoritmo de Manacher). Guárdalo
en solution.py.

Luego escribe test_solution.py con al menos 6 casos de prueba que cubran: cadena vacía,
un solo carácter, caracteres todos iguales, ninguna palíndroma de longitud mayor que 1, una
palíndroma de longitud par y una palíndroma de longitud impar.

Ejecuta las pruebas con pytest y asegúrate de que todas pasen. Si alguna falla, corrige el
código y vuelve a ejecutar hasta que todas pasen. Informa la salida final de pytest.
Prueba 3 — indicación de redacción/trabajo de conocimiento:
Estás asesorando a una pequeña empresa SaaS (12 empleados, $80k MRR, actualmente en una
sola región de AWS) sobre si expandirse a una segunda región de AWS para recuperación
ante desastres antes de su ronda de financiación Serie A, que se cierra en 6 semanas.
Ingeniería estima que la migración toma 3-4 semanas y consumiría la mayor parte de la
capacidad del equipo durante esa ventana, retrasando dos funciones solicitadas por clientes.

Escribe una recomendación ejecutiva de ~350 palabras: ¿deberían hacerlo ahora, retrasarlo,
o buscar un punto intermedio? Justifica con compensaciones. Sin preámbulo, solo la
recomendación.
Prueba 4 — prompt de búsqueda agentiva:
En el árbol de directorios actual, encuentra todos los archivos con extensión .py, suma su
tamaño total en bytes y dime qué único subdirectorio (hijo inmediato
del directorio de trabajo) contiene la mayor cantidad de archivos .py por número. Solo los dos
números/respuesta, no hace falta escribir ningún archivo nuevo.
Aquí está la respuesta real de la API para la ejecución de Sonnet 5 (xhigh) de la Prueba 1, recortada a los campos relevantes para el costo y el tiempo:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
Ese es el total_cost_usd, duration_ms y los recuentos de tokens sin editar que devolvió la CLI de Claude Code para esa ejecución — los números de la tabla de la Prueba 1 anterior provienen directamente de campos como estos, una respuesta JSON por ejecución.