 AIREITER
Meter un modelo de 27.000 millones de parámetros en un teléfono ya no es solo una promesa llamativa. PrismML lo consigue con Bonsai 27B, una versión de Qwen3.6 27B cuantizada en ternario que puede reducirse hasta 3,9GB y generar alrededor de 11 tokens por segundo en un iPhone 17 Pro. Sus pesos se distribuyen gratis bajo licencia Apache 2.0, y la versión ternaria conserva más del 95% de la puntuación de benchmarks del modelo en precisión completa. Pero la pérdida de calidad no se reparte por igual: matemáticas y programación se mantienen cerca del original, mientras que el uso de herramientas y visión empeoran. Es una opción local muy interesante para razonamiento y código, pero menos fiable para flujos agénticos intensivos en herramientas. Aquí repasamos cómo logra esa compresión, qué significan sus cifras, las cuatro formas de usarlo y para quién merece la pena.
Así ha conseguido PrismML meter 27B parámetros en un móvil
Un modelo estándar de 27B en FP16 necesita aproximadamente 54GB de memoria, mucho más de lo que puede ofrecer cualquier teléfono. Bonsai 27B baja de los 6GB al sustituir los pesos de precisión completa por valores discretos diminutos.
En la variante ternaria, cada peso solo puede tomar uno de tres valores: -1, 0 o +1. En teoría, eso equivale a unos 1,58 bits de información por peso. PrismML añade escalado FP16 por grupos —un factor de escala de precisión completa para cada grupo de pesos, que permite conservar una magnitud adecuada tras reducir los valores—, con lo que el coste real se sitúa en torno a 1,71 bits efectivos por peso. La versión binaria de 1 bit va un paso más allá: elimina el cero y conserva únicamente -1 y +1, hasta llegar a cerca de 1,125 bits efectivos.
Hay dos matices importantes. El primero es que la compresión abarca todo el modelo: embeddings, atención, bloques MLP y la cabeza del modelo de lenguaje están cuantizados; no quedan componentes en precisión completa que actúen como apoyo. El segundo es que la base es Qwen3.6 27B, un modelo causal de atención híbrida con 27,8B parámetros. Por eso Bonsai hereda su ventana de contexto de 262K tokens y su entrada multimodal.
Versión ternaria o de 1 bit: cuál conviene descargar
PrismML ofrece dos versiones. Elegir mal implica renunciar sin necesidad a memoria o a calidad: cuanto menor es el archivo, menor es la precisión.
| Versión | Bits efectivos/peso | Tamaño | Calidad conservada | Mejor para |
|---|---|---|---|---|
| Ternaria (-1, 0, +1) | ~1.71 | 5.9GB | >95% de FP16 | Escritorio y trabajo sensible a la calidad |
| Binaria de 1 bit (-1, +1) | ~1.125 | 3.9GB | >90% de FP16 | Teléfonos y equipos con poca memoria |
Para un teléfono, la compilación de 1 bit es la que entra dentro del margen de memoria de un iPhone 17 Pro. Si dispones de un portátil o sobremesa con más margen, la ternaria recupera varios puntos de precisión a cambio de dos gigabytes adicionales. Merece la pena siempre que la calidad de salida pese más que el tamaño.
Qué revelan los benchmarks y dónde pierde calidad
Las cifras oficiales corresponden a la versión ternaria, que promedia 80.49 en 15 benchmarks con modo de razonamiento. Sus resultados más destacados son estos:
| Benchmark | Puntuación | Qué mide |
|---|---|---|
| MATH-500 | 99.20 | Matemáticas desde nivel escolar hasta competición |
| AIME 2025 | 90.84 | Matemáticas de competición exigentes |
| HumanEval+ | 93.90 | Generación de código |
| BFCL v3 | 74.41 | Llamada a funciones y herramientas |
Vistos en conjunto, estos datos perfilan bien a Bonsai 27B. Matemáticas y código se mueven en los 90; las llamadas a herramientas, en los 70. Es la principal limitación que debes tener presente: la cuantización preserva mucho mejor el razonamiento y la programación que el comportamiento estructurado y de varios pasos del que dependen los flujos agénticos.
Son datos de PrismML, así que conviene tomarlos como un punto de partida, no como una conclusión definitiva, hasta que haya más pruebas independientes. Más que el promedio de 80.49, interesa mirar los resultados por tarea y los fallos que aparecen en el uso real. Los primeros usuarios han informado de que la versión ternaria puede quedarse ocasionalmente atrapada en bucles de razonamiento, y una cuantización tan extrema suele perjudicar más la estabilidad con contextos largos de lo que deja ver una puntuación aislada. Antes de depender de él, merece la pena probarlo con tus propios prompts.
Rendimiento: velocidad y hardware compatible
Una compresión tan agresiva solo tiene valor si la inferencia sigue siendo lo bastante rápida para usarla. En hardware capaz, lo es. Estas son las cifras comunicadas por PrismML:
| Dispositivo | 1 bit | Ternaria |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
Los 11 tokens por segundo en un teléfono son suficientes para chat y razonamientos cortos, aunque no resulten espectaculares. En un M5 Max, los 87 tokens por segundo pueden hacer que la inferencia local supere a una llamada a una API en la nube para prompts breves, una vez se suma la latencia de red. PrismML también presenta el resultado en términos de densidad de inteligencia, es decir, puntuación de benchmark por gigabyte: Bonsai ronda 0.53, aproximadamente diez veces más que una referencia en precisión completa.
Cuatro formas de ejecutar Bonsai 27B hoy mismo
Al ser pesos abiertos, no existe una única ruta de instalación. Estas son las cuatro opciones disponibles, desde probarlo sin configurar nada hasta tener control total.
En un iPhone
La app de iOS Locally AI ejecuta directamente en el dispositivo la versión de 1 bit y 3.9GB, sin cuenta ni servidor. Es la vía que cumple la promesa de llevar un modelo de 27B al teléfono y funciona completamente sin conexión una vez descargados los pesos.
Desde el navegador
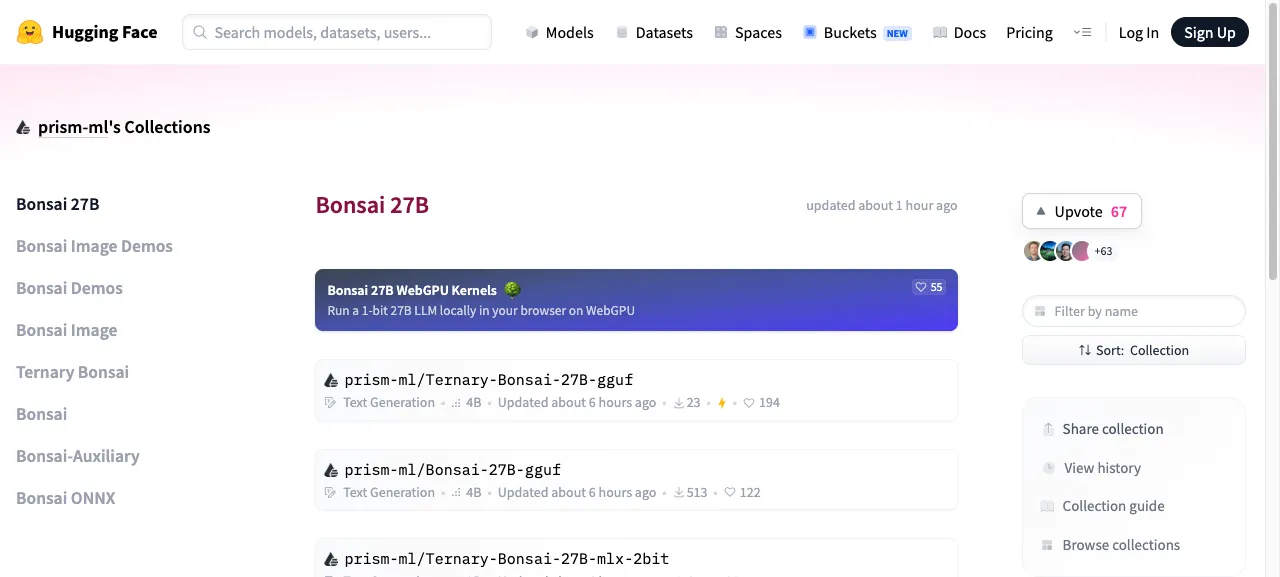
PrismML publica kernels WebGPU que permiten ejecutar el modelo de 1 bit dentro de una pestaña del navegador, sin instalar nada. Es la forma más rápida de probar Bonsai 27B antes de reservar espacio en disco, aunque necesitarás un equipo con una GPU compatible con WebGPU.
En tu propio equipo
Los pesos en GGUF, MLX y ONNX están disponibles en Hugging Face y GitHub bajo Apache 2.0. Los repositorios principales son prism-ml/Bonsai-27B-gguf para 1 bit y prism-ml/Ternary-Bonsai-27B-gguf para la versión ternaria; también hay compilaciones MLX de 2 bits y ONNX. Calcula unos 4GB de almacenamiento y RAM libres para la versión de 1 bit, y 6GB para la ternaria. Hay una salvedad: las herramientas aún van por detrás del lanzamiento. Los pesos cargan en varios runtimes, pero al salir todavía no había soporte completo en aplicaciones locales populares como LM Studio, así que es razonable esperar cierta configuración manual.
Mediante una API alojada
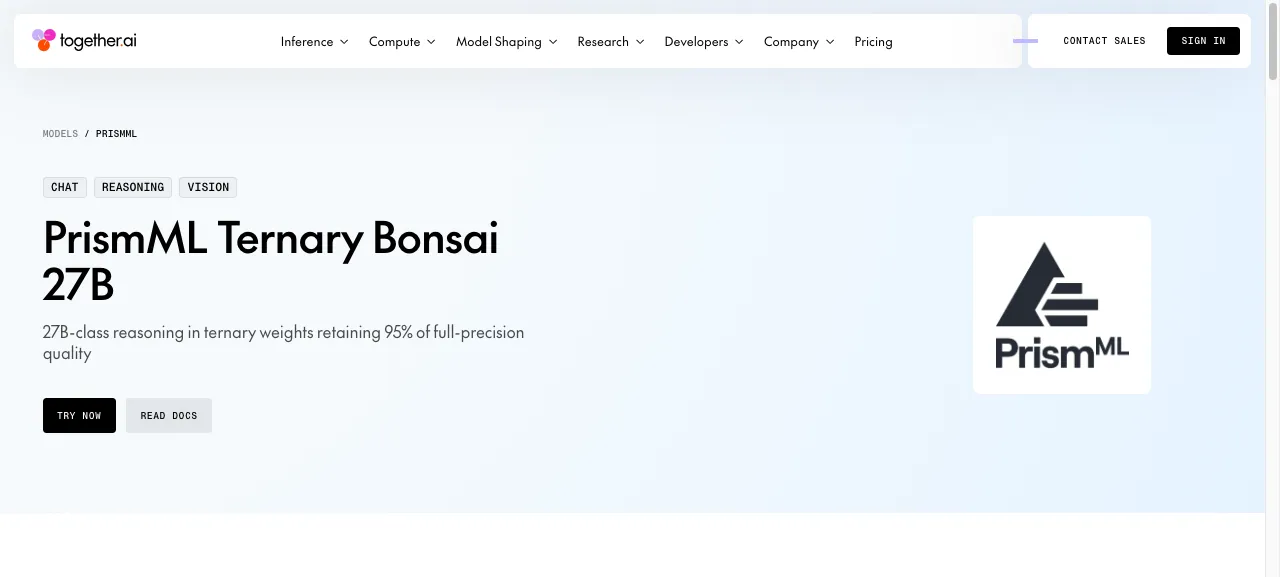
Si prefieres no gestionar los pesos, Together.ai ofrece la versión ternaria mediante una API estándar, con la ventana de contexto completa de 262K, entrada de visión y modo JSON. Durante la promoción de lanzamiento, el precio de entrada figuraba como $0.00 por millón de tokens. Comprueba la tarifa vigente antes de planificar presupuesto, porque los precios promocionales cambian.
Bonsai 27B frente a Gemma 4 12B QAT
La comparación más habitual es con Gemma 4 12B QAT, el modelo de Google entrenado con cuantización consciente, que ocupa alrededor de 7GB: solo un poco más que la versión ternaria de Bonsai.
Destacan en aspectos distintos. Gracias a su base de 27B, Bonsai 27B supera claramente a Gemma en benchmarks de matemáticas y programación. Gemma suele mantenerse mejor en visión y llamadas a herramientas, y sus pesos algo mayores y menos comprimidos la convierten en una alternativa de propósito general más estable para un teléfono. Para razonamiento local y código, Bonsai es la opción más potente; si predominan las imágenes o las llamadas a funciones, Gemma 4 12B QAT es la apuesta más segura.
Para quién tiene sentido Bonsai 27B
Usa Bonsai 27B si buscas asistencia privada, sin conexión y en el propio dispositivo para razonamiento o programación, y cuentas con un iPhone 17 Pro o un portátil capaz. También es un caso de estudio atractivo para quien tenga interés en la cuantización extrema: que un modelo de 27B pueda ejecutarse en una pestaña del navegador es un hito real, y la licencia abierta Apache 2.0 facilita experimentar. Encaja de forma natural junto a otros modelos abiertos y gratuitos que merece la pena ejecutar para programar cuando buscas una alternativa local.
Por ahora, no lo uses en sistemas agénticos de producción que requieran llamadas a herramientas fiables, en tareas donde la visión sea crítica ni en escenarios donde un bucle de razonamiento tenga un coste elevado. En esos casos, sigue siendo más prudente un modelo menos comprimido o uno en precisión completa servido mediante API.
Preguntas frecuentes
¿Bonsai 27B es gratis?
Los pesos son gratuitos bajo la licencia Apache 2.0, por lo que puedes descargarlos y ejecutarlos sin coste. El acceso alojado de Together.ai tiene su propia tarifa de API, que durante el lanzamiento figuraba como $0.00 por millón de tokens de entrada; confirma el precio actual.
¿Bonsai 27B realmente puede funcionar en un teléfono?
Sí. La versión de 1 bit ocupa 3.9GB y funciona en un iPhone 17 Pro a unos 11 tokens por segundo mediante la app Locally AI, completamente sin conexión después de descargarla.
¿Bonsai 27B es tan bueno como Qwen3.6 27B completo?
Se acerca, pero no es idéntico. La versión ternaria conserva más del 95% del rendimiento en benchmarks de la precisión completa, y la de 1 bit más del 90%. La retención es mayor en matemáticas y código, y menor en llamadas a herramientas.
¿Qué archivo de Bonsai 27B debo descargar?
En un teléfono o un equipo con poca memoria, elige la versión de 1 bit (prism-ml/Bonsai-27B-gguf, unos 3.9GB). En un sobremesa o una GPU con espacio disponible, descarga la ternaria (prism-ml/Ternary-Bonsai-27B-gguf, unos 5.9GB) para ganar unos puntos de precisión. También existen variantes MLX de 2 bits y ONNX para Apple Silicon y runtimes multiplataforma.
¿Qué es la cuantización ternaria?
Es una técnica que almacena cada peso del modelo como uno de tres valores —-1, 0 o +1— en lugar de como un número de precisión completa. De ahí que el modelo pueda reducirse tanto. Los factores de escala FP16 ayudan a mantener los pesos reducidos en una magnitud aproximadamente correcta.
¿Bonsai 27B admite imágenes?
Sí. Acepta imágenes junto con texto como entrada y genera texto como salida, ya que hereda la capacidad multimodal de su base Qwen3.6 27B. La calidad de visión resiste peor la compresión que las matemáticas y el código.