 AIREITER
Ein Claude-Code-Nutzer hat einen Monat Arbeit zum Max-Tarif zu API-Listenpreisen nachgerechnet: 7.470 $ standen am Ende einer Rechnung von 200 $ gegenüber. Das Problem ist nicht der Tokenpreis an sich. Bei der API fällt die Obergrenze weg, die das Abo stillschweigend gesetzt hat – und Agenten schicken deutlich mehr Tokens erneut durch das Modell, als ein Mensch jemals in ein Chatfenster tippen würde.
Warum die Unterschiede so groß ausfallen
Die Größenordnung der Erfahrungsberichte ist erstaunlich einheitlich. In einem Thread auf r/ClaudeAI wurden Claude-Code-Sitzungsprotokolle rekonstruiert: Ein Monat mit Max-Nutzung entsprach demnach rund 7.470 $ zum API-Listenpreis – bei einem Abo für 200 $. In einem kleineren Thread zum Vergleich von Abo und API kam ein Nutzer mit 200-$-Tarif für dieselbe Arbeitslast auf 5.000–20.000 $ pro Monat.
Das sind nicht geprüfte Schätzungen von Nutzern. In beiden Fällen steckt aber derselbe Token-Treiber dahinter: Ein Agent arbeitet sich wieder und wieder durch ein Repository.
„Ich nutze für meine Firma einen Enterprise-API-Tarif über Claude Code und kann aus erster Hand sagen: Bei größeren Projekten sind 100–200 $ API-Kosten pro Sitzung selbst beim ganz normalen Programmieren problemlos möglich.“ – u/andywidjaja, r/ClaudeAI
Abo und API-Key sind zwei verschiedene Produkte
Anthropic trennt die beiden Angebote ausdrücklich. Im Hilfeartikel, aktualisiert am 16. März 2026, bezeichnet das Unternehmen Claude-Tarife und die Claude Console als „separate products designed for different purposes“ und stellt klar, dass ein kostenpflichtiges Abo „doesn't include access to the Claude API or Console“. Auch OpenAI hält die Systeme getrennt und rechnet ChatGPT und die API-Plattform separat ab.
Der bessere Vergleich setzt deshalb bei dem an, was jeweils verkauft wird:
| Kostenpflichtiger Chat-Tarif | API-Key | |
|---|---|---|
| Verkaufte Einheit | Ein menschlicher Nutzer | Token-Durchsatz |
| Obergrenze | Rollierendes 5-Stunden-Fenster plus Wochenlimits | Kein enthaltenes Kontingent; Rate- und Ausgabenlimits gelten trotzdem |
| Zugriff | Web-, Desktop- und Mobile-Apps | Dein eigener Code |
| Preismodell | Fix pro Monat | Variabel, pro Token |
| Für das eigene Produkt | Nicht dafür gedacht | Genau dafür gedacht |
Auf der Claude-Preisseite kostet Pro 20 $ pro Monat bei monatlicher Zahlung oder 17 $ bei jährlicher Abrechnung (200 $ im Voraus). Max startet bei 100 $ pro Monat und bietet entweder das 5- oder das 20-Fache der Pro-Nutzung pro 5-Stunden-Sitzung. Anthropic veröffentlicht für diese Stufen keine Nachrichtenanzahl, weil der Verbrauch von Gesprächslänge, Modell und Funktionen abhängt. Verglichen wird also eine gemessene Größe mit einer nicht gemessenen.
Auf derselben Seite findet sich ein weiterer wichtiger Hinweis: Claude Enterprise kombiniert eine monatliche Gebühr von 20 $ pro Sitz mit Nutzung, die zu API-Preisen abgerechnet wird. Bei intensiver Nutzung landet man also wieder beim Zähler.
Wie viele Tokens ein Abo-Dollar zum Listenpreis kauft
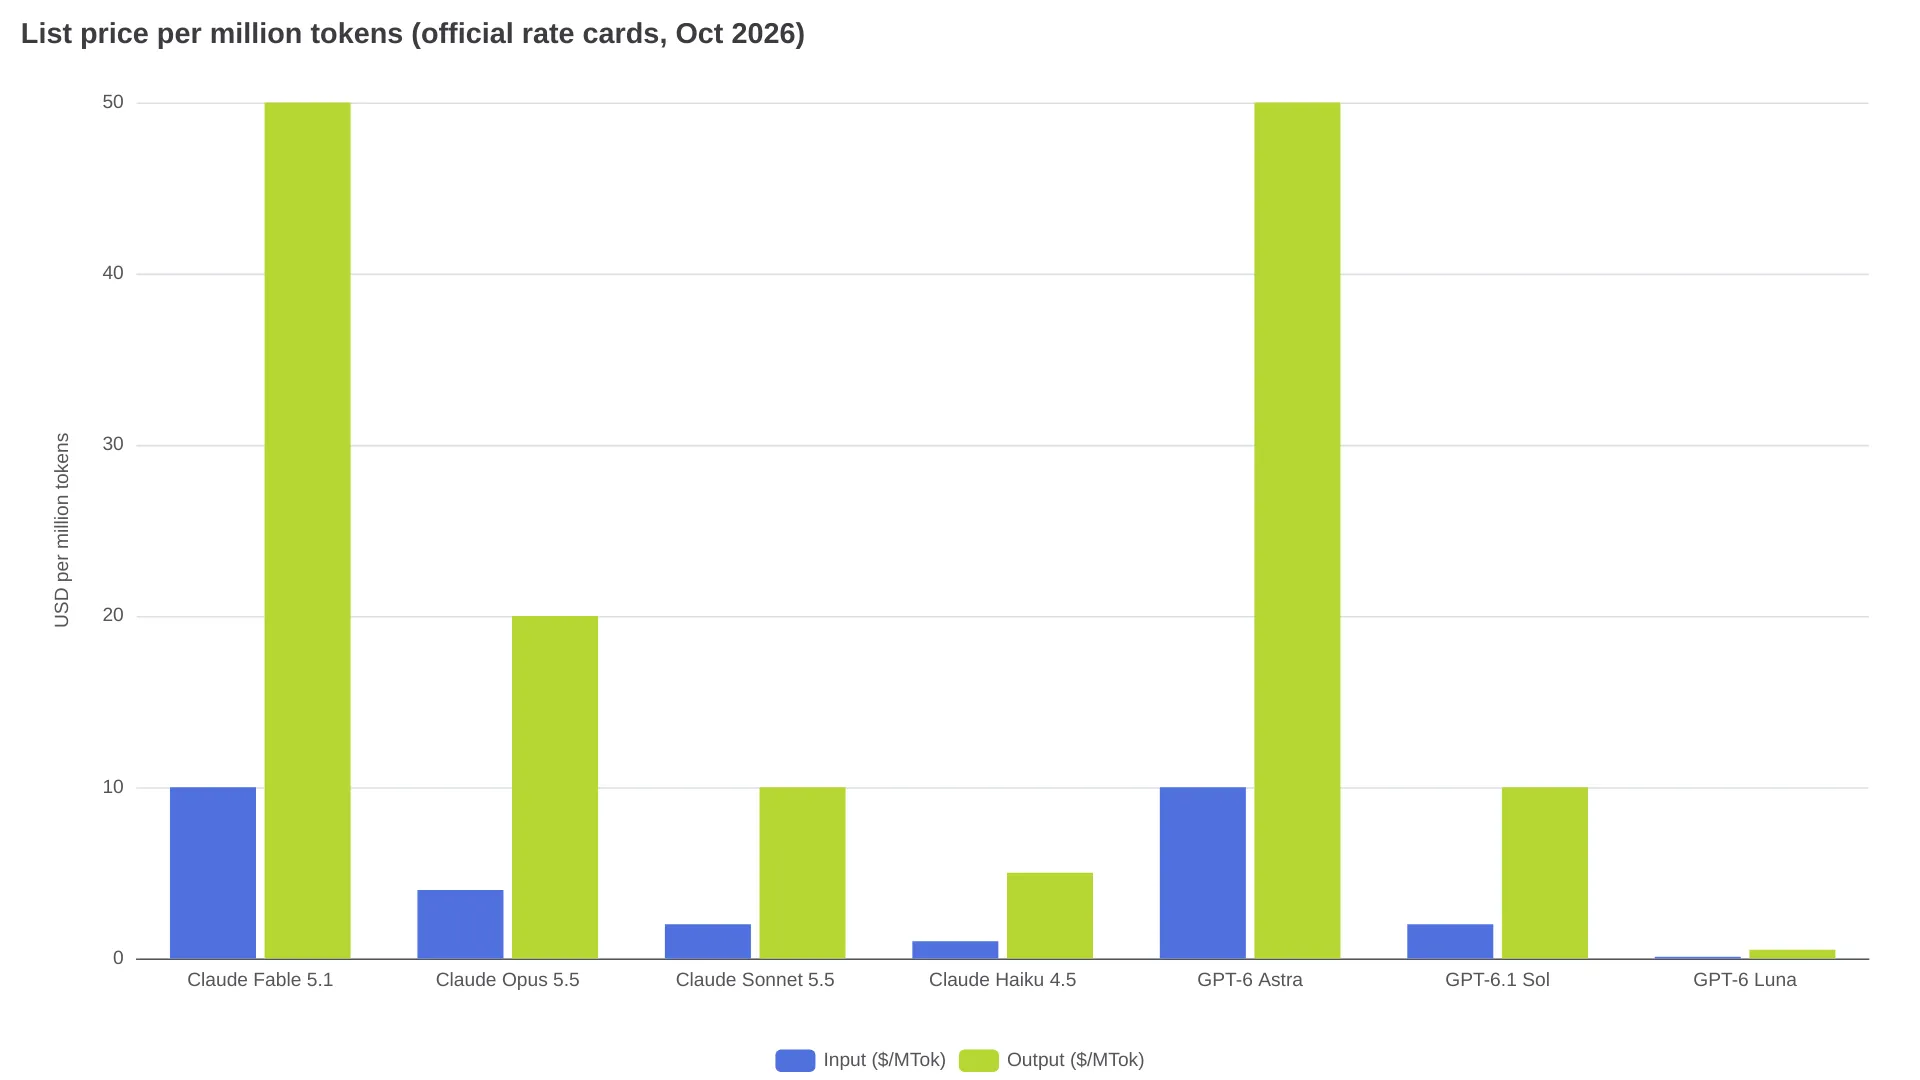
Wer die Tarifkosten in Tokens umrechnet, sieht den Unterschied sofort. Die folgenden offiziellen Preise gelten pro einer Million Tokens (MTok) und stammen aus den Preislisten der Claude-Plattform und der API-Preisseite von OpenAI, geprüft am 1. Oktober 2026.
| Modell | Eingabe | Ausgabe | Cache-Lesen | Batch (rein/raus) |
|---|---|---|---|---|
| Claude Fable 5.1 | 10 $ | 50 $ | 0,25 $ | 5 $ / 25 $ |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ | 2 $ / 10 $ |
| Claude Sonnet 5.5 | 2 $ | 10 $ | 0,20 $ | 1 $ / 5 $ |
| Claude Haiku 4.5 | 1 $ | 5 $ | 0,10 $ | 0,50 $ / 2,50 $ |
| GPT-6 Astra | 10 $ | 50 $ | 1,00 $ | 5 $ / 25 $ |
| GPT-6.1 Sol | 2 $ | 10 $ | 0,10 $ | 1 $ / 5 $ |
| GPT-6 Luna | 0,10 $ | 0,50 $ | 0,01 $ | 0,05 $ / 0,25 $ |
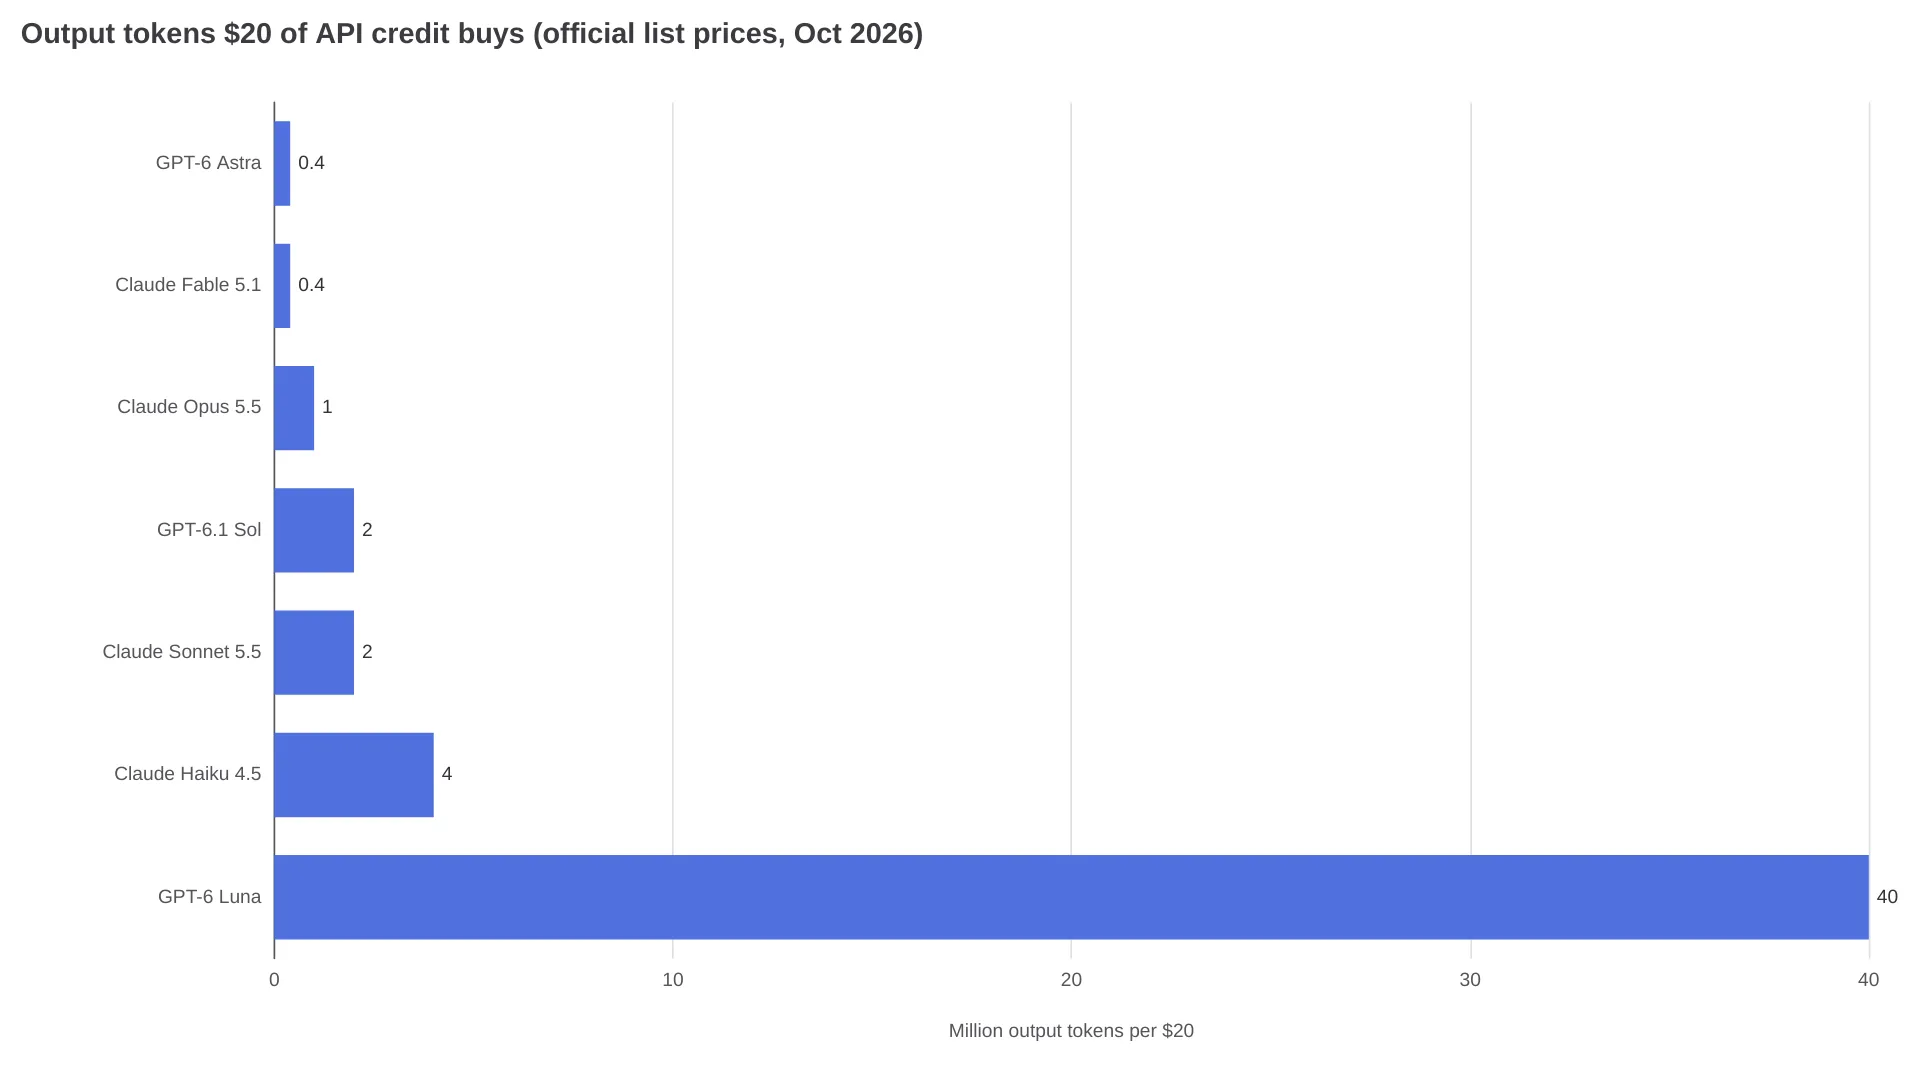
Bei einer typischen Chat-Arbeitslast – ein paar tausend Wörter Kontext und einige hundert Wörter Antwort – reichen 20 $ Guthaben bei Sonnet 5.5 für ungefähr 10 Millionen Eingabe-Tokens oder 2 Millionen Ausgabe-Tokens. Die eigene Rechnung ergibt sich aus vier Feldern der API-Antwort: (neue Eingabe × Eingabepreis) + (gecachte Eingabe × Cache-Lesepreis) + (Cache-Schreibvorgänge × Schreibpreis) + (Ausgabe × Ausgabepreis). Batch-, Langkontext- und Regionalaufschläge kommen gegebenenfalls noch hinzu. Wer diese vier Werte pro Endpunkt eine Woche lang protokolliert, hat eine Monatszahl, die sich direkt mit einem Sitzplatz vergleichen lässt.
Wo die Tokens tatsächlich verschwinden
Vier typische Ursachen für unerwartete Tokenkosten stehen nicht direkt auf der Preistabelle. Die letzten drei sind in der Analyse von LLM Cost Lab zu Kosten abseits der Listenpreise dokumentiert.
- Der Verlauf wird bei jeder Runde erneut gesendet. Bei anfragebasierten Chat-Integrationen schickt der Client die Historie mit. Runde 20 enthält also die Runden 1 bis 19. Wenn jede Runde ähnlich viel Kontext hinzufügt, wächst das Eingabevolumen ungefähr quadratisch mit der Gesprächslänge. Genau deshalb kommt die Analyse für eine 20-Runden-Sitzung auf 0,163 $, während einzelne unabhängige Aufrufe mit 0,063 $ veranschlagt wurden – eine Differenz vom 2,6-Fachen.
- Der System-Prompt wird mit jedem Aufruf vervielfacht. Ein System-Prompt mit 2.000 Tokens erzeugt bei 1 Million Anfragen 2 Milliarden Eingabe-Tokens, noch bevor ein Nutzer überhaupt etwas schreibt.
- Unsichtbare Reasoning-Tokens. Bei Modellen, die interne Denkspuren als Ausgabe abrechnen, können diese Tokens ein Mehrfaches der sichtbaren Antwort ausmachen. Wer nur die zurückgegebenen Zeichen misst, unterschätzt die Rechnung.
- Tool-Ergebnisse, Wiederholungen und verworfene Generierungen. Sobald das Modell etwas generiert, wird es berechnet – auch die Antwort, die dein JSON-Validator ablehnt, und der parallele Aufruf, den du gestartet und anschließend verworfen hast.
Auch günstige Tokens können eine Rechnung dominieren. Genau das sorgt für Verwirrung, wenn Nutzer ihr eigenes Dashboard ansehen. Im Thread zu den 7.470 $ wies ein Kommentator darauf hin, dass Cache-Lesevorgänge trotz ihres niedrigen Preises 48 % der Gesamtsumme ausmachten.
„Das ist bereits der günstigste Token-Typ der API. Wenn er nach Anwendung der Listenpreise trotzdem dominiert, besteht die eigentliche Arbeitslast größtenteils darin, den Kontext in jeder Runde erneut zu lesen.“ – u/YoanEdwin, r/ClaudeAI
Wendet man die Opus-5.5-Preise auf eine Agentenrunde mit 150.000 Tokens Repository-Kontext an, wird die Kostenstruktur sichtbar:
| Opus 5.5, 60-Runden-Sitzung, 150.000 Kontext-Tokens + 2.000 Ausgabe-Tokens pro Runde | Kosten |
|---|---|
| Neue Eingabe pro Runde, kein Cache-Treffer (150.000 @ 4 $) | 0,60 $ |
| Cache-Lesen pro Runde statt neuer Eingabe (150.000 @ 0,20 $) | 0,03 $ |
| Ausgabe pro Runde (2.000 @ 20 $) | 0,04 $ |
| Ein 1-stündiger Cache-Schreibvorgang pro Sitzung (150.000 @ 8 $) | 1,20 $ |
| Gesamtkosten der Sitzung, ohne Cache | 38,40 $ |
| Gesamtkosten der Sitzung, mit Cache | 5,40 $ |
Zwei gecachte Sitzungen pro Tag an 22 Arbeitstagen ergeben ungefähr 238 $ und liegen damit bereits über einem 200-$-Tarif. Ohne Cache kostet derselbe Monat mehr als 1.600 $. Der Preis pro Token hat sich nicht verändert – nur die Tokenmenge.
Es gibt drei Stufen, nicht zwei
Die meisten Vergleiche stellen Abo und API gegenüber. Eine dritte Stufe kommt ins Spiel, sobald das Kontingent aufgebraucht ist: zusätzliche Nutzungsguthaben, die innerhalb des Abo-Produkts verkauft werden.
Berichte aus r/codex ordnen diese Stufe preislich sogar über der reinen API ein. Ein Pro-Nutzer protokollierte ungefähr 16 Millionen Tokens, die über gekaufte Guthaben für rund 40 $ verbraucht wurden. Zum Vergleich schätzte er dieselbe Menge zum API-Listenpreis auf ungefähr 12 $.
„Ja, die Guthabenpreise sind schon fast räuberisch. 50 $ für eine einzelne Landingpage sind absurd, wenn die API dafür ungefähr 2 $ kosten würde.“ – u/AbjectBug5885, r/codex
Das sind Nutzerschätzungen und keine allgemeingültigen Preise. Außerdem unterscheiden sich die Nachkaufpreise je nach Anbieter und Tarif. In den genannten Codex-Fällen lag diese dritte Stufe ungefähr beim Dreifachen der entsprechenden API-Listenpreise. Wer regelmäßig Guthaben nachkauft, sollte das vor dem zweiten Kauf mit den eigenen Zahlen abgleichen.
Fünf Stellschrauben für eine niedrigere Rechnung
Für jede dieser Stellschrauben gibt es einen offiziellen Preis. Die Rechnung lässt sich also zunächst anhand der Anbieterangaben überprüfen.
- Prompt-Caching – inklusive Aufpreis fürs Schreiben. Laut den Anthropic-Preisangaben kostet ein 5-Minuten-Cache-Schreibvorgang das 1,25-Fache des normalen Eingabepreises, ein 1-Stunden-Schreibvorgang das Doppelte. Das Lesen liegt beim 0,1-Fachen des Basistarifs (0,05× bei Opus 5.5 und 0,025× bei Fable 5.1). Ein 5-Minuten-Schreibvorgang amortisiert sich nach einem Lesen, ein 1-Stunden-Schreibvorgang nach zwei. Wird der Cache einmal beschrieben und nie gelesen, ist er teurer als gar kein Caching. Auch die Reihenfolge entscheidet: Stabile Inhalte gehören an den Anfang, variable Nutzereingaben ans Ende – sonst passt das Präfix nicht mehr. Tipps zur Analyse der Trefferquote stehen in diesem Leitfaden zum Prompt-Caching.
- Alles stapeln, was nicht sofort fertig werden muss. Beide Anbieter halbieren die Listenpreise für asynchrone Verarbeitung: Opus 5.5 sinkt auf 2 $/10 $, Sonnet 5.5 auf 1 $/5 $. Die Abdeckung ist allerdings unterschiedlich: LLM Cost Lab zählt bei 26 von 83 erfassten Modellen eine vergünstigte Batch-Stufe. Bevor du deine Architektur darauf ausrichtest, solltest du prüfen, ob dein Modell dazugehört. Die technischen Details stehen in unserem Leitfaden zu Batch-API-Preisen.
- Das Modell an die Aufgabe anpassen. Für Klassifizierung, Routing und Retrieval braucht es selten ein Spitzenmodell. Haiku 4.5 kostet 1 $/5 $, Fable 5.1 dagegen 10 $/50 $. Bei Schritten, die nur zehn Tokens ausgeben, liegt dazwischen trotzdem ein Faktor von 10.
- Die Ausgabe begrenzen – nicht nur
max_tokens. Die Ausgabe kostet in fast jeder Tabellenzeile das Fünffache der Eingabe. Ein Schema ohne Vorrede verursacht etwas strukturellen Overhead, verhindert aber den Prosa-Teil, für den sonst ebenfalls abgerechnet würde.max_tokensfunktioniert besser als Sicherheitsgrenze denn als Formatierungswerkzeug, weil eine abgeschnittene Antwort einen zweiten kostenpflichtigen Versuch nötig machen kann. - Die Aufschläge im Blick behalten. OpenAIs Langkontext-Stufe verdoppelt die Eingabepreise für kurze Kontexte, der Fast-Modus verdoppelt die Standardpreise anschließend erneut. Anthropic berechnet für US-gebundene Inferenz das 1,1-Fache. In den Preisangaben steht außerdem, dass Claude 4.7 und spätere Modelle einen neuen Tokenizer verwenden, der für denselben Text ungefähr 30 % mehr Tokens erzeugt. Dein Prompt hat sich nicht verändert – der Zähler schon.
Eine strukturelle Option steht außerhalb dieser Liste: Programmzugriffe lassen sich über einen einzigen abgerechneten Endpunkt führen, statt für jeden Anbieter eine eigene Abrechnungsbeziehung zu pflegen. Genau dafür ist der Claude-API-Endpunkt von AIReiter gedacht. Bei Listenpreisen kostet ein Monat mit 40 Millionen Sonnet-kompatiblen Eingabe-Tokens und 8 Millionen Ausgabe-Tokens 80 $ + 80 $. Der Vergleich mit einem zweiten Sitzplatz ist damit in etwa einer Minute erledigt.
Was solltest du kaufen?
| Deine Situation | Kauf | Warum |
|---|---|---|
| Chat, Recherche und gelegentliches Programmieren in einer App | Nur den kostenpflichtigen Tarif | Begrenzte Ausgaben, enthaltene Apps, Nutzung deutlich unter den Tariflimits |
| Agentengestütztes Programmieren allein auf einem Rechner | Zuerst den Tarif, API-Key für Spitzen | Der Tarif deckt den Großteil ab; der Key verhindert die Wartezeit bis zum wöchentlichen Reset |
| Ein Produkt, das von anderen genutzt wird | Nur die API | Ein Sitzplatz deckt einen Menschen ab; deine Nutzer brauchen eigenen Durchsatz |
| Regelmäßige Batch-Jobs: Evaluierungen, Backfills, Klassifizierung | API mit Batch-Tarif | 50 % Rabatt auf den Listenpreis, Latenz spielt keine Rolle |
| Fast jede Woche zusätzliche Guthaben kaufen | Spitzen gegen einen API-Key rechnen | Die gemeldeten Guthabenpreise lagen über den API-Listenpreisen |
FAQ
Sind API-Guthaben in einem kostenpflichtigen ChatGPT- oder Claude-Tarif enthalten?
Nein. Anthropic schreibt im Hilfe-Center ausdrücklich, dass ein kostenpflichtiger Claude-Tarif „doesn't include access to the Claude API or Console“. OpenAI rechnet ChatGPT und die API-Plattform über getrennte Systeme ab. Wer beides nutzt, bezahlt also zwei Positionen.
Bezahle ich für Reasoning-Tokens, die ich nie sehe?
Ja – bei Modellen, die Denken oder erweitertes Reasoning anbieten. Diese Tokens werden zum Ausgabepreis abgerechnet, tauchen aber nicht im Antworttext auf. Deshalb solltest du das usage-Objekt auswerten.
Bezahle ich bei jeder Runde für das komplette Gespräch?
Ja, sofern kein Cache-Treffer das wiederholte Präfix abdeckt. Ohne serverseitige Zustandsfunktion schickt dein Client die für das Modell relevante Historie erneut. Diese Historie wird als neue Eingabe zum Modellpreis berechnet – oder zum Cache-Lesepreis, wenn das Präfix wiedererkannt wurde.
Kostet eine fehlgeschlagene oder wiederholte Anfrage trotzdem Geld?
Laut der Abrechnungsanalyse von LLM Cost Lab wird eine Anfrage berechnet, wenn sie das Modell erreicht und eine Antwort zurückkommt – auch wenn die Anwendung das Ergebnis wegen eines Schemafehlers oder eines Client-Timeouts verwirft. Eine Ausnahme sind Anfragen, die noch vor der Generierung abgewiesen werden.
Der Zielkonflikt bleibt bestehen
Tarife begrenzen die Ausgaben, rationieren aber den Zugriff. Bei API-Keys ist es genau umgekehrt. Weil Anbieter keinen Token-Gegenwert für ein Tarifkontingent veröffentlichen, lässt sich die Frage „Was ist für mich günstiger?“ erst nach einer Woche mit eigenen, instrumentierten Nutzungsdaten und der obigen Preistabelle belastbar beantworten.
Weiterführend: Günstigste LLM-API 2026 · Claude-API-Preisleitfaden