 AIREITER
OpenRouter meldete zum Start seines Dashboards eine plattformweite Cache-Hit-Rate von 82,8 % (@OpenRouter). In der Praxis zeichnet die Community oft ein anderes Bild: Hit-Raten von unter 1 % (@miolini) und Rechnungen, die 10- bis 32-mal höher ausfallen als erwartet (r/openrouter). Prompt Caching über OpenRouter kann die Input-Kosten deutlich senken – allerdings erst, wenn vier typische Fehlerquellen ausgeräumt sind. Der größte Hebel: Aufeinanderfolgende Requests müssen beim selben bereits aufgewärmten Provider landen. Eine harte Grenze gilt vorab: Liegt ein Prompt unter dem Token-Minimum des Providers, wird er unabhängig von jeder Konfiguration nie gecacht.
Wann OpenRouter einen Prompt-Cache-Treffer zählt
Beim Prompt Caching verarbeitet der Provider einen unveränderten Prompt-Anfang nicht erneut. Wiederkehrende Input-Tokens werden dann rabattiert statt zum vollen Preis abgerechnet. Der Cache liegt allerdings beim konkreten Provider-Endpunkt, der den ersten Request bedient hat – deshalb ist das Routing mindestens so wichtig wie der Prompt-Aufbau. Davon zu unterscheiden ist Response Caching: Es liefert einen vollständig identischen Request kostenlos aus, noch bevor überhaupt ein Routing stattfindet.
| Prompt Caching | Response Caching | |
|---|---|---|
| Was wiederverwendet wird | Stabiler Präfix von beliebigen Requests | Byte-identischer Request (SHA-256 des normalisierten Bodys) |
| Aktivierung | Meist automatisch; cache_control für Anthropic, Qwen und Gemini | Header X-OpenRouter-Cache: true oder Preset |
| Kosten | Gecachte Tokens zum 0,1- bis 0,5-fachen Input-Preis | Treffer kostenlos, Fehlversuche regulär abgerechnet |
| Laufzeit | Typisch 3–5 Min., bis zu 1 Std. bei Anthropic | Standard 300 Sek., Bereich 1–86.400 Sek. |
| Kein Treffer bei | Geändertem Präfix, Provider-Wechsel, Token-Minimum | Jeder JSON-Änderung, API-Key-Rotation, ZDR auf Kontoebene |
Response Caching eignet sich besonders für Retries, Unit-Tests und wiederholte identische Aufrufe in Agent-Workflows. Selbst die Reihenfolge von JSON-Eigenschaften gehört zum Cache-Key – eine harmlose Änderung bei der Serialisierung reicht also für einen Miss. Die maßgebliche Referenz zu den Provider-Mechanismen ist OpenRouters Prompt-Caching-Leitfaden:
Prompt-Caching-Kosten bei OpenRouter nach Provider
Gecachte Lesevorgänge kosten bei allen Providern nur einen Bruchteil des normalen Input-Preises. Das erste Schreiben in den Cache kann dagegen einen Aufschlag haben: Bei Anthropic etwa das 1,25-Fache des regulären Inputs für die standardmäßige TTL von 5 Minuten und das 2-Fache für die 1-Stunden-Option. Caching lohnt sich erst, wenn derselbe Präfix oft genug gelesen wird, um diesen Schreibvorgang zu amortisieren. Bei einem einmaligen Request kann Caching sogar teurer sein als kein Caching. Bei Claude Sonnet 4.6 kostet gecachter Input laut OpenRouters eigener Beispielrechnung 0,30 $/M gegenüber 3,00 $/M für neuen Input.
Die Schreib- und Lesemultiplikatoren je Provider, aus derselben Quelle:
| Provider | Cache-Schreiben | Cache-Lesen | Hinweise |
|---|---|---|---|
| Anthropic | 1,25x (5 Min.) / 2x (1 Std.) | 0,1x | TTL pro Breakpoint wählbar |
| OpenAI, vor GPT-5.6 | Kostenlos | 0,25–0,5x | Automatisch ab 1.024 Tokens |
| OpenAI GPT-5.6+ | 1,25x | 0,25–0,5x | Explizite Breakpoints jetzt unterstützt |
| Google Gemini | Kostenlos | 0,25x | Implizit bei 2.5+, TTL ca. 3–5 Min. |
| Grok | Kostenlos | 0,25x | Automatisch |
| Moonshot | Kostenlos | 0,25x | Automatisch |
| Groq | Kostenlos | 0,5x | Nur Kimi-K2-Modelle |
| DeepSeek | 1,0x | 0,1x | Schreibvorgänge wie regulärer Input abgerechnet |
| Alibaba Qwen | 1,25x | 0,1x | Explizites cache_control erforderlich |
| Z.AI | Kostenlos | ~0,2x | Gecachter Speicher als zeitlich begrenzt kostenlos ausgewiesen |
OpenRouters Tutorial rechnet mit 10.000 wiederholten Tokens über sechs Turns: 6,0x gegenüber einem einzelnen ungecachten Turn, 1,75x mit Anthropics 5-Minuten-Cache und Sticky Routing sowie 2,25x bei einem Provider mit kostenlosem Schreiben und Lesezugriffen zum 0,25-Fachen. Wachsende Nachrichten und Output-Tokens sind in diesem Modell nicht enthalten.
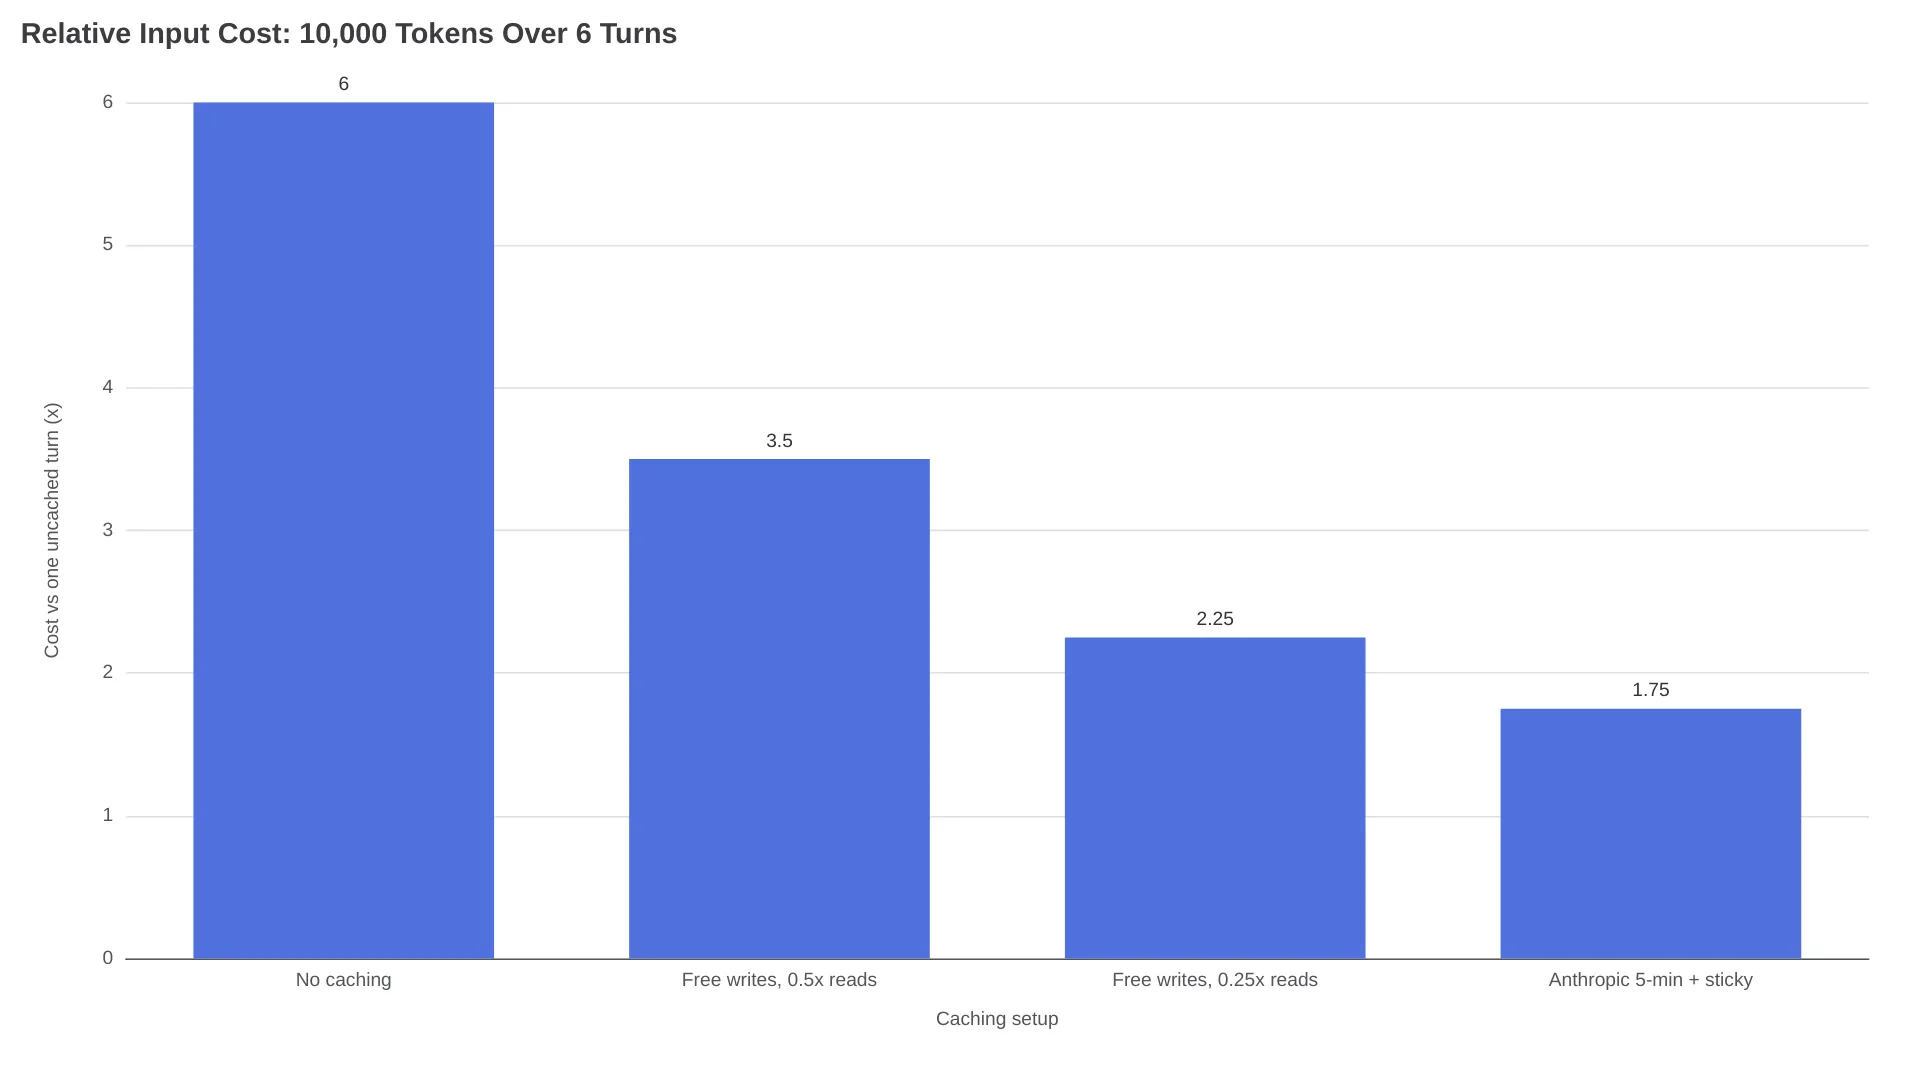
Der teure Anthropic-Schreibvorgang gewinnt nach sechs Turns, weil die Lesezugriffe zum 0,1-Fachen ab Turn zwei überwiegen; mit weiteren Turns wird der Abstand größer. Nur wenn die 5-Minuten-TTL zwischen den Turns abläuft, dreht sich die Rechnung: Dann fallen bei jedem Request erneut 1,25x fürs Schreiben an – über sechs Turns 7,5x und damit mehr als ohne Caching. Ein Provider mit kostenlosem Schreiben und Input zum 1,0-Fachen landet dagegen lediglich bei den ungecachten 6,0x.
Erst messen, dann debuggen: Drei Werte beweisen den Cache-Treffer
Jede OpenRouter-Antwort enthält im Objekt usage die entscheidenden Werte: cached_tokens, cache_write_tokens und cache_discount. Die Feldbedeutungen dokumentiert OpenRouters Caching-Leitfaden. Wer diese drei Werte vor jeder Änderung prüft, trennt echte Cache-Misses von einer unerwarteten Preisrechnung. Ist cached_tokens größer als null, traf der Request auf einen warmen Cache. Bei null gab es keinen Treffer – unabhängig davon, was das Activity-Dashboard vermuten lässt.
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
Diese Antwort entspricht einem Treffer von 99,8 %: 10.318 von 10.339 Prompt-Tokens stammen aus dem Cache. cache_write_tokens erscheint beim ersten Request, der einen Cache erzeugt. cache_discount zeigt die Ersparnis und kann bei Anthropic-Schreibvorgängen sogar negativ sein, weil der Aufschlag von 1,25x real anfällt und erst durch spätere Lesezugriffe ausgeglichen wird. Dieselben Werte stehen in der Detailansicht einer Generation unter Activity – unser Leitfaden zum Activity-Dashboard zeigt, wo – oder unter /api/v1/generation.
Maßgeblich sind die Rohmetadaten, nicht die Oberfläche. Ein SillyTavern-Nutzer suchte lange nach einem vermeintlichen Cache-Problem, bis er direkt in die Logs schaute:
"Die rohen OpenRouter-Metadaten sagen ganz klar
native_tokens_cached: 0[und]usage_cache: null." — u/HauntingWeakness
Wenn diese drei Werte über Tage hinweg null bleiben, frisst eine der folgenden vier Fehlerquellen den Cache auf.
Vier Gründe, warum ein warmer Cache wieder kalt wird
OpenRouters Dokumentation und die Erfahrungen der Community laufen auf vier häufige Ursachen für einbrechende Hit-Raten hinaus: Prompts unter dem Minimum, abgelaufene TTL zwischen Turns, ein veränderter Präfix und Provider-Drift. In den Logs hinterlässt jede Ursache ein eigenes Muster – und jede verlangt nach einer anderen Lösung.
1. Der Prompt unterschreitet das Provider-Minimum
Provider mit Prompt Caching setzen je Modell eine Mindestzahl an Tokens voraus. Ein System-Prompt mit 900 Tokens wird bei keinem Claude-Modell gecacht. Ihn mit Fülltext künstlich aufzublasen, wird ausdrücklich nicht empfohlen: „Don't pad the request with filler text just to force it“, heißt es im OpenRouter-Tutorial. Die Mindestwerte unterscheiden sich im Katalog um den Faktor vier:
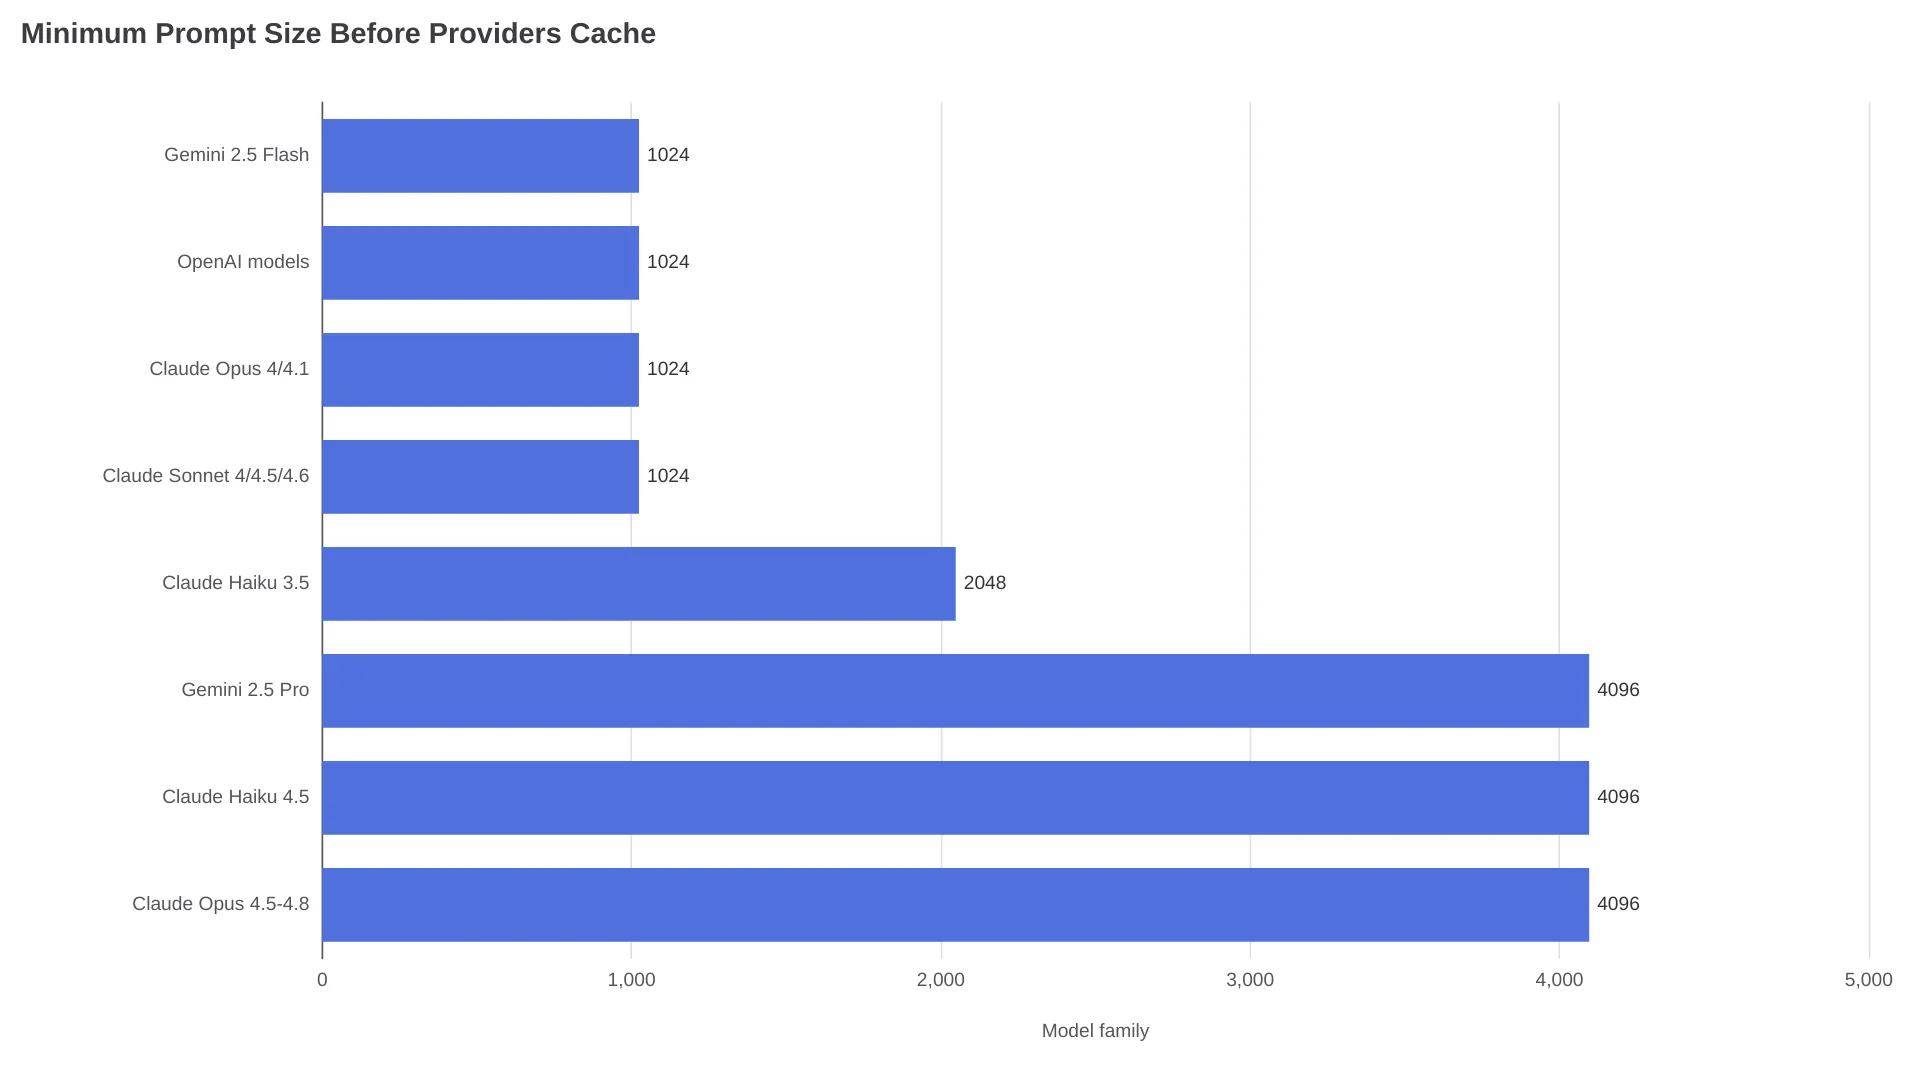
Laut OpenRouters Provider-Hinweisen benötigen Claude Opus 4.5–4.8 und Haiku 4.5 mindestens 4.096 Tokens, bevor überhaupt etwas gecacht wird. Für Sonnet 4/4.5/4.6 sowie Opus 4/4.1 reichen 1.024 Tokens. Gemini 2.5 Pro liegt bei 4.096, Gemini 2.5 Flash bei 1.024; OpenAI-Modelle cachen ab 1.024 Tokens. Ein Short-Prompt-Workflow auf Opus 4.8 ist damit strukturell nicht cachebar. Die Lösung lautet, statisches Material wie Tool-Schemas, Referenzdokumente und Few-Shot-Beispiele in einem Präfix zu bündeln – oder ein Modell mit niedrigerem Mindestwert zu wählen.
2. Der Cache läuft zwischen zwei Turns ab
Der Anthropic-Cache lebt standardmäßig 5 Minuten; die TTL von 1 Stunde kostet beim Schreiben 2x. Geminis impliziter Cache hält ungefähr 3–5 Minuten. Entscheidend dabei: Lesezugriffe setzen den Timer nicht zurück, wie OpenRouters Tutorial erklärt. Die Sticky Session, die Requests beim selben Provider hält, endet nach 10 Minuten ohne Aktivität. Agent-Loops, die zwischen Aufrufen 5–6 Minuten nachdenken, reißen damit sämtliche dieser Zeitfenster:
"OpenRouter [ist] großartig zum Testen von Modellen. Für produktive Agents sind sie stillschweigend ziemlich schlecht. Das schmutzige Geheimnis? Caching liegt in echten Workloads praktisch bei null." — @ran_cohenn, über Agent-Intervalle von 5–6 Minuten, die Sticky Affinity auslaufen lassen und zu vollständigen Cache-Misses plus teuren Cache-Schreibvorgängen führen
Die 1-Stunden-TTL von Anthropic bei 2x Schreibkosten ist besser, als alle fünf Minuten erneut 1,25x zu zahlen – sofern die Session innerhalb der Stunde weiterläuft. Bei zwanzig Minuten Pause zwischen Nutzerinteraktionen überlebt keine verfügbare TTL; Caching hilft dann nur innerhalb kurzer Turn-Serien.
3. Der Prompt-Präfix verändert sich
OpenRouter bildet seinen Standard-Konversationsschlüssel aus einem Hash der ersten Systemnachricht und der ersten Nicht-Systemnachricht. Alles, was den Prompt-Anfang verändert, invalidiert den Cache ab dieser Stelle. Typische Kandidaten sind RAG-Kontext oberhalb des System-Prompts, Zeitstempel oder Request-IDs in der ersten Nachricht, bei jedem Aufruf neu erzeugte Tool-Definitionen und Chat-Frontends, die Nachrichten mitten in den Verlauf einfügen.
"Die Cache-Miss-Rate steigt, wenn sich am Anfang des Prompts ständig etwas ändert." — u/Exact_Law_6489
Mitunter stammt die Änderung aus einem Tool, das man selbst gar nicht geschrieben hat. „I found Claude Code was causing cache hit problems for me, I think it's from how they inject tools“, berichtet u/askchris. Gemini bringt zwei zusätzliche Fallen mit: OpenRouter berücksichtigt nur den letzten gesendeten cache_control-Breakpoint, und die System Instruction gilt als unveränderlicher gecachter Inhalt. Dynamisches Material muss daher in eine spätere User-Nachricht, nicht hinter den System-Prompt. Die Lösung folgt stets derselben Disziplin: Erst statischer System-Prompt, Tool-Schemas und Referenzdokumente; variable Inhalte pro Request zuletzt.
4. Der Request landet bei einem kalten Provider
OpenRouter routet über mehr als 70 Provider (laut eigenem Tutorial). Ein Prompt-Cache ist jedoch lokal an den Endpunkt gebunden, der ihn geschrieben hat. Sticky Routing schickt Folge-Requests zurück an den warmen Provider – allerdings nur, wenn dessen Cache-Lesezugriffe günstiger sind als regulärer Input. Eine manuelle provider.order überschreibt diese Bindung vollständig. Auch ein Provider-Fehler löst die Zuordnung.
Die Community-Daten zu diesem Problem sind deutlich:
- @bruceforai verglich denselben Modellnamen bei verschiedenen Providern und fand Cache-Hit-Raten von 95,3 % bis 0 %; bei einigen Drittanbietern lagen die Cache-Preise beim Zehnfachen des offiziellen Tarifs.
- @Bryan_1269 erhielt für GLM 5.2 über OpenRouter eine sehr niedrige Hit-Rate, beim identischen Prompt direkt über Fireworks dagegen mehr als 85 %.
- @miolini schrieb über Routing via OpenRouter: "Die Cache-Hit-Rate ist wirklich schlecht, unter 1 %."
OpenRouters offizielle Position: Das Pinning funktioniert – „when you get cached by a model or provider, you get pinned to it until the cache expires“ (@OpenRouter). Das deckt sich mit der Dokumentation. Entscheidend zu managen ist daher die Provider-Varianz, nicht das Pinning selbst.
cache_control richtig platzieren – und was es unterwegs entfernt
Anthropic-Modelle auf OpenRouter cachen auf zwei Arten: über ein einziges Top-Level-Objekt cache_control, das mit wachsender Konversation automatisch weiterwandert – OpenRouters Empfehlung für Multi-Turn-Chats – oder über explizite Breakpoints an einzelnen Content-Blöcken. Davon sind bis zu vier möglich und sie eignen sich für große feste Inhalte wie Tool-Schemas, RAG-Dokumente, CSV-Dumps oder Character Cards. Die Top-Level-Variante funktioniert mit Anthropic Native, Vertex, Azure und Bedrock. Da Bedrocks API das Top-Level-Feld nicht akzeptiert, übersetzt OpenRouter es dort in einen abschließenden Breakpoint. Eine explizite TTL lässt sich mit Chat Completions oder der Anthropic Messages API setzen, nicht mit Responses.
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k Tokens mit Tool-Schemas und Referenzdokumenten>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
OpenAI funktioniert anders: Caching startet automatisch ab 1.024 Tokens. Explizite Marker namens prompt_cache_breakpoint gibt es nur bei GPT-5.6 und neuer. Sie werden auf einem input_text- oder text-Block gesetzt; bei angeforderter TTL gilt ein Minimum von 30 Minuten.
OpenRouter übersetzt laut seinen Provider-Hinweisen zwischen den Dialekten: Ein Anthropic-Marker cache_control wird zu einem OpenAI-Breakpoint, ein OpenAI-Breakpoint zu einem standardmäßigen Anthropic-Marker für 5 Minuten. TTL-Werte werden dabei nie übertragen. Qwen benötigt explizite cache_control-Marker, cached 5 Minuten und unterstützt sie nur bei bestimmten Modellen wie qwen3-max, qwen-plus, qwen3-coder-plus und weiteren; Snapshots wie qwen3.5-plus-02-15 sind ausgenommen.
Eine unauffälligere Fehlerquelle: Manche Clients und Gateways zwischen der eigenen App und OpenRouter entfernen nicht standardisierte Felder, bevor sie den Request weiterleiten:
"Dass Anthropic Prompt Caching hinter Gateways auf null fällt, ist meist ein Marshalling-Bug. ... cache_control-Marker werden stillschweigend entfernt, bevor sie an OpenRouter weitergeleitet werden. Provider lassen sich nicht abstrahieren, indem man ihre Schema-Erweiterungen verwirft." — @SiddharthInk_
Prüfe, ob der Marker ankommt: Kontrolliere die Rohmetadaten des Requests in der Activity-Detailansicht einer Generation oder sende einen Test-Request direkt mit curl, ohne störende Zwischenstation. Ein Tool, das Nachrichten zu einem einzigen Block zusammenzieht, zerstört Breakpoints unabhängig davon, wie korrekt sie platziert waren. OpenRouters Examples-Repository enthält ausführbare Beispiele für TypeScript, Vercel AI SDK und Effect, die die Marker erhalten.
Provider festhalten: session_id und Provider-Reihenfolge
Die stärkste Stellschraube fürs Routing ist eine stabile Session-Identität: session_id bindet Folge-Requests an den Provider, der den ersten erfolgreichen Request bedient hat – noch bevor ein Cache-Treffer beobachtet wurde. Ohne sie beginnt die Bindung erst nach dem ersten erkannten Cache-Hit. Die Standardidentität, ein Hash aus erster Systemnachricht und erster Nicht-Systemnachricht, ändert sich zudem unbemerkt bei jeder Präfix-Mutation aus Fehlerquelle 3. Das geht aus OpenRouters Routing-Dokumentation hervor.
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}
Wichtige Details: session_id gehört in den Request-Body oder in den Header x-session-id. Sind beide gesetzt, gewinnt der Body. Das Limit liegt bei 256 Zeichen. Falls keines von beiden vorhanden ist, verwendet OpenRouter den OpenAI-kompatiblen Wert prompt_cache_key als Fallback.
Zwei Einschränkungen aus der Dokumentation: Provider-Fehler lösen das Pinning, und Zeilen der Batch API laufen parallel sowie außer Reihenfolge. Ein Cache-Schreibvorgang einer Zeile ist für die nächste daher nicht sichtbar. Teile einen Präfix mit "ttl": "1h" zwischen Batches oder wärme ihn zuvor mit einem synchronen Request auf. (Der Leitfaden zum Auto Router behandelt die Best-Effort-Wiederverwendung des aufgelösten Modells durch Auto Router.)
Reicht Pinning allein nicht aus, lässt sich die Provider-Auswahl direkt beschränken:
"Die Lösung, die ich gefunden habe, ist eine bevorzugte Provider-Liste in Reihenfolge ihrer Priorität festzulegen." — u/nabil9506
Eine provider.order-Liste mit zwei oder drei Providern mit günstigen Cache-Lesezugriffen tauscht breite Failover-Optionen gegen bessere Cache-Lokalität. Für Agent-Workloads ist das ein sinnvoller Tausch. u/welcome_to_milliways nennt den Aufwand für das manuelle Setup „einen ziemlich grundlegenden Fehler bei OR“. Ob man das so sieht oder nicht: Das ist derzeit der Vertrag.
Wann Caching über einen Router nicht lohnt
Prompt Caching über OpenRouter rechnet sich in drei klar erkennbaren Fällen nicht mehr: wenn Prompts nie das Token-Minimum des Modells erreichen, wenn Session-Pausen länger sind als jede verfügbare TTL und wenn bei einmaligen Requests der Schreibaufschlag nie durch einen rabattierten Lesezugriff amortisiert wird. Hinzu kommt ein vierter Fall: Tooling, das sich nicht ändern lässt und cache_control entfernt, bevor es den Router erreicht. @grapeot ordnet die Größenordnung ein: Scheitert Caching auf Gateway-Ebene, beträgt der Kostenunterschied eine Größenordnung und übersteigt damit die Routing-Gebühr selbst deutlich.
Für cachekritische Workloads, bei denen keine der Maßnahmen greift, ist ein einzelner fester Upstream einem Router überlegen: Das Cache-Verhalten ist deterministisch, Pinning entfällt. Ein direkter Claude API endpoint mit Anthropics eigenem Caching ist der naheliegende Ausweg, wenn sich Provider-Drift nicht beheben lässt.
Zero Data Retention auf Kontoebene deaktiviert Response Caching vollständig. Für Prompt Caching unter ZDR ist OpenRouters Analyse dazu, ob implizites Caching als Datenaufbewahrung gilt, die maßgebliche Referenz.
Die richtige Reihenfolge für die Fehlerbehebung
Wer in Messreihenfolge debuggt, holt die meisten Einsparungen mit möglichst wenig Umbau zurück: erst verifizieren, dann vom Prompt über Routing bis zur TTL arbeiten.
| # | Maßnahme | Was damit geklärt wird |
|---|---|---|
| 1 | cached_tokens und cache_discount bei einigen echten Requests prüfen | Hit-Rate-Problem oder falsche Preisannahme |
| 2 | Prompt-Größe mit dem Token-Minimum des Modells vergleichen | Schließt „grundsätzlich nicht cachebar“ frühzeitig aus |
| 3 | Präfix einfrieren: statischer System-Prompt, Schemas und Dokumente zuerst; Zeitstempel und RAG zuletzt | Eliminiert die Klasse stiller Invalidierungen |
| 4 | session_id bei jedem Request einer Konversation mitsenden | Provider-Pinning ab Turn eins statt erst nach dem ersten Treffer |
| 5 | provider.order auf zwei oder drei Provider mit günstigen Cache-Lesezugriffen setzen | Reduziert Drift zwischen Providern |
| 6 | "ttl": "1h" hinzufügen (Anthropic) oder für lange Sessions zu einem Provider mit kostenlosem Schreiben wechseln | Fängt Abläufe zwischen Turns ab |
Die Schritte 1–3 räumen Fehlerklassen aus, die sich im eigenen Code kontrollieren lassen. Die Schritte 4–6 bringen die Berichte über unter 1 % mit der Schlagzeile von 82,8 % zusammen. Weiterführend: der OpenRouter Pricing Guide dazu, wie gecachte Tokens auf der Rechnung erscheinen, der Auto Router Guide zum Modell-Pinning und der Activity Dashboard Guide zum langfristigen Monitoring von Hit-Raten.