 AIREITER
Am 17. August 2026 räumte OpenRouter ein, dass eines der eigenen Preview-Modelle unbemerkt rund 6,2 K$ pro Monat verursachte – etwa das 25-Fache des gemischten Organisationstarifs. 98 % davon entfielen auf einen einzigen API-Key für eine Batch-Pipeline. Das am selben Tag gestartete Activity Dashboard soll genau solche Fehler innerhalb weniger Minuten sichtbar machen, statt erst nach Monaten. Die Oberfläche erfüllt diesen Zweck ziemlich gut: Ausgaben, Tokens, Cache-Trefferquote und Details bis auf Anfrageebene sind zentral gebündelt. Die darunterliegende Analytics API im Beta-Stadium ist deutlich kantiger. Ihre wichtigsten Eigenheiten haben wir hier zusammengetragen.
Die 6,2-K$-Lektion: Diese Fehler findet das OpenRouter Activity Dashboard
Die interne Fallstudie aus dem Ankündigungsbeitrag zeigt den Fehler, für den das neue Werkzeug gedacht ist. Ein Preview-Modell verbrauchte in einem Monat 6.185 $ bei 250 Mio. Tokens – rund 24,7 $ pro Million Tokens und einer Cache-Trefferquote von 7,6 %. Die Aufschlüsselung nach API-Key brachte einen einzelnen Verantwortlichen ans Licht: batch-pipeline stand für 6.067 $ bei 127 Mio. Tokens und 37.000 Anfragen. Das entspricht ungefähr 48 $ pro Million Tokens für umfangreiche, aber wenig komplexe Batch-Aufgaben. Die Lösung bestand in einem einzeiligen Modellwechsel – die vollständige Aufschlüsselung findet sich im Cookbook zur Kostenkontrolle.
Gemeinsam mit dem Dashboard gingen außerdem eine Explore-Ansicht für eigene Abfragen, eine Trends-Ansicht zur Erkennung von Veränderungen, Guardrails für Prompt-Injection- und Ereignisse mit sensiblen Daten, Logs auf Anfrageebene, die Analytics API im Beta-Stadium sowie ein installierbares openrouter-analytics-Skill auf GitHub für Coding-Agenten an den Start.
Welche Frage jeder Activity-Tab beantwortet
Das OpenRouter Activity Dashboard ist weniger nach Menüs als nach typischen Analysefragen aufgebaut. Drei Tabs decken den Großteil der Kostenkontrolle ab – jeweils mit einem eigenen Schwerpunkt.
Overview: Wie viel haben wir ausgegeben?
Die Overview-Ansicht beginnt mit fünf Kennzahlen: Gesamtausgaben, Anzahl der Anfragen, Token-Volumen, Cache-Trefferquote und gemischte Kosten pro Million Tokens. Zu jeder Zahl gibt es eine Sparkline und den Vergleich mit dem vorherigen Zeitraum. Darunter folgen die aktivsten Nutzer und Apps, die Ausgaben nach Modell, die Aufteilung zwischen OpenRouter-Guthaben und geschätzten BYOK-Ausgaben sowie die Token-Zahlen für Prompts und Antworten. Diese Ansicht ist die richtige Anlaufstelle, wenn zunächst nur die Höhe der Rechnung zählt.
Trends: Was hat sich seit dem letzten Zeitraum verändert?
Trends sortiert Veränderungen statt absolute Werte – über Modelle, Nutzer, API-Keys und Apps hinweg. Die Ansicht hilft dabei, einen außer Kontrolle geratenen Agenten, ein plötzlich beliebtes Modell oder ein internes Tool zu finden, das vom Experiment zum Standard geworden ist. Overview zeigt, dass etwas teuer ist. Trends zeigt, dass es gerade teuer geworden ist.
Explore: Wie kann ich die Daten selbst aufschlüsseln?
Explore ist der Abfrage-Builder. Zur Auswahl stehen Ausgaben, Anfragen, mehrere Token-Kategorien, Cache-Trefferquote, gemischte Kosten pro Million Tokens, BYOK- und Guthabenausgaben sowie P50-, P90- und P99-Latenz und Durchsatz.
Gruppieren lässt sich nach höchstens zwei Dimensionen gleichzeitig. Mögliche Dimensionen sind Modell, Provider, API-Key, App, Nutzer, Workspace, Land, Region, Kontextlänge, Session, Generation, eigene IDs und Klassifizierer. Zeitliche Zusammenfassungen reichen von Minute bis Monat, Diagramme können als Balken-, Linien- oder Punktdiagramme dargestellt werden. Jedes Diagramm lässt sich privat oder für die gesamte Organisation speichern. Zwei Einschränkungen solltest du kennen: Eine dritte Gruppierungsdimension wird direkt abgelehnt, und Prompt- beziehungsweise Antwortinhalte in den Logs sind nur sichtbar, wenn das private Ein- und Ausgabe-Logging vor der jeweiligen Anfrage aktiviert wurde.
CSV- oder PDF-Export ohne API-Aufwand
Buchhaltung und Tabellenkalkulation kommen ohne API aus. Die Activity-Seite exportiert dieselben aggregierten Werte als zusammengefassten oder detaillierten Bericht in zwei Formaten – ganz ohne Code. Der offizielle Exportablauf umfasst fünf Schritte:
- Activity-Seite öffnen.
- Zeitraum und Gruppierung auswählen (Modell, API-Key oder Ersteller).
- Das Optionsmenü oben rechts öffnen.
- Export to… auswählen.
- CSV oder PDF wählen.
Standardmäßig wird ein zusammengefasster Bericht mit Ausgaben, Tokens und Anfragen erzeugt. Für einen detaillierten Bericht öffnest du zuerst eine bestimmte Kennzahlenkarte und startest anschließend den Export. Die Detailansicht schlüsselt diese Kennzahl nach der gewählten Gruppierung auf. Der gewählte Zeitraum legt das Unterintervall automatisch fest:
| Zeitraumfilter | Unterintervall |
|---|---|
| 1 Stunde | pro Minute |
| 1 Tag | pro Stunde |
| 1 Monat | pro Tag |
| 1 Jahr | pro Monat |
Zwei Hinweise aus der Dokumentation gehören ins Kleingedruckte: BYOK-Ausgaben in diesen Berichten sind eine Schätzung auf Basis der Marktpreise der Provider. Sie können deshalb von der tatsächlichen externen Rechnung abweichen, weil providerabhängige Rabatte nicht berücksichtigt werden. Reasoning-Tokens werden innerhalb der Completion-Tokens abgerechnet, aber separat ausgewiesen. So bleibt der Anteil fürs „Denken“ sichtbar, ohne doppelt gezählt zu werden.
Die erste Analytics-API-Abfrage in fünf Minuten
Die Analytics API stellt dieselben Daten bereit, die Explore berechnet – über zwei Endpunkte. Da sie ausdrücklich als Beta gekennzeichnet ist, beginnt der sinnvolle Workflow mit der Schema-Ermittlung und nicht mit der ersten Abfrage.
Ohne Management-Key geht nichts
Für die Analytics-Endpunkte ist ein Management-Key erforderlich; ein normaler Inference-Key führt zu HTTP 403. Umgekehrt gilt laut dem Cookbook zur Kostenkontrolle: Management-Keys können keine Modellanfragen ausführen. Das begrenzt den Schaden, falls ein Key nach außen gelangt – trotzdem gewährt er Einblick in die vollständige Kostenaufschlüsselung der Organisation. Die Empfehlung im Cookbook ist eindeutig: Behandle ihn wie jedes andere Zugangstoken.
Erst Meta, dann Query
GET /api/v1/analytics/meta liefert die aktuell unterstützten Metriken, Dimensionen, Filteroperatoren und Granularitäten. Rufe den Endpunkt vor jedem Automatisierungslauf ab, denn die Unterstützung kann sich im Beta-Stadium ändern. Die eigentliche Abfrage läuft über POST /api/v1/analytics/query. Das dokumentierte cURL-Beispiel:
curl -X POST https://openrouter.ai/api/v1/analytics/query \
  -H "Authorization: Bearer <management-key>" \
  -H "Content-Type: application/json" \
  -d '{
    "metrics": ["request_count"],
    "dimensions": ["model"],
    "granularity": "day",
    "limit": 100,
    "time_range": {
      "start": "2026-08-01T00:00:00Z",
      "end": "2026-08-08T00:00:00Z"
    }
  }'
Die Antwort legt ihre Zeilen unter data.data ab und enthält außerdem einen metadata-Block mit query_time_ms, row_count und truncated. Im Cookbook dauern Beispielabfragen mit einer einzigen Zeile 17 ms. Die Abfragen sind also günstig; der beschriebene Workflow ist schreibgeschützt und verursacht über die bestehenden Nutzungskosten hinaus keine weiteren Gebühren. Dokumentierte Fehlerfälle sind 400 (fehlerhafte Abfrage), 401 (keine Authentifizierung), 403 (falscher Key-Typ), 408 und 500.
Vier Abfragen, die zu hohe Ausgaben aufspüren
Das offizielle Cookbook enthält fünf Rezepte. Als Ablauf neu geordnet, ergeben sie eine wiederholbare Suche nach Kostentreibern.
1. Welches Modell verbraucht am meisten? Die erste Abfrage des Cookbooks ruft total_usage, request_count, tokens_total und cache_hit_rate ab, gruppiert nach model und nach Ausgaben sortiert:
{
  "metrics": ["total_usage", "request_count", "tokens_total", "cache_hit_rate"],
  "dimensions": ["model"],
  "order_by": { "metric": "total_usage", "direction": "desc" },
  "limit": 10,
  "time_range": { "start": "2026-07-01T00:00:00Z", "end": "2026-08-01T00:00:00Z" }
}
Die entscheidende abgeleitete Kennzahl sind die effektiven Kosten pro Million Tokens: total_usage / tokens_total × 1e6. Vergleiche sie mit deinem gemischten Tarif – also derselben Formel ohne Dimensionen. Die Faustregel aus dem Cookbook: Ein Modell, dessen Preis ein Vielfaches des gemischten Tarifs beträgt, ist der stärkste Hinweis auf einen Ansatzpunkt. So wurde auch die 25-fache Abweichung des Preview-Modells entdeckt.
2. Welcher API-Key steckt dahinter? Ergänze einen Filter für den exakten Modell-Slug und gruppiere nach api_key_id. In den Ergebnissen werden die Namen in lesbare Bezeichnungen aufgelöst. Genau so tauchte batch-pipeline als Verursacher von 6.067 $ der insgesamt 6.185 $ auf. Gruppiere nach api_key_id, statt nach aufgelösten Key-Namen zu filtern, und nutze user_email aus der Antwort, um die Ausgaben mit internen Aufzeichnungen abzugleichen.
3. Wofür wurde das Geld tatsächlich ausgegeben? Teile die täglichen Kosten in ihre Bestandteile auf:
| Metrik | Bedeutung |
|---|---|
usage_upstream | tatsächliche Inferenzkosten |
usage_cache | Ersparnis durch Caching (oder Kosten fürs Schreiben in den Cache) |
usage_data | Rabatte, in der Regel negativ |
usage_web | Aufpreis für Websuche |
usage_file | Aufpreis für Dateiverarbeitung |
Ein Prompt-zu-Completion-Verhältnis von etwa 20:1 deutet auf übergroße Kontexte hin. Ein hoher Anteil an Reasoning-Tokens bedeutet, dass du möglicherweise für mehr Denkaufwand bezahlst als nötig. Der beste Ansatzpunkt fürs Caching ist promptlastiger Datenverkehr mit niedriger Cache-Trefferquote. Ist die Quote bereits hoch, solltest du stattdessen den Modellmix prüfen. Promptlastigkeit ist dabei eher die Regel als die Ausnahme: Eine Analyse der öffentlichen OpenRouter-Daten aus der Kategorie Programmierung kam auf 93,4 % Eingabe-Tokens.
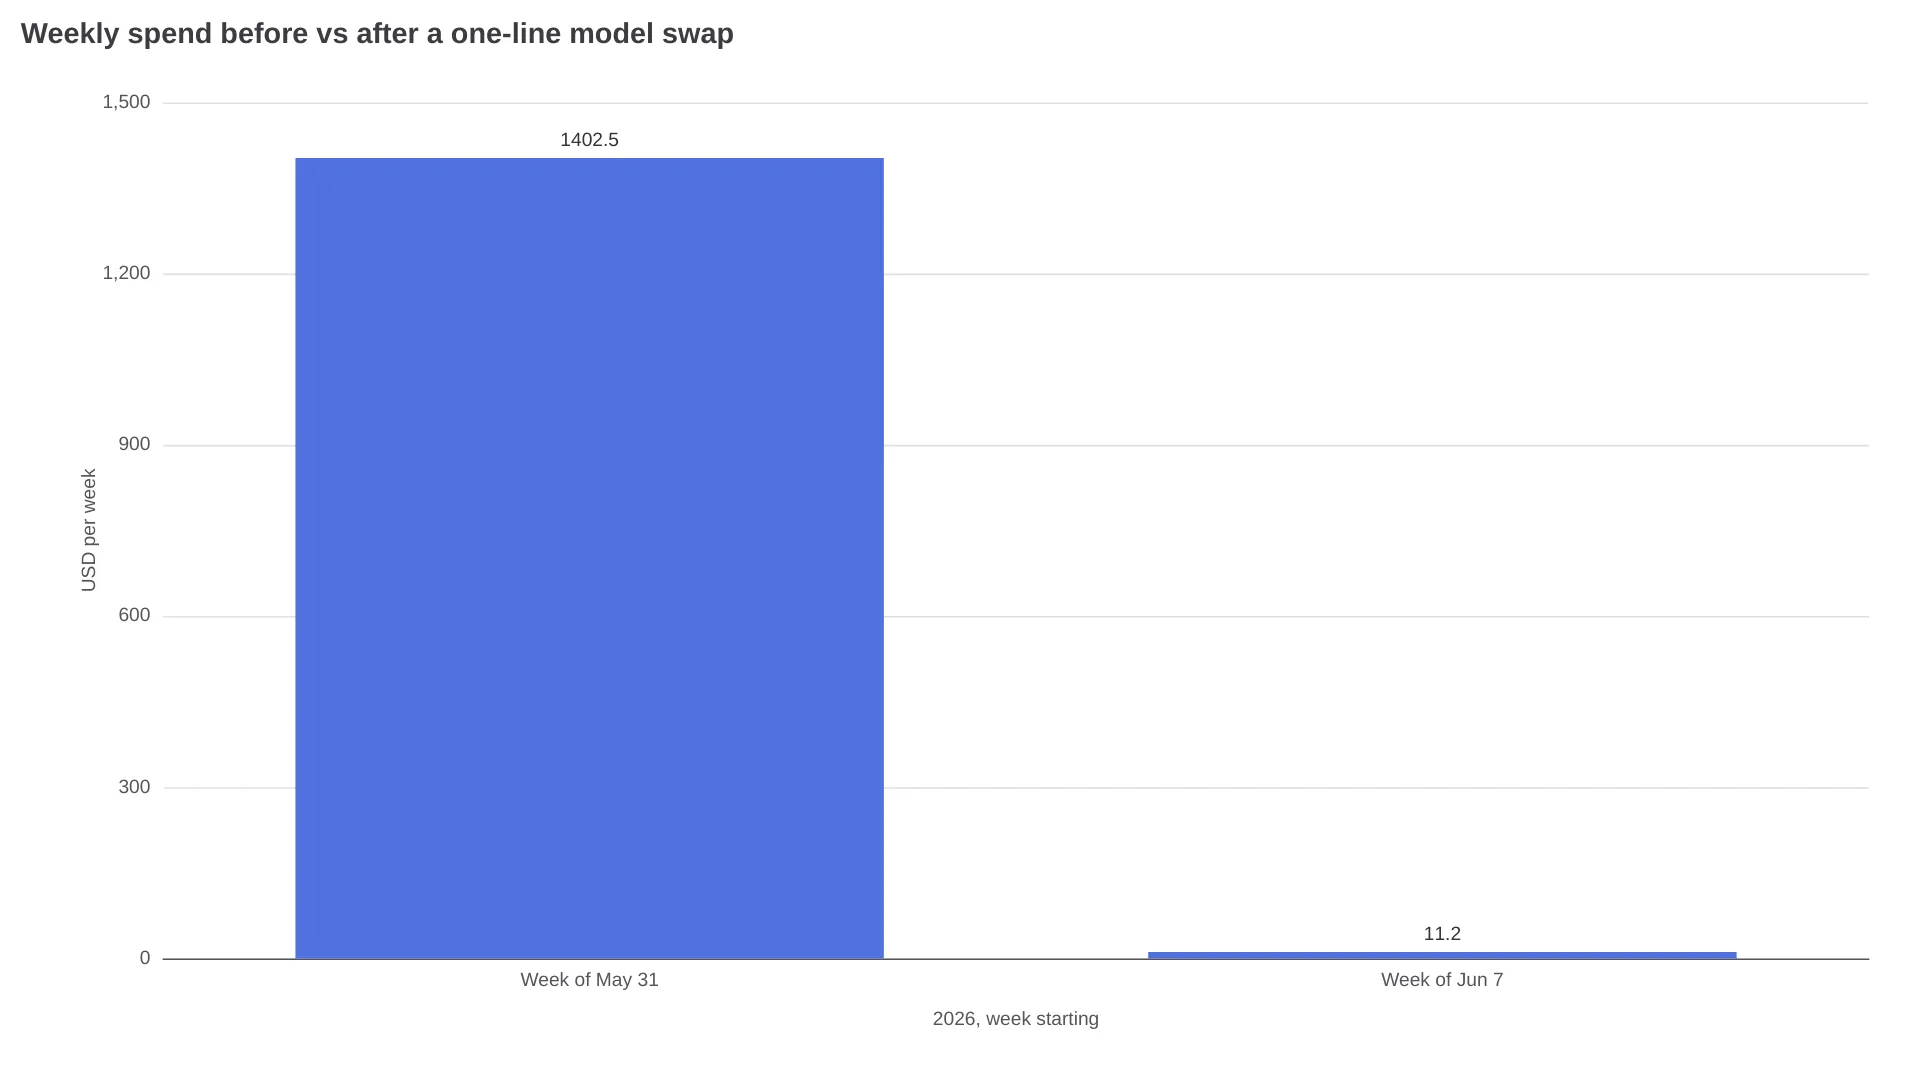
4. Hat die Änderung wirklich geholfen? Führe Abfrage 1 als wöchentliche Zeitreihe erneut aus und gruppiere nach api_key_id. Im offiziellen Beispiel sank der Schlüssel batch-pipeline von 1.402,50 $ in der Woche ab dem 31. Mai auf 11,20 $ in der Woche ab dem 7. Juni. Ein erfolgreicher Modellwechsel zeigt sich als abrupter Absturz, nicht als sanfter Rückgang.
Wenn nach Abfrage 1 der Wechsel zu einem günstigeren Modell ansteht, wird diese Entscheidung in OpenRouters eigener Routing-Schicht umgesetzt. Die Vor- und Nachteile von automatischem und fest vorgegebenem Routing erklären wir in unserem Leitfaden zum OpenRouter Auto Router.
Sechs Beta-Stolperfallen, die die Referenz nicht deutlich genug erklärt
Die API funktioniert wie dokumentiert, sobald die Abfrage stimmt. Die folgenden Fehlerquellen sind ebenfalls beschrieben – allerdings verstreut über Fußnoten im Cookbook.
- Drei Dimensionen führen zu 400. Das Limit liegt bei zwei. Für
model × key × daybrauchst du mehrere Abfragen oder eine andere Zeitgranularität. group_limitkann Zeitintervalle unbemerkt abschneiden. Lässt du das Feld weg, berechnet OpenRouter automatisch einen sicheren Wert. Ist es zu niedrig gesetzt, verschwinden Wochen aus Zeitreihen. Ohne Dimensionen wird es vollständig ignoriert.- Zählmetriken kommen manchmal als Strings zurück. In der Referenz sind Zahlen abgebildet, die API kann aber Strings liefern. Deine Verarbeitung sollte beides akzeptieren.
- Die Spaltennamen von Zeitreihen sind nicht eindeutig. Dasselbe Intervall kann je nach Abfrage als
date__dayodercreated_at__dayerscheinen. - Nicht verwendete Kostenbestandteile liefern
null, nicht null. In jedes Aggregationsskript gehört deshalb eine Nullprüfung. metadata.truncated: truebedeutet, dass deine Summen unvollständig sind. Erhöhelimit(Standardwert 1.000), oder verkleinere den Zeitraum und führe die Abfrage erneut aus.
Dashboard, API oder eigene Pipeline?
Für Fragen auf Kontoebene reichen die nativen Werkzeuge aus. Eine eigene Lösung lohnt sich erst, wenn du darüber hinausgehen musst:
| Du brauchst … | Verwende |
|---|---|
| Ausgaben, Tokens und Cache-Quote auf einen Blick | Activity Overview |
| Was sich verändert und wo es Ausschläge gibt | Trends |
| Einmalige Aufschlüsselungen und Freigaben | Explore + CSV/PDF-Export |
| Geplante Berichte, Warnungen und interne Dashboards | Analytics API |
| Aggregation über mehrere Provider, Budgets pro Nutzer und eigene Anomalieerkennung | Eine eigene Pipeline auf Basis von Nutzungslogs und Webhooks |
Der Weg zur eigenen Lösung ist gut dokumentiert. Ein r/FinOps-Nutzer schrieb:
„Ich habe meinen eigenen KI-Kostentracker in Obsidian gebaut, weil der Preis eines Modells über Nacht von Centbeträgen auf 3 € gestiegen ist.“
In diesem Thread und in der r/openrouter-Diskussion „Long context pricing should be more transparent“ steckt dieselbe Ursache: Eigene Schätzungen entfernen sich von den abgerechneten Beträgen, weil Routing, Caching, Reasoning-Tokens und die Preise für lange Kontexte eine Rolle spielen. Die im Activity Dashboard erfasste Nutzung ist die maßgebliche Zahl. Wer eine eigene Pipeline betreibt, sollte sie daran abgleichen – nicht an einer selbst gepflegten Preistabelle.
Ein unkomplizierter Tipp zur Zuordnung stammt von einem Builder mit sechs Monaten Plattform-Erfahrung: Kennzeichne Anfragen mit X-Title-Headern, damit jede App und jedes Experiment unter einem eigenen Namen in Activity auftaucht. Wenn sich deine Ausgaben ohnehin auf mehrere Provider verteilen und nicht nur über einen Router laufen, nimmt dir ein Setup mit einheitlicher API (AIReiter ist eine Option) die Aggregation ab, bevor sie überhaupt zum Problem wird.
FAQ
Benötige ich für das Activity Dashboard einen Management-Key?
Nein. Das Dashboard läuft als reine Benutzeroberfläche unter deinem normalen Konto-Login. Einen Management-Key brauchst du nur für die Analytics-API-Endpunkte (/api/v1/analytics/meta und /api/v1/analytics/query).
Kann ich die OpenRouter Analytics API kostenlos aufrufen?
Das Cookbook beschreibt den Analytics-Workflow als schreibgeschützt und kostenlos: Du fragst deine eigenen Nutzungsdaten ab und zahlst nicht pro API-Aufruf. Die Inferenz, die in diesen Datensätzen erfasst ist, wird natürlich weiterhin berechnet.
Wie weit reichen die OpenRouter-Aktivitätsdaten zurück?
Der ältere /api/v1/activity-Endpunkt deckt die vorherigen 30 vollständig abgeschlossenen UTC-Tage ab. Die Dokumentation der neuen Analytics API nennt kein Aufbewahrungslimit – ihre Beispielabfragen reichen über einen Monat. Behandle längere Zeiträume daher als ungeprüft und exportiere CSV-Dateien für alles, was du dauerhaft aufbewahren musst.
Warum sehe ich keine Prompts und Antworten in meinen Activity-Logs?
Details zu Prompts und Completions werden nur für Anfragen gespeichert, bei denen das private Ein- und Ausgabe-Logging zum Zeitpunkt der Anfrage aktiviert war. Die Ankündigung stellt ausdrücklich klar, dass historische Prompt-Inhalte ohne diese Einstellung nicht verfügbar sind. Nutzungswerte werden aufgezeichnet, Inhalte sind optional.
Dieser Beta-Faktor gehört in die Kalkulation
Alles hier Beschriebene lässt sich heute umsetzen, und allein Abfrage 1 rechtfertigt die fünf Minuten Einrichtung. Das offene Risiko heißt Drift: Die Analytics API ist ausdrücklich eine Beta, ihre unterstützten Metriken und Dimensionen können sich ändern. OpenRouter weist selbst darauf hin, vor dem Vertrauen in ein Schema erneut /meta abzurufen. Sichere deine Cronjobs deshalb mit einer Meta-Prüfung ab, statt Feldnamen fest einzubauen. Dann bleibt die Transparenz des Dashboards erhalten, auch wenn die API noch nicht ausgewachsen ist.
Weiterlesen: Leitfaden zum OpenRouter Auto Router · Die besten kostenlosen OpenRouter-Modelle fürs Programmieren · OpenRouter-Preisleitfaden