 AIREITER
MuseTalk läuft sogar auf einer Laptop-GPU mit 4 GB VRAM: Im offiziellen README braucht eine RTX 3050 Ti Laptop im FP16-Modus für einen acht Sekunden langen Clip ungefähr fünf Minuten. Genau hier liegt die entscheidende Frage bei MuseTalk Lipsync: Nicht ob das Modell läuft, sondern ob es schnell genug läuft. Dieser Unterschied zieht sich durch Auflösung, Einrichtung und die folgende Kostenrechnung.
Was MuseTalk im Video verändert – und was nicht
MuseTalk rendert Mund und unteren Gesichtsbereich eines vorhandenen Videos neu, damit die Lippen zu einer Audiospur passen. Kopfhaltung, Augenbewegungen, Gesichtsausdruck, Hintergrund und Kamerabewegung werden nicht neu erzeugt, sondern aus dem Ausgangsmaterial übernommen. Das Modell ist also kein Generator für sprechende Köpfe, sondern ein lokaler Eingriff in bestehendes Videomaterial. Ein klar sichtbares Gesicht im Ausgangsvideo ist Voraussetzung.
Die Geschwindigkeit verdankt MuseTalk seiner Architektur. Das von Tencent Musics Lyra Lab veröffentlichte Repository kodiert das maskierte Gesicht mit dem eingefrorenen sd-vae-ft-mse-VAE, extrahiert Audio-Merkmale mit einem eingefrorenen Whisper-tiny-Modell und führt beides per Cross-Attention in einem aus Stable Diffusion v1.4 übernommenen UNet zusammen. Statt einer iterativen Denoising-Schleife nutzt MuseTalk ein einstufiges Inpainting im latenten Raum. Damit kommen die Autoren auf eine angegebene Leistung von 30 fps oder mehr auf einer NVIDIA Tesla V100.
Was die 256x256-Gesichtsregion für 1080p-Videos bedeutet
Die Angabe 256x256 beschreibt die Größe der bearbeiteten Gesichtsregion, nicht die Ausgabeauflösung. Ein 1080p-Clip bleibt also 1080p und behält seine ursprüngliche Bildrate; lediglich ein 256x256 großer Bereich wird neu berechnet und über den Mundbereich zurück in das Video geblendet. Je kleiner das Gesicht im Bild ist, desto besser fällt diese Begrenzung aus. In einer engen Nahaufnahme wird die weichere Region dagegen schnell sichtbar, weil das übrige Gesicht scharf bleibt.
Es gibt zwei Gegenmaßnahmen, beide mit Nachteilen. Wenn du --use_float16 weglässt, steigt die Qualität, dafür werden mehr VRAM und längere Laufzeiten fällig. Eine anschließende Bearbeitung mit GFPGAN oder CodeFormer Face Restoration kann den Mundbereich nachschärfen, kostet aber einen zusätzlichen Verarbeitungsschritt und verändert das Erscheinungsbild der Person leicht.
Qualität in Zahlen: Wo MuseTalk punktet und Wav2Lip noch vorne liegt
Der wichtigste Vorteil von MuseTalk liegt laut den veröffentlichten Daten bei der Bildqualität, nicht bei der reinen Synchronisationsgenauigkeit. Auf dem HDTF-Datensatz kommt der technische Bericht zu MuseTalk auf einen FID-Wert von 6.43. DI-Net erreicht 7.27, VideoRetalking 10.93 und Wav2Lip 11.21.
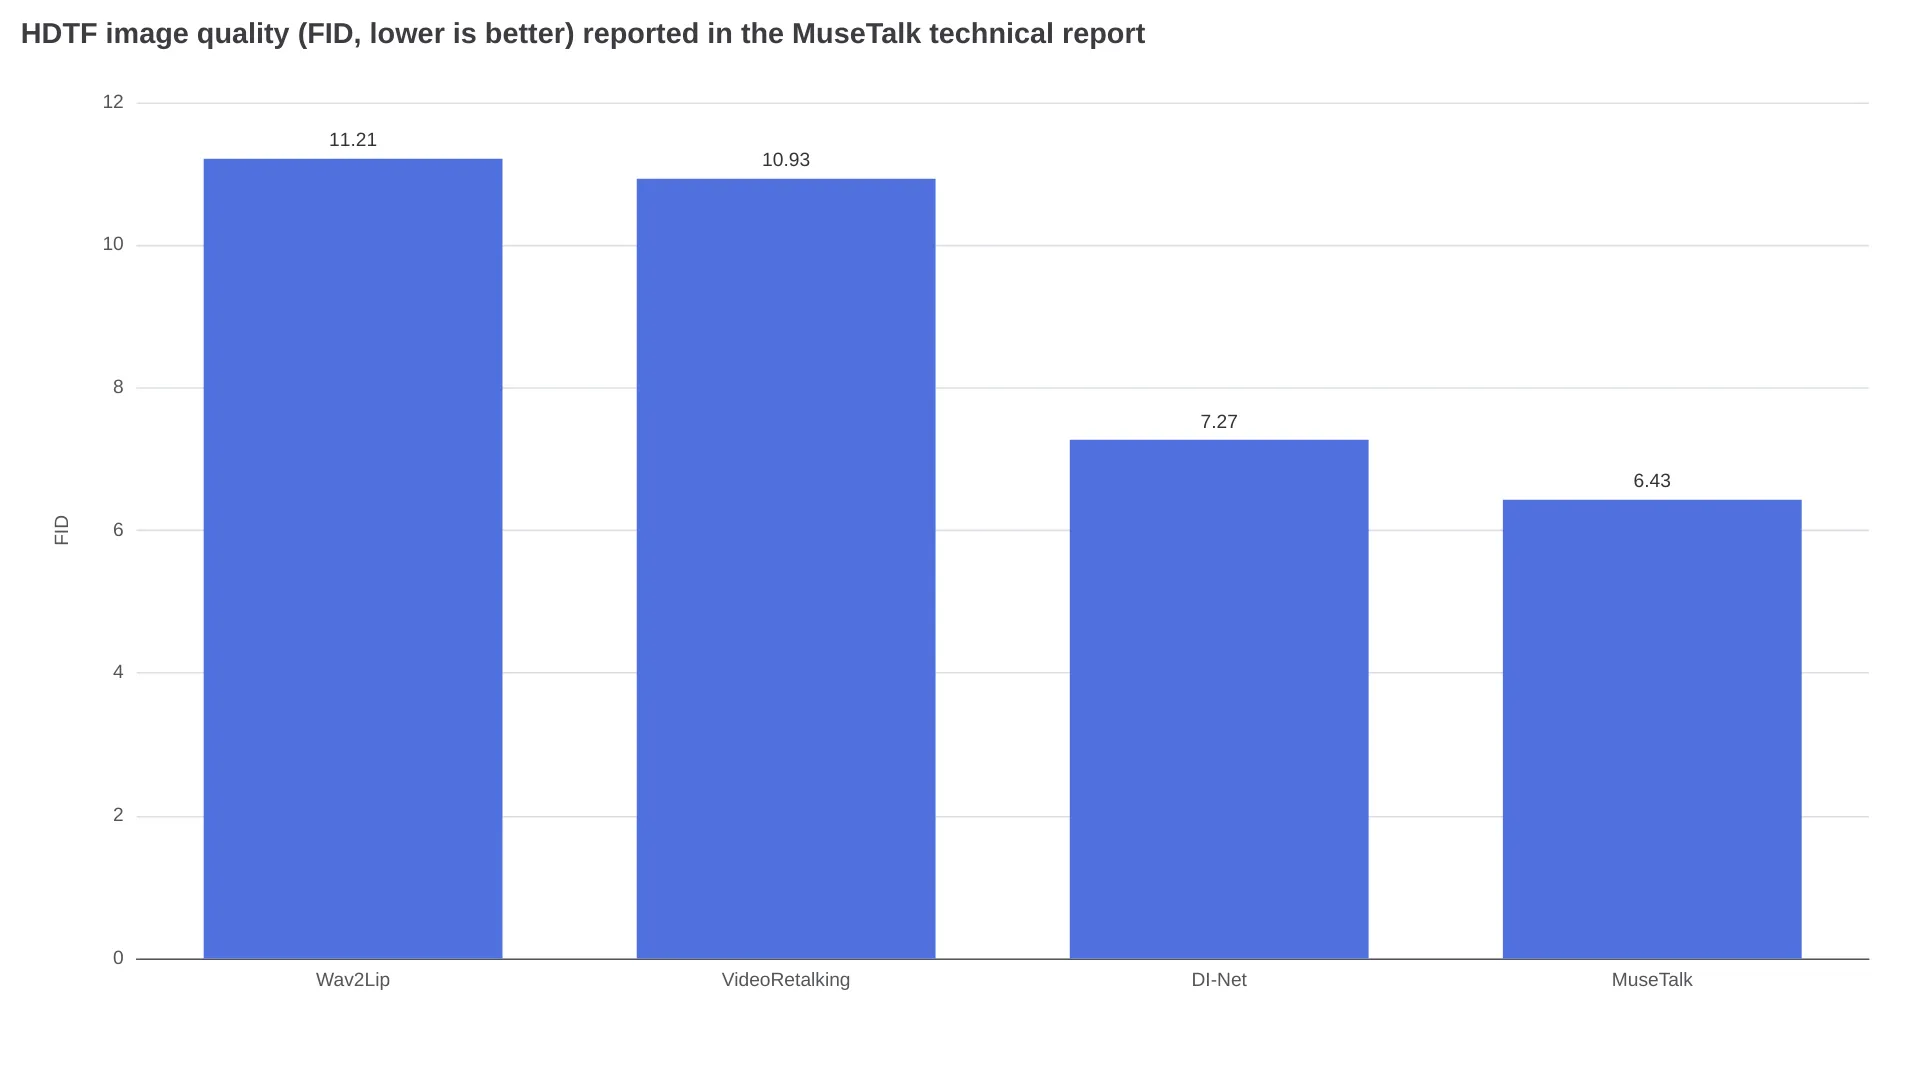
Beim Synchronisationswert dreht sich das Bild. Im selben Bericht erreicht Wav2Lip einen LSE-C-Wert von 7.46, MuseTalk kommt auf 6.53. Bei der Ähnlichkeit der Identität liegt MuseTalk mit einem CSIM von 0.8225 knapp vor Wav2Lip mit 0.8184. Das ergibt ein klares Bild: Das ältere GAN-Modell verfolgt die Lippen besser, MuseTalk liefert die höhere Bildtreue. Die Nutzerstudie des Berichts bleibt insgesamt eher im Mittelfeld: 3.62 von 5 Punkten für die visuelle Qualität, 3.55 für die Identität und 3.41 für die Lippensynchronisation.
Zusammen mit der 256x256-Grenze sprechen diese Werte eher für überzeugende Halbtotalen als für eine gestochen scharfe 4K-Nahaufnahme.
Was eine Minute Lippensynchronisation kostet
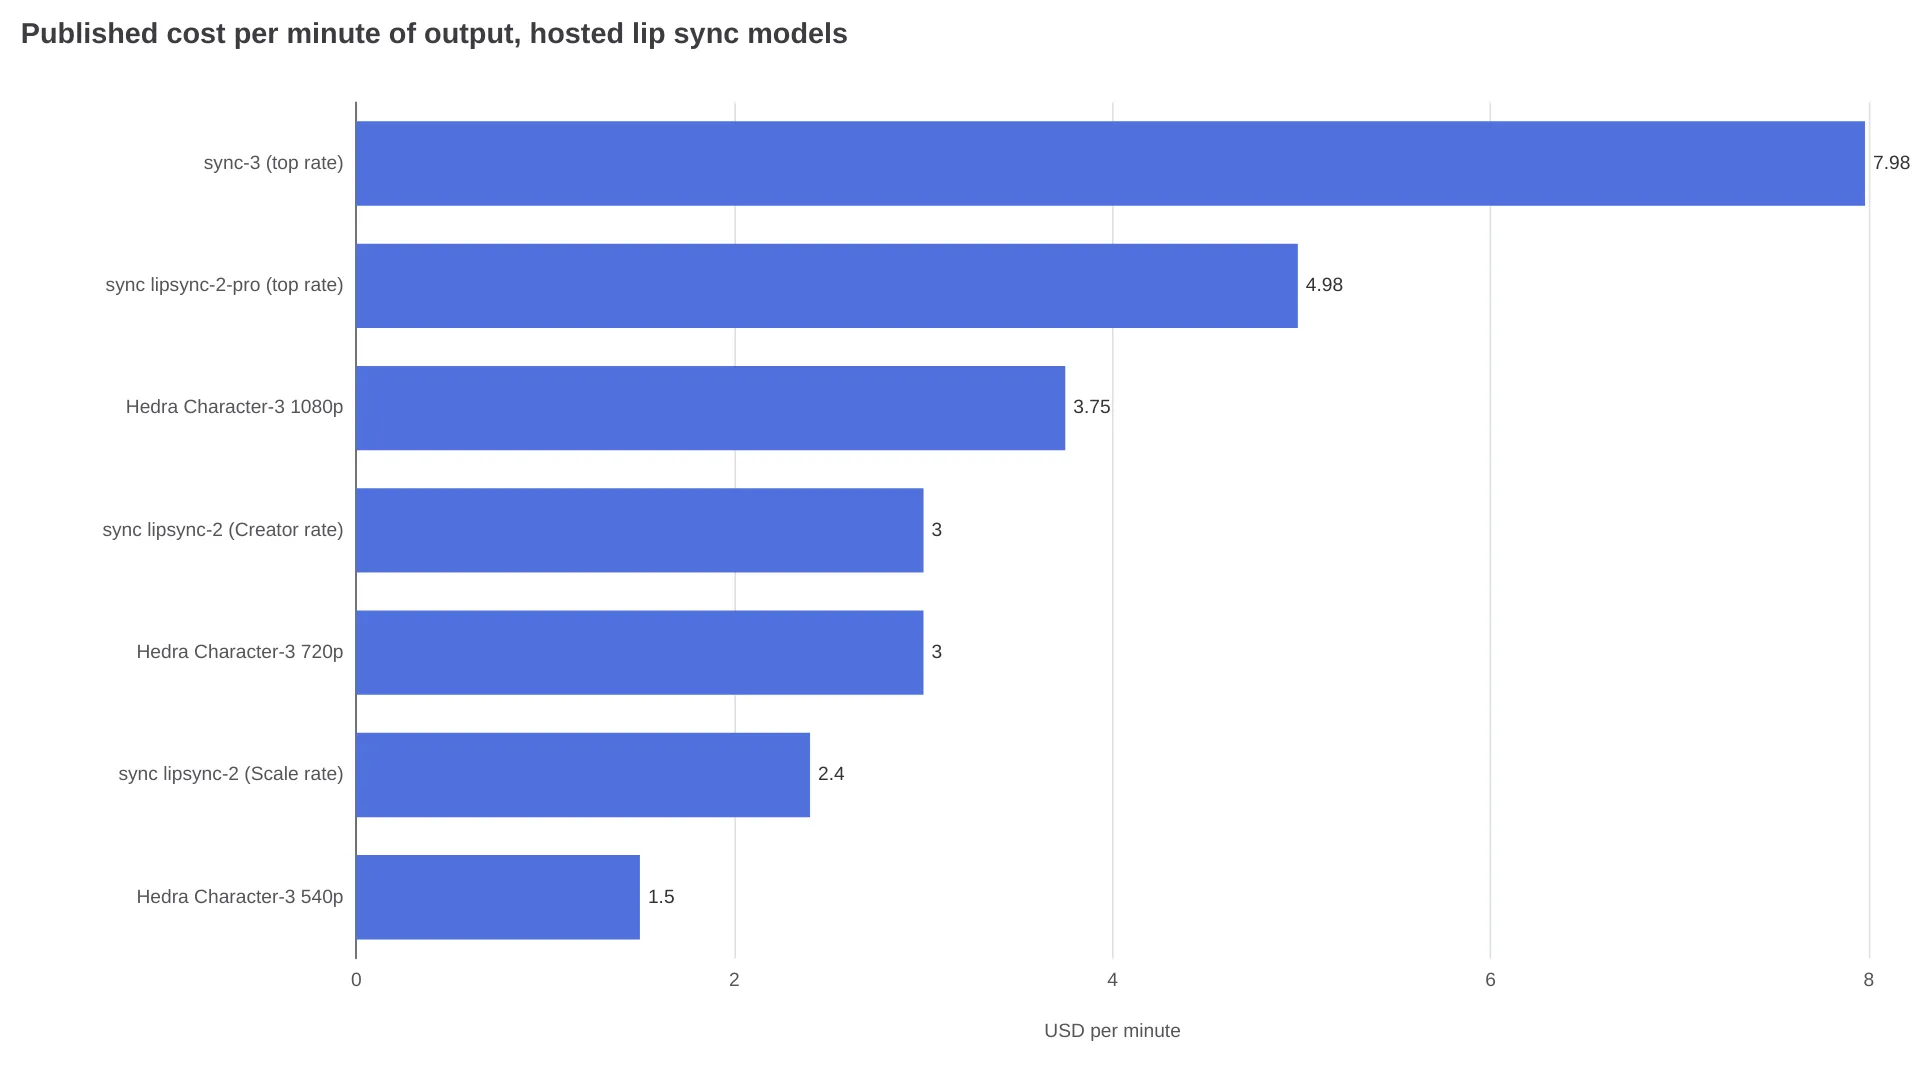
Hier spielt die Open-Source-Variante ihre größte Stärke aus. Die veröffentlichten Preise gehosteter Lip-Sync-Modelle liegen zwischen $1.50 und knapp $8.00 pro ausgegebener Minute.
| Variante | Veröffentlichter Preis (Abrechnungseinheiten unterscheiden sich) | Pro Ausgabeminute | Gesichtsauflösung |
|---|---|---|---|
| MuseTalk self-hosted, Tesla-V100-Miete | $0.188 / GPU-Stunde | ~$0.006 bei 2 GPU-Minuten pro Clipminute | 256x256 |
| MuseTalk auf Replicate | ~$0.052 / Lauf, 54 s typische Laufzeit laut Modellseite | Abrechnung pro Lauf, nicht pro Minute | 256x256 |
| MuseTalk auf fal.ai | Abrechnung pro Compute-Sekunde | Auf der Modellseite nicht veröffentlicht | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — Image-to-Video, kein direkter Ersatz für vorhandenes Videomaterial | 2.5¢ / 5¢ / 6.25¢ pro Sekunde | $1.50 / $3.00 / $3.75 | n/a |
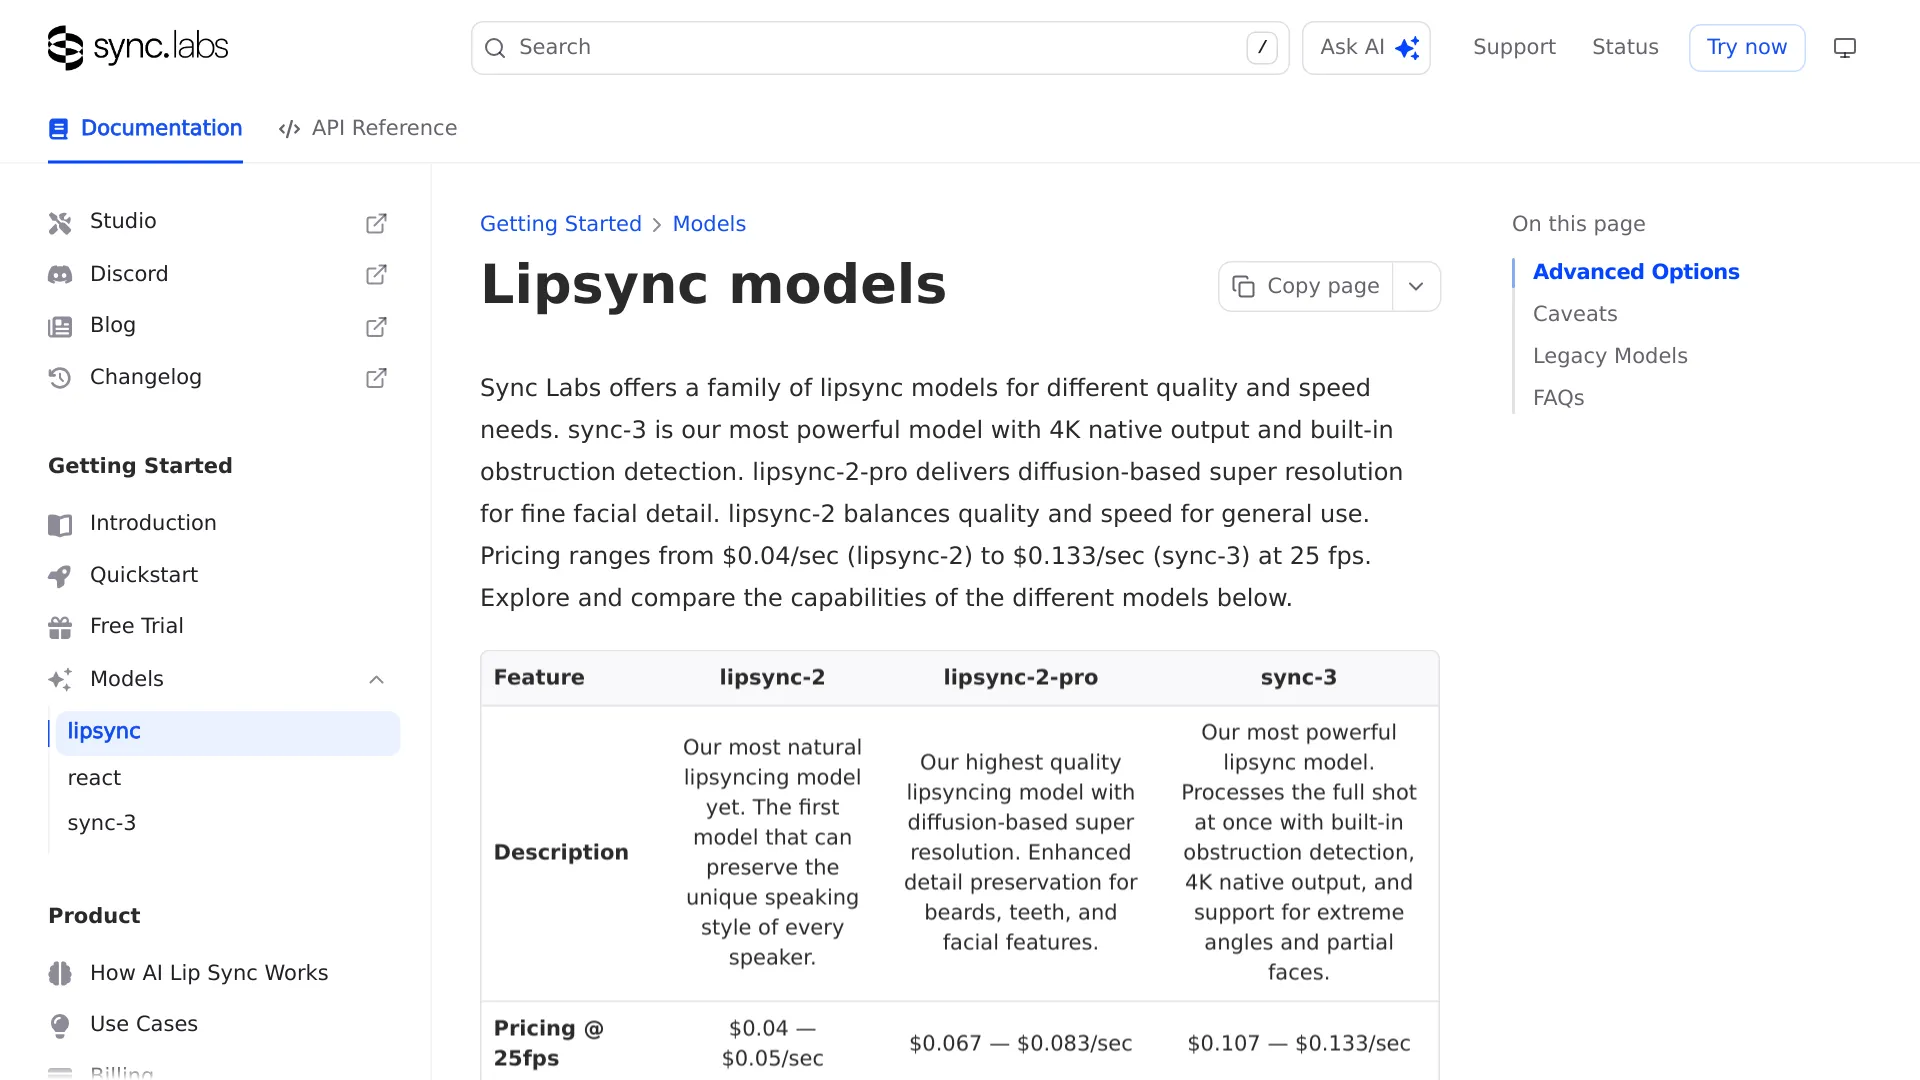
| sync lipsync-2 | $0.04–0.05 / Sekunde bei 25 fps | $2.40–$3.00 | 512x512 |
| sync lipsync-2-pro | $0.067–0.083 / Sekunde | $4.02–$4.98 | 512x512 + Detail-Pass |
| sync-3 | $0.107–0.133 / Sekunde | $6.42–$7.98 | Native 4K |
Die Zahl für Self-Hosting stammt aus dem Kostenüberblick von NexGPU. Dort werden zwei Minuten GPU-Zeit pro einminütigem Clip kalkuliert: Inferenz plus DWPose-Erkennung, VAE-Kodierung und -Dekodierung sowie FFmpeg-Muxing. Einhundert einminütige Clips kosten auf einer V100 bei $0.188 pro Stunde damit ungefähr $0.63 an Rechenzeit, zuzüglich etwa $0.09 für die Einrichtungszeit. Das sind ausschließlich GPU-Mietkosten; Entwicklungszeit, Speicher und laufender Betriebsaufwand sind nicht enthalten.
Bei einem Lokalisierungs-Backlog wird der Unterschied schnell deutlich. Fünfhundert Minuten synchronisiertes Videomaterial kosten über selbst gehostetes MuseTalk ungefähr $3 GPU-Miete, während sync lipsync-2 zum Creator-Tarif bei $1,200 liegt.
Ab wann die kostenlose Variante nicht mehr kostenlos ist
Der Aufpreis pro Minute kauft dir vor allem Folgendes:
- Höhere Gesichtsauflösung. Laut der Modelldokumentation von sync erzeugen lipsync-2 und lipsync-2-pro Gesichter mit 512x512 Pixeln – doppelt so groß wie MuseTalks Region. sync-3 liefert nativ 4K und bringt eine integrierte Super-Resolution mit.
- Schwierige Einstellungen. Dieselbe Dokumentation nennt Profilansichten, Over-the-Shoulder-Aufnahmen und teilweise verdeckte Gesichter als native Anwendungsfälle von sync-3. Verdeckungen werden automatisch erkannt. MuseTalk führt stattdessen pro Frame eine Gesichtserkennung durch; ein gedrehter Kopf oder eine Hand vor dem Mund sind daher dokumentierte Schwachstellen.
- Videos mit mehreren Personen. Eine Erkennung der aktiv sprechenden Person ist bei allen drei aktuellen sync-Modellen als Option aufgeführt. Bei MuseTalk gibt es dafür keinen entsprechenden Schalter.
- Einrichtungszeit. Bei einer selbst gehosteten Installation zahlst du diesen Aufwand nur einmal – klein ist er trotzdem nicht.
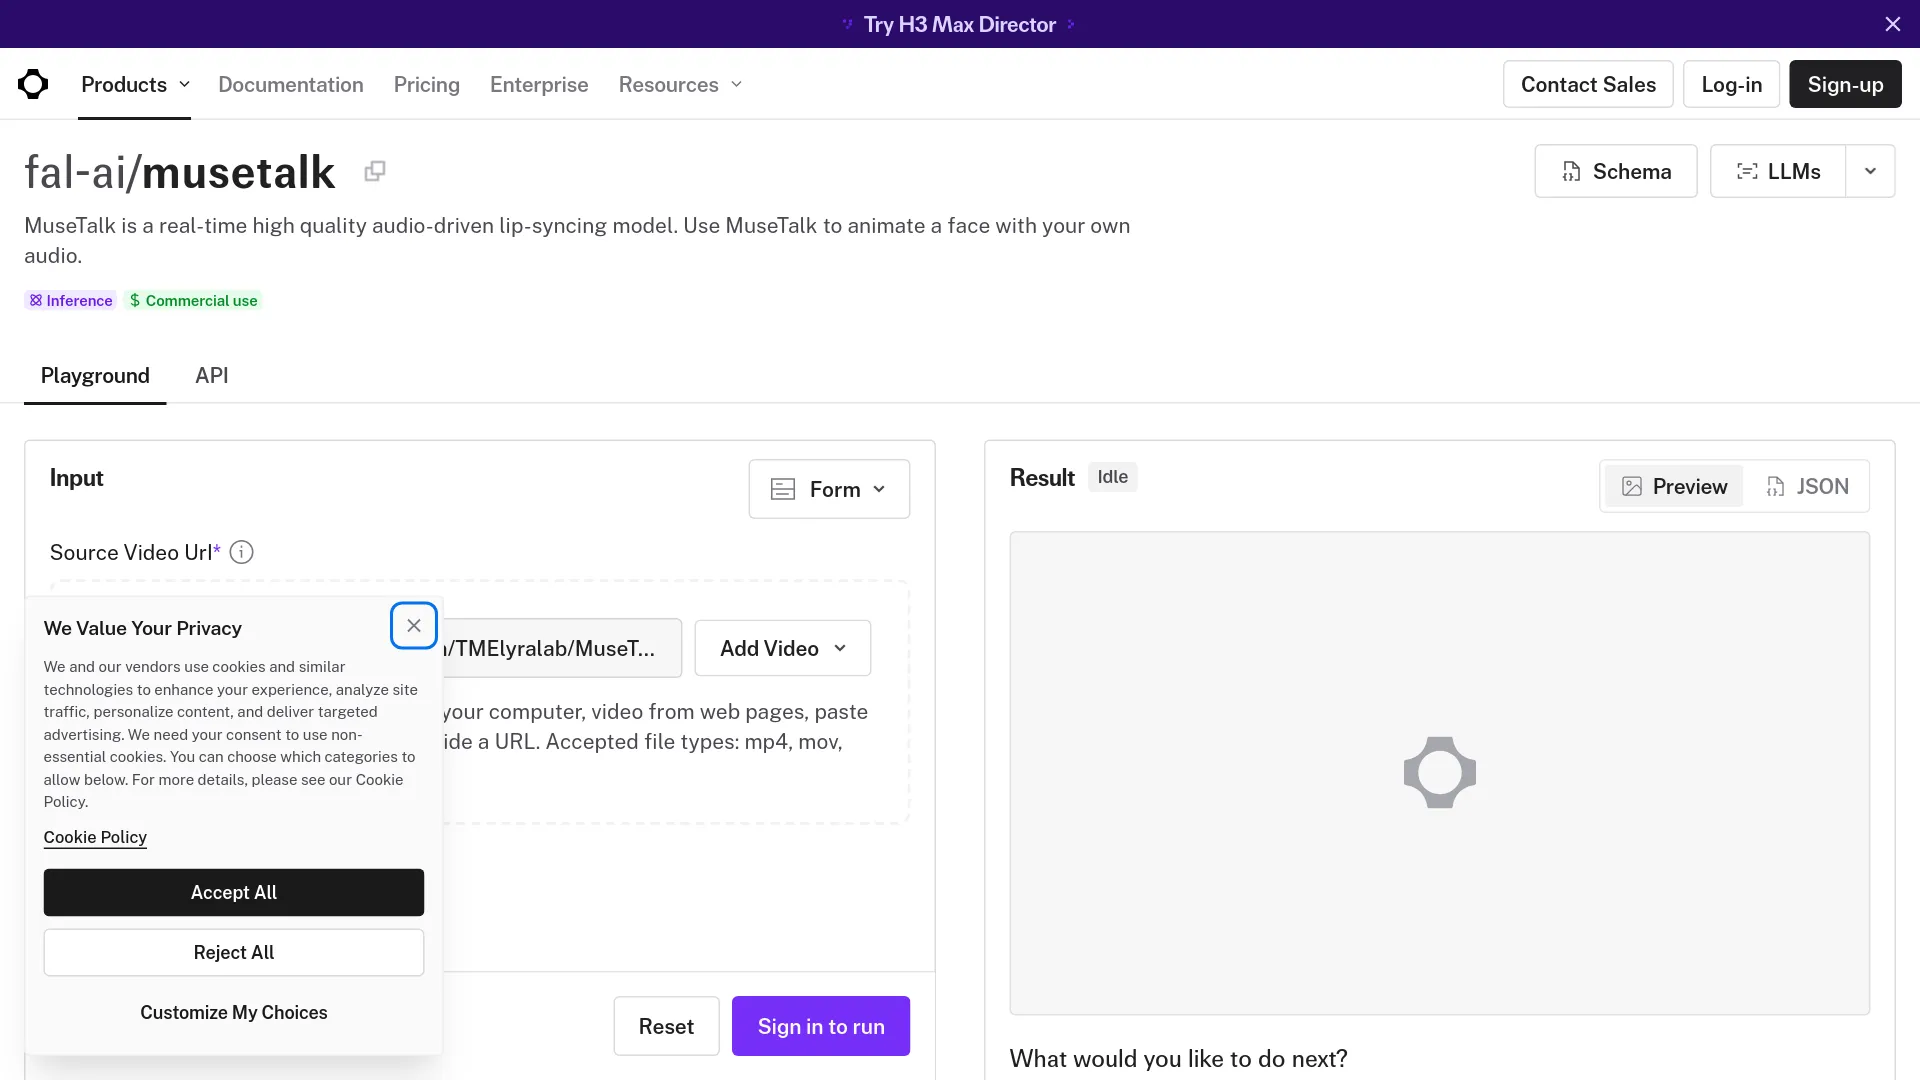
Die MuseTalk-Seite von fal.ai zeigt sehr anschaulich, wofür du bei einem gehosteten Dienst bezahlst: eine URL für das Quellvideo, eine URL für das Audio und sonst nichts. Keine conda-Umgebung, keine CUDA-Pins, kein Verzeichnis voller Gewichte.
MuseTalk zum Laufen bringen, ohne an Dependencies zu verzweifeln
Eine wiederkehrende Kritik von Nutzern, die das Modell tatsächlich ausgeführt haben, betrifft nicht die Ausgabequalität. Der Ärger steckt im OpenMMLab-Stack. Auf r/StableDiffusion brachte es ein Nutzer nach einem Vergleich von MuseTalk und LatentSync auf den Punkt:
"LatentSync and Musetalk work and have similar performance... Musetalk is a hassle to set up since it depends on OpenMMLab libraries." — u/Traditional_Tap1708, r/StableDiffusion
Installiere die im README festgelegten Versionen über mim, nicht über plain pip:
- Python 3.10 in einer frischen conda-Umgebung mit PyTorch 2.0.1, torchvision 0.15.2 und torchaudio 2.0.2.
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0". Eine neuere mmcv-Version ist die häufigste Ursache für Importfehler bei mmdet.- FFmpeg muss über
PATHerreichbar sein. Prüfe das mitffmpeg -versionoder übergib unter Windows den Pfad ausdrücklich mit--ffmpeg_path. sh download_weights.shlädt den vollständigen Gewichtsbaum. Das UNet allein reicht nicht: Das Skript lädt zusätzlich sd-vae-ft-mse, Whisper, DWPose mitdw-ll_ucoco_384.pthsowie die BiSeNet-Gewichte für die Gesichtssegmentierung. Fehlt eine Datei, zeigt sich das oft eher als Fehler bei Gesichtserkennung oder Blending statt als verständliche Fehlermeldung.- Konvertiere das Ausgangsvideo mit
ffmpeg -i input.mp4 -r 25 output.mp4auf 25 fps. Das Repository empfiehlt 25-fps-Eingaben, weil das Modell mit dieser Bildrate trainiert wurde. Eine Abweichung ist die häufigste Ursache für zeitliches Wegdriften. - Verweise in
configs/inference/test.yamlauf Video und Audio und starte anschließendpython -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15.
Wenn du wiederholt neue Audiospuren mit demselben Gesicht renderst, setze in configs/inference/realtime.yaml einmal preparation: true. Lass MuseTalk anschließend coords.pkl, latents.pt und die Masken unter results/v15/avatars/ zwischenspeichern und stelle den Wert danach wieder auf false. Auch --skip_save_images ist wichtiger, als es zunächst klingt: Das Schreiben der PNGs auf die Festplatte kann zum Flaschenhals werden und nicht mehr das Modell selbst.
MuseTalk 1.5 oder 1.0: Welche Gewichte solltest du laden?
Nimm 1.5. Das Repository führt diese Version als aktuellste Veröffentlichung vom 28 March 2025 und schreibt ihr dank Perceptual-, GAN- und Sync-Losses sowie einem Training in zwei Stufen eine bessere Klarheit, Identitätskonsistenz und Übereinstimmung von Lippen und Sprache zu.
Der einzige Grund, 1.0 zusätzlich aufzubewahren, ist bbox_shift. Dieser Parameter gilt nur für diese Version und verschiebt die Maskengrenze vertikal: Positive Werte öffnen den Mund weiter, negative schließen ihn.
Starte das Skript zunächst mit den Standardwerten. Es gibt dann den anpassbaren Bereich für deinen Clip aus. Im Beispiel des README reicht dieser von [-9, 9], wobei -7 als Wert gewählt wird. Rendere innerhalb des für deinen Clip ausgegebenen Bereichs neu: Gehe in den negativen Bereich, wenn der Mund zu weit aufgerissen wirkt, und in den positiven, wenn er sich kaum öffnet.
Typische Fehler – und was sich davon beheben lässt
| Symptom | Ursache | Behebbar? |
|---|---|---|
| Der Lauf bricht ab, kein Gesicht erkannt | Ein Frame zeigt ein gedrehtes, verdecktes oder fehlendes Gesicht | Ja. Den betroffenen Abschnitt zuschneiden oder entfernen |
| Der Mund bewegt sich kaum | Audio liegt unter Musik oder die Maskengrenze sitzt zu hoch | Ja. Gesang isolieren; bei v1.0 einen positiven bbox_shift setzen |
| Die Lippen laufen in der Mitte aus dem Takt | Das Ausgangsvideo hat nicht 25 fps | Ja. Vor der Verarbeitung konvertieren |
| Der Mund wirkt weich vor einem scharfen Gesicht | Das Gesicht ist für die 256x256-Region zu klein im Bild | Teilweise. Enger zuschneiden, fp16 deaktivieren, Face Restoration ergänzen |
| Sichtbare Naht, Schnurrbart bleibt nicht erhalten | Die Synthese des unteren Gesichts ersetzt Identitätsdetails | Nein. Das ist eine dokumentierte Einschränkung des Modells |
| Ruckeln von Frame zu Frame | Die Frames werden einzeln erzeugt | Teilweise. Das Repository führt das zweistufige Training von v1.5 als Grund für bessere Konsistenz an |
| Cartoon- oder stilisiertes Gesicht schlägt fehl | Die Trainingsverteilung besteht aus realen Gesichtern | Nein |
| Energetisches Audio bei einem statischen Sprecher | MuseTalk verändert weder Kopfbewegung noch Gesichtsausdruck | Nein. Ausgangsvideo neu aufnehmen oder ersetzen |
Ein Nutzer, der Tests mit wenig VRAM durchführte, meldete für MuseTalk "171s for 7 seconds of audio" und ergänzte, dass es "only works with realistic images" (u/Bartholomheow, r/StableDiffusion). Die Überschrift von der "Echtzeit"-Leistung beschreibt außerdem den dauerhaften Durchsatz nach der Avatar-Vorbereitung, nicht die Latenz vom Start bis zur fertigen Ausgabe. Ein Entwickler, der auf r/LocalLLaMA sprechende Köpfe baute, schrieb, bei MuseTalk sei "the preparation time is too long" (u/lonyPorgrammer) für seinen interaktiven Anwendungsfall.
Welche Lip-Sync-Variante zu welchem Job passt
| Variante | Die richtige Wahl, wenn | Wichtigster Kompromiss |
|---|---|---|
| MuseTalk self-hosted | Du große Mengen kooperativen Materials verarbeiten willst: Lokalisierungsentwürfe, interaktive Avatare mit einem Gesicht für tausende Audiospuren oder interne Schulungsvideos | Die Einrichtung dauert Stunden, nicht Minuten; der Durchsatz hängt von der gemieteten GPU ab |
| Gehostetes MuseTalk (Replicate, fal.ai) | Du nur wenige Clips hast oder die Qualität mit eigenem Material testen möchtest, bevor du eine Installation aufsetzt | Dasselbe 256x256-Limit, kein Avatar-Cache-Schalter im Schema eines der beiden Endpunkte, Abrechnung pro Lauf |
| Kostenpflichtiges Lip-Sync-Modell (sync-3, lipsync-2-pro) | Das Ergebnis für Kunden bestimmt ist, große Nahaufnahmen, Profilwinkel, Verdeckungen, mehrere Sprecher oder eine 4K-Ausgabe gefragt sind | $4–$8 pro Minute, außerdem verlässt das Videomaterial deine Infrastruktur |
Miete eine V100, wenn du den offiziellen Durchsatzwert reproduzieren möchtest, oder eine 4090, wenn du live streamen willst. Für gehostete Endpunkte behandeln wir beide Plattformen ausführlicher in unserem Replicate-Test und im fal.ai-Test.
MuseTalk Lipsync FAQ
Läuft MuseTalk auf einer GPU mit 6 oder 8 GB VRAM?
Ja. Das README dokumentiert eine getestete RTX 3050 Ti Laptop mit 4 GB VRAM im FP16-Modus, die für die grundlegende Inferenz ausreicht. Der praktisch größere Engpass ist der Durchsatz.
Ist 256x256 die Ausgabeauflösung?
Nein. Das ist die bearbeitete Gesichtsregion, die in ein Video mit ursprünglicher Auflösung und Bildrate zurückgeblendet wird.
Funktioniert MuseTalk mit Cartoon- oder Anime-Gesichtern?
Nicht zuverlässig. Das Modell wurde mit realen Aufnahmen sprechender Personen trainiert. Nutzer, die stilisierte Eingaben getestet haben, berichten von uneinheitlichen Ergebnissen.
Enthält die Angabe "30 fps real time" die Vorverarbeitung?
Nein. Sie beschreibt den Erzeugungsdurchsatz auf einer Tesla V100 nach der Avatar-Vorbereitung. Gesichtserkennung, latente Kodierung und der erste Caching-Durchlauf finden vorher statt.
MuseTalk oder LatentSync?
Greife zu MuseTalk, wenn Latenz und Volumen die wichtigsten Faktoren sind: Die einstufige Inferenz und gecachten Avatare reduzieren den Aufwand pro Clip erheblich. Der oben zitierte Nutzer von r/StableDiffusion, der beide Modelle ausprobiert hat, beschrieb ihre Leistung als ähnlich. Damit wird eher der Durchsatz als die Bildtreue zum entscheidenden Kriterium.
Darf MuseTalk kommerziell eingesetzt werden?
Das Repository steht für den Code unter der MIT-Lizenz, die Abhängigkeiten haben jedoch keine einheitliche Lizenz. Whisper, der VAE, DWPose, die BiSeNet-Gesichtssegmentierung und SyncNet werden jeweils unter eigenen Bedingungen veröffentlicht. Für die Beispieldaten weist das Repository außerdem auf separate Einschränkungen hin. Prüfe jeden Bestandteil, bevor du ein Produkt damit auslieferst.
Der Kompromiss, der bei diesem Preis ungelöst bleibt
MuseTalk bringt dich für praktisch kein Geld erstaunlich weit. Was unter schwierigen Bedingungen fehlt, ist die Identitätstreue: Schnurrbärte, die exakte Lippenform, ein Gesicht, das den gesamten Bildausschnitt füllt, oder ein Sprecher, der sich mitten im Satz dreht.
Für die meisten Teams lautet die Antwort deshalb nicht ein einziges Tool. MuseTalk übernimmt die Masse, ein kostenpflichtiges Modell die Einstellungen, die später bildschirmfüllend zu sehen sind.
Weiterführende Artikel
- Higgsfield AI: Tests und Preise im Vergleich zum API-Zugriff
- Kokoro 82M TTS: Lokale Einrichtung zur Erzeugung der Audiospur, die MuseTalk verarbeitet
- Wan 2.2 Animate: Anleitung