 AIREITER
Muse Spark 1.2 im Kurzfazit
Meta hat Muse Spark 1.2 am 5. August 2026 veröffentlicht – mit besseren Coding-Benchmarks als 1.1 und einem neuen Terminal-Agenten, der eigens dafür entwickelt wurde. Gegen Claude Opus 5 verliert das Modell allerdings weiterhin auf allen drei Coding-Ranglisten. Genau darin liegt die Einordnung dieses Updates: Die Fortschritte sind messbar. Meta hat mehr Trainings-Compute für Coding eingesetzt und das Modell zusammen mit seinem Muse Code Agent trainiert. Doch ein Teil des Sprungs zwischen den Versionen geht auf das neue Harness zurück, nicht allein auf das Modell. Bei Terminal-Bench, DeepSWE und Metas internem Coding-Eval bleibt Anthropic mit 4 bis 9 Punkten vorn.
Interessant wird Muse Spark 1.2 dennoch über den Preis. Die regulären Tarife bleiben bei $1.25/$4.25 pro Million Tokens, im Contributor-Tarif sinken sie um etwa das 12-Fache. Dafür gibt es zwei wichtige Einschränkungen: Im Standard-Einstiegspfad darf Meta deinen Code zum Trainieren verwenden, und bei der höchsten Reasoning-Stufe ist die Zeit bis zum ersten Token um etwa das Neunfache gestiegen. Wer Muse Spark 1.2 für Coding in Produktion bewertet, sollte diese beiden Punkte höher gewichten als eine Ranglistenposition.
Das steckt neu in Version 1.2
Muse Spark 1.2 ist ein auf Coding zugeschnittenes Update von Metas Frontier-Reasoning-Modell. Es erschien am 5. August zusammen mit Muse Code, einem terminalbasierten Coding-Agenten, der sich derzeit in der Beta befindet. Meta selbst bezeichnet den Abstand zu Muse Spark 1.1 als „moderate Verbesserung“. Das ist bewusst zurückhaltend formuliert, denn die Fortschritte konzentrieren sich auf die anspruchsvollen Aufgaben von Coding-Agenten: Refactorings über mehrere Dateien, längere Debugging-Sitzungen und Arbeiten, die weit über einen einzelnen Prompt hinausgehen.
Zwei Trainingsentscheidungen erklären den Zugewinn. Erstens war Muse Code von Beginn an Teil der Trainingsschleife. Meta trainierte das Modell gemeinsam mit per Rejection Sampling ausgewählten Harness-Trajektorien und optimierte es damit für die Arbeit im eigenen Agenten. Nach Angaben des Unternehmens kamen mehrere Harnesses zum Einsatz, sodass das Modell auch mit anderen Coding-Tools funktionieren soll. Zweitens setzte Meta auf einen Selbstverbesserungs-Loop: Muse Spark 1.1 erzeugte anspruchsvolle Coding-Umgebungen und Vorlagen zum Befolgen von Anweisungen, bewertete Kandidatenlösungen dagegen und lieferte so den Trainingsdatensatz für 1.2. Meta führt darauf zurück, dass 1.2 komplexe Instruktionen nachweislich besser befolgt.
Das Update greift die bisher schwächste Seite der Muse-Familie an. Als Muse Spark im April 2026 debütierte, lag es beim agentischen Coding mit 77.4 auf SWE-Bench Verified hinter Claude Opus 4.6 mit 80.8. Ein auf Coding spezialisierter Checkpoint in Verbindung mit einem maßgeschneiderten Harness ist die direkte Antwort darauf; die allgemeine agentische Leistungsfähigkeit soll dabei erhalten bleiben.
Die Benchmarks richtig eingeordnet
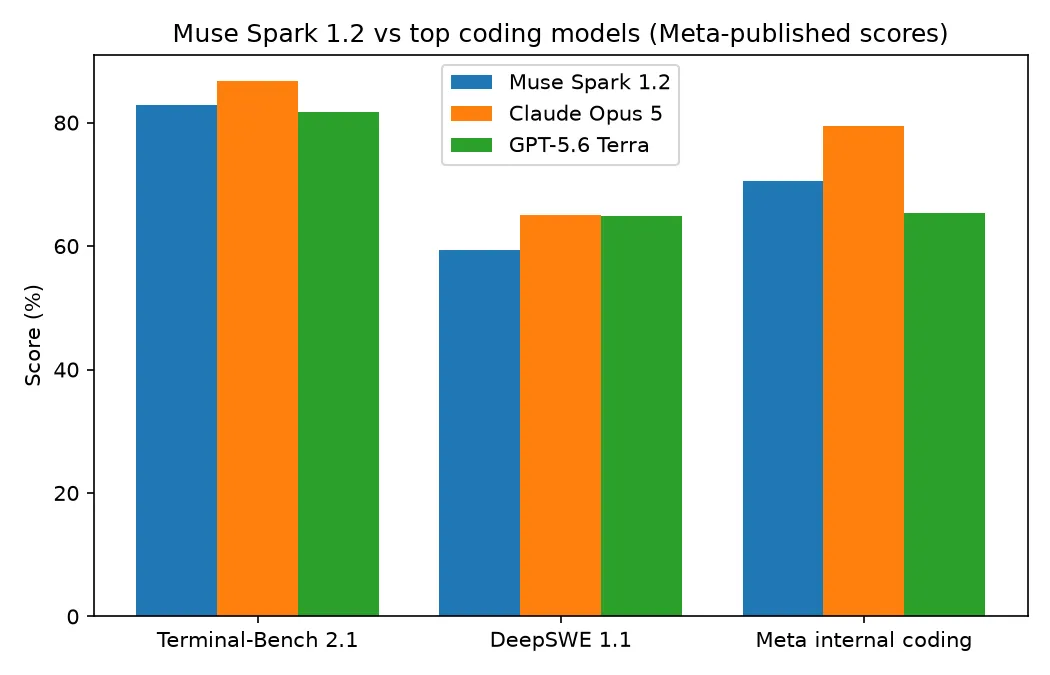
Bei Terminal-Bench 2.1 erreicht Muse Spark 1.2 in Muse Code 82.9%. Damit liegt es knapp vor GPT-5.6 Terra in Codex mit 81.8% und Grok 4.5 in Grok Build mit 81.6%. Claude Opus 5 mit maximalem Aufwand in Claude Code führt jedoch mit 86.7%. Bei DeepSWE 1.1 kommt Muse Spark 1.2 auf 59.3% und landet hinter Opus 5 mit 65.0% sowie GPT-5.6 Terra mit 64.8% auf Platz drei. Besonders offen ist Metas internes Coding-Benchmark: Die 70.6% von Muse Spark 1.2 übertreffen GPT-5.6 Terra mit 65.4% und Gemini 3.6 Flash mit 63.9%, liegen aber noch fast neun Punkte hinter den 79.4% von Opus 5. Claude führt alle drei Charts an.
Der Fortschritt gegenüber der Vorgängerversion ist real: Bei Terminal-Bench gewinnt Muse Spark 1.2 gegenüber 1.1 um 6.7 Punkte, bei DeepSWE um 6.3 Punkte. Für den Versionsvergleich ist allerdings ein Detail in den Diagrammbeschriftungen wichtig. Die Werte von 1.1 entstanden mit einem generischen mini-swe-agent-Harness, während 1.2 in Muse Code lief. Ein Teil des Zugewinns gehört also dem neuen Harness und nicht nur dem neuen Modell. Im gemischten Intelligence Index von Artificial Analysis erzielt 1.2 einen Wert von 54 und liegt damit auf Rang #14 von 186 Modellen; der Klassenmedian beträgt 32. Gegenüber den 51 Punkten von 1.1 ist das ein deutlich kleinerer Fortschritt, als die Coding-Charts nahelegen.
Der direkte Vergleich mit Claude und GPT ist genau die Frage, die Interessenten immer wieder stellen. Auf Reddit formulierte es ein Entwickler noch vor den ersten Daten zu 1.2 so:
„Hat jemand Metas MUSE Spark 1.1 verwendet? Mich interessiert, wie es sich bei Reasoning, Coding, Geschwindigkeit, Genauigkeit und Context Handling mit Claude und GPT vergleicht.“
Die Benchmarks zu 1.2 liefern darauf erstmals eine belastbare Antwort: konkurrenzfähig, beim Coding klar auf Platz zwei und auf den meisten Charts vor den Optionen von GPT-5.6 und Gemini.
Zwei Haken für den Produktiveinsatz
Ob Muse Spark 1.2 im tatsächlichen Workflow funktioniert, entscheiden zwei praktische Details. In einer Rangliste tauchen sie nicht auf.
xhigh macht die Antwort deutlich langsamer
Muse Spark ist ein Reasoning-Modell: Es denkt vor der Antwort nach, und diese Funktion lässt sich nicht abschalten. Der Regler /effort bietet fünf Stufen von minimal bis xhigh; Thinking-Tokens werden als Output abgerechnet. Auf der höchsten Stufe steigen die Kosten gleich in zweifacher Hinsicht. Unabhängige Messungen von OrcaRouter zeigen, dass die Zeit bis zum ersten Token bei xhigh von 2.90 Sekunden in 1.1 auf 26.12 Sekunden in 1.2 sprang – also etwa auf das Neunfache. Gleichzeitig sank die Output-Geschwindigkeit von 213.5 auf 165.0 Tokens pro Sekunde. Die Ausführung des Artificial Analysis Intelligence Index für 1.2 kostete $637.85, 16% mehr als die $548.07 für 1.1, allein weil das Modell länger abwägt. Bei interaktivem Coding, wenn Entwickler auf eine Antwort warten, tauscht maximaler Aufwand Latenz gegen Genauigkeit – und das lohnt sich häufig nicht.
Der Contributor-Tarif erkauft den Rabatt mit deinen Daten
Meta bietet Muse Spark 1.2 in zwei Tarifen an. Der Tarif, zu dem neue Nutzer geführt werden, ist an eine Bedingung geknüpft. Der Contributor-Tarif ($0.10/$0.20 pro Million Input-/Output-Tokens statt $1.25/$4.25 im Standardtarif) ist beim Input etwa 12x und beim Output 21x günstiger; gecachte Eingaben kosten mit $0.002 nahezu nichts. Der Tausch ist ausdrücklich festgehalten: Meta darf Prompts und Vervollständigungen verwenden, um künftige Modelle zu trainieren. Es ist der günstigste Tarif im obigen Vergleich – bezahlt wird er mit den eigenen Daten.
Der Standard-Einstieg über Muse Code führt Entwickler in genau diesen Tarif. In einem von VentureBeat dokumentierten Test funktionierte der Einzeilen-Installer auf einem Mac mini – ein Download von 97 MB und eine Anmeldung. Der Agent führte anschließend jedoch nichts aus, meldete keine sichtbaren Modelle und verlangte selbst im vergünstigten Tarif eine Zahlungsmethode. Günstig trifft zu, kostenlos nicht. Auch die Rate Limits sind mit 60 Anfragen pro Minute statt 3,000 im Standardtarif deutlich strenger. Das zeigt klar: Der Tarif richtet sich an Einzelpersonen und Prototyping, nicht an Produktion. Teams mit proprietären Codebases sollten bewusst zum Standardtarif wechseln oder über Metas Vertrieb Zero Data Retention anfragen.
Preislich im Markt eingeordnet
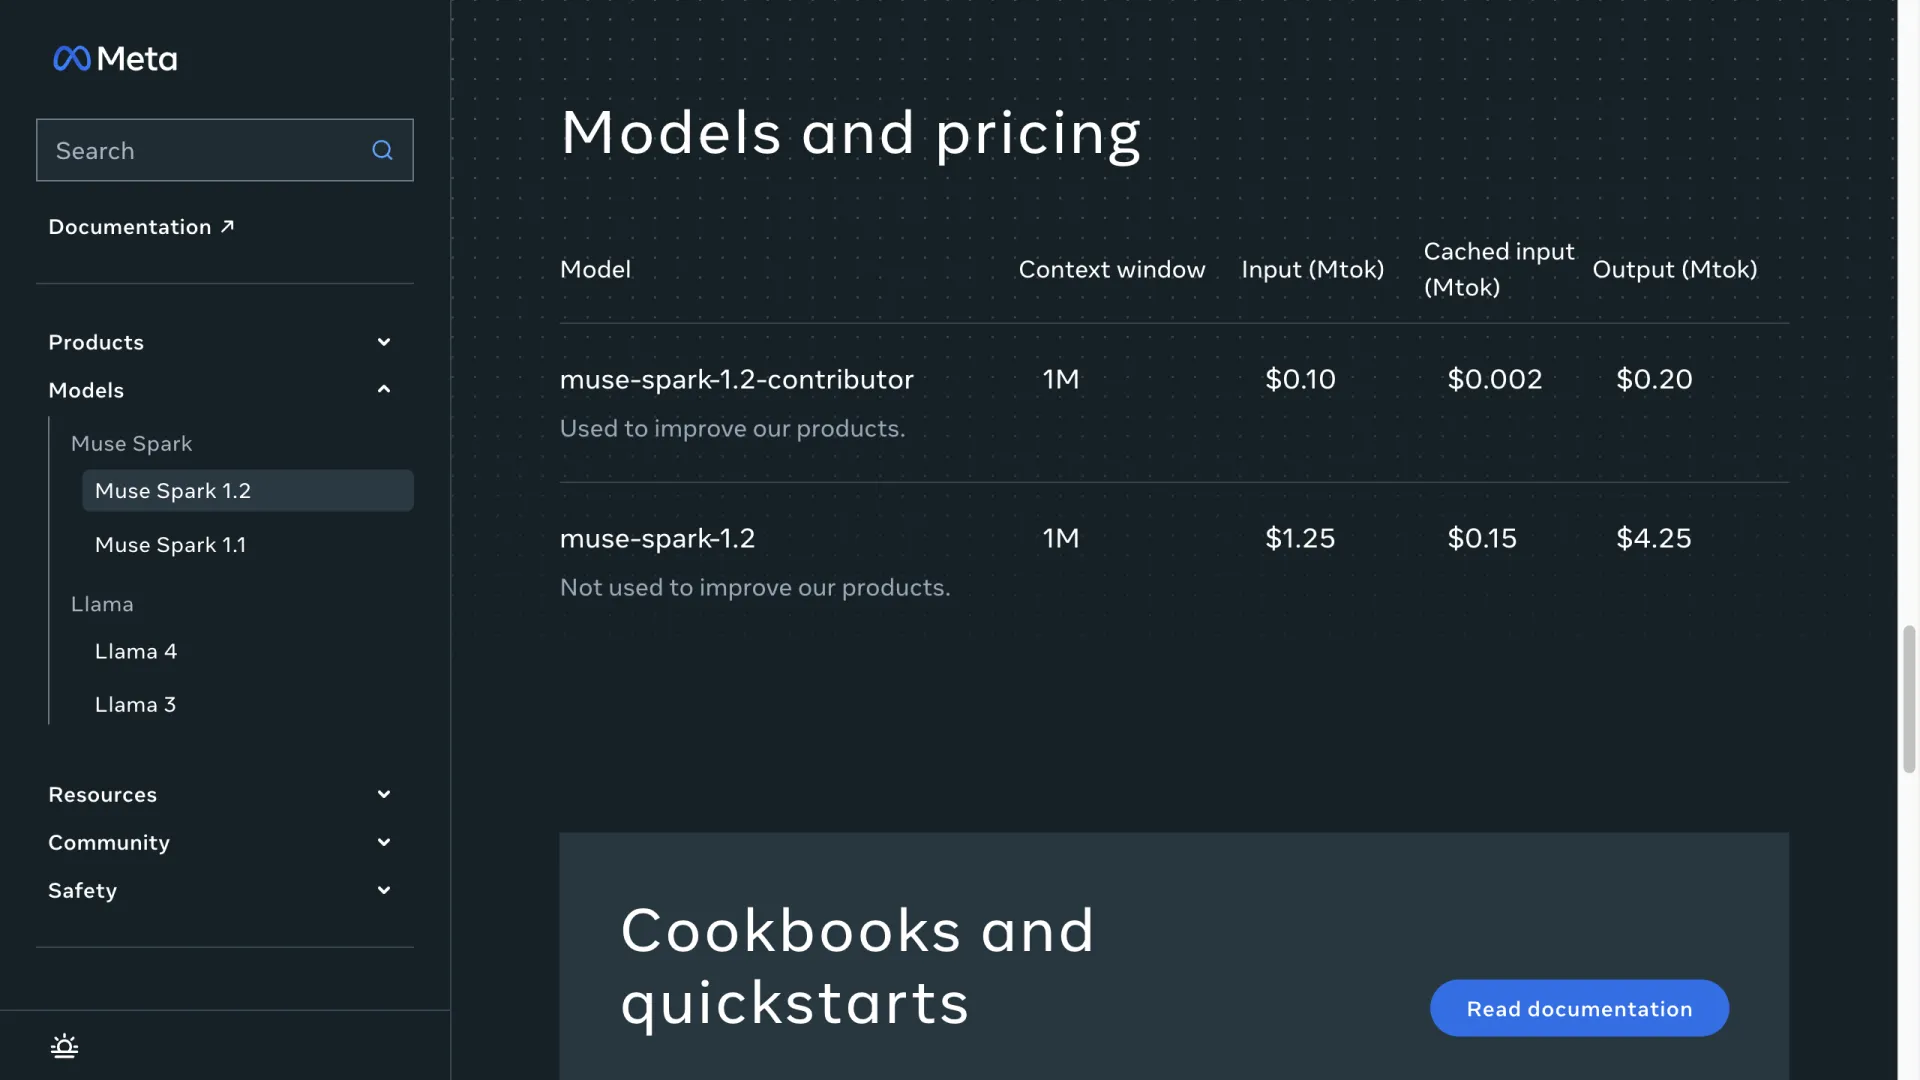
Mit $1.25 pro Million Input-Tokens, $0.15 für gecachte Tokens und $4.25 für Output liegt Muse Spark 1.2 im Standardtarif im unteren Mittelfeld des Markts für Coding-Modelle. Das Kontextfenster beträgt 1M Tokens, einen Aufpreis für langen Kontext gibt es nicht. Gegenüber den führenden Frontier-Coding-Modellen ist es deutlich günstiger: Claude Opus 5 mit $5/$25 und GPT-5.5 mit $5/$30 kosten beim Output etwa 4 bis 7x so viel. Fast auf demselben Preisniveau liegt Z.ai's GLM-5.2 mit $1.40/$4.40, während Grok 4.5 mit $2/$6 eine Stufe darüber liegt. Am günstigen Ende unterbietet DeepSeek V4 Pro mit $0.435/$0.87 Muse Spark um ein Mehrfaches – ebenso der Contributor-Tarif von Muse Spark selbst.
| Modell | Input $/M | Output $/M | Cache $/M | Kontext |
|---|---|---|---|---|
| Muse Spark 1.2 (Standard) | 1.25 | 4.25 | 0.15 | 1M |
| Muse Spark 1.2 (Contributor)* | 0.10 | 0.20 | 0.002 | 1M |
| Claude Opus 5 | 5.00 | 25.00 | — | — |
| GPT-5.5 | 5.00 | 30.00 | — | — |
| GLM-5.2 | 1.40 | 4.40 | — | — |
| Grok 4.5 | 2.00 | 6.00 | — | — |
| DeepSeek V4 Pro | 0.435 | 0.87 | — | — |
\*Der Contributor-Tarif räumt Meta Trainingsrechte an deinen Daten ein; Limit: 60 Anfragen/Min.
Verfügbarkeit und nutzbare Alternativen
Muse Spark 1.2 ist an drei Stellen verfügbar: über die Meta Model API, den Terminal-Agenten Muse Code und OpenRouter. Bei weitem nicht jeder Aggregator führt es bereits – im am 6. August 2026 geprüften Katalog von AIReiter ist es nicht gelistet. Wer auf einer einheitlichen API aufbaut und heute ein Coding-Modell braucht, muss daher aus den bereits angebundenen Optionen wählen.
Der aktuell verfügbare Preis-Zwilling ist GLM-5.2 für $1.40/$4.40. Am 6. August 2026 habe ich eine einmalige Coding-Reasoning-Aufgabe über glm-5.2 ausgeführt, angebunden über die API der Plattform, um zu prüfen, was „heute verfügbar“ konkret liefert: eine Python-Funktion für Abhebungen, der die Überziehungsprüfung fehlte. GLM-5.2 antwortete in 3.2 Sekunden mit 85 Prompt- und 128 Completion-Tokens, erkannte die fehlende Kontostandsprüfung korrekt, lieferte die Korrektur (if amount > 0 and account_balance >= amount:) und schrieb einen Test, der vor dem Fix fehlschlägt und danach durchläuft. Das ist eine einzelne Aufgabe, kein Benchmark. Es zeigt aber: Zum selben Preis ist bereits heute ein funktionierendes Coding-Modell direkt abrufbar. DeepSeek V4 Pro, Kimi K3, Claude Sonnet 5 und die GPT-5.6-Familie ergänzen die Coding-fähigen Optionen, die bereits in AIReiters Katalog verfügbar sind.
Lohnt sich Muse Spark 1.2?
Die Entscheidung hängt von drei unterschiedlichen Prioritäten ab.
Nimm Muse Spark 1.2, wenn du preisbewusst in großem Maßstab programmierst – etwa bei umfangreichen Refactorings über mehrere Dateien, langen Debugging-Sitzungen oder agentischen Aufgaben mit langem Horizont – und Meta, Muse Code oder OpenRouter direkt nutzen kannst. Für $1.25/$4.25 bietet es Coding-Leistung auf Frontier-Niveau zu Preisen der Mittelklasse. Das Kontextfenster von 1M Tokens samt Context Compaction eignet sich für Arbeit, die länger als ein einzelner Prompt dauert. Bleibe beim Reasoning-Aufwand unter xhigh, sofern deine Aufgabe nicht 26 Sekunden bis zum ersten Token verkraftet.
Nimm Claude Opus 5, wenn du die Spitze der Coding-Benchmarks brauchst. Das Modell führt auf allen drei Benchmarks, auf denen Muse Spark 1.2 auftaucht. Für den Genauigkeitsvorsprung zahlst du pro Token 4 bis 6x mehr.
Nimm ein Modell, das dein Aggregator bereits führt, wenn du heute ausliefern musst und Muse Spark auf deiner Plattform fehlt. GLM-5.2 bietet ohne Wartezeit dieselbe Preisklasse; DeepSeek V4 Pro ist noch günstiger, wenn die reinen Kosten entscheidend sind.
FAQ
Ist Muse Spark 1.2 beim Coding besser als Claude Opus 5?
Nein. Claude Opus 5 führt auf allen drei von Meta veröffentlichten Coding-Benchmarks – Terminal-Bench 2.1, DeepSWE 1.1 und Metas internem Coding-Eval – mit Vorsprüngen von 3.8 bis 9 Punkten. Muse Spark 1.2 liegt klar auf Platz zwei und vor GPT-5.6 Terra sowie Gemini 3.6 Flash auf den meisten Charts.
Ist Muse Spark 1.2 Open Source?
Nein. Anders als Metas Llama-Familie ist Muse Spark proprietär: ausschließlich in der Cloud verfügbar, ohne herunterladbare Weights und ohne Self-Hosting. Mark Zuckerberg hat angekündigt, er werde zu möglichen Open-Source-Veröffentlichungen „mehr zu teilen haben“. Für 1.2 gibt es jedoch weder Weights noch eine Lizenz.