 AIREITER
Wie viel bringt das offizielle Prompt-Schema von MiniMax H3 wirklich? Laut eigener Model Card ist die Vorverarbeitungsschicht für die Qualität des Endergebnisses „entscheidend“. Ein Reddit-Thread mit 220 Upvotes liest sich dagegen wie ein Fehlerprotokoll zu Kauderwelsch-Dialogen. Dieser MiniMax-H3-Prompt-Test stellt das offizielle Format den dokumentierten Creator-Tests und Fehlerberichten gegenüber: Kamera- und Referenzsteuerung funktionieren in diesen Berichten deutlich verlässlicher als Dialog und Audio – und die besten Resultate entstehen teils gerade dann, wenn man bewusst von der Syntax abweicht.
So funktioniert das Prompt-Format von MiniMax H3
Ein offizieller MiniMax-H3-Prompt ist ein strukturiertes Dokument mit drei Feldern: integrated_multimodal_description, overall_soundscape und non_diegetic_music. Dazu kommen zeitcodierte Shots, dauerhaft vergebene Sprecher-IDs und <d>-Tags für Dialoge. Der Grund: H3 erwartet eine strukturierte Zwischenrepräsentation, die normalerweise der gehostete Preprocessor H3-Context-IR erzeugt. MiniMax hat ihn allerdings nicht in die Open-Weights-Veröffentlichung aufgenommen. Über die gehostete API werden freie Eingaben automatisch umgeschrieben; wer die 33B Open Weights lokal mit SGLang, vLLM, Diffusers oder ComfyUI nutzt, muss diese Struktur selbst formulieren.
Im offiziellen GitHub-Repo liefert MiniMax außerdem eine portable Fähigkeit namens h3-prompt-writing mit: zwei Guide-Dateien, base-en.txt und ref-en.txt, die jeder Coding-Agent ohne externe API-Aufrufe einlesen kann. Creator verwenden sie etwa in Claude oder Cursor, um Briefings in Alltagssprache in das vollständige Format zu überführen. @AI__TSUBAKI dokumentiert genau diesen Workflow für filmische Clips.
Diese Grenzen gelten für jeden Prompt
| Vorgabe | Wert | Konsequenz fürs Prompting |
|---|---|---|
| Clip-Länge | 4–15 Sekunden, 24 FPS | Zeitstempel müssen strikt aufsteigend sein und innerhalb der Laufzeit liegen |
| Audio | 32-kHz-Stereo, gemeinsam generiert | Soundscape- und Musikfeld sind Pflicht; N/A ist erlaubt |
| Auflösung | 768p standardmäßig; 2K über H3-Regenerate-2K, nur per API | Bei 768p testen, erst nach finalem Prompt für 2K zahlen |
| Aufgabentypen | T2VA (Text), I2VA (erstes Bild bei 0.00 s), FL2VA (erstes + letztes Bild), L2VA (letztes Bild), Ref2VA (Omni-Referenz) | Jeder Typ benötigt seinen eigenen Alignment-Satz |
| Referenzlimits | 9 Bilder + 3 Videoclips + 3 Audioclips, insgesamt 12 Dateien, ≤15 s je Medientyp | Mehr Referenzen bedeuten mehr Routing – nicht automatisch bessere Ergebnisse |
| Prompt-Größe | Offizielle Beispiele umfassen 300–700 Wörter; reines Text-zu-Video ist auf etwa 7.000 Zeichen begrenzt | Kurze Prompts ohne Referenzen gelten laut offiziellem Handbuch als Fehlerquelle |
Ein vollständiger Minimal-Prompt mit drei Feldern, einer Kameraanweisung, sichtbarer Sprecherin samt Dialog und ohne Musik passt in zehn Zeilen:
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
Die komplette Feldsyntax mit allen Tags, Alignment-Sätzen und Vorlagen behandelt unser MiniMax H3 prompt guide. Hier geht es darum, ob sich dieser Syntax-Aufwand tatsächlich lohnt.
Drei Versprechen des Formats im Praxistest
Aus der offiziellen Anleitung lassen sich drei zentrale Versprechen ableiten. Die zitierten Berichte sprechen klar für die ersten beiden – bei der Audiotreue fällt das Urteil deutlich gemischter aus.
Versprechen 1: Struktur liefert planbarere Ergebnisse
Hier ist die Evidenz am deutlichsten. Der X-Creator @AIWarper veröffentlichte einen Vorher-nachher-Vergleich, nachdem er zum offiziellen Format gewechselt war:
„I STRONGLY encourage you to adhere to the prompting guide released by Minimax. It really helps a lot with getting exactly what you expected.... My last post did not follow the suggested prompt structure.“ — @AIWarper, 306 Likes
Auch das Testprotokoll eines Drittanbieters zeigt dieses Muster auf Detailebene: Ein Schnitt bei exakt 00:05.000 wurde umgesetzt, ein vorgegebenes Testimonial wortgetreu gesprochen und eine First-Frame-Komposition über einen 6-sekündigen I2VA-Clip stabil gehalten. Ähnlich fallen Storyboard-Berichte aus: Die Boards von @aimikoda werden als aufeinanderfolgende Shot-Vorgaben befolgt; @nanyuan0412 berichtet ebenfalls von einem ohne Improvisation umgesetzten Board. Nur die vergessenen Sound-Felder führten dort zu fast völliger Stille.
Die wiederkehrende Grenze ist nicht Verweigerung, sondern Timing. „Biggest problem has been pacing“, schreibt u/Relevant_One_2261. Dialoge, die nicht in die Laufzeit passen, und zu eng gesetzte Zeitstempel sind die häufigsten strukturellen Fehler.
Versprechen 2: Kamerakommandos schlagen Wunschformulierungen
Das bestätigt ein konkreter Framing-Fehler, der sich beheben ließ. Ein Nutzer auf r/StableDiffusion wollte eine gehende Person durchgehend komplett im Bild halten und formulierte schlicht: „entire subject remains visible throughout“. H3 scheiterte damit wiederholt. Erst die Übersetzung des gewünschten Ergebnisses in H3s eigene Kameragrammatik brachte Erfolg:
„The camera pulls out with large amplitude at the same speed as the subject walks forward, maintaining a full-body composition.“ — u/Powerful-Goal52, vom ursprünglichen Poster als funktionierend bestätigt
Das entspricht direkt den drei Kamera-Dimensionen von H3: Bewegungsart, Amplitude und Geschwindigkeit. Zudem gilt pro Shot nur eine Kameraanweisung. Als praktische Übersetzungshilfe:
| Gewünschtes Ergebnis | Kommando, dem H3 folgt |
|---|---|
| Person bleibt beim Gehen vollständig sichtbar | Pull Out mit großer Amplitude in Gehgeschwindigkeit der Person |
| Sanfte Betonung ohne Bruch im Framing | Push In, kleine Amplitude, langsame Geschwindigkeit |
| Umgebung um ein stehendes Motiv enthüllen | Truck Left oder Truck Right, mittlere Amplitude |
| Höhenänderung ohne Neigung | Pedestal Up / Pedestal Down bei langsamer Geschwindigkeit |
Die offizielle Prompt-Anleitung nennt 13 Familien von Bewegungsarten: Zoom, Push, Pull, Pan, Tilt, Truck, Pedestal, Arc, Tracking, Static, Shake, Roll und POV. Jede wird über Amplitude und Geschwindigkeit moduliert. Der Unterschied zwischen Zoom, also einer Brennweitenänderung, und Push, also einer physischen Kamerabewegung, ist in der Praxis relevant; die Begriffe sind nicht austauschbar.
Versprechen 3: Getrennte Audiofelder halten den Ton sauber
Das ist die schwächste Ebene. Die Trennung von diegetischer Klangkulisse und nicht-diegetischer Musik ist sinnvoll gestaltet, wird aber nicht konsistent befolgt:
„I use this, but about 20% of the time it adds music anyway lol“ — u/TheElectriking über
non_diegetic_music: N/A
Der Reddit-Thread mit 220 Upvotes, aus dem dieses Zitat stammt, listet weitere typische Probleme auf: Audioartefakte an Clip-Grenzen, Figuren mit zufälligem Kauderwelsch und die falsche Person, die eine Zeile spricht. u/krigeta1 übergab drei eigene Audio-Referenzen und erhielt „a random voice or not the audio I assign to the characters“. Ein separater Thread löste Dialoge, die trotz sichtbarer Figur als Off-Text gesprochen wurden, indem die Sprecher-ID ausdrücklich an die sichtbare Figur gebunden wurde.
Auch Text im Bild ist ähnlich fragil. Das Community-Wiki bezeichnet „exact text“ als fragil; markenkritische Schriftzüge sollten daher besser als Bildreferenz geliefert oder später in der Postproduktion ergänzt werden. Eine abweichende Einschätzung kommt von @web4miko: In den eigenen Tests könne H3 bei Text und Kontextverständnis „can't even beat Seedance 2.0“. In den zitierten Berichten sind Audio-Routing, exakter Text und dichter Kontext die wiederkehrenden Schwachstellen.
Wann man die offizielle Syntax bewusst brechen sollte
In den zitierten Direktvergleichen und Erfahrungsberichten tauchen drei Abweichungen vom offiziellen Format auf. Sie sollte man kennen, bevor man sich vollständig auf die Struktur festlegt.
Anführungszeichen funktionieren manchmal besser als <d>-Tags. In einem Direktvergleich auf r/StableDiffusion mit etwa 105 Upvotes und 81 Kommentaren stellte das ursprüngliche Poster fest: Entfernte es die vom Guide geforderte Markierung <d>[Language]...台词...</d> und setzte den Dialog einfach in Anführungszeichen, entstand saubere Sprache. Die getaggte Variante fügte dagegen unerwünschtes Audio hinzu. Ein Kommentator mit vergleichbaren Tests stimmte zu:
„the official dialogue prompting is buggy as hell... quotes approach is still not nearly as buggy as the
<d></d>tagging.“ — u/networking_noob
Praktisch heißt das: Zuerst <d> verwenden, denn das ist der trainierte Pfad. Bei verstümmelter oder übermäßig erzeugter Sprache sollte man aber dieselbe Zeile in Anführungszeichen erneut versuchen, statt den kompletten Prompt umzubauen.
non_diegetic_music: N/A ist auch allein ein wirksames Steuerelement. Laut u/Nextil verhindert es Musik „even if you ignore most of the other structure“. Wer nur einen strukturierten Teil des Prompts übernehmen will, sollte diesen wählen: Unerwünschte Musik ist in den zitierten Berichten ein wiederkehrendes Problem.
Bei vielen Referenzen braucht es weniger Text, nicht mehr. Wenn Bilder die Identität und ein Video die Bewegung transportieren, beschränkt sich die Aufgabe des Prompts auf Routing und die neue Aktion. Die meistgeteilten Vorlagen von @aimikoda – eine erhielt mehr als 1.300 Lesezeichen – sind genau deshalb minimalistisch. Und @CharaspowerAI zeigte, wie der Design-Agent von MiniMax eine einzige Zeile, „act as an expert FPV director and turn this into something viral“, automatisch in einen vollständigen strukturierten Prompt erweitert. Ein Referenz-Routing-Block kann so aussehen:
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
Danach beschreibt der Prompt nur noch den neuen Shot. Der praktische Workflow in diesen Berichten: Zuerst die Stills festlegen, Referenzen die Hauptarbeit übernehmen lassen und nur Worte für das einsetzen, was sich ändern soll.
Fehlerdiagnose: Was das Handbuch offenlässt
Die offizielle Prompt-Anleitung endet bei der Syntax. Sie erklärt nicht, was zu tun ist, wenn eine Generation fehlerhaft zurückkommt. Die folgende Tabelle fasst die oben genannten Fehlerberichte zusammen:
| Symptom | Wahrscheinliche Ursache | Lösung |
|---|---|---|
Musik trotz N/A | Ein Nutzer beobachtete Leckagen in etwa 20 % seiner Durchläufe | Neu generieren; nirgends im Prompt eine musikalische „Stimmung“ anfordern |
| Falsche Figur spricht eine Zeile | Konflikt beim Sprecher-Audio-Routing | Sprecher-ID ausdrücklich an die sichtbare Figur im Bild binden |
| Text einer sichtbaren Figur wird als Off-Voice gesprochen | Fehlende Lip-Sync-Zuordnung | Sichtbarkeit der sprechenden Figur nennen; bei echtem Voice-over „lips remain closed“ ergänzen |
| Audio-Referenz wird ignoriert | Über den Limits von 3 Clips / 15 Sekunden oder ohne Zuordnung | Jedem Clip eine Rolle geben; gesamte Referenz-Audiolänge kürzen |
| Lokales Modell ignoriert chinesische Dialoge | ComfyUI verwendete erneut den Qwen-Tokenizer; Shell-Encoding beschädigte den Text | Tokenizer aus dem Repo, wie offiziell verlangt, + Unicode-sichere Übermittlung + <d>[Chinese] 台词</d> (von der Community gemeldeter Fix) |
| Langer One-Shot (>15 s) zerfällt | Außerhalb des für 4–15 s ausgelegten Bereichs; Objekte flachen ab, Kontinuität driftet | In 15-Sekunden-Segmente aufteilen und Kontinuität zwischen ihnen planen |
Der Punkt zur lokalen Bereitstellung verdient besondere Aufmerksamkeit: Im Bericht von @eternityspring ließ sich „H3 won't speak Chinese“ auf wiederverwendeten Tokenizer und Encoding zurückführen – nicht auf den Prompt.
Der Preis der Struktur: Tokens, Iterationen und Portabilität
Struktur gibt es nicht gratis. Das offizielle Repo veröffentlicht den Context-IR-Tokenverbrauch für drei reproduzierbare Fälle. Mit steigender Referenzanzahl wachsen die Werte deutlich:
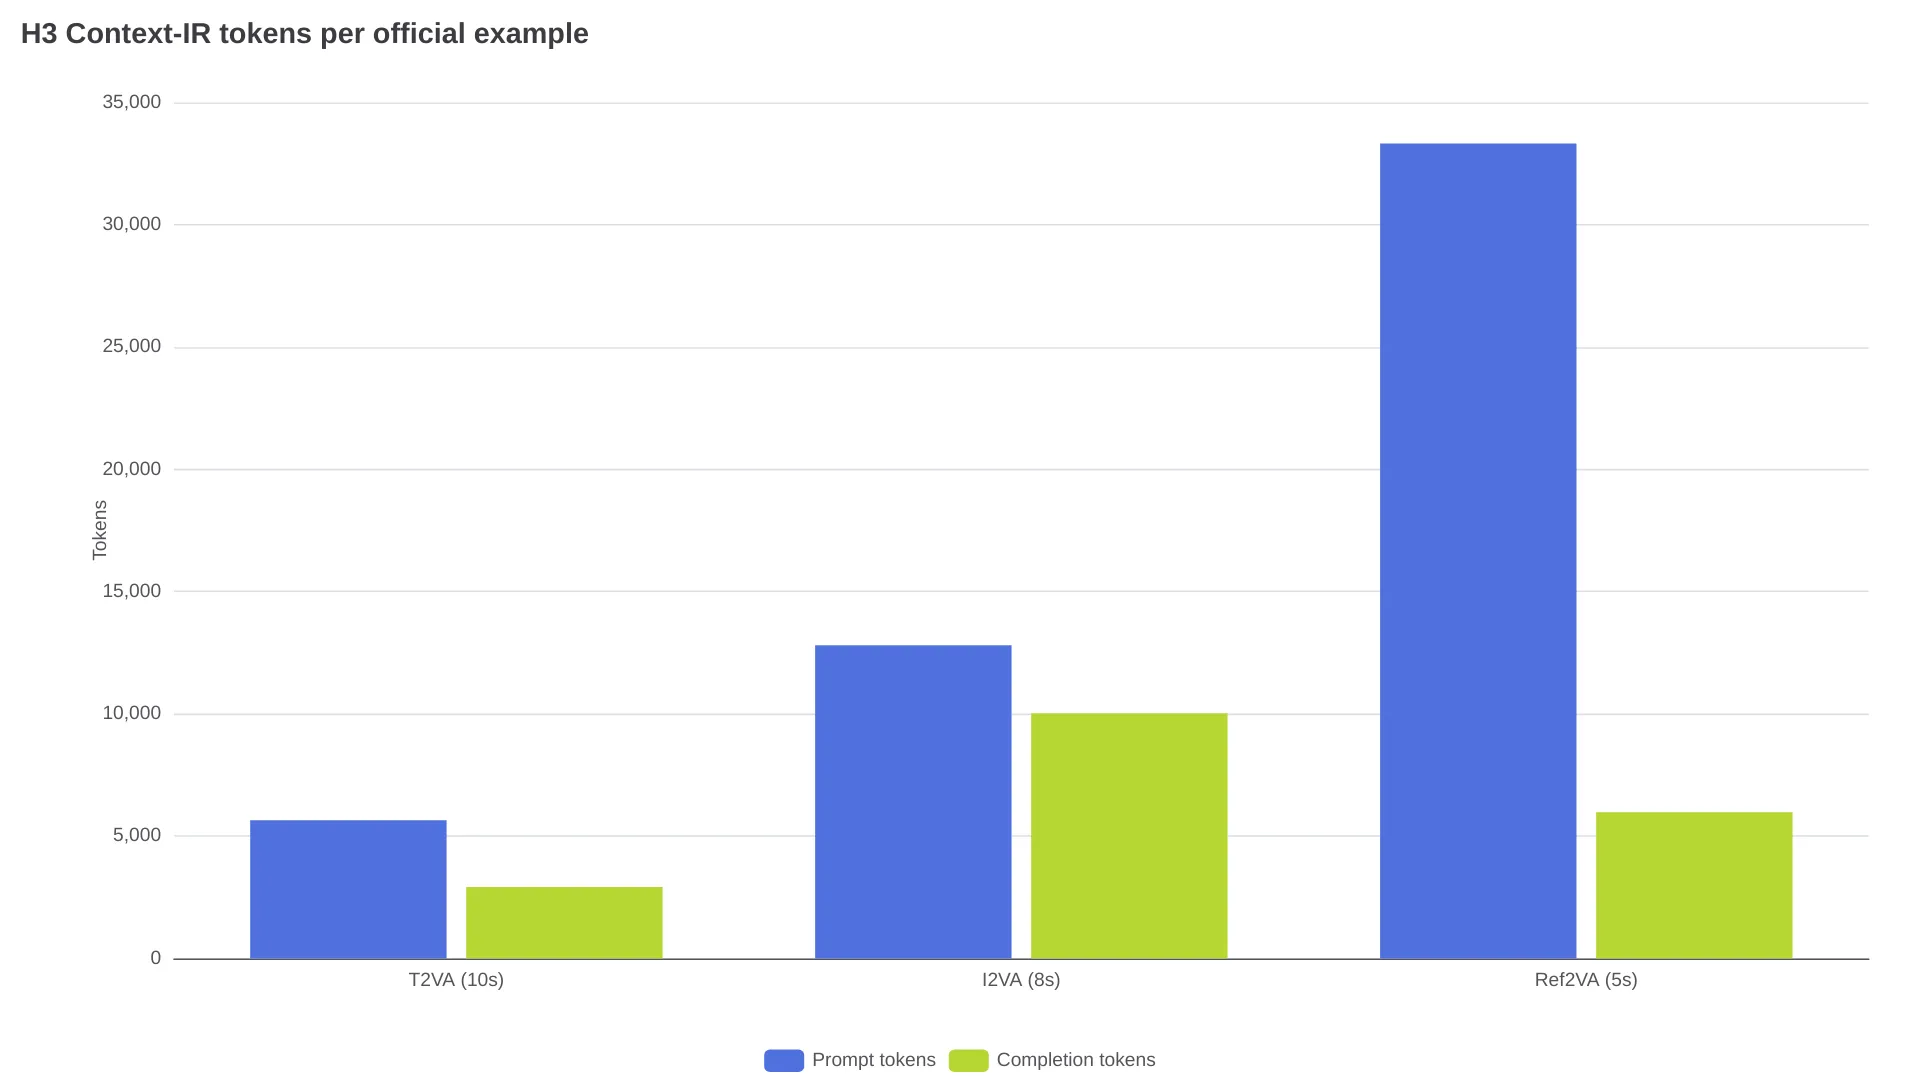
Eine reine Textgenerierung verbraucht 8.565 Preprocessing-Tokens; ein multimodaler Job mit Referenzen kommt auf 39.299, davon 33.323 auf Prompt-Seite. Lokal erhöhen diese Tokens die Vorverarbeitungszeit. In gehosteten Workflows verursachen sie zusätzlichen Verarbeitungsaufwand, auch wenn Preise pro generierter Sekunde angegeben werden. Auch der Zeitaufwand ist real: Ein X-Creator dokumentierte, 48 Stunden an einem einzigen Prompt mit drei Personen und umlaufender Kamera gefeilt zu haben, bis das Ergebnis saß (@LoveUolanda). Günstiger iteriert man bei 768p: Ein 6-Sekunden-Test kostet dort etwa $0.68. Erst der finale Prompt sollte durch 2K laufen. Die Modellseite des Relays nennt für MiniMax H3 $0.1125/s für 768p und $0.1825/s für 2K.
Die letzte versteckte Ausgabe ist die Portabilität. H3s Felder, Sprecher-IDs und Tags sind ein Dialekt, kein Standard. Ein modellübergreifender Walkthrough stellt fest, dass Veo 3.1 einfache Absätze mit eingebetteten SFX:-Labels erwartet, während Seedance 2.0 eine Beschreibung mit sechs Slots nutzt. Keines der beiden Modelle akzeptiert H3s Felder, Sprecher-IDs oder Tags. Eine für H3 aufgebaute Prompt-Bibliothek muss für andere Modelle neu geschrieben werden – Copy-and-paste reicht nicht.
MiniMax H3 Prompt-Test: FAQ
Ist das strukturierte Prompt-Format für MiniMax H3 Pflicht?
Nein. Über die gehostete API überführt Context-IR freie Eingaben in die interne Repräsentation. Besonders wichtig wird die Struktur bei lokalen Open-Weights-Setups sowie für exakte Schnitte, Zeitstempel und Sprecher-Routing.
Wie verhindere ich, dass MiniMax H3 Hintergrundmusik hinzufügt?
Den Prompt mit non_diegetic_music: N/A abschließen und an keiner anderen Stelle eine musikalische Stimmung anfordern. Leckagen kommen trotzdem vor; eine erneute Generierung ist normal.
Wie lang sollte ein MiniMax-H3-Prompt sein?
Die eigenen Beispiele von MiniMax liegen bei 300–700 Wörtern, reines Text-zu-Video akzeptiert bis zu etwa 7.000 Zeichen. Wenn Referenzen Identität und Bewegung tragen, sollten Prompts kürzer werden, nicht länger.
Kann ich H3-Prompts mit Seedance oder Veo wiederverwenden?
Nein. Die benannten Felder, Sprecher-IDs und Tags von H3 sind modellspezifisch. Seedance nutzt ein Sechs-Slots-Format, Veo nimmt einfache Absätze entgegen. Jedes Zielmodell braucht daher seine eigene Überarbeitung.
Warum ignoriert meine lokale H3-Installation nicht-englische Dialoge?
Meist liegt es an der Toolchain, nicht am Modell: Setups mit wiederverwendetem Qwen-Tokenizer oder Shells, die Unicode beschädigen, zerstören den Dialog vor der Generierung. Den offiziellen Tokenizer aus dem Repo und das Dialogformat <d>[Language] verwenden.
Fazit: Für wen sich das Format lohnt
| Dein Einsatz | Urteil |
|---|---|
| Multi-Shot-Film mit Dialogen | Das vollständige Format lernen; Audio-Wiederholungen und die Anführungszeichen-Alternative einplanen |
| Produkt- oder Stillbild-Animation (I2VA) | Die schlanke Variante lernen: Alignment-Satz + Bewegung + Sound-Felder |
| Storyboard- oder Character-Consistency-Serie | Ja – Referenzen übernehmen die Hauptarbeit; Prompts minimal und klar routbar halten |
| Einzelne One-off-Clips, gelegentliche Nutzung | Den Großteil überspringen: einfache Beschreibung + non_diegetic_music: N/A reichen aus |
| Eine modellübergreifende Prompt-Bibliothek aufbauen | Nein – jeder Modell-Dialekt braucht seine eigene Fassung; pro Modell schreiben |
Für Multi-Shot-, zeitcodierte oder referenzgetriebene Arbeit lohnt es sich, das Format zu lernen. Dort ist die Befolgung dokumentiert und reproduzierbar. Für einzelne Clips kann man es weitgehend überspringen. Bei dialoglastigem Audio sollte man eher mit Wiederholungen als mit striktem Befolgen rechnen.
Die Community ist bei diesem Kompromiss selbst gespalten: Im selben Monat gab es einen 48-Stunden-Marathon für einen Kameraprompt und einen Beitrag mit 880 Upvotes, unter dem ein Kommentator schrieb, „reading the manual was actually exciting“. Bis die Audiofelder so zuverlässig befolgt werden wie Kameravorgaben, ist diese Vorgehensweise am praktikabelsten: Die Struktur von einem Agenten entwerfen lassen, die Audiofelder selbst prüfen und zunächst günstig in 768p testen, bevor es an 2K geht.