 AIREITER
Wer vor allem auf die Rechnung schaut, fährt mit DeepSeek V4 Pro besser. Wo jede Sekunde zählt, hat Grok die Nase vorn. Dieses Muster zeigte sich in sieben Aufgaben, die ich über beide APIs laufen ließ. Allerdings warnt DeepSeek auf der eigenen Preisseite bereits vor einer deutlichen Erhöhung – und genau das könnte den Preisvorteil, auf dem diese Empfehlung beruht, weitgehend zunichtemachen.
Was im August 2026 tatsächlich verglichen wird
Beide Modelle haben sich in der Woche vor diesem Vergleich verändert. Grok 4.6 steht nun in xAIs Modelldokumentation im Bereich Latest und wird als Flaggschiff „for code and everything else“ beschrieben. DeepSeek V4 Pro läuft derzeit als Snapshot DeepSeek-V4-Pro-0813. Keiner dieser Wechsel ist an einer API-Modell-ID erkennbar.
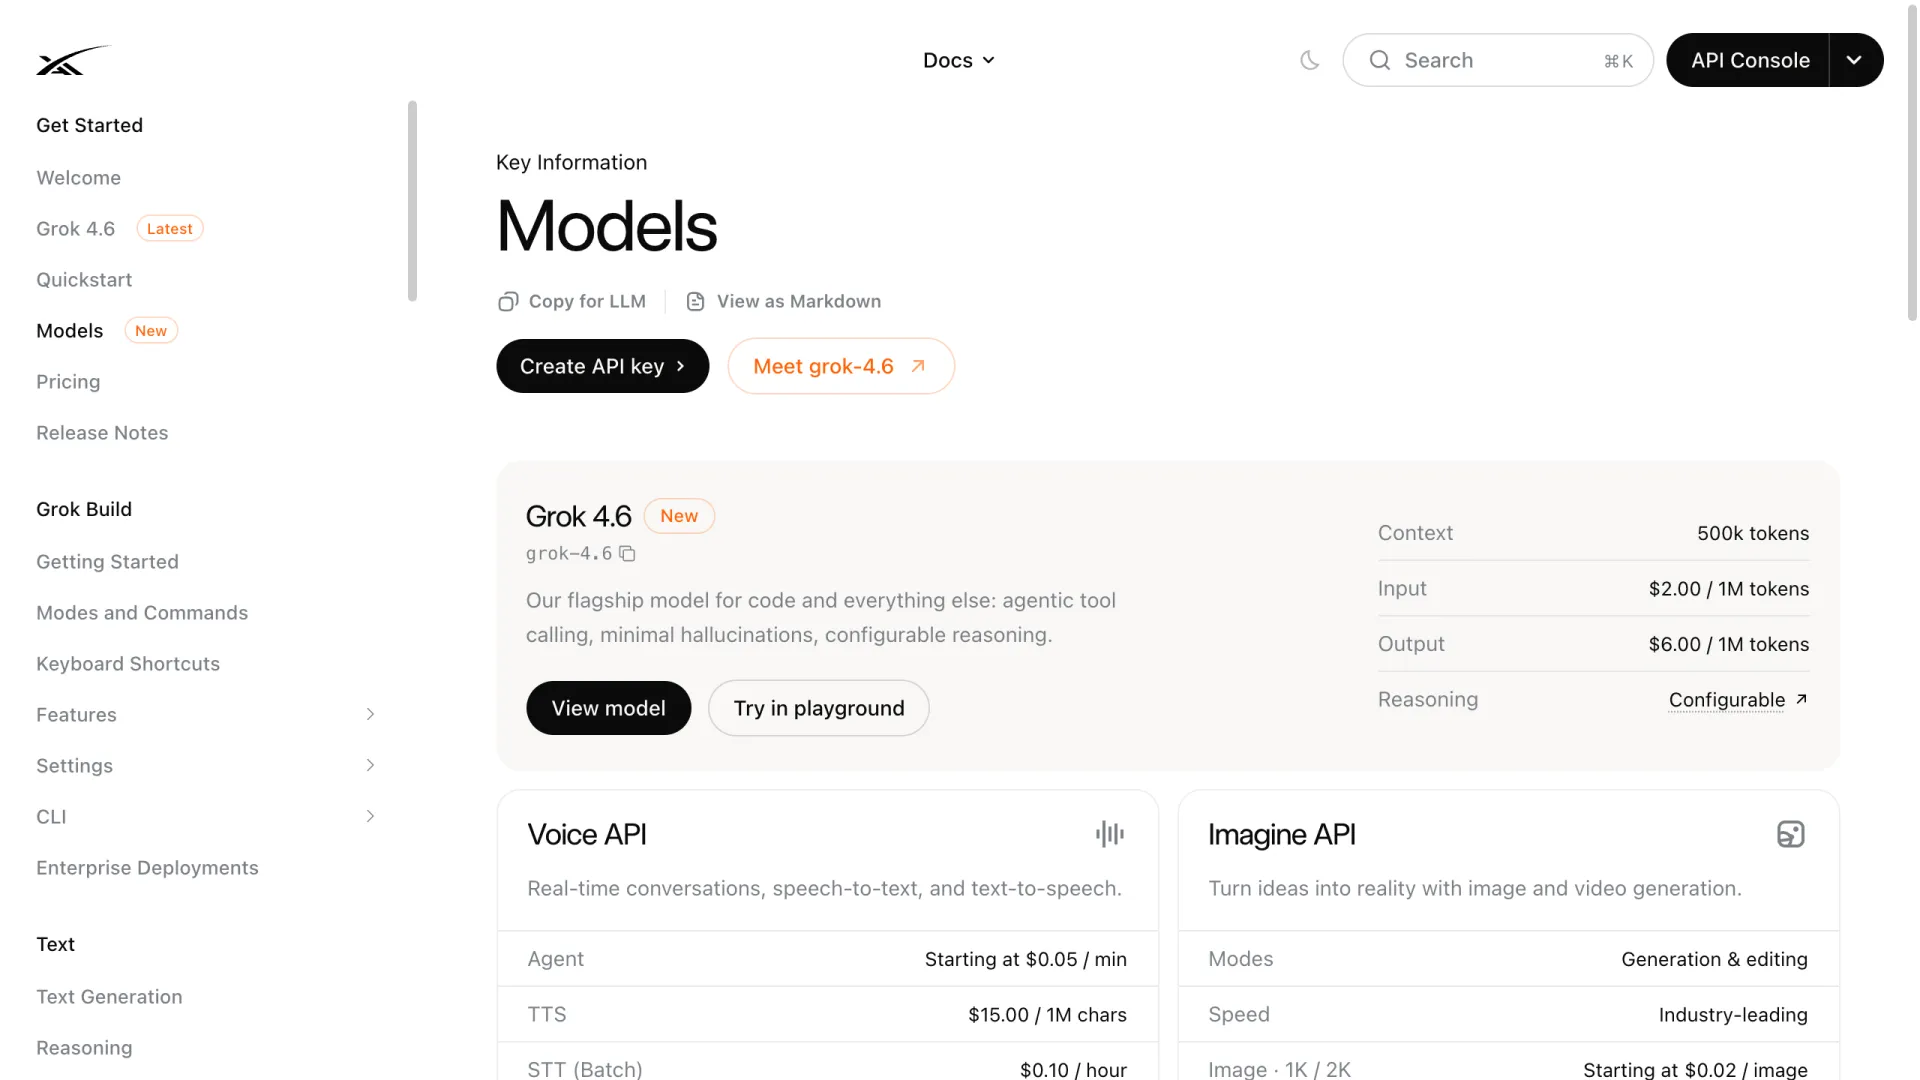
Die DeepSeek-Versionskennung taucht ausschließlich in der Zeile MODEL VERSION auf der Preisseite auf. Die API reagiert weiterhin schlicht auf deepseek-v4-pro, ohne Datumszusatz. Eine Anfrage von heute sieht in den Logs also genauso aus wie eine aus dem Juli – obwohl im Hintergrund möglicherweise andere Weights laufen.
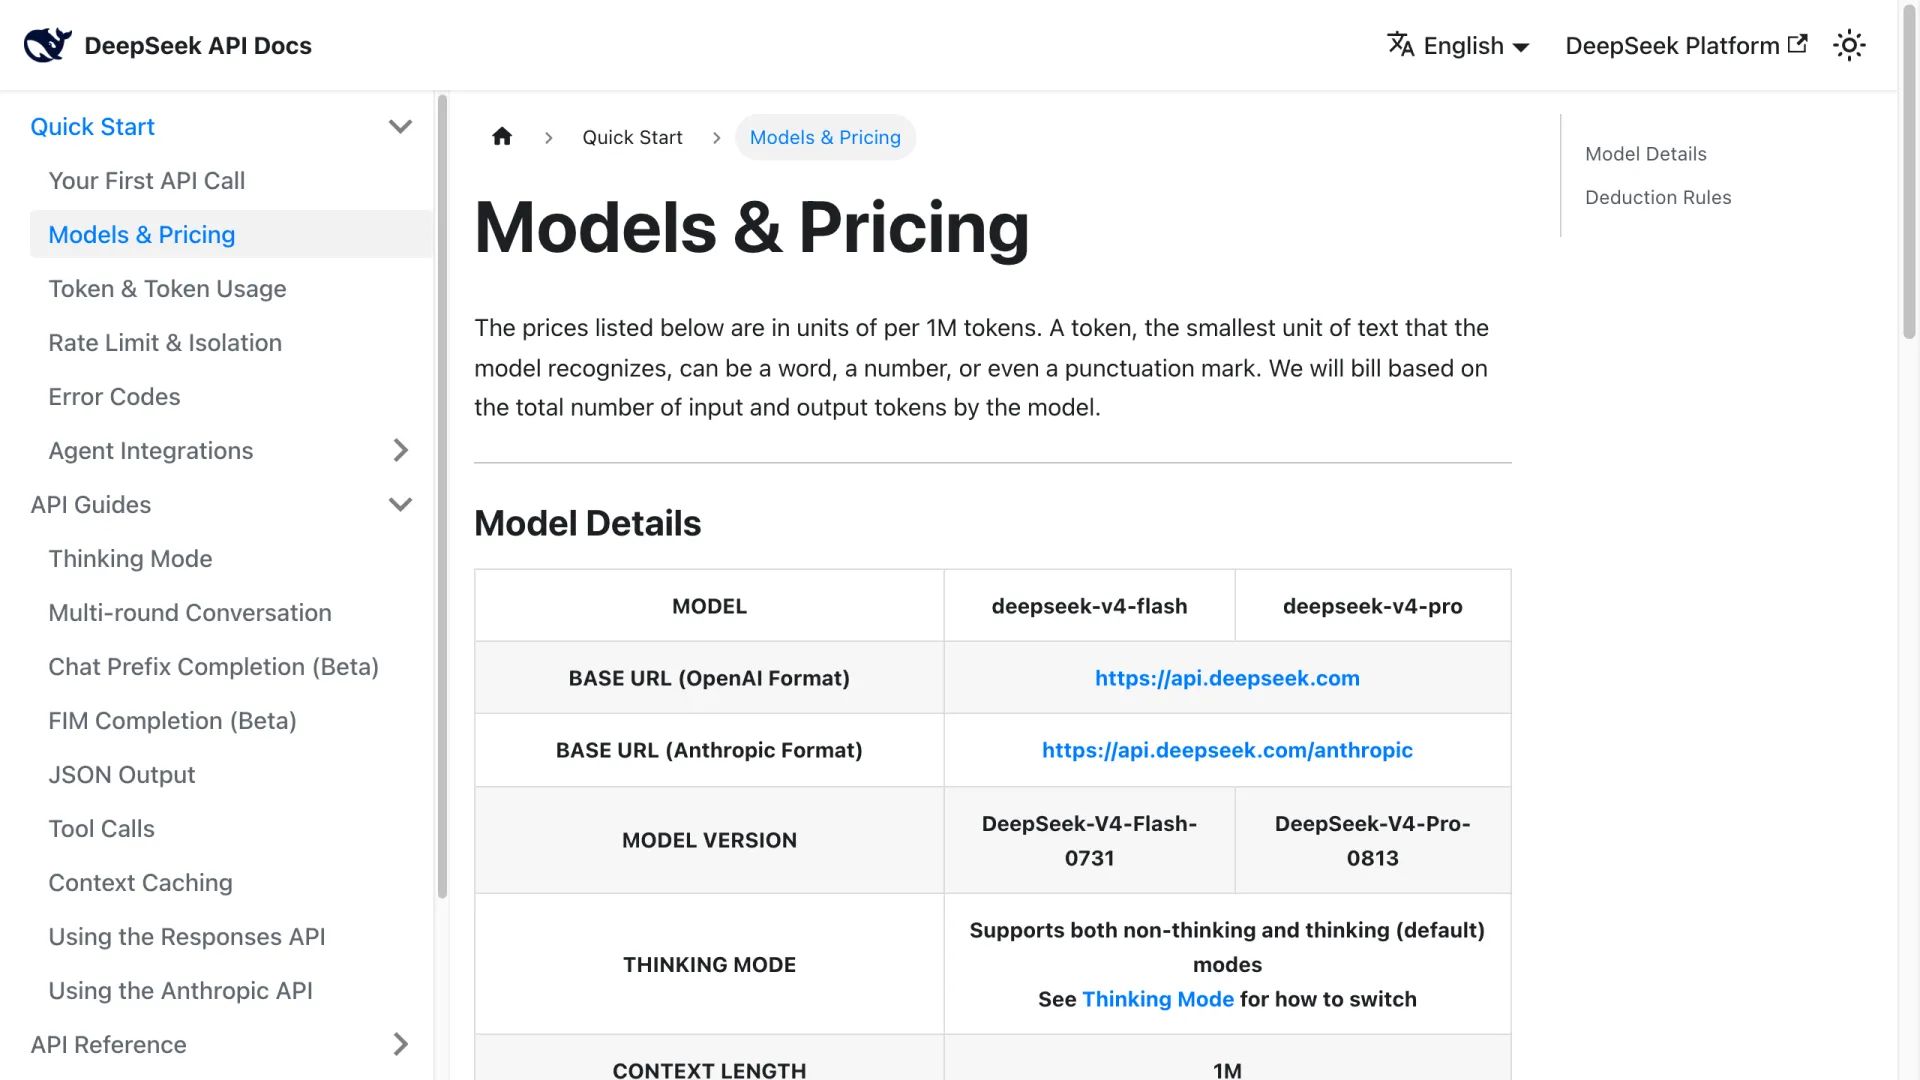
Hier der vollständige Vergleich von Spezifikationen und Preisen, übernommen von xAIs Preisseite und DeepSeeks Preisseite am 13. August 2026:
| Grok 4.6 | DeepSeek V4 Pro (0813) | |
|---|---|---|
| Kontextfenster | 500K | 1M |
| Maximaler Output | Nicht veröffentlicht | 384K |
| Input / 1M | $2.00 | $0.435 |
| Gecachter Input / 1M | $0.50 | $0.003625 |
| Output / 1M | $6.00 | $0.87 |
| Preis bei langem Kontext | 2x alle Tarife ab ≥200K Prompt | Keiner |
| Bildeingabe | Ja | Nein |
| Tool-Aufrufe | Ja | Ja |
| Reasoning | Konfigurierbar | Thinking / non-thinking |
| Knowledge Cutoff | 1. Februar 2026 | Nicht veröffentlicht |
Bei Grok 4.6 bleiben die Kernpreise von Grok 4.5 unverändert: $2.00 für Input und $6.00 für Output. Verändert hat sich nur der Preis für gecachten Input. In derselben xAI-Tabelle stehen für Grok 4.5 noch $0.30, für Grok 4.6 dagegen $0.50. Cache-Nutzung ist beim neueren Modell damit 67% teurer.
Viele Drittanbieter liefern noch Grok 4.5 aus
Dass ein Modell in xAIs Dokumentation steht, heißt nicht automatisch, dass es überall verfügbar ist, wo man Tokens einkauft. Beim getesteten Gateway lieferte grok-4.6 einen model_not_found-Fehler. Die Aliasse grok-latest und grok lösten beide zu grok-4.5-build auf. Wer Grok über einen Reseller statt über xAIs eigene API bezieht, sollte daher prüfen, welches Modell sich tatsächlich hinter dem Alias verbirgt.
Dieser Rückstand ist auch der Grund, warum die Messungen unten mit grok-4.5 statt 4.6 durchgeführt wurden. Da beide Versionen dieselben Input- und Output-Preise haben, lassen sich die Kostenschlüsse übertragen. Die Genauigkeitswerte pro Aufgabe gelten jedoch für 4.5.
Bei exakten Vorgaben trennen sich die Wege
In sieben maschinell prüfbaren Aufgaben lagen die Modelle sechs Mal gleichauf; eine Aufgabe brachte einen deutlichen Unterschied ans Licht. Gefordert waren exakt vier Zeilen, die jeweils mit einer Beschreibung aus genau fünf Wörtern enden. DeepSeek V4 Pro bestand alle 5 von 5 Versuchen, Grok keinen einzigen der 5 Versuche.
Groks Fehlschläge waren nicht einfach derselbe Fehler in Serie. In zwei Durchläufen erschien ein roher web_search-Tool-Aufruf als Antworttext statt einer eigentlichen Antwort. Einer davon lautete vollständig: „I need accurate information on the four stages of canary deployment. Let me search for that.“ Zwei weitere Durchläufe lieferten zwar vier Zeilen, verzählten sich bei den Beschreibungen aber auf vier beziehungsweise sechs Wörter. Ein Versuch lief 130 Sekunden und erzeugte 10,357 Output-Tokens, am Ende standen 331 Zeilen.
Das Durchsickern des Tool-Aufrufs dürfte eher am Gateway als am Modell liegen: Ein Prompt mit 6 Tokens wurde als Input mit 201 Tokens ausgewiesen. Das deutet auf ein eingeschleustes Präambel hin, das xAIs serverseitige Tools deklariert. Die Fehler beim Wortzählen sind davon unabhängig. Diese Antworten wurden normal ausgegeben und verletzten die Vorgabe trotzdem.
Methode: deepseek-v4-pro und grok-4.5 liefen über dasselbe OpenAI-kompatible Gateway mit den Standardeinstellungen. Pro Aufgabe gab es einen Durchlauf, ausgenommen die Formataufgabe mit jeweils fünf Durchläufen. Jede Aufgabe hatte eine maschinell prüfbare Lösung; ein Judge-Modell kam bei der Bewertung nicht zum Einsatz. Die sechs Aufgaben mit Gleichstand stehen namentlich in der Kostentabelle weiter unten.
Beide Modelle übernahmen eine falsche Annahme
Die siebte Aufgabe enthielt absichtlich zwei falsche Angaben: DeepSeek V4 Pro habe ein Kontextfenster von 128K, und Grok 4.6 sei im Januar 2026 mit 2M Kontext gestartet. Anschließend fragte ich, welches Modell sich für einen Korpus mit 900,000 Tokens eigne. Keines von beiden hinterfragte die Zahlen. Beide leiteten aus den falschen Angaben sauber eine selbstsichere Empfehlung für Grok ab.
Wer veraltete Spezifikationen in einen Prompt kopiert und daraufhin um eine Empfehlung bittet, bekommt von beiden Modellen eine gut begründete falsche Antwort – keine Korrektur der Eingabe.
Weniger Output-Tokens, trotzdem 5,7-mal höhere Kosten bei Grok
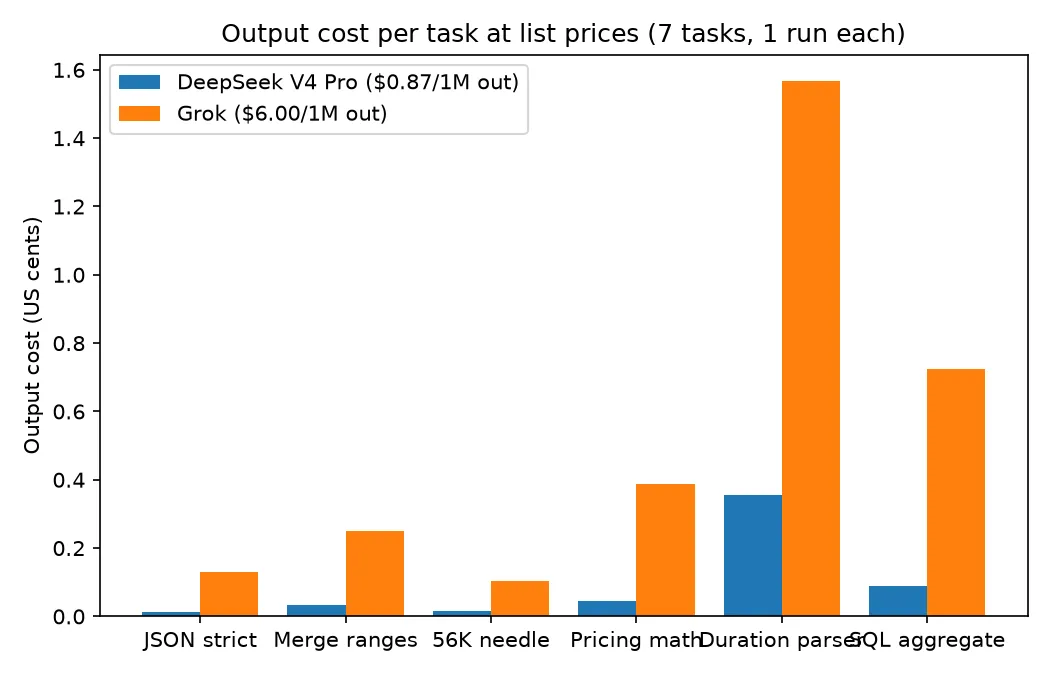
Über die sechs Aufgaben, die beide Modelle erledigten, erzeugte Grok 5,275 Output-Tokens gegenüber 6,331 bei DeepSeek – also 17% weniger. Nach den offiziellen Output-Preisen kosteten dieselben Antworten bei Grok $0.0317 und bei DeepSeek $0.0055. Trotz der geringeren Tokenzahl war Grok damit 5,7-mal teurer.
| Aufgabe | DeepSeek-Tokens | Grok-Tokens | DeepSeek-Kosten | Grok-Kosten |
|---|---|---|---|---|
| Striktes JSON | 147 | 219 | 0.013¢ | 0.131¢ |
| Bereiche zusammenführen | 384 | 416 | 0.033¢ | 0.250¢ |
| 56K-Nadel | 181 | 174 | 0.016¢ | 0.104¢ |
| Preisrechnung | 520 | 647 | 0.045¢ | 0.388¢ |
| Duration-Parser | 4,087 | 2,611 | 0.356¢ | 1.567¢ |
| SQL-Aggregat | 1,012 | 1,208 | 0.088¢ | 0.725¢ |
| Gesamt | 6,331 | 5,275 | 0.551¢ | 3.165¢ |
Die bessere Token-Effizienz ist real, reicht aber nicht aus: Beim Duration-Parser war Grok deutlich knapper und kam mit 2,611 statt 4,087 Tokens aus. Trotzdem kostete diese Antwort viermal so viel.
Auf einen Arbeitsmonat hochgerechnet lässt sich die Rechnung leicht nachvollziehen: 1,000 Anfragen mit jeweils 50,000 ungecachten Input-Tokens und 3,000 Output-Tokens ergeben 50M Input und 3M Output. Bei Grok 4.6 sind das $100.00 plus $18.00, zusammen $118.00. Bei DeepSeek V4 Pro stehen $21.75 plus $2.61, also $24.36.
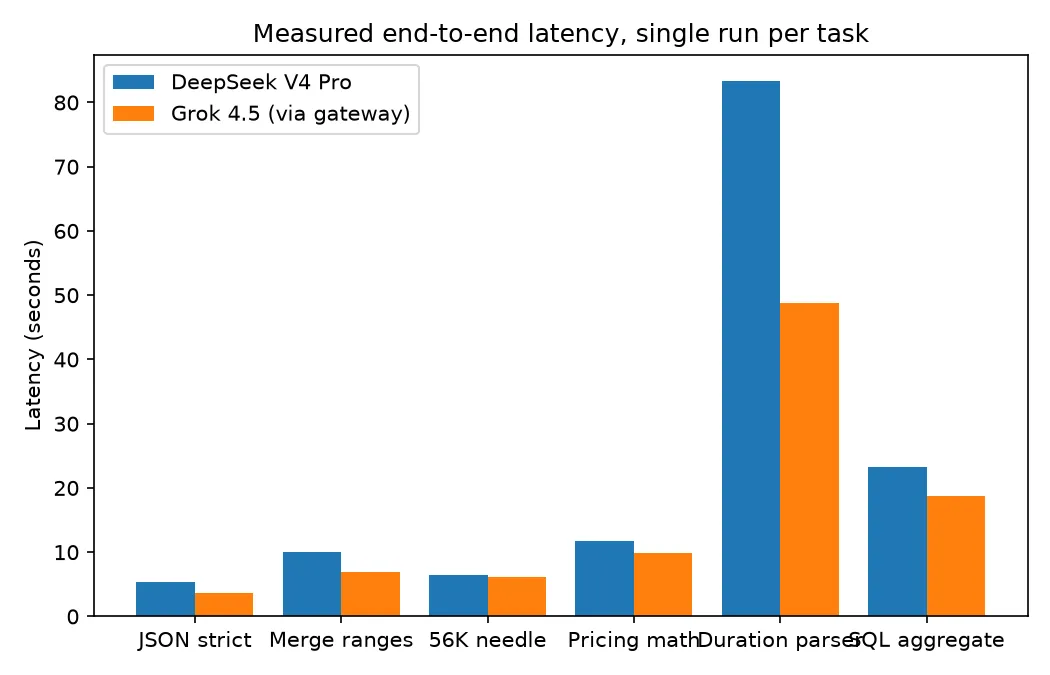
Grok war bei allen sechs Aufgaben schneller, und bei längeren Aufgaben wurde der Abstand größer: Beim Duration-Parser 48.8 gegenüber 83.3 Sekunden, bei der JSON-Aufgabe 3.7 gegenüber 5.4 Sekunden. Das sind Einzelmessungen über ein gemeinsam genutztes Gateway. Kleine Abstände sollte man daher als Rauschen behandeln, der große Vorsprung zeigt aber eine klare Richtung.
Zwei Abrechnungsregeln, die in keiner Spezifikationstabelle stehen
Zwei Preismechaniken beeinflussen die tatsächliche Rechnung stärker als die beworbenen Tarife – und beide fehlen in üblichen Spezifikationstabellen.
xAIs Langkontext-Schwelle ist eine Klippe, keine Rampe. Sobald ein Prompt 200,000 Tokens erreicht, gelten für jeden Token dieser Anfrage doppelte Preise – nicht nur für die Tokens oberhalb der Schwelle. Ein Prompt mit 199,000 Tokens kostet beim Input $0.398, einer mit 201,000 Tokens $0.804. Wer die Grenze um 1% überschreitet, verdoppelt die Rechnung.
DeepSeeks Cache kostet fast nichts. Ein Cache-Hit kostet $0.003625 pro 1M Input-Tokens, bei Grok 4.6 sind es $0.50 – also etwa das 138-Fache. Bei wiederholter Arbeit mit einer stabilen Codebasis ist das die Zahl, die über die Rechnung entscheidet. Ein Entwickler schrieb auf Hacker News:
DeepSeeks offizielle API erreicht eine Cache-Hit-Rate von über 99%, wenn man über lange Sessions hinweg kontinuierlich mit derselben Codebasis arbeitet. Dadurch ist sie viel günstiger als Frontier-Modelle. Ich habe ein Beispiel für eine 200M-Token-Session in claude code.
Der Haken: DeepSeeks Preise sind ausdrücklich vorläufig. Auf der Preisseite steht in einer Fußnote: „We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected.“ Eine Aufschlüsselung auf Hacker News zu DeepSeeks Aktionspreisen beziffert die Preise vor dem Rabatt auf $1.74 für Input und $3.48 für Output. Die Rechnung ist stimmig, denn $0.435 und $0.87 entsprechen exakt einem Viertel dieser Werte. DeepSeek selbst hat allerdings keine Bedingungen für die Aktion veröffentlicht.
Falls die Erhöhung auf diese Werte kommt, steigt das Monatsszenario oben von $24.36 auf $97.44, während Grok bei $118.00 bleibt. Beim Output schrumpft der Preisabstand von 6.9x auf etwa 1.7x – und eine reine Preisentscheidung wird nicht mehr so eindeutig.
Welches Modell für welchen Einsatz?
DeepSeek V4 Pro eignet sich für hohe Volumina, knappe Budgets und wiederkehrenden Kontext: Batch-Verarbeitung, lange agentische Coding-Sessions in einem Repository und alles oberhalb von ungefähr 200K Tokens pro Prompt, wo Groks Schwelle den Preis verdoppelt. Das 1M-Kontextfenster und der nahezu kostenlose Cache spielen hier zusammen für DeepSeek. Zudem hielt das Modell die exakte Formatvorgabe in allen fünf Versuchen ein. Direkt nutzen lässt es sich über die DeepSeek V4 Pro API page.
Grok 4.6 ist die bessere Wahl für latenzkritische und multimodale Aufgaben. Grok war bei jeder Aufgabe schneller, wobei sowohl diese Messung als auch das Formatergebnis mit 4.5 und nicht mit 4.6 ermittelt wurden. Es akzeptiert Bildeingaben, DeepSeek nicht, und sein veröffentlichter Knowledge Cutoff vom 1. Februar 2026 ist zumindest bekannt. Wer ein Gateway nutzt, sollte kontrollieren, ob tatsächlich 4.6 statt 4.5 ausgeliefert wird. Grok on AIReiter und jeder andere Reseller hängen von der Version ab, die upstream angebunden ist.
Keines der beiden Modelle sollte allein wegen eines angekündigten Preises gewählt werden. DeepSeeks eigene Fußnote macht den heutigen Vorteil zur beweglichen Zielmarke, während Groks Preis für gecachten Input von 4.5 auf 4.6 bereits um 67% gestiegen ist. Vor der Festlegung auf einen Workload sollte man die obige Rechnung mit den aktuellen Preisen erneut durchführen.
FAQ
Ist Grok 4.6 wirklich veröffentlicht?
Ja. Stand 13. August 2026 erscheint Grok 4.6 in xAIs Modelldokumentation an der Latest-Position, mit veröffentlichten Preisen von $2.00 für Input und $6.00 für Output pro 1M Tokens sowie einem Kontextfenster von 500K. Drittanbieter-Gateways können grok-latest weiterhin auf Grok 4.5 routen.
Was ist DeepSeek-V4-Pro-0813?
Das ist die Modellversionskennung, die DeepSeek aktuell hinter dem API-Endpunkt deepseek-v4-pro ausliefert. Sie steht in der Zeile MODEL VERSION auf der offiziellen Preisseite. Die API-ID enthält kein Datum, weshalb sich der Snapshot ändern kann, ohne dass sich die Anfrage selbst verändert.
Welches Modell hat das größere Kontextfenster?
DeepSeek V4 Pro: 1M Tokens gegenüber 500K bei Grok 4.6. DeepSeek veröffentlicht zudem einen maximalen Output von 384K; xAI nennt für Grok 4.6 keinen maximalen Output-Wert.
Ist DeepSeek V4 Pro günstiger als Grok 4.6?
Zu den Listenpreisen vom 13. August 2026: ja. Beim Input ist DeepSeek 4.6-mal günstiger, beim Output 6.9-mal. DeepSeeks Preisseite warnt jedoch vor einer deutlichen Erhöhung. Bei den von Entwicklern identifizierten Preisen vor der Aktion würde der Abstand beim Output auf ungefähr 1.7x sinken.
Welches Modell befolgt Anweisungen zuverlässiger?
Im einzigen Test mit einem klaren Unterschied erfüllte DeepSeek V4 Pro die exakte Formatvorgabe in 5 von 5 Versuchen, Grok in 0 von 5. Beide Modelle versäumten es, absichtlich in einen Prompt eingebaute falsche Spezifikationen zu korrigieren.
Weiterführend: GPT-5.6 Luna vs DeepSeek V4 Pro