 AIREITER
Bei unseren drei identischen API-Aufgaben lieferten GPT-5.6 Luna und DeepSeek V4 Pro jeweils drei richtige Ergebnisse. Die reine Modellqualität dürfte bei dieser Entscheidung also selten den Ausschlag geben. Wichtiger sind Latenz und Preislogik – zumal DeepSeek auf der eigenen Preisseite bereits eine deutliche kommende Preiserhöhung ankündigt. Das haben wir am 10. August 2026 gemessen und daraus lässt sich die Modellwahl ableiten.
Drei identische API-Aufgaben im Praxistest
Am 10. August 2026 haben wir beide Modelle über dieselbe API-Pipeline mit ihren Standardeinstellungen getestet. Auf dem Plan standen ein Python-Bugfix mit absichtlich knapper Anweisung ("reply with the corrected function only"), ein Lkw-Planungsproblem mit drei Laderampen und genau einer richtigen Lösung (10:10) sowie eine strikt schema-konforme JSON-Extraktion mit einem nullable Feld. GPT-5.6 Luna und DeepSeek V4 Pro lösten alle drei Aufgaben korrekt.
| Aufgabe | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
Python-Bugfix für merge_intervals | Korrekt (max()-Fix), 10,7 s | Korrekt (max()-Fix), 16,1 s |
| Planungslogik für Laderampen | Korrekt (10:10), 8,0 s | Korrekt (10:10), 27,2 s |
| Strikte JSON-Extraktion | Valide, schema-exakt, 3,0 s | Valide, schema-exakt, 7,6 s |
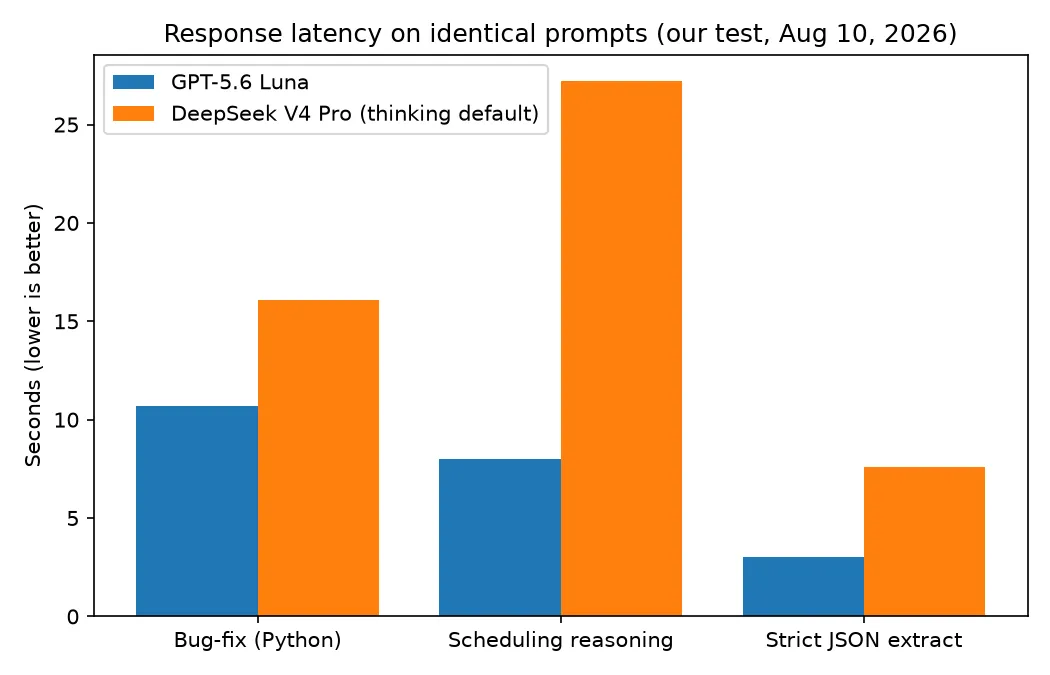
Zwei Einschränkungen und zwei Details sind dabei wichtig. Der Test umfasst nur drei Aufgaben und ist kein Benchmark. V4 Pro arbeitet standardmäßig im Thinking-Modus, was den hier gemessenen Latenzunterschied von etwa dem Zwei- bis Dreifachen größtenteils erklärt. Der Modus lässt sich pro Anfrage deaktivieren, allerdings auf Kosten der Leistung bei anspruchsvoller Logik. Bei der Befolgung von Anweisungen gab Luna wie verlangt nur die Funktion zurück; V4 Pro setzte sie in einen Markdown-Codeblock. Im Chatfenster ist das harmlos, in einer Pipeline bedeutet es einen zusätzlichen Parsing-Schritt. Zur Stabilitätsprüfung haben wir die Planungsaufgabe einmal wiederholt: Beide Modelle antworteten erneut mit 10:10.
Offizielle API-Preise – inklusive DeepSeeks Erhöhungswarnung
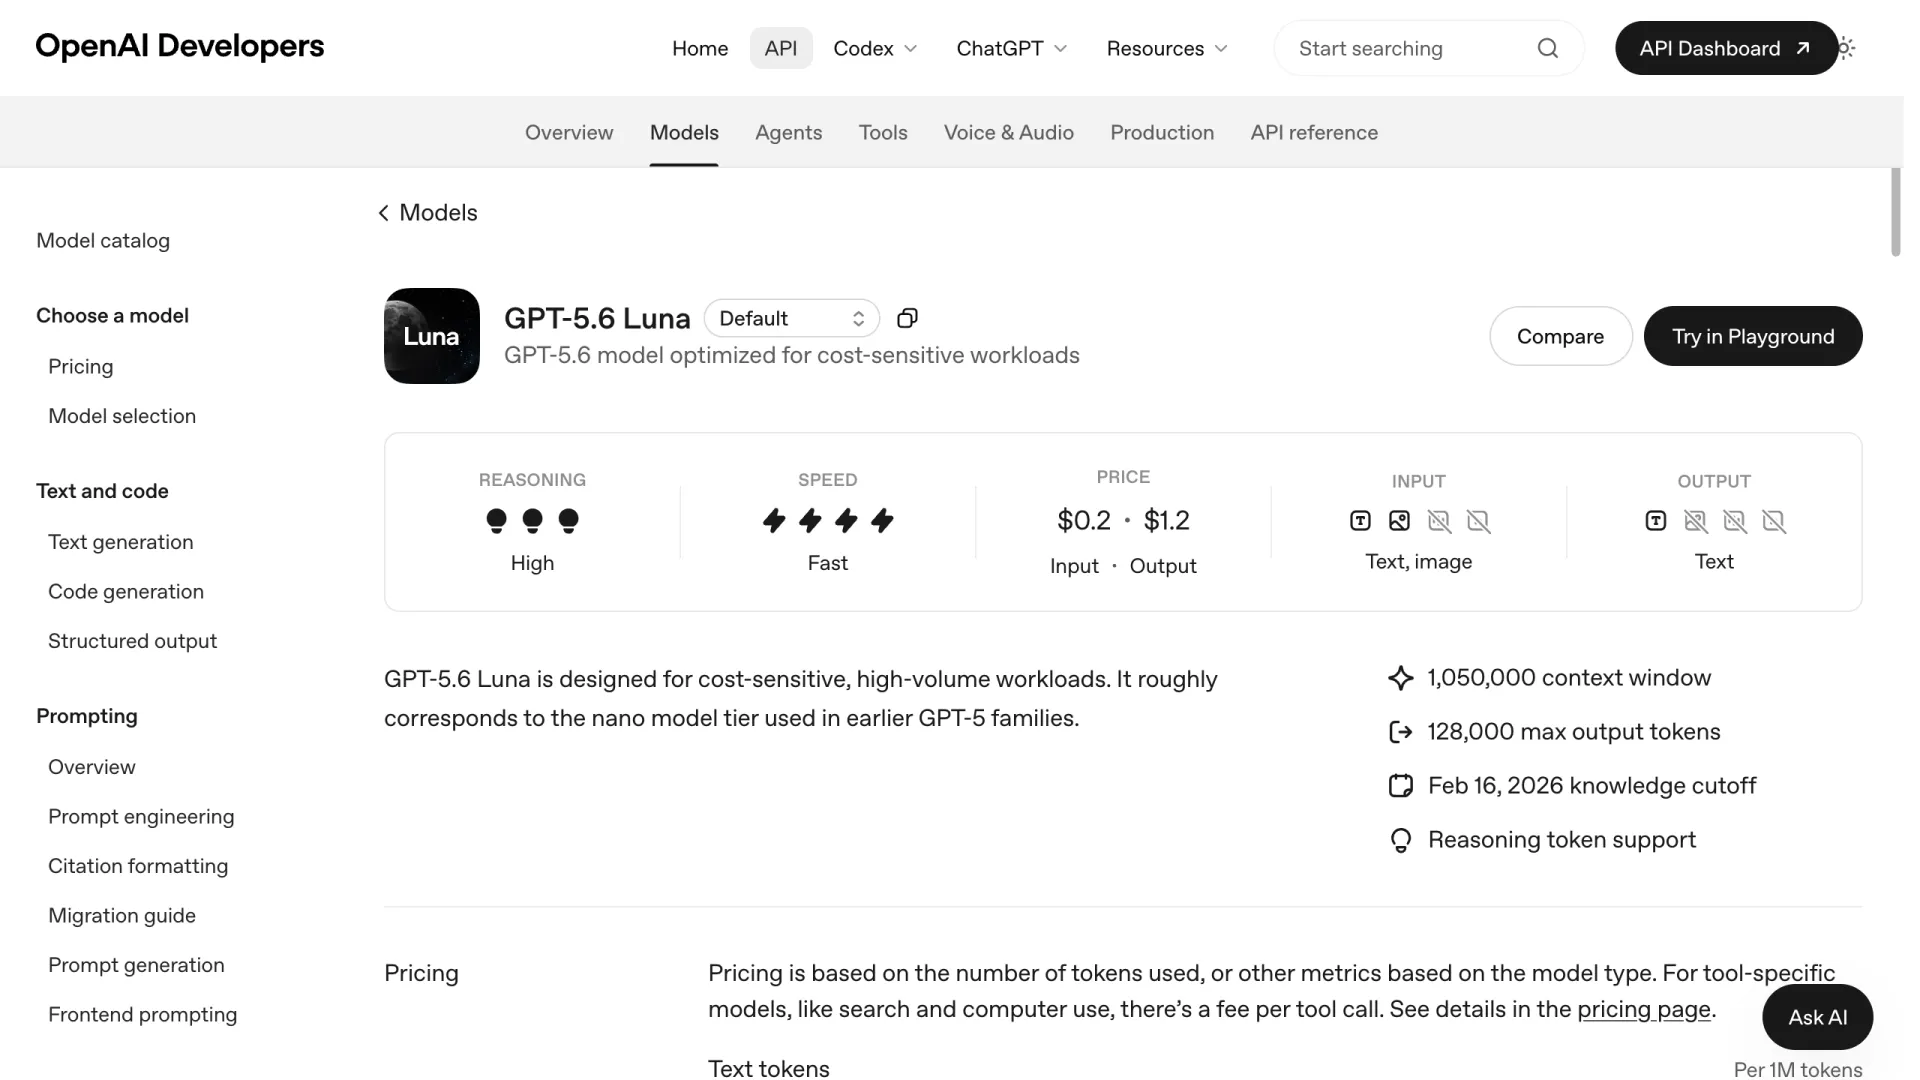
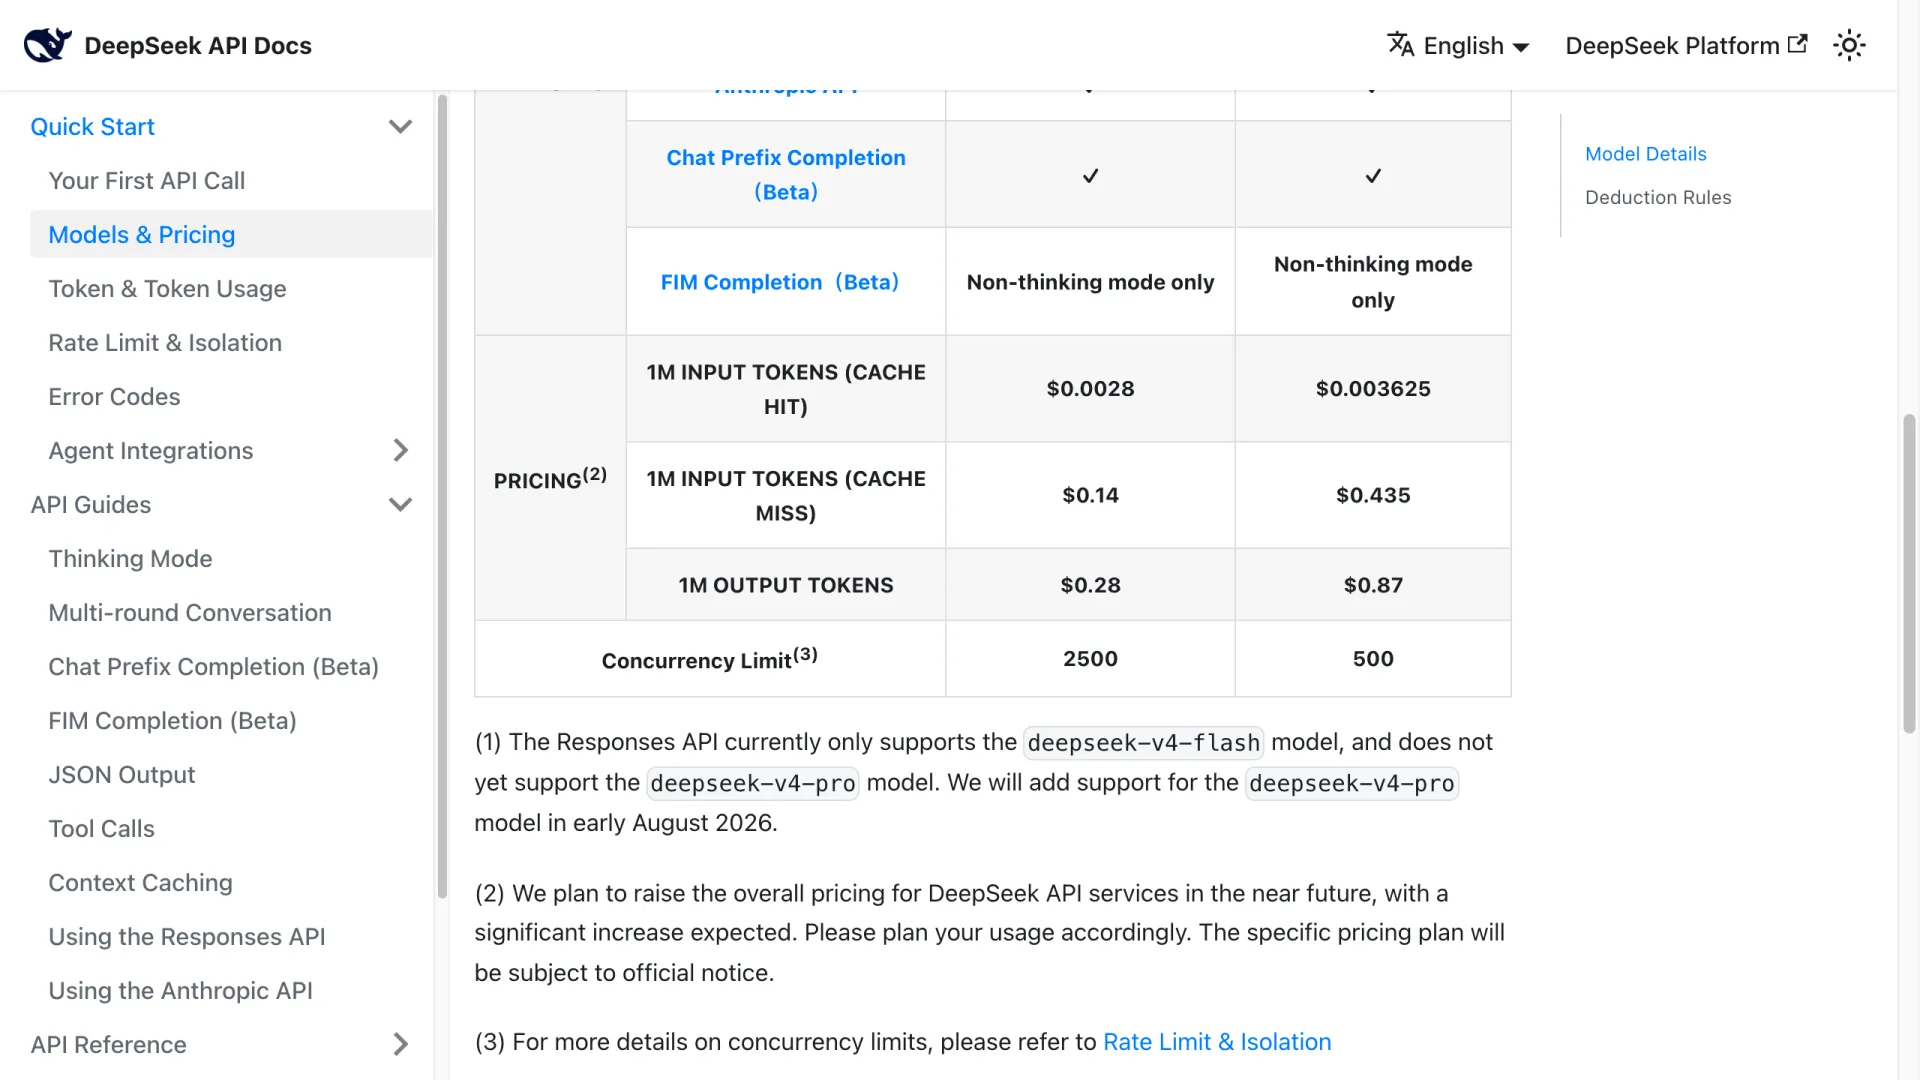
Abgleich mit den offiziellen Seiten beider Anbieter am 10. August 2026: GPT-5.6 Luna kostet 0,20 $ pro Million Input-Tokens, 0,02 $ für gecachte Tokens und 1,20 $ für Output-Tokens (OpenAI-Modellseite). Bei DeepSeek V4 Pro liegen die Preise bei 0,435 $ pro Million Input-Tokens bei einem Cache Miss, 0,003625 $ bei einem Cache Hit und 0,87 $ für Output-Tokens (DeepSeek-Preisseite).
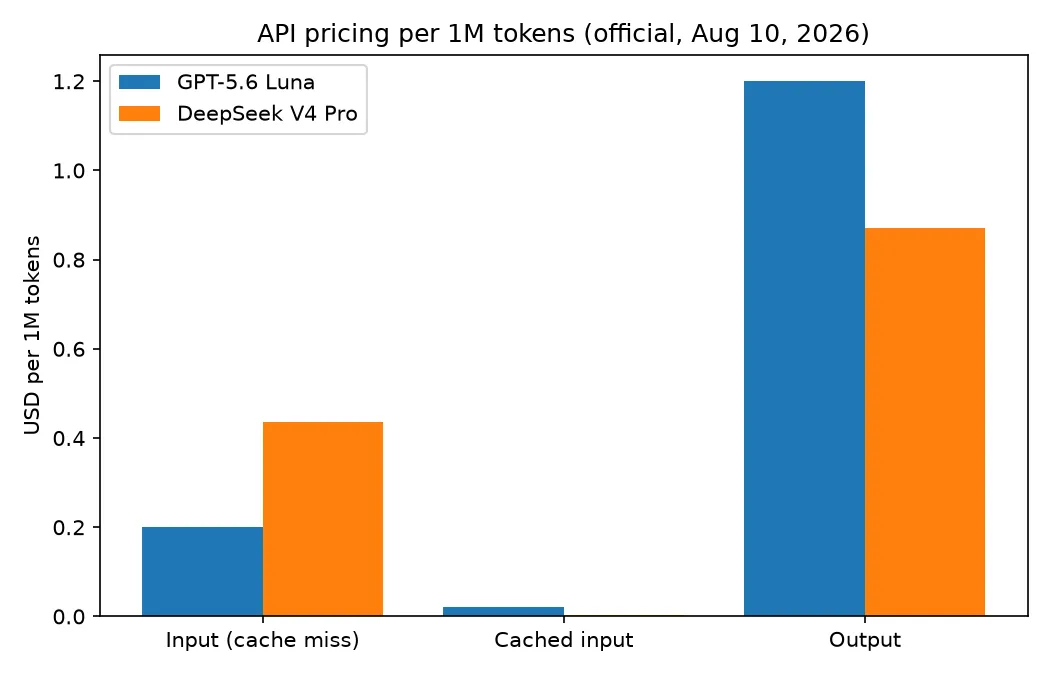
Pauschal ist damit keines der beiden Modelle günstiger. Lunas ungecachter Input kostet 54 % weniger, V4 Pros Output 27 % weniger, und bei Cache Hits ist V4 Pro 5,5-mal günstiger als Luna. Entscheidend ist also der Token-Mix:
- Interaktiver Chat (1K Input + 500 Output pro Aufruf): Luna 0,0008 $ gegenüber V4 Pro mit 0,00087 $ – praktisch Gleichstand.
- Repository-Review (50K neuer Input + 3K Output): Luna 0,0136 $ gegenüber V4 Pro mit 0,0244 $ – Luna ist 44 % günstiger.
- Agent-Loop (200K gecachter + 20K neuer Input + 10K Output pro Iteration): Luna 0,020 $ gegenüber V4 Pro mit 0,018 $. Hier übernimmt V4 Pro die Führung, die mit jeder weiteren gecachten Iteration wächst.
Ein weiterer Punkt begrenzt die Aussagekraft dieser Rechnung zeitlich. Fußnote 2 auf DeepSeeks Preisseite lautet: "We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected." Einen Termin oder konkrete Zahlen nennt DeepSeek nicht. Wer V4 Pro vor allem wegen des Preises einplant, sollte diese offizielle Warnung aber berücksichtigen. Bei Luna geht die Entwicklung in die andere Richtung: Das Modell erschien zusammen mit OpenAIs GPT-5.6-Preissenkung im August.
Cache-lastige Agenten: Hier punktet V4 Pro
Für gecachten Input berechnet DeepSeek V4 Pro 0,003625 $ pro Million Tokens, Luna dagegen 0,02 $. Der Faktor 5,5 dominiert die Kosten bei Agent-Workloads, wenn jede Schleifeniteration einen langen, unveränderten Kontext erneut einliest. Auch Entwickler mit Agenten-Setups weisen darauf hin:
DeepSeek v4 Pro & MiMo v2.5 Pro ... are insanely cheap for agent-driven work due to their super low cached-input prices ($0.0036/mtok). For Luna, the cached-input price ... the pricing page puts it at $0.02/mtok, & that's 5x more expensive. — Hacker-News-Kommentator, im Thread zum GPT-5.6-Launch
Bei Luna sollte man außerdem den Aufpreis für das Schreiben in den Cache einplanen: Cache Writes werden mit dem 1,25-Fachen des ungecachten Input-Preises abgerechnet (OpenAI-Modellseite). Bei Prompts mit mehr als 272K Input-Tokens werden für die gesamte Anfrage der doppelte Input-Preis und der 1,5-fache Output-Preis fällig. Überschreitet dein Agent-Kontext regelmäßig 272K Tokens, verdoppelt sich Lunas effektiver Preis damit ungefähr genau in dem Bereich, in dem V4 Pros Caching besonders stark wird.
Kostenmodelle immer mit den offiziellen Dokumentationen abgleichen
Bei der Recherche zu diesem Vergleich fanden wir Drittanbieterangaben, die für V4 Pro zwischen 0,435 $ und 1,74 $ pro Million Input-Tokens nannten. Beim Kontextfenster von Luna reichten die Angaben von 400K bis 1,05M. Drei Prüfungen dauern weniger als eine Minute: Preise nur auf den beiden oben verlinkten offiziellen Seiten nachsehen, den Modellversions-String prüfen (die aktuelle API liefert DeepSeek-V4-Pro; Flash ist auf -0731 festgelegt) und klären, ob sich ein zitierter „Input-Preis“ auf Cache Hit oder Cache Miss bezieht. Bei V4 Pro liegen diese Werte um den Faktor 120 auseinander.
Die Specs, die über den passenden Workload entscheiden
Neben dem Preis sind vier Unterschiede ausschlaggebend: Output-Limit, Modalitäten, offene Gewichte und API-Umfang. Beide Modelle werben mit einem Kontextfenster von rund 1M Tokens – Luna mit 1.050.000, V4 Pro mit 1M. Allein daran lässt sich die Wahl also nicht festmachen.
| Spezifikation (geprüft am 10. Aug. 2026) | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
| Kontextfenster | 1.050.000 | 1M |
| Maximale Output-Tokens | 128K | 384K |
| Input-Modalität | Text + Bild | Nur Text |
| Reasoning-Steuerung | Effort-Stufen (niedrig→maximal) | Thinking an (Standard) / aus |
| Open Weights | Nein | Ja (selbst hostbar) |
| Responses API | Ja | Noch nicht (offiziell: Anfang Aug. 2026) |
| Concurrency-Limit | Abhängig vom Usage Tier | 500 |
| Knowledge Cutoff | 16. Feb. 2026 | Auf der Preisseite nicht angegeben |
Mit 384K Output-Tokens liegt V4 Pro beim Ausgabelimit dreimal über Lunas 128K. Das ist relevant für die Generierung ganzer Codebasen in einem Durchlauf, lange Übersetzungen oder umfangreiche strukturierte Extraktion, bei denen Aufteilen zusätzliche Fehlerquellen schafft. Lunas Bild-Input ist aus einem anderen Grund relevant – und DeepSeek-Nutzer nennen den fehlenden Support von sich aus:
My only real complaint is that they can't do images, which limits their ability to autonomously debug some kinds of issues. — Hacker-News-Kommentator, über DeepSeek für Hobbyprojekte
Bei offenen Gewichten dreht sich das Bild: V4 Pro lässt sich herunterladen und selbst hosten. Damit ist es hier die einzige Option für Anforderungen an Datenresidenz – wobei der Betrieb eines Modells dieser Größe ernsthafte Multi-GPU-Hardware erfordert und kein Wochenendprojekt ist.
Effort-Modus beeinflusst Benchmarks stärker als die Modellwahl
Veröffentlichte Benchmarks für GPT-5.6 Luna und DeepSeek V4 Pro können unterschiedliche Sieger ausweisen, je nachdem, mit welchem Effort-Modus getestet wurde. Auf einem Tracker, der Luna mit niedrigem Effort gegen V4 Pro mit maximalem Effort laufen lässt, steht es 33,3 zu 44,3 für V4 Pro. Bei Artificial Analysis, wo beide mit maximalem Effort getestet werden, gewinnt Luna mit 52 zu 45. Keines der Ergebnisse ist falsch – gemessen werden unterschiedliche Konfigurationen.
Dieselbe Falle steckt in Latenzangaben. Artificial Analysis beziffert Lunas Time-to-First-Answer-Token bei maximalem Effort auf 132 Sekunden: In diesem Modus denkt Luna ungefähr zwei Minuten nach, bevor die Antwort beginnt. In unserem Test mit Standardeinstellungen antwortete Luna nach 3 bis 10,7 Sekunden. Beides sind reale Werte, aber nur einer davon entspricht wahrscheinlich deiner Produktionskonfiguration. Sobald Luna mit der Ausgabe beginnt, ist der Durchsatz deutlich höher: 202 Tokens/s gegenüber 78 bei V4 Pro (Artificial Analysis).
Auch innerhalb eines Modells verschieben Effort-Modi die Ergebnisse massiv: V4 Pro erreicht bei GPQA Diamond mit maximalem Thinking 90,1 %, mit deaktiviertem Thinking jedoch 72,9 %. In gemeinsamen Max-Effort-Benchmarks führt Luna bei SWE-Bench Pro mit 62,7 % zu 55,4 %; bei BrowseComp liegen beide praktisch gleichauf (83,3 gegenüber 83,4). Bevor du einem Scoreboard vertraust, solltest du drei Fragen stellen: Welcher Effort-Modus lief? Enthält die Latenzangabe die Thinking-Zeit? Und sind die Benchmark-Versionen identisch? Der Unterschied von 84,7 zu 67,9 bei Terminal-Bench auf einem Tracker vergleicht etwa v2.1 mit v2.0.
Welches Modell solltest du einsetzen?
Für nutzernahe Produkte ist GPT-5.6 Luna die passendere Wahl: In unserem Test war es bei allen drei Aufgaben mit Standardeinstellungen zwei- bis dreimal schneller, ungecachter Input kostet etwa halb so viel wie bei V4 Pro, und Bilder werden unterstützt. DeepSeek V4 Pro eignet sich besser für cache-intensive Agent-Loops, Ausgaben über 128K Tokens und alle Szenarien, die auf eigener Hardware laufen müssen. Für langfristige Entscheidungen gehört jedoch DeepSeeks offizielle Preiserhöhungswarnung in die Kalkulation. Über GPT-5.6 Luna und DeepSeek V4 Pro trennt beide nur ein Endpoint-Wechsel – teste deshalb unsere drei Prompts mit deinem eigenen Workload, bevor du dich festlegst.
| Dein Workload | Empfehlung | Entscheidender Punkt |
|---|---|---|
| Chatbots, nutzernahe Apps | Luna | 3,0–10,7 s gegenüber 7,6–27,2 s Latenz in unserem Test; 202 gegenüber 78 Tok./s |
| Verarbeitung großer Mengen neuen Inputs | Luna | 0,20 $ gegenüber 0,435 $ pro 1M ungecachte Input-Tokens |
| Agent-Loops mit stabilem Kontext | V4 Pro | 0,003625 $ gegenüber 0,02 $ pro 1M gecachte Input-Tokens |
| Lange Ausgaben in einem Durchlauf | V4 Pro | 384K gegenüber 128K maximaler Output |
| Vision (Screenshots, PDFs als Bilder) | Luna | V4 Pro verarbeitet nur Text |
| Self-Hosting / Datenresidenz | V4 Pro | Open Weights; Luna gibt es nur per API |
| Planbare Kosten bis 2027 | Luna | DeepSeeks offizielle Ankündigung einer Preiserhöhung |
FAQ
Was ist günstiger: GPT-5.6 Luna oder DeepSeek V4 Pro?
Keines der Modelle ist durchgehend günstiger. Lunas ungecachter Input kostet 54 % weniger (0,20 $ gegenüber 0,435 $ pro 1M Tokens). V4 Pro ist bei gecachtem Input 5,5-mal günstiger (0,003625 $ gegenüber 0,02 $) und beim Output 27 % günstiger (0,87 $ gegenüber 1,20 $). Cache-intensive Agenten laufen mit V4 Pro günstiger, Workloads mit viel neuem Input mit Luna.
Unterstützen beide Modelle ein Kontextfenster von 1M Tokens?
Ja. Luna bietet 1.050.000 Tokens, V4 Pro 1M. Beachte bei Luna: Anfragen mit mehr als 272K Input-Tokens werden für die gesamte Anfrage mit dem doppelten Input-Preis und dem 1,5-fachen Output-Preis abgerechnet.
Ist DeepSeek V4 Pro Open Source und lässt es sich selbst hosten?
Ja. V4 Pro wird mit offenen Gewichten ausgeliefert und kann selbst gehostet werden, anders als das reine API-Modell Luna. Plane dafür aber Multi-GPU-Hardware für den Betrieb ein, nicht nur einen einzelnen Arbeitsplatzrechner.
Unterstützt GPT-5.6 Luna Bild-Input?
Ja, Luna akzeptiert Text- und Bild-Input. DeepSeek V4 Pro verarbeitet ausschließlich Text. Eigene Nutzer nennen den fehlenden Vision-Support als zentrale Einschränkung für autonome Debugging-Workflows.
Wie viele Output-Tokens können die Modelle maximal erzeugen?
DeepSeek V4 Pro kann pro Antwort bis zu 384K Tokens ausgeben, GPT-5.6 Luna maximal 128K. Für die Generierung langer Dokumente oder großer Codedateien in einem Durchlauf liegt V4 Pros Limit damit dreimal höher.
Weiterführende Artikel
- DeepSeek V4 Pro vs GPT-5.6 Sol: DeepSeeks Flaggschiff im Vergleich mit OpenAIs mittlerer Modellklasse
- GPT-5.6 Luna im Test: Luna für sich betrachtet, über diesen Direktvergleich hinaus
- DeepSeek V4 Flash vs V4 Pro: wenn das Preisrisiko von V4 Pro für eine kleinere Modellklasse spricht