 AIREITER
Haiku 5.5 kostet ein Zwanzigstel von Sonnet 5.5 – solange der Prompt unter 100.000 Tokens bleibt. Danach schrumpft der Abstand auf den Faktor 4, und agentische Schleifen überschreiten diese Grenze schneller, als viele Teams erwarten. Für kurze, wiederholbare API-Aufgaben reicht Haiku 5.5 meist aus. Beim Debugging und mehrstufigen Programmieren rechtfertigt Sonnet 5.5 dagegen weiterhin seinen Aufpreis.
Der Preisvorteil beträgt 20x – bis zur 100K-Klippe
Claude Haiku 5.5 und Claude Sonnet 5.5 bieten auf dem Papier dieselbe Kapazität, erzeugen aber sehr unterschiedliche Rechnungen. Beide Modelle unterstützen ein Kontextfenster von 1M Tokens und maximal 128K Tokens Ausgabe. Ihre Model-IDs lauten claude-haiku-5-5 und claude-sonnet-5-5. Sonnet 5.5 startete am 28. September 2026, Haiku 5.5 folgte am 7. Oktober 2026 – laut Anthropics Ankündigung zu Haiku 5.5 und Anthropics Ankündigung zu Sonnet 5.5. Auch die Claude-Plattformdokumentation zu Sonnet 5.5 nennt 1M Kontext und 128K maximale Ausgabe.
| Spezifikation | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Model-ID | claude-haiku-5-5 | claude-sonnet-5-5 |
| Veröffentlichung | 7. Okt. 2026 | 28. Sept. 2026 |
| Kontext / maximale Ausgabe | 1M / 128K | 1M / 128K |
| Input / Output unter 100K | $0.10 / $0.50 pro 1M | $2 / $10 pro 1M |
| Input / Output bei Prompt über 100K | $0.50 / $2.50 pro 1M | $2 / $10 pro 1M (keine Stufe) |
| Cache-Lesevorgänge | $0.01 pro 1M | $0.10 pro 1M |
| Standard-Effort | medium | high |
Bei den Preisen handelt es sich um die Listenpreise von Anthropic. Sobald ein Prompt mehr als 100.000 Tokens enthält, rechnet Haiku 5.5 die gesamte Anfrage nach der höheren Stufe ab – einschließlich Cache-Lese- und Schreibvorgängen. Das geht aus APIKOs Zusammenfassung der Anthropic-Preise hervor.
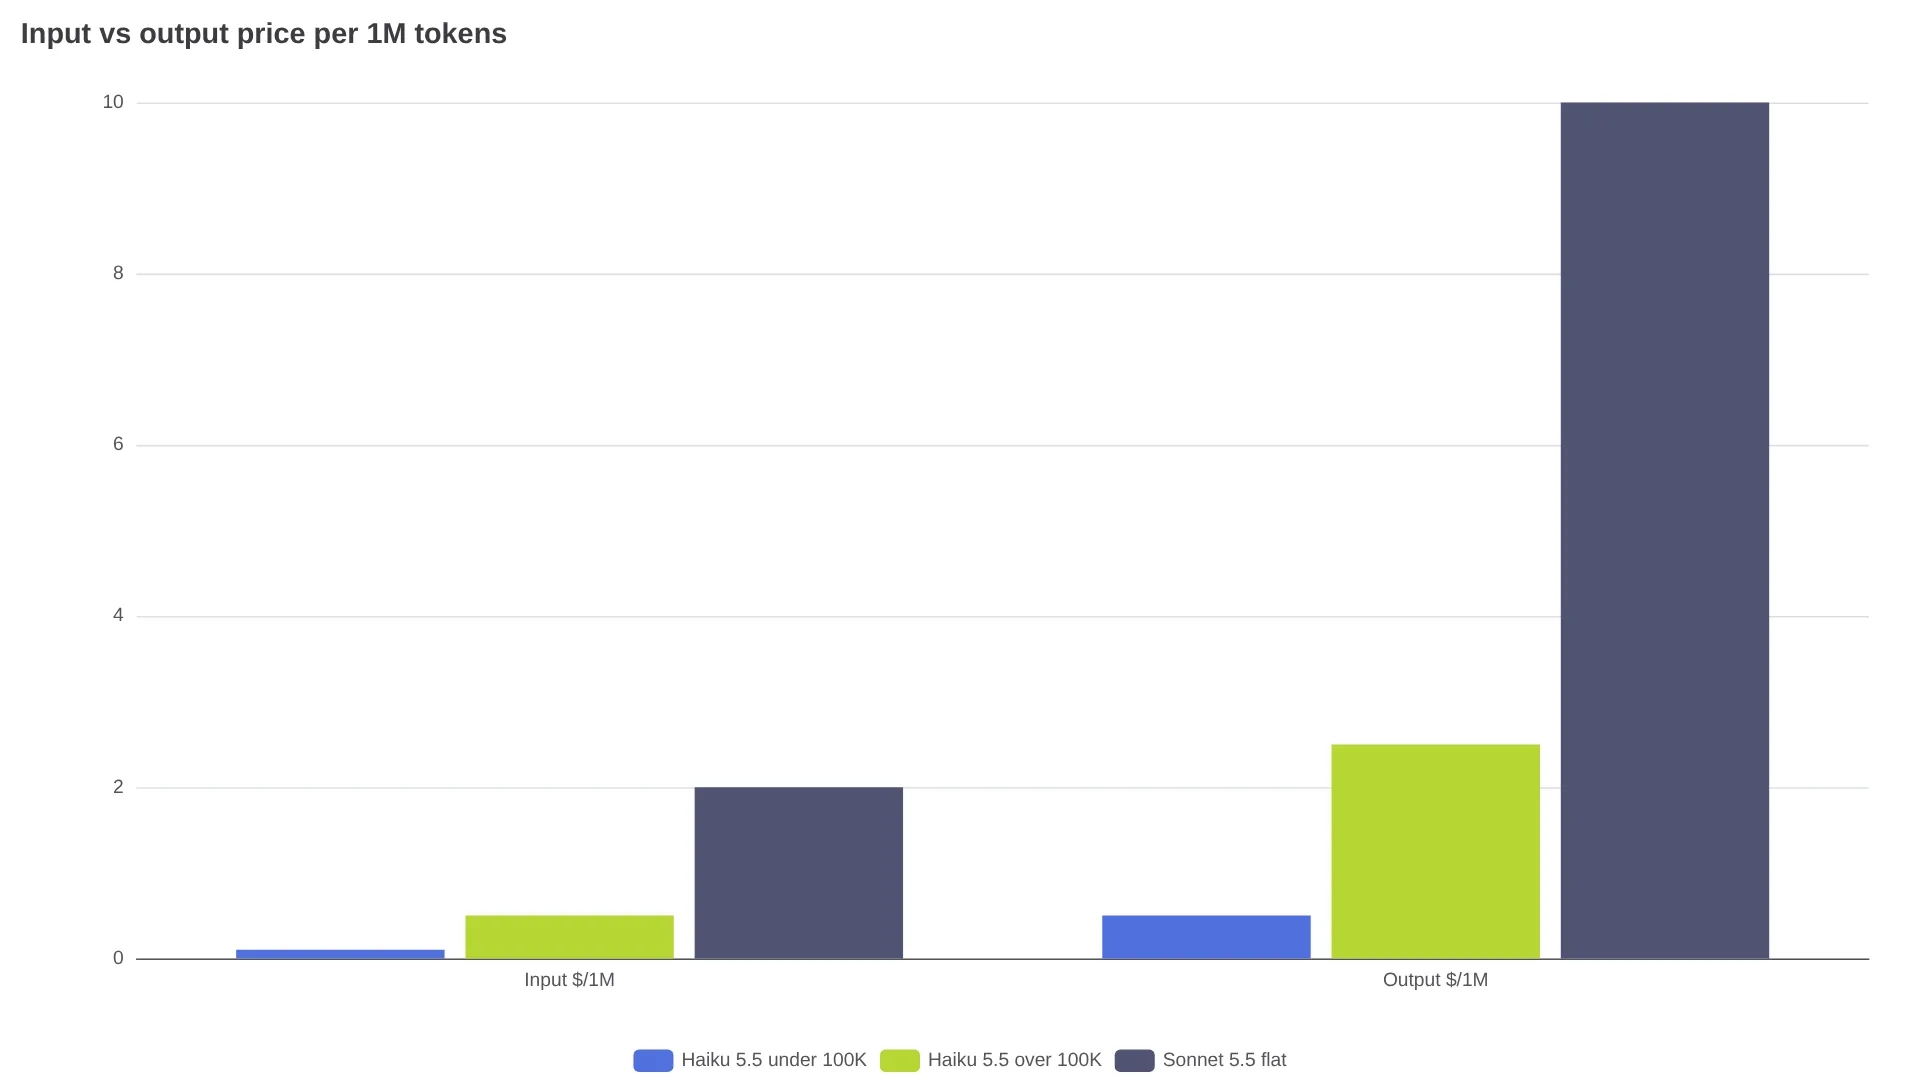
Bei 1.000 identischen Dokumenten mit jeweils 99K Tokens Input und 1K Tokens Output kostet der Batch zum Listenpreis rund $10.40 (APIKO nennt für denselben Batch zu seinen Konditionen $4.54). 1.000 Dokumente mit jeweils 101K Tokens schlagen dagegen mit rund $53.00 zu Buche – fünfmal so viel für gerade einmal 2.000 zusätzliche Tokens pro Dokument. Derselbe 101K-Batch kostet mit Sonnet 5.5 etwa $212.00. Die Rechnung basiert auf den von APIKOs Haiku-5.5-vs.-Sonnet-5.5-Test genannten Listenpreisen. Ein modellierter Batch aus 1.000 Aufrufen mit jeweils 10K Input- und 1K Output-Tokens kostet bei Sonnet 5.5 insgesamt $30.00, bei Haiku 5.5 dagegen $1.50 – eine Ersparnis von 95 Prozent laut Sims Preisvergleich von Sonnet 5.5 und Haiku 5.5.
Agentische Schleifen überschreiten die Grenze oft ganz nebenbei. In einem r/ClaudeAI-Thread zum Token-Verbrauch von Haiku 5.5 stellte ein Nutzer fest, dass seine Läufe ungefähr beim zwanzigsten Modellaufruf die 100K-Marke überschritten. 145 der folgenden 164 Aufrufe wurden bereits nach der höheren Stufe berechnet, weil Verlauf und Tool-Ausgaben immer weiter anwuchsen. Als Gegenmaßnahmen wurden in dem Thread kleinere Aufgabenpakete, ein gezielterer Dateiumfang, weniger Testausgabe und frische Subagenten statt einer einzigen langlebigen Unterhaltung empfohlen. Kurze Jobs bleiben mit Haiku günstig. Für Pipelines mit langem Kontext muss Sonnet ins Budget.
"Der günstige Preis von Haiku 5.5 gilt nur unterhalb von 100K Kontext. Bei mehr als 100K Input steigt der Preis um das Fünffache; kleine Aufgaben wie Übersetzungen und Zusammenfassungen sparen Geld, für Arbeiten mit langem Kontext sollte man Sonnet verwenden." – @zookmas1314
Mehr Details gibt es in Claude Haiku 5.5 API: Preise und Claude Sonnet 5.5 API: Test und Preise.
Was die Benchmarks zu Haiku 5.5 und Sonnet 5.5 zeigen
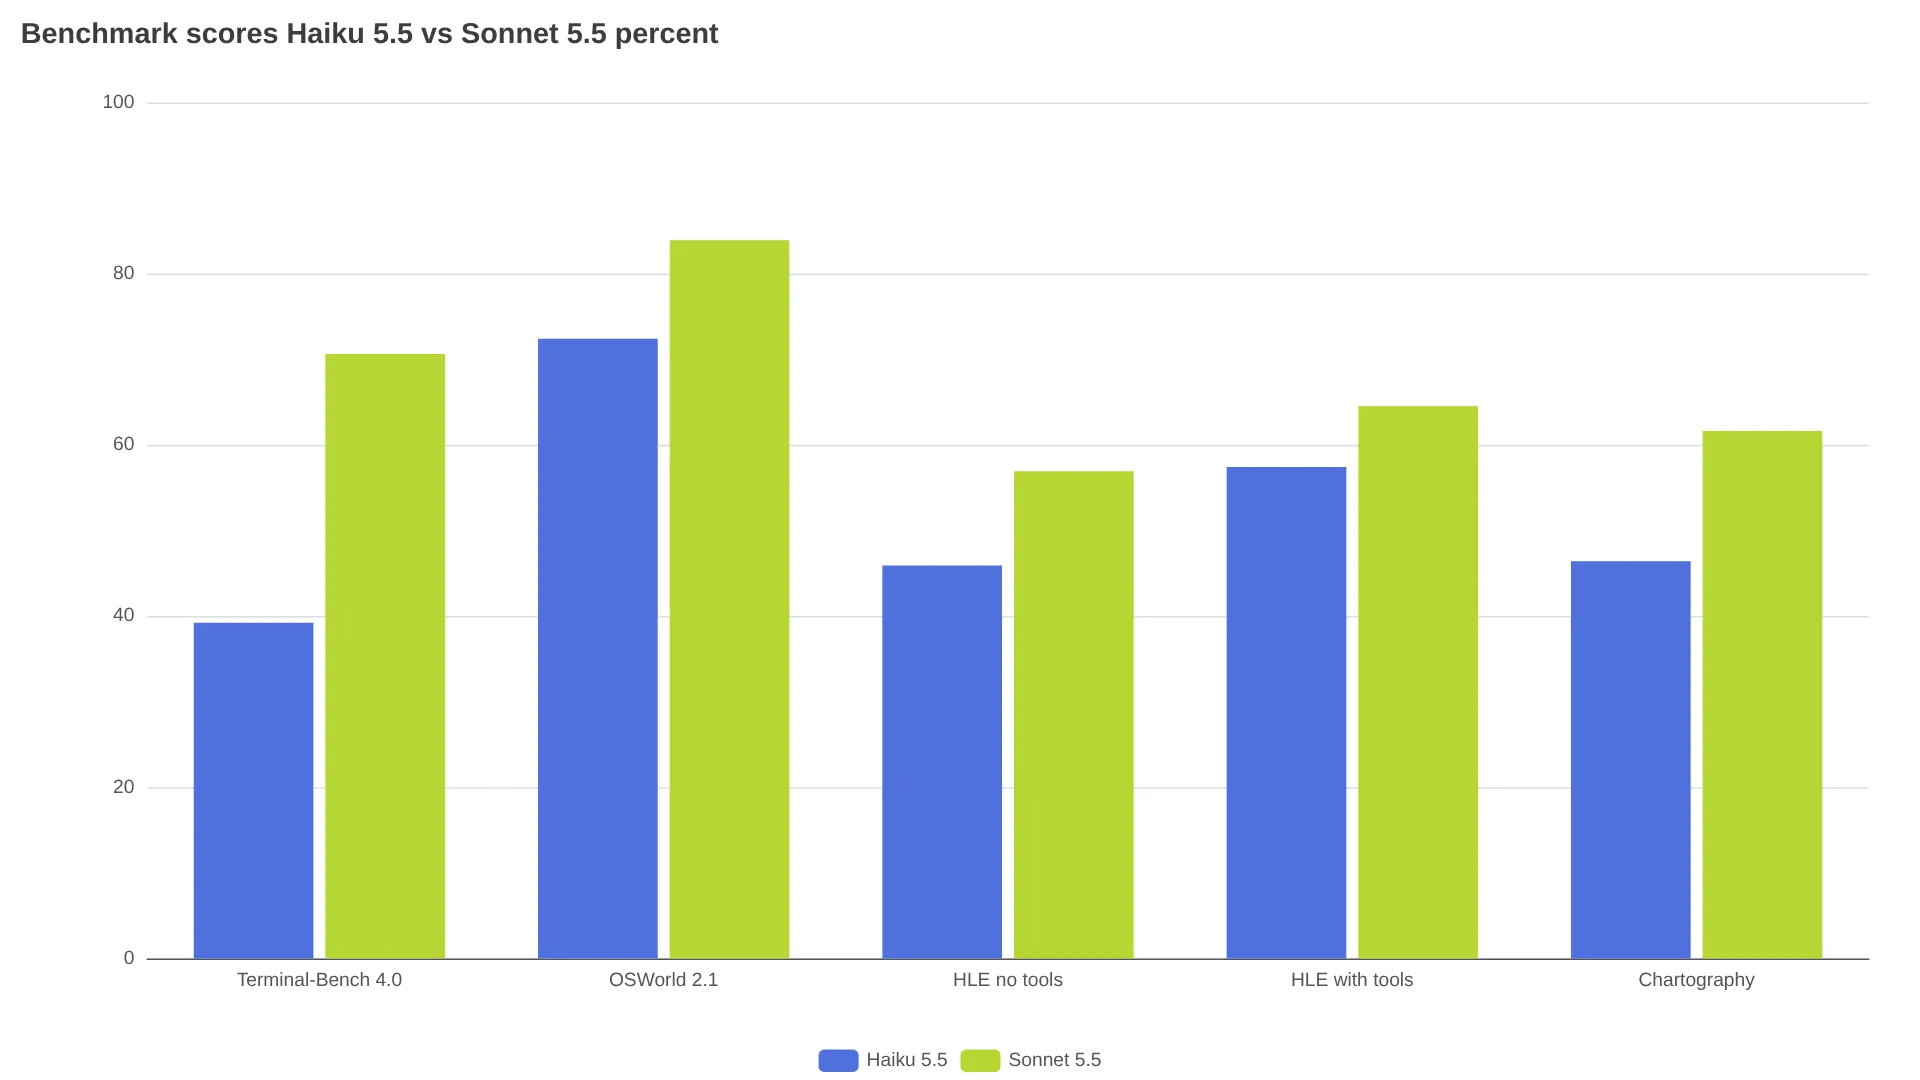
In den veröffentlichten direkten Vergleichen liegt Sonnet 5.5 bei allen von Anthropic gemeldeten Ergebnissen vorn. Am deutlichsten ist der Abstand dort, wo Agenten Code schreiben und ausführen. Im Terminal-Bench 4.0 für agentisches Programmieren erreicht Haiku 5.5 39.2 Prozent, Sonnet 5.5 dagegen 70.6 Prozent. Beim Computer-Use-Benchmark OSWorld 2.1 fällt der Unterschied mit 72.4 zu 83.9 Prozent kleiner aus. Humanity's Last Exam ohne Tools liegt bei 45.9 zu 56.9 Prozent, mit Tools bei 57.4 zu 64.5 Prozent. Die Werte stammen aus der Benchmark-Tabelle im Vergleich von APIKO.
Mit den Effort-Einstellungen verschiebt sich der Abstand. Die im selben Vergleich zitierten Ergebnisse von Artificial Analysis setzen Haiku mit xhigh und Sonnet mit medium beim Intelligence Index beide auf 41. Auch im Terminal-Bench liegen sie mit 29.3 Prozent gegenüber 29.8 Prozent fast gleichauf. Haiku xhigh kostete pro Aufgabe jedoch $0.12, Sonnet medium $0.48. Dafür benötigte Haiku 295 Sekunden statt 122 Sekunden. Keine Haiku-Konfiguration erreichte in diesem Datensatz den Standardwert 47 von Sonnet mit high. Die Kosten berücksichtigen Haikus höhere Stufe ab 100K nicht und sind deshalb für Aufgaben mit langem Kontext als Untergrenze zu verstehen.
Für eng umrissene Extraktion und Klassifikation braucht es Sonets Vorsprung beim Programmieren nicht. Führende Coding-Agenten, lange Tool-Schleifen und visuelles Schlussfolgern – Chartography liegt bei 46.4 gegenüber 61.6 Prozent – profitieren dagegen davon. Ein einzelner Elo- oder Indexwert ist kein universelles Qualitätsranking. In einem Reddit-Test war Haiku mit medium bei einer gemischten Rust- und Legacy-Codebasis ähnlich gut wie Sonnet, kostete aber $0.08 statt $1.68. Haiku mit high stellte in demselben Workflow 385 Anfragen und brachte keinen Qualitätsgewinn, wie der kontrollierte Coding-Test von r/ClaudeCode zeigt.
Effort ist wichtiger als das Modelllabel: Haiku low gegen Sonnet low
Die Standard-Einstellung erklärt viele Beschwerden über ein angeblich „zu ausführliches“ Haiku. Haiku 5.5 startet mit medium, Sonnet 5.5 mit high; außerdem unterscheiden sich die Thinking-Konfigurationen. Bei Haiku wird Thinking mit {"type": "disabled"} abgeschaltet. Sonnet verwendet bei high und niedrigeren Stufen {"type": "between_tools"}; bei xhigh/max kommt adaptive oder eine weggelassene Thinking-Angabe zum Einsatz. Das dokumentieren die Claude-Plattformdokumentation und die APIKO-Hinweise zum Verhalten der Modelle.
In APIKOs Evaluation mit 22 Aufgaben und 528 Requests über den Messages-Endpunkt am 10. Oktober 2026 bestand Haiku mit low 65 von 66 Läufen. Sonnet kam je nach Konfiguration auf 64 bis 66. Die Gateway-Kosten der kurzen Aufgaben lagen bei Haiku ungefähr beim Achtzehntel. Wurde Thinking vollständig deaktiviert, fiel Haiku auf 56 von 66 zurück – vor allem bei Schlussfolgerungsaufgaben und strengen Formatvorgaben wie einer CSV-Summe oder einem Code-Trace. Haiku mit dem Standardwert medium bestand alle 66 Tests, erzeugte aber 4.4-mal mehr Output-Tokens als Haiku mit low, größtenteils Thinking-Tokens.
Aus diesen Daten und den Berichten von Nutzern lassen sich praktische Regeln ableiten:
- Begrenzte Aufgaben wie Klassifikation, Routing, Extraktion und kurze JSON-Antworten zunächst mit Haiku
lowbearbeiten – nicht mit Haikus Standardwertmedium. - Wenn bessere Qualität zum Haiku-Preis gefragt ist, zuerst Haiku
highoderxhighausprobieren, bevor Sonnetlowzum Einsatz kommt. Die in APIKOs Vergleich zitierten Zahlen von Artificial Analysis setzen Haikumaxmit 43 vor Sonnetlowmit 36 – bei etwa 60 Prozent der Kosten. - Sonnet ab
mediumfür Debugging, mehrstufige Implementierungen und lange Tool-Sequenzen reservieren, wenn die zusätzliche Latenz von Haiku-high keinen weiteren Qualitätsgewinn bringt. - Thinking im gemeinsam genutzten Code je Modell explizit setzen. Ein Template, das
between_toolsan Haiku oderdisabledan Sonnet schickt, führt laut APIKOs Gateway-Test zu einem 400-Fehler beim Upstream.
"Opus/Sonnet als Hauptorchestrator und Reviewer und Haiku als Arbeitstier, mit einer neuen Haiku-Instanz pro Feature." – u/ohrajaaa auf r/ClaudeAI
Nach den Folgen eines unbemerkten Fehlers routen – nicht nach dem Schwierigkeitsgrad
Die entscheidende Routing-Frage lautet nicht: „Ist diese Aufgabe schwierig?“ Sondern: „Was passiert, wenn Haiku plausibel falsch liegt und niemand den Fehler bemerkt?“ Mehrere der zitierten Praxistests kommen zum gleichen Ergebnis: Bei Bewertungsaufgaben kann Haiku unauffällig scheitern, während sich Sonnet dort auszahlt, wo eine nachträgliche Prüfung teuer ist.
| Wenn die Aufgabe so aussieht | Führendes Modell |
|---|---|
| Sentiment-Klassifikation, Ticket-Routing, Permit-to-JSON, Log-Zusammenfassungen, OCR und Annotation, SQL-Auswahl, Kompaktierungs-Subagenten | Haiku 5.5 |
| Codebase-Suche, Änderungen an einer Datei, Dokumentverarbeitung in einem Turn | Haiku 5.5 |
| Führender Coding-Agent, echtes Debugging, mehrstufige Refactorings, Faktenprüfung, Dokumentzuordnung | Sonnet 5.5 |
Nutzer berichten bei einzelnen, volumenstarken Haiku-Aufgaben von dreifacher Geschwindigkeit und deutlich geringerem Verbrauch. Ein Fall verarbeitete mehrere Megabytes an Dokumenten für ein paar Dollar, wie aus r/ClaudeAIs Thread „What is Haiku 5.5 best suited for?“ hervorgeht.
Ein Vergleich mit sechs Subagenten-Aufgaben zeigte, dass Haiku zwar günstig, bei Recherche und faktischer Bewertung aber deutlich unzuverlässiger war. Dabei wurden Dateien übersehen, was nach außen wie ein sauberes Ergebnis aussah. So lautet das Ergebnis des Subagententests von Haiku, Sonnet und Opus auf r/ClaudeCode. Die dortige Leitplanke ist unmissverständlich:
"Wenn die Ausgabe eine Aktion auslöst … geht sie entweder an ein größeres Modell oder wird von einem größeren Modell geprüft." – u/vladgladi auf r/ClaudeCode
Ein Hinweis aus der Produktion: Strukturierte Ausgaben sind bei Haiku nicht automatisch zuverlässig. In APIKOs Evaluation wurde bei low ein Verstoß gegen das strikte Format protokolliert – die korrekten Labels lagen in einem JSON-Objekt statt als eigenständiges Array vor. Nutzer von r/ClaudeCode berichten bei niedrigem Effort außerdem von übersprungener Verifikation und ignorierten Einschränkungen, wie der kontrollierte Coding-Test zeigt.
Ein Haiku-first-Setup für den Produktionsbetrieb
Der Anwendungscode muss mit modellspezifischem Thinking, der Tool-Auswahl und dem Gesprächsverlauf umgehen können. Das zeigt APIKOs Gateway-Test vom 10. Oktober mit dokumentierten Mustern. Haiku akzeptiert ein erzwungenes tool_choice, Sonnet lehnt es beim Upstream ab – hier sollten auto oder strukturierte Ausgaben verwendet werden. Haiku kann Thinking-Blöcke von Sonnet nicht lesen, während Sonnet Haikus Thinking-Blöcke verarbeiten kann, solange der Verlauf nur angehängt wird. Das erneute Abspielen bearbeiteter Sonnet-Blöcke kann einen 400-Fehler auslösen.
Ein Haiku-first-Muster, auf das Nutzer unabhängig voneinander immer wieder kommen, sieht so aus:
- Haiku 5.5 für den ersten Durchlauf mit
lowaufrufen – etwa zum Klassifizieren, Extrahieren oder Erstellen eines Entwurfs. Um Thinking vollständig zu deaktivieren,thinking: {"type": "disabled"}verwenden. - Nur erlaubte Labels oder schema-valide JSON akzeptieren. Alles Unsichere, Ungültige oder folgenschwere an Sonnet 5.5 mit
mediumeskalieren. - Subagenten frisch und kurzlebig halten: eine Haiku-Instanz pro Datei oder Feature statt einer einzigen Unterhaltung, die über 100K hinauswächst.
- Sonnet oder Opus als Reviewer einsetzen, sobald eine Ausgabe eine Aktion auslöst, eine Nachricht versendet oder Produktionscode verändert.
"Haiku ist sehr gut, wenn man weiß, was zu tun ist und wie man die Qualität prüft." – u/Awric auf r/ClaudeCode
Anthropic positioniert Haiku 5.5 als Subagent für volumenstarke Aufgaben wie Zusammenfassungen, der neben Sonnet oder Opus eingesetzt wird, laut @ClaudeDevs. Ein gemeinsames Setup nutzt Haiku-Schwärme für die Suche im Repository, während Sonnet Diffs und Tests übernimmt, wie @mirku21 beschreibt.
Haiku 5.5 vs. Sonnet 5.5: FAQ
Wie viel günstiger ist Haiku 5.5 als Sonnet 5.5?
Zum Listenpreis ist Haiku bei Prompts unter 100K 20-mal günstiger ($0.10/$0.50 gegenüber $2/$10 pro 1M) und bei mehr als 100K viermal günstiger ($0.50/$2.50 gegenüber $2/$10). Cache-Lesevorgänge kosten $0.01 gegenüber $0.10 pro 1M.
Haben Haiku 5.5 und Sonnet 5.5 dasselbe Kontextfenster?
Ja. Beide Modelle bieten laut Anthropic und der Plattformdokumentation ein Kontextfenster von 1M Tokens und maximal 128K Tokens Ausgabe.
Ist Haiku 5.5 für den produktiven API-Einsatz geeignet?
Für klar abgegrenzte, volumenstarke und überprüfbare Aufgaben: meistens ja, typischerweise mit low und Schema-Validierung. Bei Coding-Agenten mit Führungsrolle und rechercheintensiven Bewertungsaufgaben berichten Nutzer von mehr übersehenen Fehlern und Fehlalarmen als bei Sonnet 5.5.
Welches Modell eignet sich besser für Coding-Agenten?
Sonnet 5.5 für den führenden Agenten und fürs Debugging (70.6 gegenüber 39.2 Prozent im Terminal-Bench). Haiku 5.5 eignet sich für Suche, Tipparbeit und Subagenten-Aufgaben an einzelnen Dateien – mit Sonnet oder Opus als Reviewer.
Wie bleibe ich unter Haikus Preisschwelle von 100K?
Dokumente vor Erreichen der Grenze aufteilen, Subagenten auf bestimmte Dateien begrenzen, ausführliche Testausgaben unterdrücken und für jede Aufgabe neue Subagenten starten. Der Verlauf agentischer Aufgaben überschreitet 100K ungefähr nach 20 Aufrufen.
Kann ich eine Unterhaltung auf halber Strecke von Sonnet 5.5 zu Haiku 5.5 verschieben?
Nicht ohne Weiteres. Haiku kann Sonets Thinking-Blöcke nicht lesen. Entweder bleibt man bei Sonnet oder startet die Aufgabe mit Haiku neu. Wird ein Haiku-Verlauf zu Sonnet verschoben, bleibt das Reasoning erhalten, solange der Verlauf ausschließlich angehängt wird.
Der Zielkonflikt, den auch Routing nicht beseitigt
| Wenn dein Workload so aussieht | Wähle | Warum |
|---|---|---|
| Hunderte Klassifikationen, Extraktionen, Zusammenfassungen und JSON-Normalisierungen | Haiku 5.5 mit low | Bei validierten Ergebnissen nahezu gleiche Erfolgsquoten wie Sonnet bei kurzen Aufgaben und etwa 1/18 der Kosten |
| Eine große Codebasis, lange Tool-Schleifen, Debugging mit hohem Anspruch an die Korrektheit | Sonnet 5.5 | 31 Punkte Vorsprung im Terminal-Bench und weniger unbemerkte Fehler |
| Dokumente rund um die 100K-Grenze | Beide Preise berechnen | Haikus fünffache höhere Preisstufe beseitigt den Großteil des Abstands; oberhalb der Grenze ist Sonnet nur noch 4-mal teurer |
| Alles, bei dem ein unbemerkter Fehler live gehen kann | Haiku-Entwurf plus Sonnet-Review | Die Kosten pro geprüftem Erfolg sind wichtiger als der nominelle Tokenpreis |
Haiku 5.5 gewinnt beim Preis pro Versuch. Sobald Prüfungen und Wiederholungen den Tokenverbrauch bestimmen, kann Sonnet trotzdem günstiger sein. Wer seinen Router an diesem Unterschied ausrichtet, macht aus keinem der beiden Modelle ein Glücksspiel.