 AIREITER
Ein 27-Milliarden-Parameter-Modell auf dem Smartphone klingt zunächst nach Marketing. Bei PrismMLs Bonsai 27B stimmt die zentrale Behauptung jedoch: Die 1-Bit-Version belegt 3,9 GB und erreicht auf einem iPhone 17 Pro rund 11 Token pro Sekunde. Grundlage ist Qwen3.6 27B, dessen Gewichte unter Apache 2.0 frei verfügbar sind. Die ternäre Variante soll mehr als 95 % des Benchmark-Ergebnisses in voller Präzision erhalten. Das gilt allerdings nicht gleichmäßig: Mathe und Code bleiben sehr nah am Original, bei Tool Calling und Vision lässt die Qualität stärker nach. Damit ist Bonsai 27B ein interessantes lokales Modell für Reasoning und Programmierhilfe, aber keine verlässliche Wahl für agentische, stark toolbasierte Aufgaben. Dieser Überblick erklärt die Komprimierung, ordnet die Messwerte ein, zeigt vier Wege zum Ausführen und sagt, für wen sich das Modell lohnt.
So passt ein 27B-Modell aufs Smartphone
Ein gewöhnliches 27B-Modell benötigt in FP16 ungefähr 54 GB Speicher – weit mehr, als ein Smartphone bieten kann. Bonsai 27B kommt auf unter 6 GB, weil die Gewichte nicht mehr als Werte voller Präzision abgelegt werden, sondern als sehr kleine diskrete Werte.
In der ternären Variante darf jedes Gewicht nur einen von drei Werten annehmen: -1, 0 oder +1. Theoretisch entspricht das rund 1,58 Bit Information pro Gewicht. PrismML ergänzt FP16-Skalierung pro Gewichtsgruppe: Für jede Gruppe wird ein Skalierungsfaktor in voller Präzision gespeichert, damit die stark reduzierten Werte weiterhin ungefähr die richtige Größenordnung treffen. Dadurch liegt der tatsächliche Bedarf bei rund 1,71 effektiven Bit pro Gewicht. Die aggressivere binäre 1-Bit-Variante entfernt die Null und behält nur -1 und +1; sie kommt auf etwa 1,125 effektive Bit.
Zwei Punkte sind dabei entscheidend. Erstens ist die Komprimierung durchgängig: Embeddings, Attention, MLP-Blöcke und der Language-Model-Head werden allesamt quantisiert. Es bleiben keine Komponenten in voller Präzision als Stütze übrig. Zweitens basiert Bonsai auf Qwen3.6 27B mit 27,8B Parametern, einem kausalen Modell mit Hybrid-Attention. Deshalb übernimmt Bonsai dessen Kontextfenster von 262K Token und die multimodale Eingabe.
Ternär oder 1 Bit: Welche Variante ist die richtige?
PrismML bietet zwei Builds an. Wer den falschen nimmt, verschenkt entweder Speicher oder Qualität. Die Regel ist einfach: Kleinere Datei bedeutet geringere Genauigkeit.
| Build | Effektive Bit/Gewicht | Größe | Erhaltene Qualität | Geeignet für |
|---|---|---|---|---|
| Ternär (-1, 0, +1) | ~1.71 | 5.9GB | >95% von FP16 | Desktop, qualitätssensible Aufgaben |
| Binär mit 1 Bit (-1, +1) | ~1.125 | 3.9GB | >90% von FP16 | Smartphones, knapper Arbeitsspeicher |
Auf dem Smartphone ist die 1-Bit-Version die passende Wahl: Sie passt in den verfügbaren Speicher eines iPhone 17 Pro. Auf einem Laptop oder Desktop mit genügend Reserve bringt der ternäre Build für zwei zusätzliche Gigabyte mehrere Genauigkeitspunkte zurück. Das lohnt sich immer dann, wenn die Qualität der Ausgabe wichtiger ist als der kleinste mögliche Speicherbedarf.
Was die Benchmarks zeigen – und wo Bonsai nachlässt
Die offiziellen Ergebnisse beziehen sich auf den ternären Build. Über 15 Benchmarks im Thinking-Modus erreicht er im Schnitt 80.49. Einige Einzelwerte fallen besonders stark aus:
| Benchmark | Wert | Gemessen wird |
|---|---|---|
| MATH-500 | 99.20 | Mathematik vom Schul- bis Wettbewerbsniveau |
| AIME 2025 | 90.84 | Schwierige Wettbewerbsaufgaben in Mathematik |
| HumanEval+ | 93.90 | Codegenerierung |
| BFCL v3 | 74.41 | Funktions- und Tool-Aufrufe |
Nebeneinander betrachtet zeichnen diese Zahlen ein klares Bild: Mathe und Code liegen in den 90ern, Tool Calling in den 70ern. Genau diese Lücke sollte man vor dem Einsatz verstehen. Die Quantisierung bewahrt Reasoning und Programmierfähigkeiten deutlich besser als das strukturierte, mehrstufige Verhalten, auf das agentische Workflows angewiesen sind.
Die Werte stammen von PrismML selbst und sind daher ein Ausgangspunkt, nicht das letzte Wort – zumindest bis mehr unabhängige Benchmarks vorliegen. Wichtiger als der Durchschnitt von 80.49 sind die Ergebnisse je Aufgabe und die realen Fehlermuster. Frühe Tester berichten, dass der ternäre Build gelegentlich in Reasoning-Schleifen hängen bleibt. Zudem beeinträchtigt extreme Quantisierung die Stabilität bei langen Kontexten meist stärker, als ein einzelner Benchmark-Wert erkennen lässt. Beides sollte man mit den eigenen Prompts kurz prüfen, bevor man sich darauf verlässt.
Geschwindigkeit und unterstützte Hardware
Eine so starke Komprimierung ist nur dann sinnvoll, wenn die Inferenz schnell genug bleibt. Auf leistungsfähiger Hardware ist das der Fall. Die folgenden Zahlen stammen von PrismML:
| Gerät | 1 Bit | Ternär |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
11 Token pro Sekunde auf einem Smartphone reichen für Chats und kürzere Reasoning-Aufgaben, auch wenn das keineswegs rasend schnell ist. Mit einem M5 Max sind 87 Token pro Sekunde schnell genug, dass lokale Inferenz bei kurzen Prompts inklusive Netzwerklaufzeit einen Cloud-API-Aufruf schlagen kann. PrismML beschreibt den Fortschritt auch über die Intelligence Density, also Benchmark-Punkte pro Gigabyte: Bonsai liegt hier bei rund 0.53 und damit ungefähr zehnmal über einer Referenz in voller Präzision.
Bonsai 27B heute auf vier Arten ausführen
Da die Gewichte offen verfügbar sind, gibt es keinen einzigen Installationsweg. Diese vier Optionen funktionieren derzeit – von ohne Einrichtung bis zur vollständigen Kontrolle.
Auf dem iPhone
Die iOS-App Locally AI führt den 1-Bit-Build mit 3,9 GB direkt auf dem Gerät aus – ohne Konto und ohne Server. Das ist der Weg, der das Versprechen eines 27B-Modells auf dem Smartphone tatsächlich einlöst. Nach dem Download der Gewichte läuft das Modell vollständig offline.
Direkt im Browser
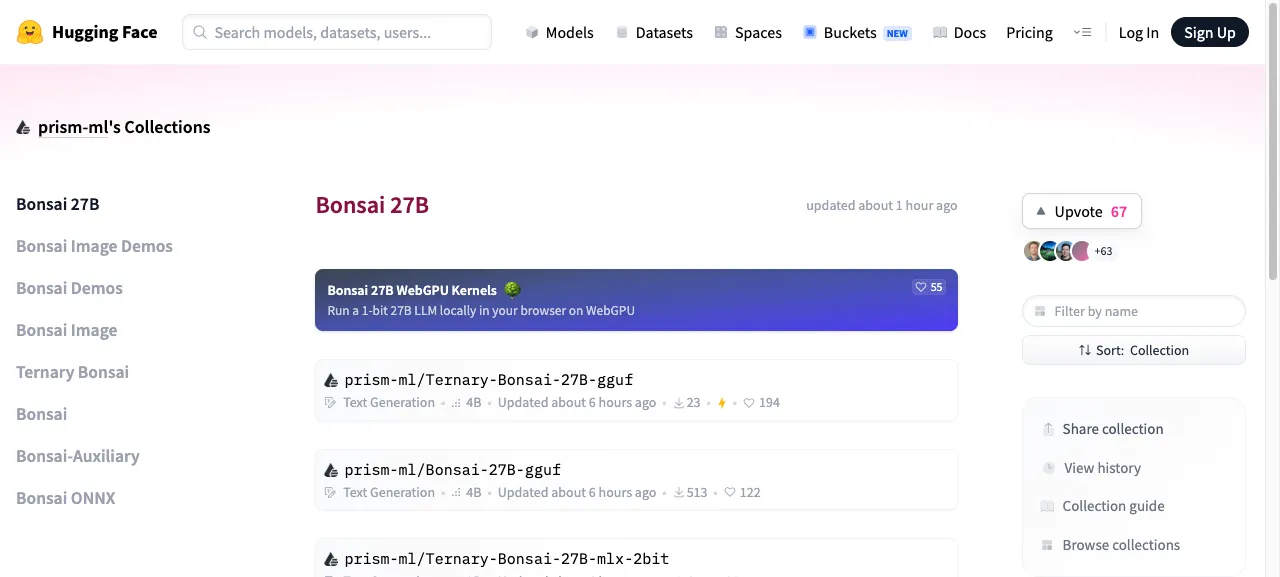
PrismML stellt WebGPU-Kernels bereit, die das 1-Bit-Modell ohne Installation in einem Browser-Tab ausführen. Das ist der schnellste Weg, Bonsai 27B auszuprobieren, bevor Speicherplatz belegt wird. Voraussetzung ist allerdings ein Rechner mit WebGPU-fähiger GPU.
Auf dem eigenen Rechner
GGUF-, MLX- und ONNX-Gewichte stehen auf Hugging Face und GitHub unter Apache 2.0 bereit. Die wichtigsten Repositories sind prism-ml/Bonsai-27B-gguf für 1 Bit und prism-ml/Ternary-Bonsai-27B-gguf für die ternäre Variante; daneben gibt es MLX-2-Bit- und ONNX-Builds. Für die 1-Bit-Version sollten rund 4 GB freier Speicher und RAM eingeplant werden, für Ternär 6 GB. Ein Vorbehalt: Die Tool-Unterstützung hinkt dem Release noch hinterher. Die Gewichte laden zwar in mehreren Runtimes, doch zum Start war die vollständige Unterstützung in beliebten lokalen Apps wie LM Studio noch nicht verfügbar. Man sollte daher mit etwas manueller Einrichtung rechnen.
Über eine gehostete API
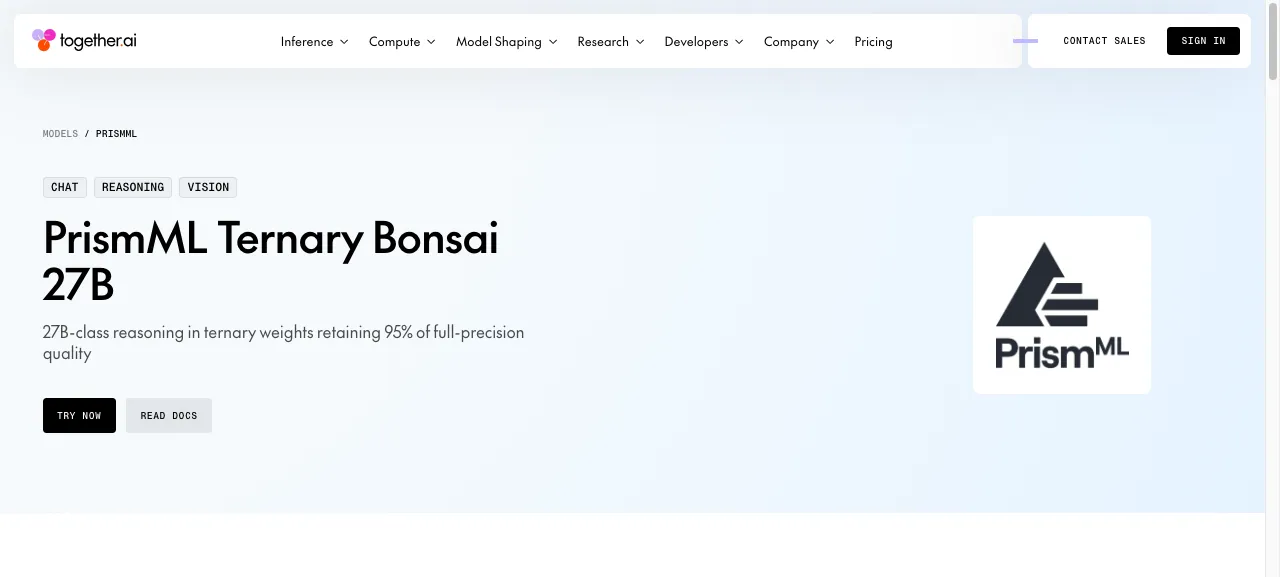
Wer keine Gewichte selbst verwalten möchte, kann den ternären Build über Together.ai per Standard-API nutzen. Angeboten werden das vollständige Kontextfenster mit 262K Token, Bildeingaben und ein JSON-Modus. Während der Einführungsaktion waren Eingabe-Token mit $0.00 pro einer Million Token gelistet. Vor der Budgetplanung sollte man den aktuellen Preis prüfen, da sich Aktionspreise ändern.
Bonsai 27B gegen Gemma 4 12B QAT
Am häufigsten wird Bonsai mit Gemma 4 12B QAT verglichen, Googles quantisierungsbewusst trainiertem Modell. Dieses liegt bei rund 7 GB und ist damit nur wenig größer als Bonsais ternärer Build.
Die Stärken verteilen sich unterschiedlich. Dank der 27B-Basis schlägt Bonsai 27B Gemma bei Mathe- und Coding-Benchmarks klar. Gemma hält sich bei Vision und Tool Calling meist besser und ist mit seinen etwas größeren, weniger aggressiv komprimierten Gewichten die stabilere Allround-Wahl auf dem Smartphone. Für lokale Reasoning- und Coding-Aufgaben ist Bonsai die stärkere Option; bei Bildarbeit oder Function Calling ist Gemma 4 12B QAT die sicherere Wahl.
Für wen sich Bonsai 27B wirklich lohnt
Bonsai 27B eignet sich für alle, die private, lokale und offline nutzbare Unterstützung beim Reasoning oder Programmieren möchten und ein Gerät auf iPhone-17-Pro-Niveau oder einen leistungsfähigen Laptop besitzen. Auch für Interessierte an extremer Quantisierung ist das Modell spannend: Dass ein 27B-Modell in einem Browser-Tab läuft, ist ein echter Meilenstein. Die offene Apache-2.0-Lizenz erleichtert zudem eigene Experimente. Als lokale Option passt es gut neben andere offene und kostenlose Modelle für die Programmierung.
Für produktive agentische Systeme, die auf verlässliches Tool Calling angewiesen sind, für visionskritische Aufgaben oder für Szenarien, in denen Reasoning-Schleifen teuer wären, sollte man es vorerst nicht einsetzen. Hier bleiben ein weniger stark komprimiertes Modell oder ein Modell in voller Präzision hinter einer API die sicherere Wahl.
Häufige Fragen
Ist Bonsai 27B kostenlos nutzbar?
Die Gewichte sind unter der Apache-2.0-Lizenz kostenlos verfügbar und können ohne Gebühren heruntergeladen und ausgeführt werden. Gehosteter Zugriff über Together.ai hat eigene API-Preise. Zum Start waren $0.00 pro einer Million Eingabe-Token angegeben, daher sollte der aktuelle Tarif geprüft werden.
Läuft Bonsai 27B wirklich auf einem Smartphone?
Ja. Der 1-Bit-Build ist 3,9 GB groß und läuft über die Locally AI App auf einem iPhone 17 Pro mit etwa 11 Token pro Sekunde. Nach dem Download arbeitet er vollständig offline.
Ist Bonsai 27B so gut wie Qwen3.6 27B in voller Präzision?
Fast, aber nicht identisch. Der ternäre Build behält mehr als 95 % der Benchmark-Leistung in voller Präzision, der 1-Bit-Build mehr als 90 %. Am besten bleibt die Leistung bei Mathe und Code erhalten, am stärksten sinkt sie bei Tool Calling.
Welche Bonsai-27B-Datei sollte ich herunterladen?
Für ein Smartphone oder einen Rechner mit knappem Speicher ist der 1-Bit-Build die richtige Wahl: prism-ml/Bonsai-27B-gguf mit etwa 3,9 GB. Auf einem Desktop oder einer GPU mit ausreichend Reserven bietet der ternäre Build prism-ml/Ternary-Bonsai-27B-gguf mit etwa 5,9 GB einige zusätzliche Genauigkeitspunkte. Für Apple Silicon und plattformübergreifende Runtimes gibt es außerdem MLX-2-Bit- und ONNX-Varianten.
Was bedeutet ternäre Quantisierung?
Statt eine Modellgewichtung als Zahl voller Präzision zu speichern, nutzt sie nur einen von drei Werten: -1, 0 oder +1. Deshalb schrumpft das Modell so stark. FP16-Skalierungsfaktoren sorgen dafür, dass die reduzierten Gewichte ungefähr die richtige Größenordnung behalten.
Unterstützt Bonsai 27B Bilder?
Ja. Das Modell akzeptiert neben Text auch Bildeingaben und erzeugt Textausgaben. Diese multimodale Fähigkeit stammt von der Qwen3.6-27B-Basis. Unter der Komprimierung bleibt die Vision-Qualität jedoch weniger gut erhalten als die Leistung bei Mathe und Code.