 AIREITER
百度这款模型随附的配置文件,将 max_position_embeddings 限定为 32,768。这正是“Unlimited”这个名字不再字面成立的边界,也是部署前最该搞清楚的一点:Unlimited OCR 确实能把逐页 OCR 循环改为一次前向推理,但前提是整份文档能装进 32K token 预算,且扫描件本身足够干净。
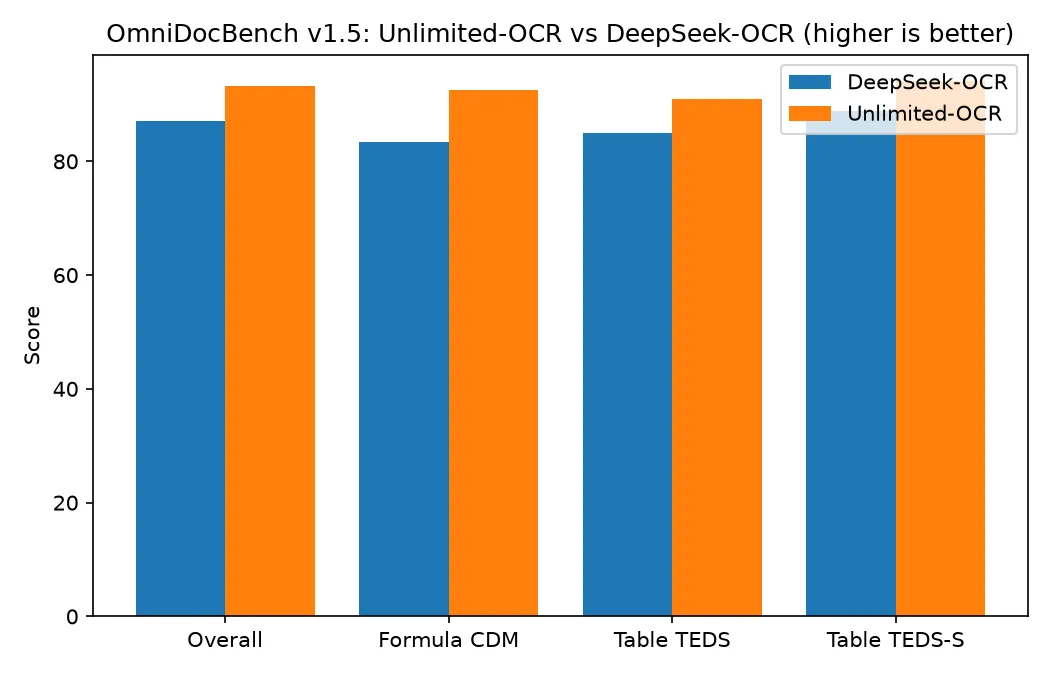
不过,这个限制并不掩盖此次发布的亮点。模型权重采用 MIT 许可证;safetensors 元数据显示,它在 BF16 下拥有 3,336,106,240 个参数;在 OmniDocBench v1.5 上的总分为 93.23,高于其基础模型 DeepSeek-OCR 的 87.01。截至 2026-07-29,Hugging Face 页面显示,该模型过去 30 天下载量为 2,694,935 次,获赞数为 3,389。
“无限”到底卡在哪:32K 上下文预算
多页处理模式下,每页会先编码为 1024×1024,再经过 16 倍压缩,最终约为 256 个视觉 token。也就是说,在动手写代码前,你就能先估算一轮可处理的页数。
| 单次处理页数 | 视觉 token(预填充) | 留给输出的 token | 每页输出预算 |
|---|---|---|---|
| 10 | ~2,560 | ~30,200 | ~3,020 |
| 20 | ~5,120 | ~27,600 | ~1,380 |
| 40 | ~10,240 | ~22,500 | ~560 |
幻灯片、内容稀疏的合同,40 页通常能轻松容纳。但一张密集的双栏报纸页面,光转成 markdown 就可能超过 560 个 token;对于这类输入,实际页数上限会明显低于 40 页。论文对此说得很明确:在有限上下文长度下,解析不可能真正无限,因为预填充长度仍会随着页数增加。百度给出的路线图包括 128K 上下文版本,以及可按需获取页面分块的“prefill pool”。因此,这个名字描述的是相对于缓存大小的无限解码长度,而不是无限页数。
R-SWA 改了什么,又没改什么
相较 DeepSeek-OCR,Unlimited OCR 有两项关键变化。视觉端的 DeepEncoder——由 SAM-ViT-B 和 CLIP-L 级联组成——被保留,并且训练期间冻结。解码器的每一层注意力则全部替换为 Reference Sliding Window Attention:每个新生成 token 都能关注全部参考 token,也就是视觉 token 与提示词,同时只关注最近 128 个输出 token。config.json 也确认了这一点:sliding_window_size: 128、12 层解码器、64 个路由专家,每个 token 激活其中 6 个。
提升并非只集中在某一类文档元素,而是体现在长输出中更容易出问题的部分。OmniDocBench v1.5 上,公式 CDM 从 83.37 提升到 92.61,表格 TEDS 从 84.97 提升至 90.93,阅读顺序编辑距离则从 0.086 降到 0.045,几乎减半。由于编码器没有重新训练,这些增量来自解码器改造,而非视觉栈变得更强。
反过来说,编码器本来识别不好的内容,新模型依然识别不好。更长的生成长度,并不能让它突然看清褪色传真上的字符。
输出够长,速度优势才会显现
输出仅为 256 个 token 时,两款模型几乎没有差异:分别为每秒 7,229.52 和 7,229.32 个 token。随着生成持续进行,差距才逐步拉开:输出达到 6,144 个 token 时,基线模型降至每秒 5,822.87 个 token,而 Unlimited OCR 仍维持在 7,847.71,约快 35%。
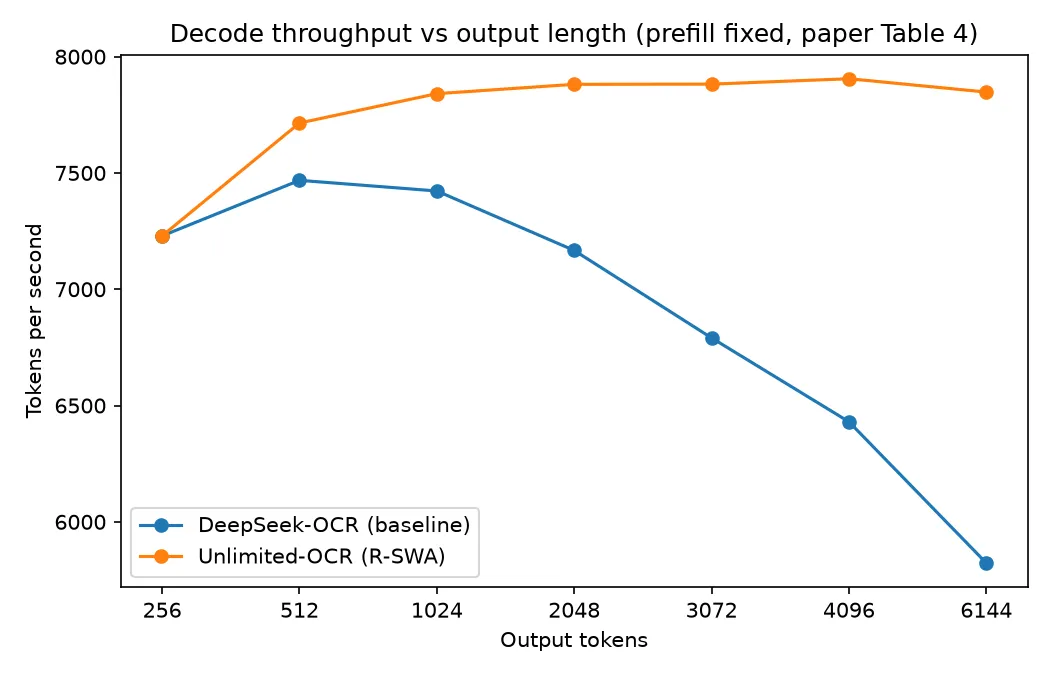
不过,在 base 模式、512 并发的完整 OmniDocBench 测试中,优势缩小为 12.7%:Unlimited OCR 为每秒 5,580 个 token,基线为 4,951 个 token。原因是批处理已经掩盖了相当一部分逐步注意力计算成本。高并发下处理单页发票,R-SWA 几乎带不来实际收益。
准确率能维持到 40 页吗?曲线会开始弯折
论文给出了单次处理时编辑距离随页数变化的结果,这条曲线并不平坦。
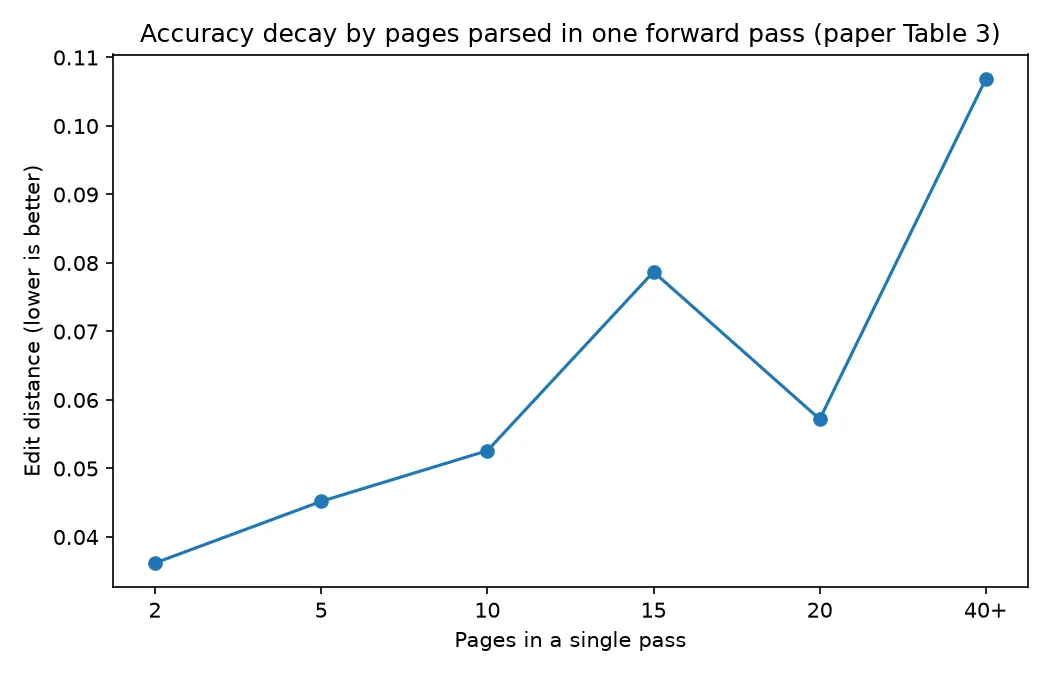
处理 2 页时,编辑距离为 0.0362;10 页时为 0.0526;达到 40 页或更多时升至 0.1069。同时,Distinct-35 从约 99.9% 降至 96.90%,意味着输出开始出现重复 n-gram。15 页的测量值为 0.0787,反而差于 20 页时的 0.0572,因此这条曲线更适合视为总体趋势,而不是逐页保证。百度认为,重复问题主要来自 1024×1024 基础分辨率下的小文字,而非注意力漂移。这也符合其架构取舍:多页和 PDF 输入无法使用单张图片可用的高细节裁剪模式。
“8 GB 就够用”背后的显存账
vLLM 的部署说明写着,BF16 推理只需一张 8 GB 或以上显存的 GPU。但社区实测并不完全支持这一说法,而模型自身配置正好解释了差异。
单个 safetensors 文件大小为 6.673 GB。缓存开销由 config.json 中四个字段决定:num_hidden_layers: 12、num_attention_heads: 10、num_key_value_heads: 10、v_head_dim: 128,并且 use_mla: false。查询头和键值头数量相同,意味着这是普通 MHA,没有 GQA 或 MQA 的共享机制可降低缓存占用。因此,每个 token 的缓存为 2(K 和 V)× 12 层 × 10 头 × 128 维 × 2 字节 = 61,440 字节,即 60 KiB。由此可得三组数字:
- 完整 32K 预填充:32,768 × 60 KiB = 1.875 GiB 缓存
- R-SWA 的解码侧缓存,受
sliding_window_size: 128限制:恒定为 7.5 MiB - 同一解码器若不使用 R-SWA,输出 6,144 个 token 时:360 MiB,并随输出线性增长
这些只是理论缓存大小,不等于峰值显存分配。视觉编码器激活值、分配器碎片以及推理引擎预分配的缓存块都会叠加在上面。因此,模型权重加上长预填充,很容易挤满一张 8 GB 显卡。一位用户在 16 GB RTX 4070 Ti Super 上本地运行 SGLang 时,报告显存占用约 12 GB;这与上述计算相符,但不能将其视为严格证明。8 GB 更应被理解为短单页任务的最低门槛,而不是 40 页场景的配置标准。
这些数字也说明了 R-SWA 的实际价值:以这个模型规模来看,限制解码缓存节省的是数百 MB,而不是数 GB。真正体现在实测中的收益,是每一步注意力计算成本不再随输出增长,这正是吞吐量曲线所展示的内容。
没有官方 API,实际部署要走这几条路
Hugging Face 模型页明确标注:“This model isn't deployed by any Inference Provider.” 目前没有第一方接口,也没有百度托管的定价页面。想自行部署,有三种路径:使用带 trust_remote_code 的 Transformers、SGLang,或使用 vLLM 部署配方。后者需要 vLLM 0.25.0 或更新版本,并且必须使用专用的 vllm/vllm-openai:unlimited-ocr 容器,因为该架构尚未进入稳定版 pip wheel。
以下四项设置,直接决定你能否获得有效输出:
- 注册 n-gram logits processor,即
NGramPerReqLogitsProcessor。否则长文档会在<|det|>坐标 token 上循环。 - 单图输入设置
ngram_size: 35与window_size: 128;多页或 PDF 输入则将窗口设为1024。 - 文本内容必须以字面量
<image>开头,例如<image>Multi page parsing.。模型没有自带 chat template。 - 传入
skip_special_tokens: False。如果保留默认设置,返回的会是空字符串。
原始生成结果包含定位标记。若要获得干净的 markdown,应保留 <|ref|> 内的文字,并丢弃 <|det|> 边界框。模型也不会原生输出页码边界;如果审计链路需要它们,应在提示词中要求添加页面标签。
配方中已验证可用的服务端和请求示例如下:
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Hopper 显卡应使用 unlimited-ocr-cu129 镜像标签。还要注意,单个请求中包含多张图片时会回退至非裁剪的 base 模式,而这种场景正需要 window_size: 1024。
每 1,000 页要花多少钱:自托管还是托管 API
开源权重不收费,运行它并不免费。少数公开的实操吞吐量数据之一,来自 Hacker News 讨论串中的一位实践者:他通过 Transformers,在 RTX 4090 上处理一份日语语法 PDF,速度约为每小时 200 页。再将其与 RunPod 上 RTX 4090 的 Community 价格对比,后者为每小时 $0.34。
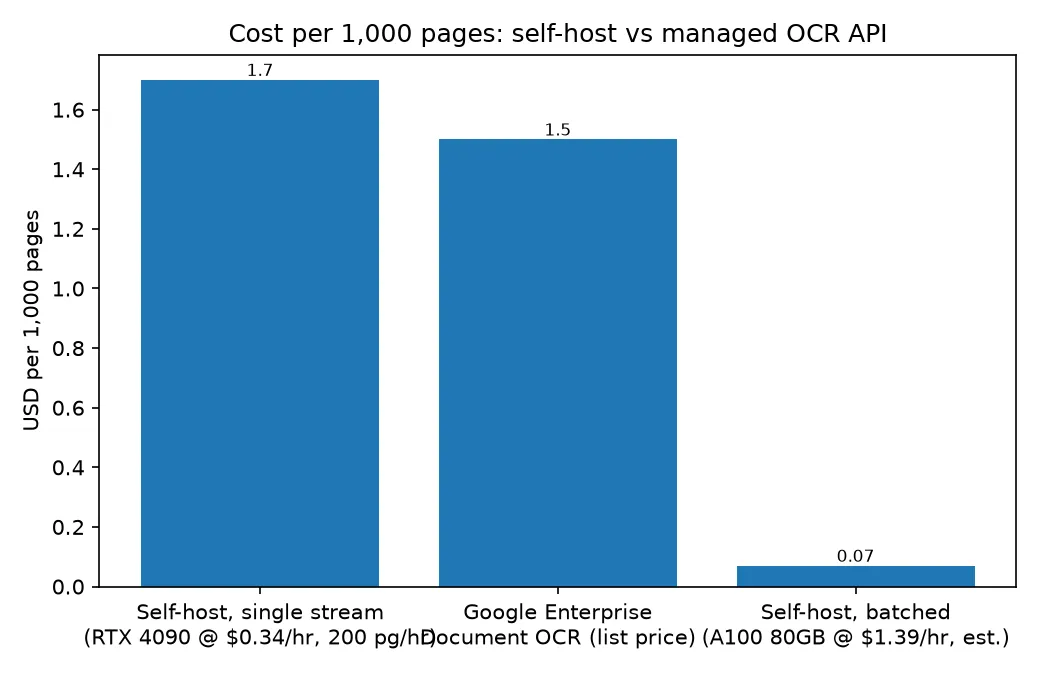
| 方案 | 每 1,000 页成本 |
|---|---|
| 自托管,单流(4090 为 $0.34/小时,200 页/小时) | ~$1.70 |
| Google Enterprise Document OCR,每月 1K 至 5M 页 | $1.50(标价) |
| Google Layout Parser,相同页数区间 | $10.00(标价) |
| 自托管,批量跑满的下限(A100 80GB 为 $1.39/小时,建模估算) | ~$0.07 |
以上标价截至 2026-07-29。Google 每月前 1,000 页免费,超过 500 万页后费率降至 $0.60。表格最后一行是建模得到的理论下限,而不是实测值,并且会随输出长度变化:按论文中 512 路并发下每秒 5,580 个 token 的吞吐量计算,若每页输出 700 个 token,约为每小时 28,700 页,即每 1,000 页 $0.05;每页 1,000 个 token 时约每小时 20,000 页,即 $0.07;密集页面达到 2,000 个 token 时,则约每小时 10,000 页,即 $0.14。这一吞吐量来自百度自有评测集群,而不是租用的 A100,因此该行混合了基准吞吐率和租卡价格。加上闲置容量、失败页重试、预处理和存储后,真实部署成本会高于这三项估算。
在消费级显卡上以单流运行,成本与 Google 托管 OCR 大致相当。因此,自托管的价值主要在并发能力和数据驻留,而不是许可证本身。更重要的是,解析只是流程的一半:把 markdown 转为结构化字段,仍需要调用长上下文文本模型。无论这一步部署在自家基础设施上,还是通过类似 GPT-5.6 API 的服务完成,计费都会重新回到按 token,而非按页。
它最容易在哪些场景失手
用户反馈的失败模式,基本符合冻结编码器所预示的问题。同一位使用 4070 Ti Super 的用户在收据、手写内容和复杂扫描件上遇到了乱码、区域漏检和结构漂移,但干净的印刷页面表现正常。Hacker News 讨论串中的实践者还提到了一类对合规工作尤其关键的 VLM-OCR 错误:外语词汇被悄悄译成英文,手写姓名被“纠正”为概率更高的拼写。这两项都只是个案,应将其视为测试重点,而不是量化后的失败率。
产品定位同样需要看清。Unlimited OCR 并不位居准确率榜首。在汇总的 OmniDocBench 榜单上,PaddleOCR-VL-1.6 为 96.33(厂商自报),Unlimited OCR 在 v1.6 上为 93.92;该模型也尚未出现在 olmOCR-Bench 上。它竞争的维度并不是逐页准确率。
到底该不该用?
如果你的现有流水线仍在逐页 OCR、再把文本拼接回去;文档主要是原生电子文档或干净扫描件;或者跨页表格等跨页结构正让现有结果失效,那么它是一个合适的选择。
如果你每天处理的是数千张单页发票——逐页流水线更容易批处理且成本更低;如果输入中手写内容或拍摄收据占比不低;或者你现在需要的是 SLA 和审计链路,而不是一张 GPU 与一个容器标签,那么它并不合适。
无论选择哪一边,都应先测试再投入。一个可执行的最低测试方案是:从自己的语料中抽取 50 份文档,按长度分为 1 至 5 页、6 至 20 页、20 页或更多,并按输入质量分为原生电子文档、干净扫描件和拍摄件;其中 10 份手工录入真值;分别计算字符错误率、阅读顺序编辑距离和表格 TEDS,而不要把它们简单平均;同时记录目标租用 GPU 上的每页端到端耗时。再用同样的 50 个文件与现有方案对比,并把门槛设在真正会让下游步骤失效的地方——对字段提取而言,通常是表格结构,而不是原始 CER。至于调优能把数值推进多少,一个处理企业级 PDF 规模的团队曾报告,在用 Rust 重写推理层后,字符错误率达到 0.94%。
常见问题
Unlimited OCR 免费吗?
模型权重采用 MIT 许可证,可从 Hugging Face 或 GitHub 免费下载,也允许商业使用。但推理并不免费:视批处理效率而定,每 1,000 页大致需预算 $0.07 至 $1.70,另加工程投入。
Unlimited OCR 有官方 API 吗?
没有。模型页面显示没有 Inference Provider 部署,因此你找到的任何接口都属于第三方对开源权重的托管服务,定价和限流规则由该服务商决定,而非百度。
Unlimited OCR 是目前最强的 OCR 模型吗?
若按准确率榜单衡量,不是:PaddleOCR-VL-1.6 在 OmniDocBench 上报告为 96.33,百度模型在 v1.6 上为 93.92;而且该模型尚无 olmOCR-Bench 成绩,因此跨基准的一致性尚未得到验证。它已测出的优势,是在单次处理 40 页时仍可达到 0.1069 的编辑距离。
我能在 Ollama 中运行 Unlimited OCR 吗?
官方模型卡仅说明了 Transformers、vLLM 和 SGLang 三种方式,且该自定义架构需要 trust_remote_code。Hugging Face 上已有社区量化版本,但在你用自己的文件将其输出与参考路径对比前,任何 Ollama 构建都应视为未经验证。