 AIREITER
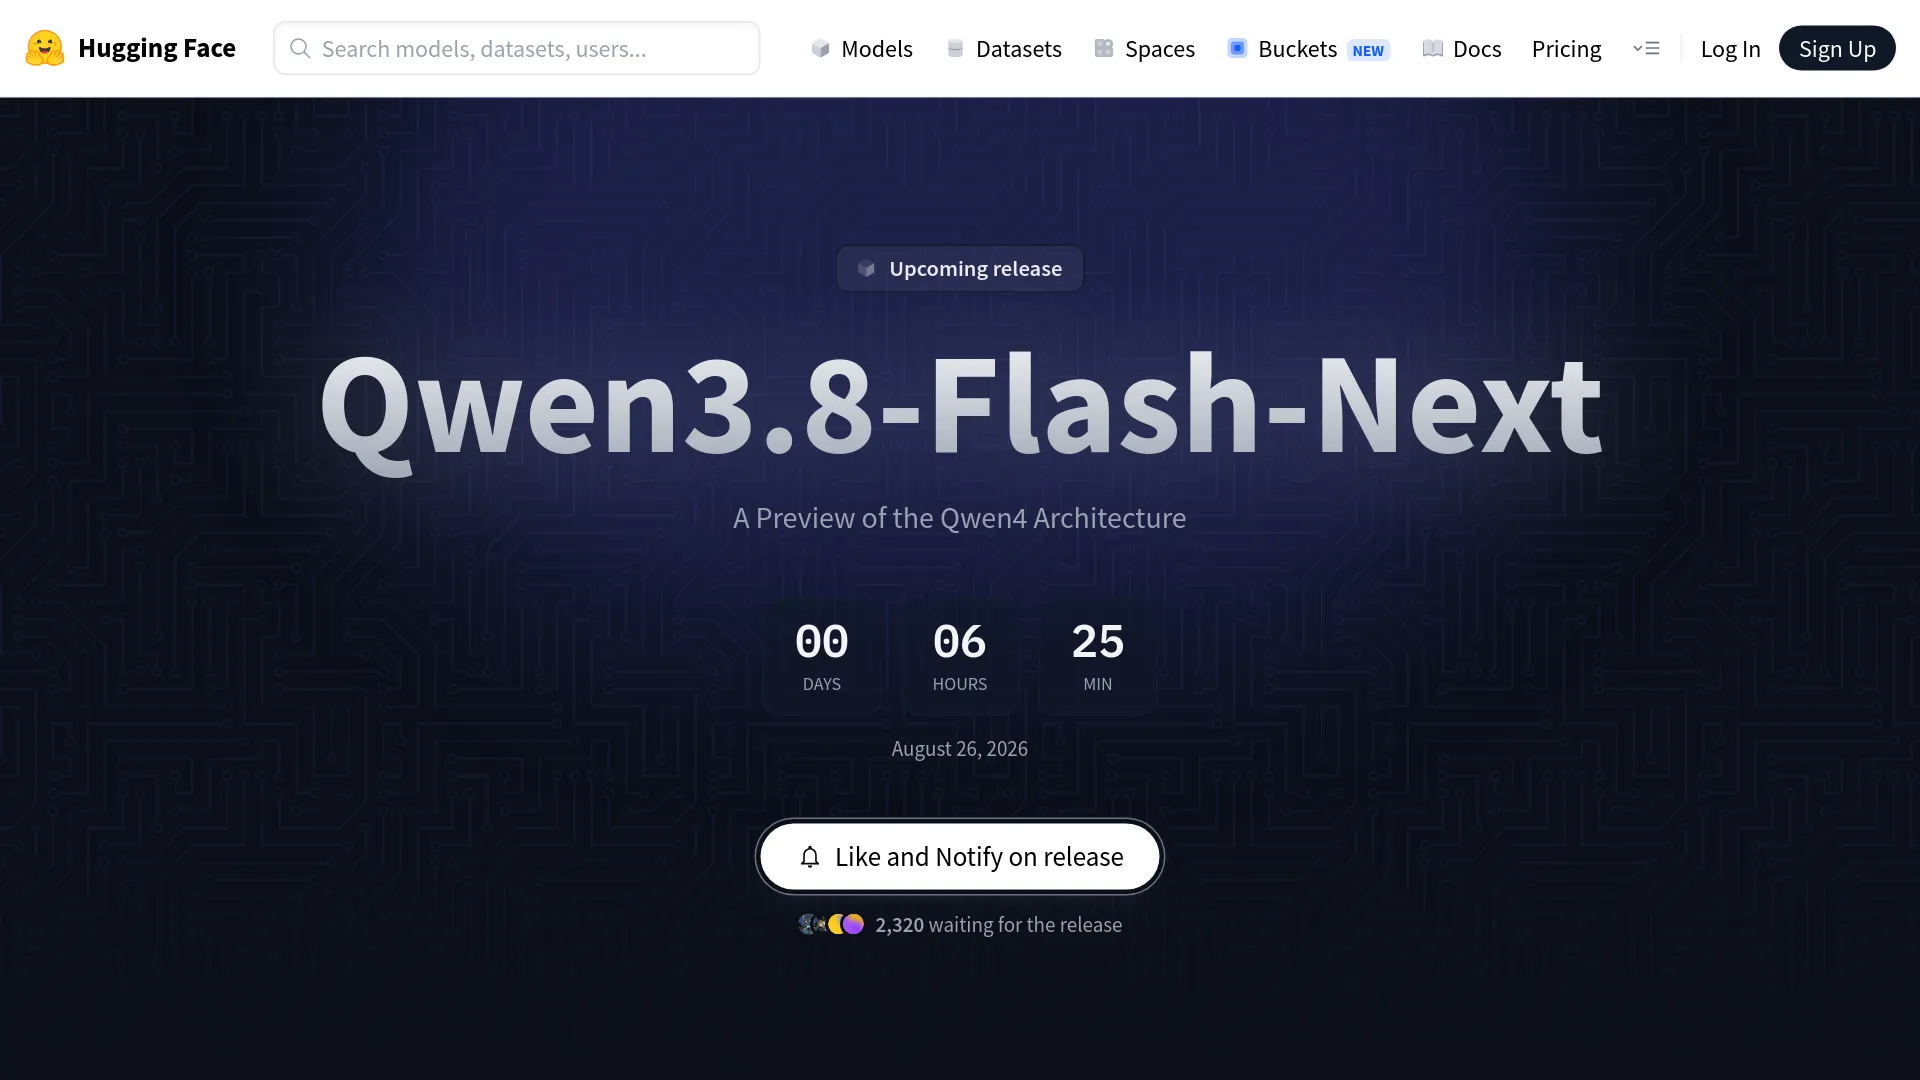
2026 年 8 月 25 日,阿里巴巴 ModelScope 为 Qwen3.8-Flash-Next 上线了倒计时页面。这个模型的特别之处在于:它会先于所属的产品家族,提前把全新架构带到开发者面前。截稿时,模型权重预计将在 8 月 26 日 23:00(UTC+8)发布。Qwen 团队这么做的目的很明确——在 Qwen4 正式到来前,给开源推理生态留出时间开发内核、量化方案和服务支持。
Qwen3.8-Flash-Next 到底是什么,又不是什么
Qwen3.8-Flash-Next 是一款多模态混合专家模型(MoE),采用了面向下一代 Qwen4 家族设计的架构。但它不是 Qwen4 本身。更准确地说,它是一款技术演示模型:通过一个可以实际运行的模型,把新的注意力机制、层结构和稀疏模式先展示出来,让推理框架能够在 Qwen4 全面发布前完成适配。
Qwen 团队在 Hugging Face 页面上将其标注为“即将发布”,并称其为“Qwen4 架构预览”。ModelScope 倒计时页面使用的宣传语则是“迈向下一代——闪电般快速。”这两个页面都来自 Qwen 官方渠道,因此发布本身已经得到确认,只是在撰写本文时,模型还没有完整上线。
目前可以确定的信息,以及仍停留在社区推测阶段的部分如下:
| 官方渠道已确认 | 尚未确认 |
|---|---|
| 将在 ModelScope 和 Hugging Face 开放权重 | 最终参数规模(125B/6B/51B) |
| 支持多模态(视觉 + 文本) | 许可证(参考以往惯例,很可能是 Apache 2.0) |
| 采用 GDN 混合架构和 Qwen Sparse Attention | 任何形式的基准测试成绩 |
提供 FP8 版本(Qwen/Qwen3.8-Flash-Next-FP8) | API 定价或可用性 |
| 作为 Qwen4 的架构预览 | 上下文长度(社区推测原生 256K,最高可扩展至 1M) |
目前大家反复引用的参数数字——总参数 125B、每个 token 激活 6B、51B 的 n-gram 嵌入——来自一张曾短暂出现在 ModelScope、后来被 Qwen 团队删减的模型卡。这组数字看起来合理,在多位独立观察者之间也基本一致,但不能视为稳定的官方文档。SaaSCity 创始人 ghosty 的评价很直接:
“今天就发这个模型基准测试图的人,都是自己编的。”
这套架构为什么会改变推理框架的适配方式
Qwen3.8-Flash-Next 有三个架构组件,使它与当前 Qwen 产品线中的模型明显不同。它们都要求推理框架增加新的内核代码,而不是简单改一个配置项就能完成适配。
GDN 层:固定大小的循环状态,降低长上下文内存占用
门控 Delta 网络(Gated Delta Network,GDN)取代了大多数层中的标准注意力。标准 Transformer 注意力需要维护会随序列长度增长的 KV Cache,而 GDN 使用固定大小的循环状态。在 GDN 层中,无论上下文有多长,内存占用都保持不变,计算复杂度也从二次增长降为线性增长。混合架构中的全注意力层仍然会使用 KV Cache,以保证精确的信息检索能力。
实际意义在于:长上下文任务的成本有望大幅下降。一段长达 100K token 的对话,不再需要为 KV Cache 预留相当于 100K token 的内存。根据社区对那张短暂可见的 ModelScope 模型卡进行的分析,Qwen3.8 架构预计采用69 个 GDN 层和 23 个全注意力层,比例约为 3:1。全注意力层负责保留全局检索能力,GDN 层则承担大部分序列处理工作。
这并不是 Qwen 第一次尝试类似方案。Qwen3-Next(2025 年 9 月)已经引入了 Gated DeltaNet,总参数 80B、激活参数 3B;据报道,Qwen3.5/3.6/3.7 系列也延续了类似的混合模式。Flash-Next 真正的新意在于规模:它把这套架构扩展到了总参数 125B,同时加入了下面两个组件。
QSA:稀疏注意力,具体实现仍是谜
Qwen Sparse Attention(QSA)虽然出现在模型卡上,但目前没有详细说明。社区普遍认为,它会用稀疏模式取代密集注意力:每个 token 只关注其他 token 的一个子集,而不是整个序列。至于 QSA 采用的是学习型稀疏、块稀疏、滑动窗口,还是几种方案的组合,目前都没有答案。等技术报告发布后,我们才能判断 QSA 究竟只是渐进式优化,还是一种真正全新的注意力基础组件。
51B 的 n-gram 表:无需草稿模型的推测解码
最不寻常的设计,是一个拥有 51B 参数的 n-gram 嵌入表。社区目前的工作假设是,它可能充当一种快速 token 查找机制,本质上相当于把用于推测解码的草稿模型集成进了系统。传统推测解码需要先运行一个独立的小模型,预测接下来的几个 token,再交给主模型验证;n-gram 表则可能直接提供低成本的下一 token 候选。
这里还有几个关键问题没有答案:这张表必须放进显存,还是可以通过内存映射使用?量化后表现如何?它是否已经包含在 125B 的参数统计中,还是需要另行计算?在技术报告或首批社区基准测试给出答案之前,最好把 51B 视为部署规划变量,而不是确定的硬件成本。
Flash-Next 在 Qwen 家族中的位置
Flash-Next 更像是一条并行探索路线,而不是产品线上的线性下一代:
| 模型 | 发布时间 | 总参数 | 激活参数 | 定位 |
|---|---|---|---|---|
| Qwen3-Next | 2025 年 9 月 | 80B | 3B | 首次测试 GDN 架构 |
| Qwen3.8-27B | 2026 年 8 月 | 27B(稠密) | 27B | 中端稠密模型主力 |
| Qwen3.8-Max | 2026 年 8 月 | ~2.4T | ~95B | 旗舰级开放权重模型 |
| Qwen3.8-Flash-Next | 2026 年 8 月 26 日 | ~125B | ~6B | Qwen4 架构预览 |
| Qwen4 | 待定(数月后) | 未知 | 未知 | 完整的下一代产品家族 |
社区目前使用的一个经验公式是:sqrt(125B x 6B) = 27B。如果这个估算成立,Flash-Next 的能力可能大致接近 27B 稠密模型,但推理计算量更接近 6B 模型。不过,Beer And Code 的 Lucas Souza 也提醒,这只是经验法则,不是定理——路由质量、数据质量以及 n-gram 表的实际贡献都还没有经过测量。
多份社区分析都把 Qwen 的这套策略称为“平台布局,而不是基准测试布局”。简单说,就是让 llama.cpp、vLLM 和 SGLang 等推理框架在 Qwen4 发布前完成内核支持。Unsloth 已宣布会争取在模型发布当天提供支持。
到底能不能跑?先看看硬件现实
| 格式 | 大致权重内存 |
|---|---|
| BF16 / FP16 | ~250 GB |
| FP8 | ~125 GB |
| Q4 / 4-bit | ~65–70 GB |
以上数字只计算模型权重,还没有包括上下文、KV Cache 和运行时开销。Q4 量化模型的主权重大约需要65–70 GB,此外还要看 51B n-gram 表需要多少空间。如果 n-gram 表必须放入显存,总需求会超过大多数单机配置的承受范围。如果它可以映射到系统内存,那么配备 128GB 以上统一内存的系统——例如满配的 Mac Studio(M2 Ultra / M3 Ultra)、AMD Strix Halo、NVIDIA DGX Spark——或许可以运行。单张 RTX 4090 或 5090 肯定不够。
在 Reddit 上,u/KURD_1_STAN 质疑了“适合本地运行”的说法:“内存价格这么高,你怎么能说它适合本地运行?”“每个 token 只激活 6B 参数”的宣传,与 250GB 的内存需求之间,确实存在明显落差。X 用户 @Dicklong1999 则指出,稀疏激活模式可能让实际生成速度对硬件充足的用户来说还算合理,但“125B,普通人基本可以不用考虑本地运行了”。
API 可用性和价格,现在能知道什么
截至本文发布时,Qwen3.8-Flash-Next 的 API 价格和可用性尚未公布。Qwen3.8-Max 在 Qwen 官方定价页面上的价格是输入 $2.00/M、输出 $6.00/M;考虑到 Flash-Next 每个 token 只激活 6B 参数,它的价格应该会低得多。FP8 版本可以将权重内存需求降至 BF16 的一半,因此很适合作为 API 服务格式。至于具体哪些平台会提供服务,还要取决于推理框架的适配进度,权重发布后可以到各家供应商目录中查看。
权重发布前,开发者应该做什么
如果你是开发者或研究人员,正在评估 Qwen3.8-Flash-Next 是否值得接入现有技术栈,可以先按下面的清单准备:
1. 检查硬件。如果打算本地运行,先确认设备拥有 128GB 以上统一内存,或准备好多 GPU 配置。如果不满足这些条件,就按 API 访问来规划。
2. 关注 Hugging Face 仓库。模型卡会首先给出实际规格、许可证和上下文长度等权威信息。可以收藏 huggingface.co/Qwen/Qwen3.8-Flash-Next。
3. 提前准备评测流程。在权重发布前准备好基准测试提示词和评测脚本。权重上线后的前 24 小时,社区测试结果往往比任何官方数字都更有参考价值。
4. 不要切换生产任务。目前还没有独立基准测试。架构本身较新,运行时支持尚不成熟,许可证也没有确认。现阶段适合用于评估,不要把它用于一旦出问题就会造成经济损失的任务。
5. 如果你维护推理工具,现在就可以开始。GDN + QSA 组合需要真正开发内核,而不是修改配置。越早理解这套架构,就越有机会更快发布支持。
常见问题
权重什么时候可以下载?
ModelScope 倒计时指向2026 年 8 月 26 日约 23:00(UTC+8)。Hugging Face 镜像通常会在 ModelScope 发布后的数小时内出现。Qwen 团队已经通过官方渠道确认了时间——@Alibaba_Qwen 预告了“今晚我们会带来什么惊喜”,@QwenDevs 也直接点名了该模型。
这就是 Qwen4 吗?
不是。这是使用 Qwen3.8 命名方式发布的 Qwen4 架构预览。Qwen4 本身预计还要数月,而不是几周后发布。Flash-Next 的作用,就是让生态在完整产品家族到来前提前准备运行时支持。
它采用什么许可证?
尚未确认。近期的 Qwen 开放权重模型(Qwen3.8-27B、Qwen3.8-Max)都采用了Apache 2.0,因此这也是最可能的结果。权重上线后,请以模型卡中的信息为准。
能在 RTX 4090 上运行吗?
不能。即使使用 Q4 量化,光是主权重也需要约 65–70 GB,而单张 RTX 4090 只有 24 GB 显存。你需要配备 128GB 以上统一内存的系统(Mac Studio、Strix Halo),或多张高显存 GPU。
它会超过 Qwen3.8-27B 吗?
未知。目前没有任何基准测试。sqrt(125B x 6B) = 27B 这一经验公式暗示,它的能力可能接近 27B 稠密模型,但这只是估算,并非实测结果。还是要等针对具体使用场景的独立评测。
它会有多快?
每个 token 激活 6B 参数,意味着它的生成速度可能更接近小模型,而不是 125B 规模的庞然大物。但 n-gram 表的内存访问模式,以及 GDN 内核的执行效率,目前都是未知变量。首批社区基准测试会给出答案。
它会登陆 API 平台吗?
几乎可以确定会。FP8 版本本身就很适合用于 API 服务。AIReiter 和其他平台通常会在权重发布后的数天内接入 Qwen 模型。真正的瓶颈,在于各类推理框架能否支持这些全新的注意力机制。
去年的 Qwen3-Next 后来怎么样了?
Qwen3-Next 于 2025 年 9 月发布,总参数 80B、激活参数 3B,并首次引入 Gated DeltaNet。它是一次规模更小的架构测试,证明了 GDN 混合方案确实可行。Flash-Next 则是它的放大版续作。X 用户 @LufzzLiz 曾评价去年的 Next 系列“令人失望”——这也正是这一次必须等待基准测试结果的原因。