 AIREITER
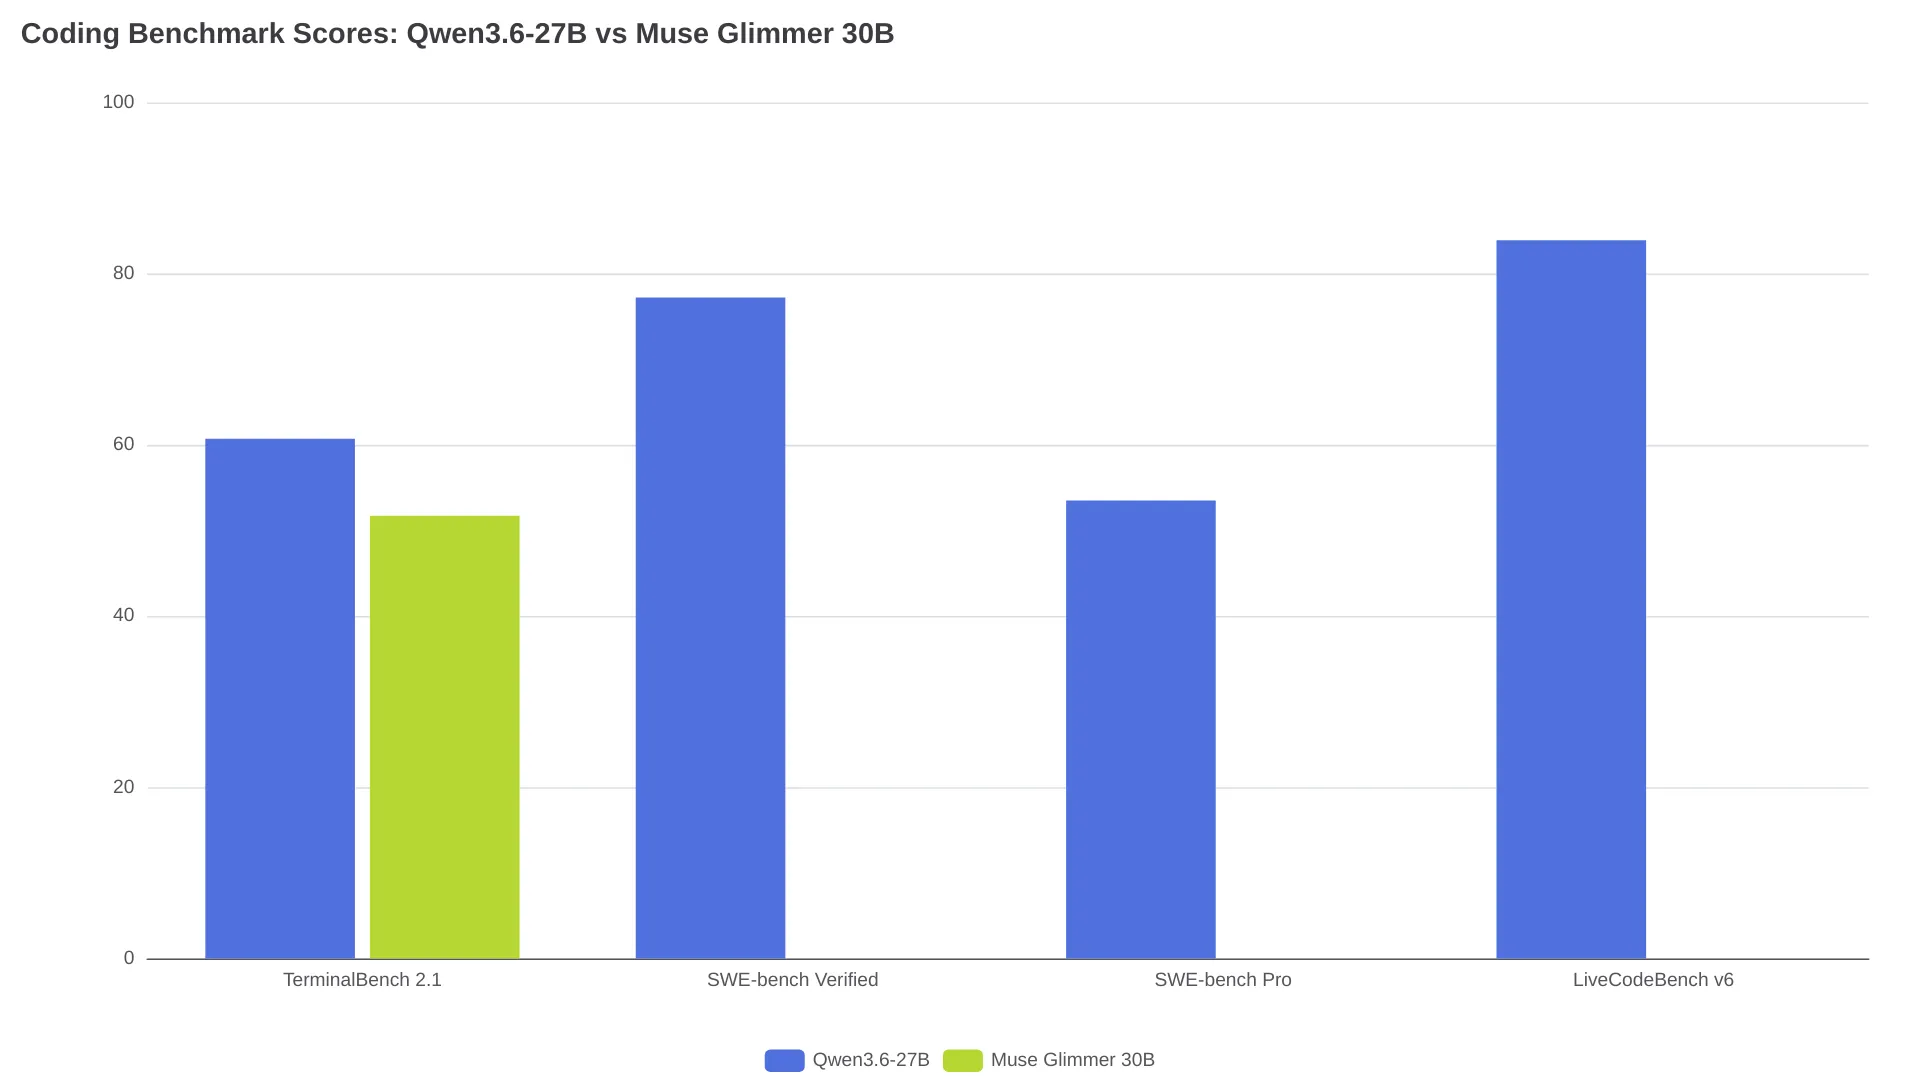
如果只看编程基准,结论很明确:Qwen3.6-27B 在 TerminalBench 2.1 拿到 60.7 分,Muse Glimmer 30B 为 51.7 分;Qwen 官方公布的 SWE-bench Verified 成绩则达到 77.2。不过,模型能否在你的本地硬件上真正跑起来,同样重要。Muse Glimmer 在单卡显存和长上下文方面的优势,足以改变部分用户的选择。Qwen3.6-27B 于 2026 年 4 月发布,并在其 Hugging Face model card 中给出了完整基准表;Meta 的开放权重模型 Muse Glimmer 30B 则在 2026 年 8 月 随后发布,几天内便迎来了本地 LLM 社区的正面对测。
TerminalBench 2.1:Qwen 领先 9 分
TerminalBench 主要考察终端智能体完成多步骤任务时的可靠性,覆盖工具调用,以及长时间会话中的上下文维持能力。在相关社区讨论中,TerminalBench 2.1 是目前最常被引用的两者正面对比编程智能体结果。
以下为 2026 年 8 月 10 日至 11 日 r/LocalLLaMA 讨论中出现的社区报告 TerminalBench 2.1 分数:
| 模型 | TerminalBench 2.1 | 来源类型 |
|---|---|---|
| Qwen3.6-27B | 60.7 | 社区报告 |
| Muse Glimmer 30B | 51.7 | 社区报告 |
| Gemma 4 31B | 43.4 | 社区报告 |
需要注意的是,TerminalBench 测量的并非纯粹的基础模型能力,而是模型与测试框架的组合表现。Qwen3.6-27B 官方卡说明,其测试采用 Harbor/Terminus-2 框架,超时设为 3 小时,配备 32 个 CPU、48 GB RAM、80K 最大输出、256K 上下文,并取五次运行的平均值。Glimmer 的分数可能来自不同或优化程度较低的框架配置,因此这 9 分差距在不同智能体设置下可能缩小,也可能扩大。
公开编程基准:Qwen 有官方数据,Glimmer 暂缺
Qwen3.6-27B 已在其 model card 中公布官方基准成绩。截至 2026 年 8 月,在本次对比查阅的关联来源中,尚未发现 Muse Glimmer 的官方 SWE-bench、LiveCodeBench 或同类智能体编程基准结果。因此,Qwen 拥有更完整的公开证据支持,但两者之间尚不存在可直接对照的官方测试。
Qwen 公布的官方编程基准如下:
| 基准 | Qwen3.6-27B(官方) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
这些均为厂商自行发布的结果。model card 指出,SWE-bench 测试使用 Qwen 内部的 bash/文件编辑脚手架,温度设为 1.0、top-p 为 0.95,上下文窗口为 200K。SWE-bench Pro 的结果基于一套经过修订的任务集计算,其中 Qwen 修正了存在问题的条目,因此未必能与公开排行榜的数值直接横比。第三方 morphllm 也指出,这些结果依赖 Qwen 自身的智能体脚手架,独立复现仍较有限。
本地实测:开发者实际遇到了什么
M5 Pro 上的 OpenCode Q4 测试
一位开发者通过 OpenCode,在配备 48 GB RAM 的 M5 Pro 上测试了 Q4 量化的 Muse Glimmer(Unsloth build)。模型大约占用 20 GB RAM,生成速度为 17 tokens/second。其结论是:
“总体上仍低于 Qwen3.6 27B” - u/curiousily_
在前端和后端编程输出上,测试者认为 Muse Glimmer 都不如 Qwen;但也提到一个优点:整个测试过程中,Muse Glimmer 没有发生工具调用失败。该测试没有配置推理循环或延长思考,这可能限制了 Glimmer 的发挥。
别把 max_tokens 设得太紧
另一位 r/LocalLLM 测试者发现,若输出 Token 预算过低,Muse Glimmer 看起来会比实际能力差得多。模型会先将 Token 预算消耗在推理上,尚未生成可见结果便已耗尽,最终得到空白或截断的回答。仅提高 max_tokens,不改动模型本身,便让其测试框架的通过任务数从 6/13 提升到 11/13,接近翻倍。如果你拿默认输出限制测试 Glimmer,测到的或许是配置问题,而不是模型能力。
Hermes 下的终端命令循环
还有用户反馈,当 Muse Glimmer 配合 Hermes 智能体框架使用时,会陷入大量终端命令的循环;同一套设置下,他们没有在 Qwen3.6-27B 身上遇到这一情况。这个案例在方向上与现有的 TerminalBench 差距一致,但无法将模型本身与 Hermes 配置的影响完全分离。
Token 效率:目前只是积极信号
u/NoFaithlessness951 发布的基准展示帖提出了另一个值得关注的角度:
“比 Qwen 稍微没那么聪明,但每个任务消耗的 Token 少得多。” - u/NoFaithlessness951
这只是社区的定性观察,并非对每个成功任务 Token 消耗的受控测量。目前没有正面对比研究在相同任务、成功率和延迟数据条件下,量化 Glimmer 相比 Qwen 的 Token 优势。可以将其视为一个有潜力的线索,而非已经确立的事实。
显存与上下文:Glimmer 的硬件优势
Muse Glimmer 的真正强项在这里。一位 r/LocalLLaMA 测试者演示称:Muse Glimmer 30B 使用 Q4_K_XL、DFlash speculative decoding、多模态 projector 以及完整 F16 KV cache 时,可在单张 RTX 3090 的约 22-23 GB 显存内运行,并配置 262,144-token 上下文窗口。
在同一张 RTX 3090、同样采用 Q4_K_XL 量化的条件下:
| 模型 | F16 KV 上下文 | Q8 KV 上下文 | 显存占用 |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | 可装入 24 GB |
| Gemma 4 31B | 52,000 | 81,000 | 可装入 24 GB |
对于需要将大型代码仓库上下文直接放入提示词的工作流,该测试作者将 Qwen 的 70K F16 上下文形容为“勉强可用”。
上述 RTX 3090 配置下,Muse Glimmer 的报告吞吐表现为:
- 生成速度:64-124 tokens/second,视代码或自然语言内容而变化
- 提示词处理:~1,400 tokens/second
- 长上下文检索:首次尝试即通过约 150K tokens 的双针寻草堆测试
同一硬件上的 Qwen3.6-27B 若要获得更长上下文,要么使用 Q8 KV cache 压缩,以输出保真度换取上下文长度;要么卸载到性能更强的机器。该测试者表示,在需要完整上下文时,会将 Qwen 移至自己的 DGX Spark 上运行,而这是一台贵得多的设备。
在更高端硬件上,根据 kie.ai 的基准分析,Qwen3.6-27B 的 NVFP4 build 在 DGX Spark 上可在最高 128K 的不同上下文长度下,单会话达到 28-33 tokens/second。与此同时,RTX 5090 上的 Unsloth Muse Glimmer Q5_K_M build 据称通过经修改的 llama.cpp DFlash 路径,在代码补丁生成中达到 220-253 tokens/second。
不同场景该选哪个模型?
| 你的场景 | 推荐选择 | 原因 |
|---|---|---|
| 纯编程、一次性代码生成 | Qwen3.6-27B | 公开编程基准证据更强,并在现有 TerminalBench 2.1 社区对比中领先 |
| 单张 24 GB GPU 上进行大上下文智能体编程 | Muse Glimmer 30B | 同一硬件的 Q4_K_XL/DFlash 设置下,可提供 262K F16 上下文,Qwen 为 70K |
| 长链路终端任务 | Qwen3.6-27B | TerminalBench 2.1 为 60.7 对 51.7;Glimmer 还有智能体框架循环的社区报告 |
| 高吞吐、成本敏感的工作负载 | Muse Glimmer 30B(可能更适合) | 一份社区报告认为其单任务 Token 消耗更低,但尚无按成功率匹配的成本对比 |
| 大代码仓库上下文编程 | Muse Glimmer 30B(显存受限时) | 在 24 GB 显存上,Qwen 需要 Q8 KV 压缩或多 GPU 才能支持大上下文 |
| 追求最高编程准确率,硬件不受限 | Qwen3.6-27B | 公开基准更强,且有官方成绩支持 |
常见问题
Muse Glimmer 有官方 SWE-bench 分数吗?
没有。截至 2026 年 8 月,在本次对比查阅的来源中,尚未找到 Muse Glimmer 30B 的官方 SWE-bench、LiveCodeBench 或 TerminalBench 分数。51.7 的 TerminalBench 2.1 成绩来自 Reddit 讨论串中的社区测试,并非 Meta 官方评测。
两个模型都能在单张 RTX 3090 上运行吗?
可以。Muse Glimmer 30B 使用 Q4_K_XL 时,可在约 22-23 GB 显存内提供 262K 上下文和完整 F16 KV cache。Qwen3.6-27B 使用 Q4_K_XL 也能装入同一张卡,但 F16 上下文仅限 70K;采用 Q8 KV cache 压缩后可达 125K。
Muse Glimmer 在编程任务上会拒答吗?
一位用户报告称,Muse Glimmer 拒绝协助调试 Python 鼠标控制代码,并将其视为潜在安全问题。这只是单一案例,且系统提示词和配置均未说明,无法据此判断该行为源自模型本身还是推理设置。
哪个更适合智能体编程工作流?
从 TerminalBench 分数和社区反馈看,Qwen3.6-27B 在长链路终端智能体任务上更可靠。Muse Glimmer 30B 则凭借显存效率更适合受限硬件;它也可能在每项任务中使用更少 Token,从而降低高吞吐智能体循环的成本和延迟,但目前尚无受控对比量化这一点。
Muse Glimmer 做编程时,max_tokens 应该设多少?
建议给出充足的输出预算。一位测试者发现,过紧的 max_tokens 限制会让 Glimmer 在生成可见输出前便将预算耗在推理上,导致空白或截断回答,看起来像是任务失败。提高限制后,其测试框架的通过任务数从 6/13 升至 11/13。Qwen3.6-27B 的 model card 建议一般查询使用 32,768 tokens,困难基准任务使用 81,920;在 Meta 发布自身指南前,可将相同的输出预算作为 Glimmer 的合理起点。