 AIREITER
多向量嵌入模型如今正式进入 Sentence Transformers 的核心能力版图。2026 年 8 月 18 日发布的 6.0 版,在稠密模型、稀疏模型和 reranker 之外,新增了 MultiVectorEncoder。不过,Hugging Face 的发布基准并没有渲染出一场碾压式胜利:晚交互在 13 个 NanoBEIR 数据集里赢了其中 9 个,相比完全对应的稠密模型,平均只领先约 1 个 NDCG@10 点;代价则是示例中的原始索引达到 384 维 MiniLM 基线的 42 倍,即使对比同级稠密模型也有 21 倍。值不值得为这笔成本买单,几乎完全取决于你的查询和文档长什么样。
多向量与晚交互,到底在算什么
稠密嵌入会把整篇文档池化成一个向量;多向量模型则保留每个 token 各自的向量。Hugging Face 当前支持的模型通常使用 128 维 token 向量,而常见稠密嵌入则是 384、768 或 1,024 维。检索打分时,MaxSim 会为每个查询 token 找到与任一文档 token 的最高点积,再把这些最大值相加:MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ)。对于经过 L2 归一化的模型,每一项都落在 [-1, 1] 区间,最终分数会随查询长度增长。
它处在两类既有架构之间,吸收了各自的一部分特征:
| 架构 | 文档侧表示 | 打分方式 | 成本特征 |
|---|---|---|---|
| 稠密双编码器 | 预先计算的单个池化向量 | 一次点积 | 检索最快,但池化会丢失 token 细节 |
| 晚交互 | 预先计算的逐 token 向量 | 对 token 对执行 MaxSim | 匹配信息更丰富;索引随文档长度膨胀 |
| 交叉编码器 | 不预计算表示 | 每个查询—文档对完整前向推理 | Hugging Face 发布文章中每对样本准确度最高;但不适合作为第一阶段检索 |
最初的 ColBERT 论文将这种方法概括为“上下文化晚交互”。
它的价值体现在 token 粒度的对齐上。Hugging Face 的 lightonai/mLateOn 示例中,查询词 token “live”与文档 token “inhabit”的相似度达到 0.94:两者词面毫无重合,却实现了语义匹配。
哪些检索任务最能发挥多向量优势
短文本段落基准并不足以体现多向量模型真正擅长的场景。本文对比的五份资料——Hugging Face 的发布文章、TopK、Qdrant 的工程文章、Data AI Hub 的生产实践指南和 Suhas Bhairav 的生产搜索对比——反复指向以下几类任务:
- 语义搜索中的精确标识符。例如产品编号、函数名、姓氏、错误字符串和条款编号。单向量池化容易把它们模糊掉,逐 token 向量则仍能精确定位。
- 包含多个条件的查询。例如“带有 Y 和 Z 的 X”。每个查询 token 都能独立找到支撑它的文档 token,不会有条件在平均过程中被冲淡。
- 答案藏在长文档小段落中的场景。在多语言长文档基准 MLDR 上,多向量模型
mLateOn得分为 77.92,mDenseOn为 51.59;这个差距比短段落基准的平均差距大一个数量级。 - PDF、表格与扫描页面。ColPali 系列模型可以直接索引页面图像,并用文本查询,无需 OCR。Hugging Face 的发布文章将视觉文档检索称为晚交互的 SOTA 领域;TopK 的分析则显示,在 ViDoRe v3 上,一个紧凑型多向量检索器以 +34% 的召回率击败了体积为其 80 倍的单向量模型,工业文档召回率也从约 42% 升至 76%。
- 领域外词汇。Hugging Face 的发布文章报告了模型在领域外数据上的提升。稠密模型在训练中学到的压缩机制,可能恰好丢掉生产查询需要的细节。
Hugging Face 的数据也解释了视觉检索为什么特别适配这条路线:对于 colqwen2.5-v0.2,一张渲染后的页面大约会产生 755 个 token 向量,而平均文本段落只有约 125 个。图表、版式和表格越丰富,单一池化向量需要舍弃的信息就越多。
效果确有提升,但没到颠覆级别
最干净的对照来自 LightOn 的配对模型:LateOn 和 DenseOn 共用同一个 149M 参数的 ModernBERT 骨干网络,也使用相同训练数据。区别只在输出头:前者生成 128 维 token 向量,后者生成一个 768 维文档向量。
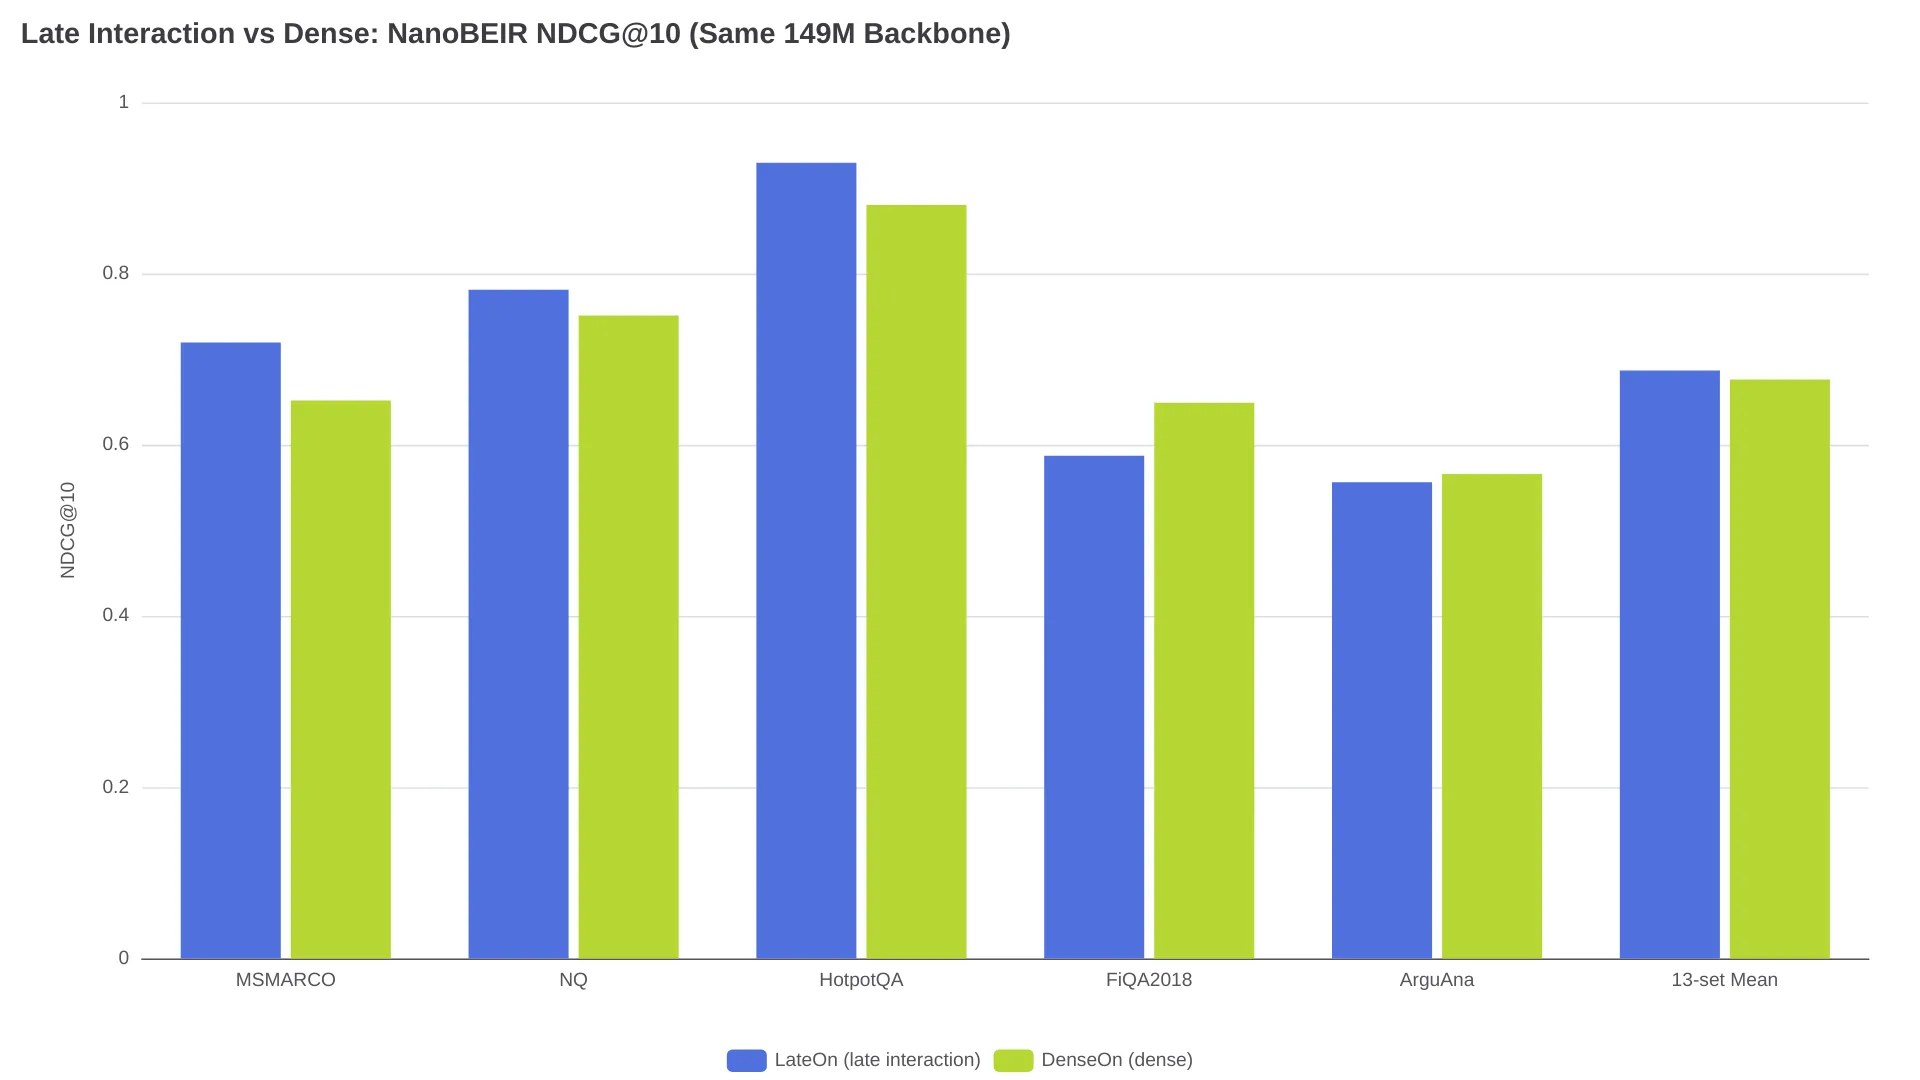
在 13 个 NanoBEIR 数据集里,LateOn 赢下 9 个,平均 NDCG@10 为 0.6868,对比 DenseOn 的 0.6764。完整 15 数据集 BEIR 上,两者分别为 57.22 和 56.20。不过,DenseOn 在 ArguAna、FiQA2018、SCIDOCS 和 SciFact 上仍然直接胜出。这才是更诚实的结论:在相同模型规模下,多向量带来了有意义的平均提升,但不是跨代升级。
维护者 Tom Aarsen 宣布 v6.0 后,开发者 @saen_dev 提出了许多实践者反复追问的问题:“它在特定领域语料上,和双编码器相比表现如何?”(讨论串)。答案仍是平均约 1 个点,显著提升主要集中在长文档;Hugging Face 自己也在发布文章中建议用户用实际检索任务评估,因为不同数据集上的收益差异很大。
存储成本:未压缩时就是 42 倍
Hugging Face 用 4,874 个 Natural Questions 段落估算了索引大小。lightonai/LateOn 为这些段落生成了 608,414 个 token 向量,平均每段 124.8 个。
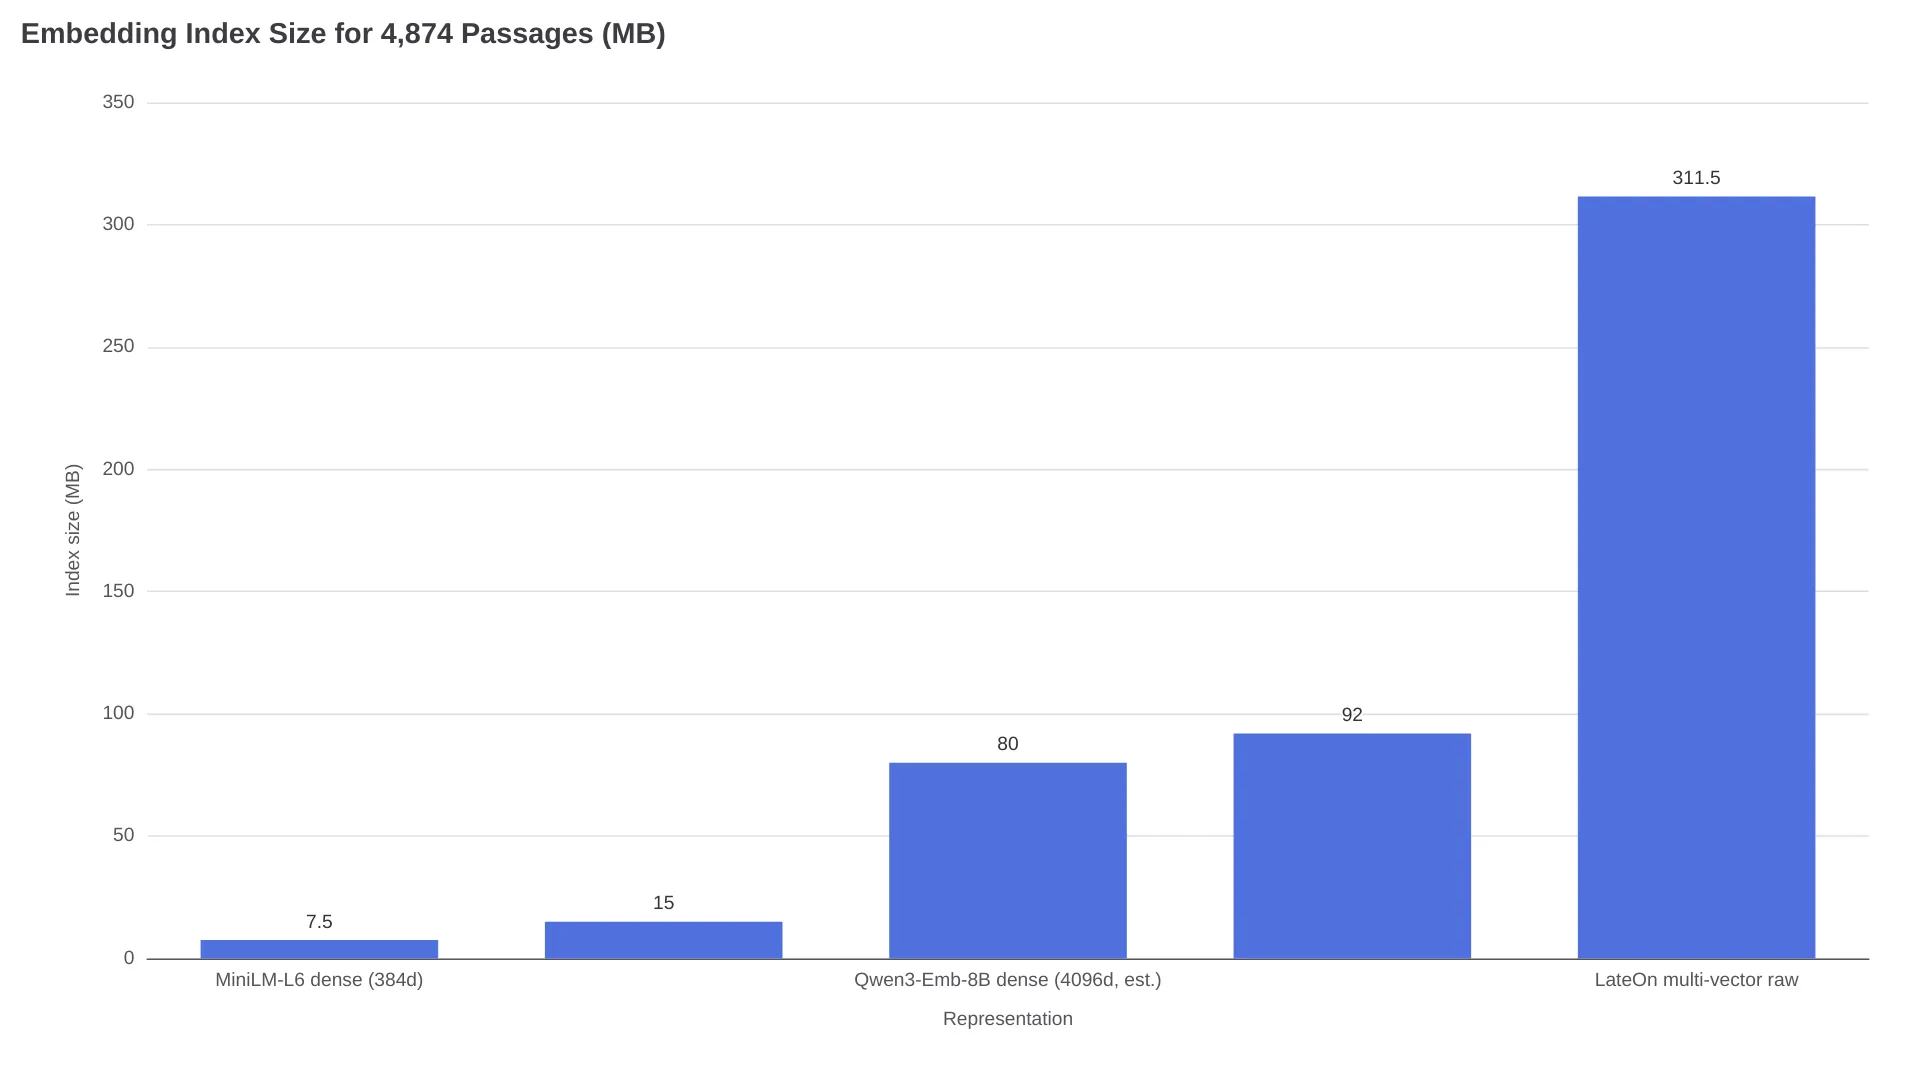
原始 float32 多向量索引占用 311.5 MB。相同段落使用 all-MiniLM-L6-v2 稠密模型只需 7.5 MB,差距为 42 倍,或每段 62 KiB。若对比同级的 768 维稠密模型 gte-modernbert-base,差距仍有 21 倍(15 MB)。TopK 给出的范围是 10–100 倍,具体取决于文档长度和精度;每次查询的打分工作量也可能是单向量比较的数千倍。
发布当天,一位开发者直接点出了上线的核心顾虑:
决定它能不能上线的是 token pooling。晚交互通常不是死于准确率,而是死于索引大小和内存。- X 上的 @JudeJobs
再作一个规模参照:同一语料上的 4,096 维 Qwen3-Embedding-8B 稠密索引约为 80 MB,已经接近下文压缩后晚交互索引的 92 MB。
把索引缩小的三种办法
1. Token 池化。Sentence Transformers v6.0 提供了 HierarchicalTokenPooling:它基于余弦距离,使用 Ward linkage 聚类文档 token 向量,并以每个簇的均值替代原始向量。默认只处理文档,因为查询通常较短,对失真更敏感。在这套包含 608,414 个向量的语料上:
| 池化系数 | Token 向量数 | float32 索引 | 报告的检索效果保留率 |
|---|---|---|---|
| 1(不池化) | 608,414 | 311.5 MB | 100% |
| 2 | 305,438 | 156.4 MB | 100.6% |
| 3 | 204,407 | 104.7 MB | 99.0% |
| 4 | 153,936 | 78.8 MB | 约 98% 的趋势 |
全量语料的池化耗时约 6 秒。LightOn 的正则化变体在 Hugging Face 文章中报告称,5 倍压缩时仍能保留 99.4% 的质量;但 Hugging Face 也指出,截至 v6.0 发布时,库中还没有集成使用该正则器的训练流程。
2. 压缩索引。相同向量构建的 fast-plaid(Rust PLAID)索引为 92 MB,构建用时 5 秒,在 RTX 3090 + i7-13700K 上的查询耗时为 11 ms。它采用近似检索——Hugging Face 测试中最高分从 11.92 偏移到 11.88——但排序没有变化。Weaviate 的 MUVERA 将写入速度提升 3 倍、查询速度提升 1.8 倍,不过在其测试语料中,top 50 少了一个正确结果。
3. 量化与推理调优。Qdrant 对 token 嵌入使用 uint8 标量量化的实验,将内存降至原来的 1/4,而 SciFact NDCG@10 仅从 0.70724 变为 0.70297,影响可忽略。Hugging Face 报告称,fp16 配合 Flash Attention 的编码吞吐量达到 fp32 的 2.44 倍,未测得质量损失;CPU 上使用 int8 的准确率代价约为 0.4%。
将 2–3 倍池化与压缩索引叠加后,相比稠密模型的有效差距可从 42 倍缩小到个位数,但也意味着需要多调两个参数。
默认部署方式:先召回,再用晚交互重排
在单张 RTX 3090 上,对全部 4,874 篇文档做穷举 MaxSim 打分耗时 98 ms,端到端为 122.7 ms;几千篇文档完全可接受,但面对数百万篇文档,其线性成本会成为灾难。本文比较的三份部署指南最终都落在同一架构上:先由低成本稠密或稀疏检索召回候选集,再交给晚交互重排。
- Hugging Face 的示例先取稠密检索 top 50,再用 MaxSim 重排。文档只需批量编码一次,评分依靠矩阵乘法,远比交叉编码器对每个文档对单独前向推理便宜。
- Qdrant 从 v1.10 起提供原生多向量支持,建议晚交互主要用于重排数百个候选,而不是全量扫描。
- Data AI Hub 的生产指南建议先做混合检索取 top 150,再经晚交互重排至 20 个,最后可选用交叉编码器筛出交给 LLM 的前 5 个。
只做重排有一个明确上限:第一阶段漏掉的文档,后续无法找回。而且,周边流水线远未收敛:
几乎不存在一种在所有场景下都好的分块、检索和重排策略。- u/gamerx88,r/MachineLearning
哪些数据库支持多向量,实际表现如何
Hugging Face 的发布文章在同一套 4,874 段落语料上测试了主要引擎。以下均为其测试结果,而非厂商营销数据:
| 引擎 | 原生多向量支持起始版本 | 写入 / 查询(其测试) | 注意事项 |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | 精确 MAX_SIM;建议使用服务器模式 |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA 更快,但漏掉一个正确结果;Windows 上没有嵌入式模式 |
| Vespa | “多年以前” | 约 80 s / 预热后 75 ms | 通过 tensor expression 实现 MaxSim;默认第二阶段只重排 100 个候选,漏掉了正确 top 3 中的 2 个 |
fast-plaid | - | 5 s / 11 ms | 无服务器;分数为近似值,但排序保持不变 |
| LanceDB | v0.15.0 | 未测试 | 原生 MaxSim |
| Milvus | v2.6.4 | 未测试 | 使用 array-of-structs 存储 |
| VectorChord | - | 未测试 | 面向 PostgreSQL 的 MaxSim 算子 |
| Elasticsearch / OpenSearch | - | - | 仅支持 rescore;ES 功能为 Enterprise 层级的技术预览 |
Hugging Face 的对比表中,turbopuffer 的晚交互索引仍被列为私有测试版。
Sentence Transformers v6.0 带来了什么
在 2026 年 8 月 18 日之前,运行 ColBERT 系列模型通常要依赖单独框架,如 PyLate、Stanford ColBERT repo 或 colpali-engine。6.0 版将 MultiVectorEncoder 作为库中的第四种一等模型类型,内置训练、推理和可解释性能力。它可加载 Sentence Transformers、PyLate、Stanford ColBERT 和 ColPali 的 checkpoint;也可以加载裸 transformer,但会使用需要训练的随机投影。环境要求为 transformers v5.x、torch 2.2+ 和 huggingface-hub v1.x。
发布文档里有三个容易踩坑的点:
- 查询和文档并不对称。
encode_query()与encode_document()会应用不同的提示词、长度上限和评分掩码。两边都调用通用encode(),是最容易在无提示情况下让结果变差的做法。 - 截断不会提醒你。一个 662 token 的段落送入 LateOn 的 300 token 文档上限后,只生成 273 个向量,其余内容被丢弃。把上限提高到 512 虽然可行,但会让模型偏离训练分布,同时增大索引。
- Flash Attention 并非通用。带有 non-attend query expansion 的模型,包括
colbert-ir/colbertv2.0和answerai-colbert-small-v1,应改用"sdpa"。
按 Hugging Face 公布的分数,支持的模型覆盖了两个数量级:
| 层级 | 示例模型(参数量) | 得分(平均 NDCG@10) |
|---|---|---|
| 边缘端文本 | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| 小型文本 | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| 文本领先模型 | LateOn family (149M) | 0.6868–0.6897 NanoBEIR |
| 视觉文档 | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
哪些情况下,稠密单向量仍是正确选择
应当避免的误区,是给根本不需要多向量的负载也套上多向量。若查询宽泛、偏主题性,例如“关于供应链的文章”;若文本很短,例如标题、FAQ 问答对或推文;若任务是聚类、去重或推荐——即任何需要整体条目相似度的场景——都不适合。另一种不该引入它的情况是:稠密召回加 reranker 已经满足你的 recall SLO,而真正的瓶颈是成本。Data AI Hub 的指南还指出,在多语言语料上,以英语为中心训练的 ColBERT checkpoint 可能不如“多语言双编码器加 reranker”的组合;写入频繁、要求实时更新的语料库,也不适合 token 级索引。
几个常见问题,用数据回答
普通稠密模型能当多向量模型用吗?
有时可以,而且效果出人意料地不错。Qdrant 的实验提取了 BAAI/bge-small-en——一个 33M 稠密模型——的输出 token 嵌入,再以 MaxSim 打分:其在 SciFact 上的 NDCG@10 为 0.73696,超过 colbert-ir/colbertv2.0 的 0.69579,也超过 bge-small 自身池化向量的 0.68213。但在 ArguAna 上顺序反转,池化稠密模型胜出。这可以是无需更换模型就增加重排阶段的一种有效技巧,但绝非普遍保证。
压缩后的多向量索引能快多少?
在这套 4,874 段落语料上:穷举 MaxSim 为 98 ms,fast-plaid 为 11 ms;索引从 311.5 MB 降至 92 MB。
多向量模型能取代交叉编码器 reranker 吗?
从计算成本看,可以:文档表示预先计算,评分使用矩阵乘法,而不是针对每个查询—文档对做一次前向推理。但 Hugging Face 的发布文章仍将交叉编码器列为逐对样本最准确的选项,因此要求更高的流水线仍会保留它,用于最终 top 5–20。
晚交互值得用于 RAG 吗?
适合用于混合或稠密候选集上的重排——这正是上文三份部署指南一致推荐的模式。若作为第一阶段检索器,前提是实测显示第一阶段 recall 正是故障点,并且 token 向量索引在预算范围内。
按工作负载选型
| 你的工作负载 | 建议 |
|---|---|
| 标识符密集或多条件查询、长文档、法律/技术文本 | 使用多向量检索或重排——这正是 MLDR +26 分的适用领域 |
| PDF、扫描页面、以页面图像形式存在的表格和图表 | 选 ColPali 系列多向量模型;无需 OCR 流水线 |
| 宽泛主题搜索、短文本、聚类/去重/推荐系统 | 选稠密单向量;池化损失在这里无关紧要 |
| 质量已接近目标,但预算紧张 | 保留稠密第一阶段,对 top 50–150 增加 MaxSim 重排 |
| 数百万文档且受成本限制 | 稠密 + 交叉编码器 reranker,或在测量后采用压缩晚交互(池化系数 2–3 + fast-plaid) |
@JudeJobs 指出的那项取舍至今仍没有标准答案:压缩保留率是在基准上测得的,不是在混乱的生产语料中测得的。先从 2 倍池化开始,再根据你自己数据上的 recall 决定是否继续沿着压缩曲线往下走。