 AIREITER
Modal 多节点任务的费用取决于完整资源分配,而不是某个单独的集群订阅费。Modal Clusters 目前已正式可用,但最终账单仍来自每个容器实际消耗的 GPU、CPU、内存、存储和网络资源。
一分钟看懂 Modal Clusters 价格
官方的 Modal 价格页面 和正式发布公告说明,Modal 采用按使用量计费,并通过 @modal.clustered 入口同时启动多个容器。可选的 RDMA 会改变通信路径,但不会改变基本计价公式。
GPU 数量 × GPU 使用秒数 × GPU 费率 + CPU 使用秒数 + GiB·秒内存 + 存储 + 适用的出站流量费用
这条公式之所以重要,是因为集群会把完整节点资源一起计入费用。比如任务申请 4 个节点、每个节点配备 8 张 H100,最终计费的是 32 张 H100,而不是 1 个协调节点加上“免费”的工作节点。
Modal Clusters 如何影响资源费率
Modal 于 2026 年 10 月 1 日正式发布 GA 版本,将多节点执行做成了托管式基础能力。size 用于设置容器数量,rdma=True 则会在支持的情况下启用高速通信路径(Modal 公告)。
文档介绍了 gang scheduling(成组调度)机制:Modal 会尽量将整个请求的容器组同时放置,而不是先启动一个无法继续执行的残缺任务。适用场景包括分布式训练、微调、模型并行推理,以及需要同步 GPU 通信的 prefill/decode 架构。
集群文档还列出了几项实际限制:GPU 必须按完整节点分配,不支持纯 CPU 集群;如果某个容器失败或被抢占,整个 clustered call 都可能失败。最终只会返回 rank 0 的输出,因此长时间运行的任务需要将检查点保存到容器外部。
Modal Clusters 账单背后的 GPU 费率
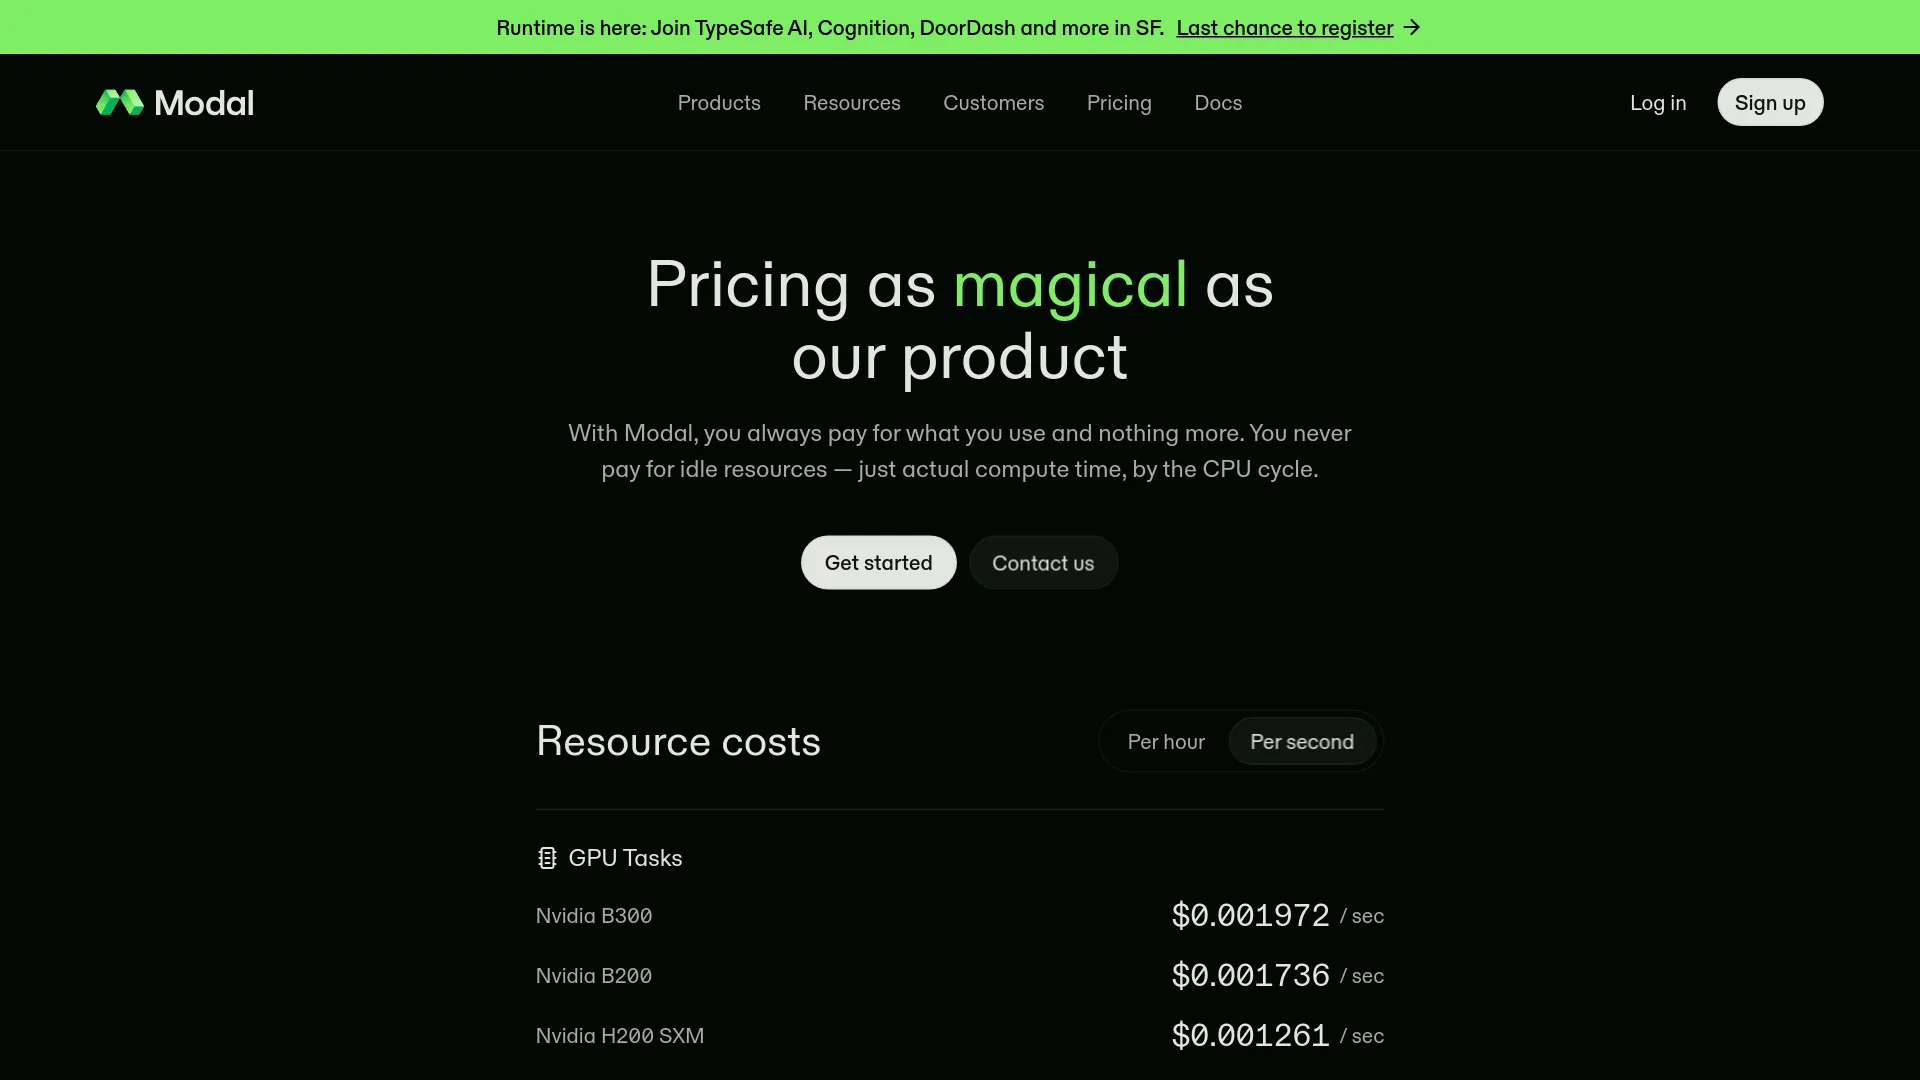
下面这些公开费率可以作为估算起点。每小时价格由每秒费率换算而来,不包含 CPU、内存、存储和可能存在的区域加价。
| GPU | 每秒 | 每 GPU 小时约 |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modal 还列出了 CPU 费率:每个物理核心每秒 $0.0000131;内存费率为每 GiB·秒 $0.00000222。存储卷价格为每 GiB 每月 $0.09,前 1 TiB 免费。超过包含额度后,网络出站流量按每 GiB $0.04 计费。启动大型任务前,请通过官方费率表确认当前价格。
示例:4 个节点、每个节点 8 张 H100
假设一个分布式训练任务设置为 size=4,并在每个节点上申请 H100:8。
- 4 个节点 × 每节点 8 张 GPU = 32 张 H100 GPU。
- 32 × 每小时 $3.95 = GPU 费用约为每小时 $126.40。
- 将 $126.40 视为仅计算 GPU 的最低成本;CPU、内存、存储和出站流量都要另行计费。
这才是与预留或专用算力比较时应使用的数字。无服务器模式的优势在于突发任务结束后可以缩容到零,但它并不会让一套满负载运行的集群变得便宜。
计划限制有时比费率表更关键
功能正式发布,并不代表容量无限。Modal 的公开工作区套餐包含并发数和平台限制,大型集群可能在价格成为问题之前,就已经无法启动。
| 套餐 | 平台费用 | 包含的计算额度 | 公开 GPU 并发数 |
|---|---|---|---|
| Starter | $0/月 | $30/月 | 10 张 GPU |
| Team | $250/月 | $100/月 | 50 张 GPU |
| Enterprise | 定制 | 定制 | 定制 / 更高限制 |
一个 32 张 H100 的实验已经会占用 32 张 GPU,因此在 10 张 GPU 并发限制下,Starter 套餐无法支持上面的示例。Team 套餐从 GPU 数量来看可以满足要求,但实际调度仍会受到可用容量、区域选择和申请硬件类型的影响。
不要把 Starter 的 $30 额度理解成 30 个免费 GPU 小时。按列出的 H100 费率计算,它大约相当于 7.6 个 H100 GPU 小时,而且还没扣除任务使用的其他资源。
什么时候使用 Modal Clusters 更划算
当任务规模较大、运行不连续,而且长期维护一套预置集群很麻烦时,Modal Clusters 最有优势。一个运行几小时后就结束的训练突发任务,比连续运行数周的集群更能体现 scale-to-zero 的价值。
适合选择它的场景包括:
- 所有节点都必须同时启动的分布式微调任务。
- 使用昂贵 GPU 资源、但持续时间较短的训练突发任务。
- 需要 RDMA 或模型并行的多节点推理。
- 原本需要自行维护 Kubernetes、SLURM 或手动配置 RDMA 的 Python 团队。
如果模型能放进一台机器,单节点 Modal function 通常更合适。当利用率可预测、任务需要固定 SLA,或者核心目标是尽可能降低长期 GPU 小时成本时,则应该认真比较专用或预留基础设施。
一场真实用户讨论也说明了适用边界。在一个计算机视觉相关讨论中,u/Substantial_Camel735 建议将向量搜索放在 VPS 上,而不是让 Modal worker 承担这部分工作(Reddit 讨论)。这只是某位实践者的架构偏好,不能视为针对整个平台的基准结论。
“我们正准备弃用 modal,不过这个设计听起来没问题。向量搜索不会用 modal worker 来做,而是直接在 VPS 上访问你的向量数据库。” — u/Substantial_Camel735,r/computervision
大规模启动前必须检查的运行细节
- 先把完整资源分配算清楚。 检查
size × 每节点 GPU 数量,再将总数与工作区并发限制进行比较。 - 从最小的有效集群开始。 两节点测试可以提前暴露镜像、NCCL、rank 和 rendezvous 问题,避免在 32 GPU 启动后才让账单成倍增加。
- 将 RDMA 与应用调试分开。 如果任务允许,先在不启用 RDMA 的情况下验证分布式任务,再打开
rdma=True,测量通信敏感路径的表现。 - 将检查点保存到持久化存储。 某个 rank 失败或被抢占,可能导致整个调用失败;没有检查点的重试可能会重复执行整段昂贵任务。
- 为 CPU、内存和出站流量单独留预算。 GPU 计算只是账单的第一项,尤其是数据集或输出需要跨区域传输时。
- 确认是否必须固定区域。 限定部署位置可能改变可用调度池和价格乘数;应将地域要求视为需要测量验证的条件,并对照最新的区域价格文档进行确认。
Modal 的官方价格页面没有将 RDMA 列为单独收费项目。它的价值在于性能:同步训练和大规模 KV cache 传输使用普通 TCP 时,可能受网络带宽限制。代价是,支持 RDMA 的硬件和部署位置可能会减少可用容量。
Modal Clusters 常见问题
Modal Clusters 是否收取单独的 API 费用?
目前没有公布单独的集群附加费。Modal 会按照每个容器实际使用的资源计费,包括 GPU、CPU、内存、存储和适用的网络用量。
集群规模上限是多少?
GA 材料显示,公开集群最多支持 32 个节点或 256 张 GPU;更大的需求需要与 Modal 沟通处理(GA 公告)。工作区并发限制和实际容量仍然适用。
Modal Clusters 能运行推理任务吗?
可以,但任务必须符合集群执行模型。多节点或模型并行推理是比普通 HTTP endpoint 更适合的场景;集群 Web function 也存在一些限制,例如流量会被发送到 rank 0(集群文档)。
实际该怎么选
| 你的任务 | 建议的起点 |
|---|---|
| 模型能放进一张 GPU 或一个节点 | 普通 Modal function |
| 短时间、需要同步的多节点训练突发任务 | Modal Clusters,先做小规模测试 |
| 长期运行且利用率稳定、接近满载 | 比较专用或预留 GPU 算力 |
| GPU 推理旁边还需要搜索或数据库服务 | 将数据服务独立部署,除非测量结果证明同机部署更合理 |
| 严格的私有网络或自托管要求 | 评估其他部署模式 |
Modal Clusters 让多节点 GPU 编排更容易上手,但并不意味着成本天然更低。无服务器调度和 Python 开发体验可以节省工程时间;而长期利用率、区域限制以及整套集群重试,则可能成为账单中的主要成本。先算清楚完整节点数量,再将这部分便利带来的溢价与专用算力进行比较。