 AIREITER
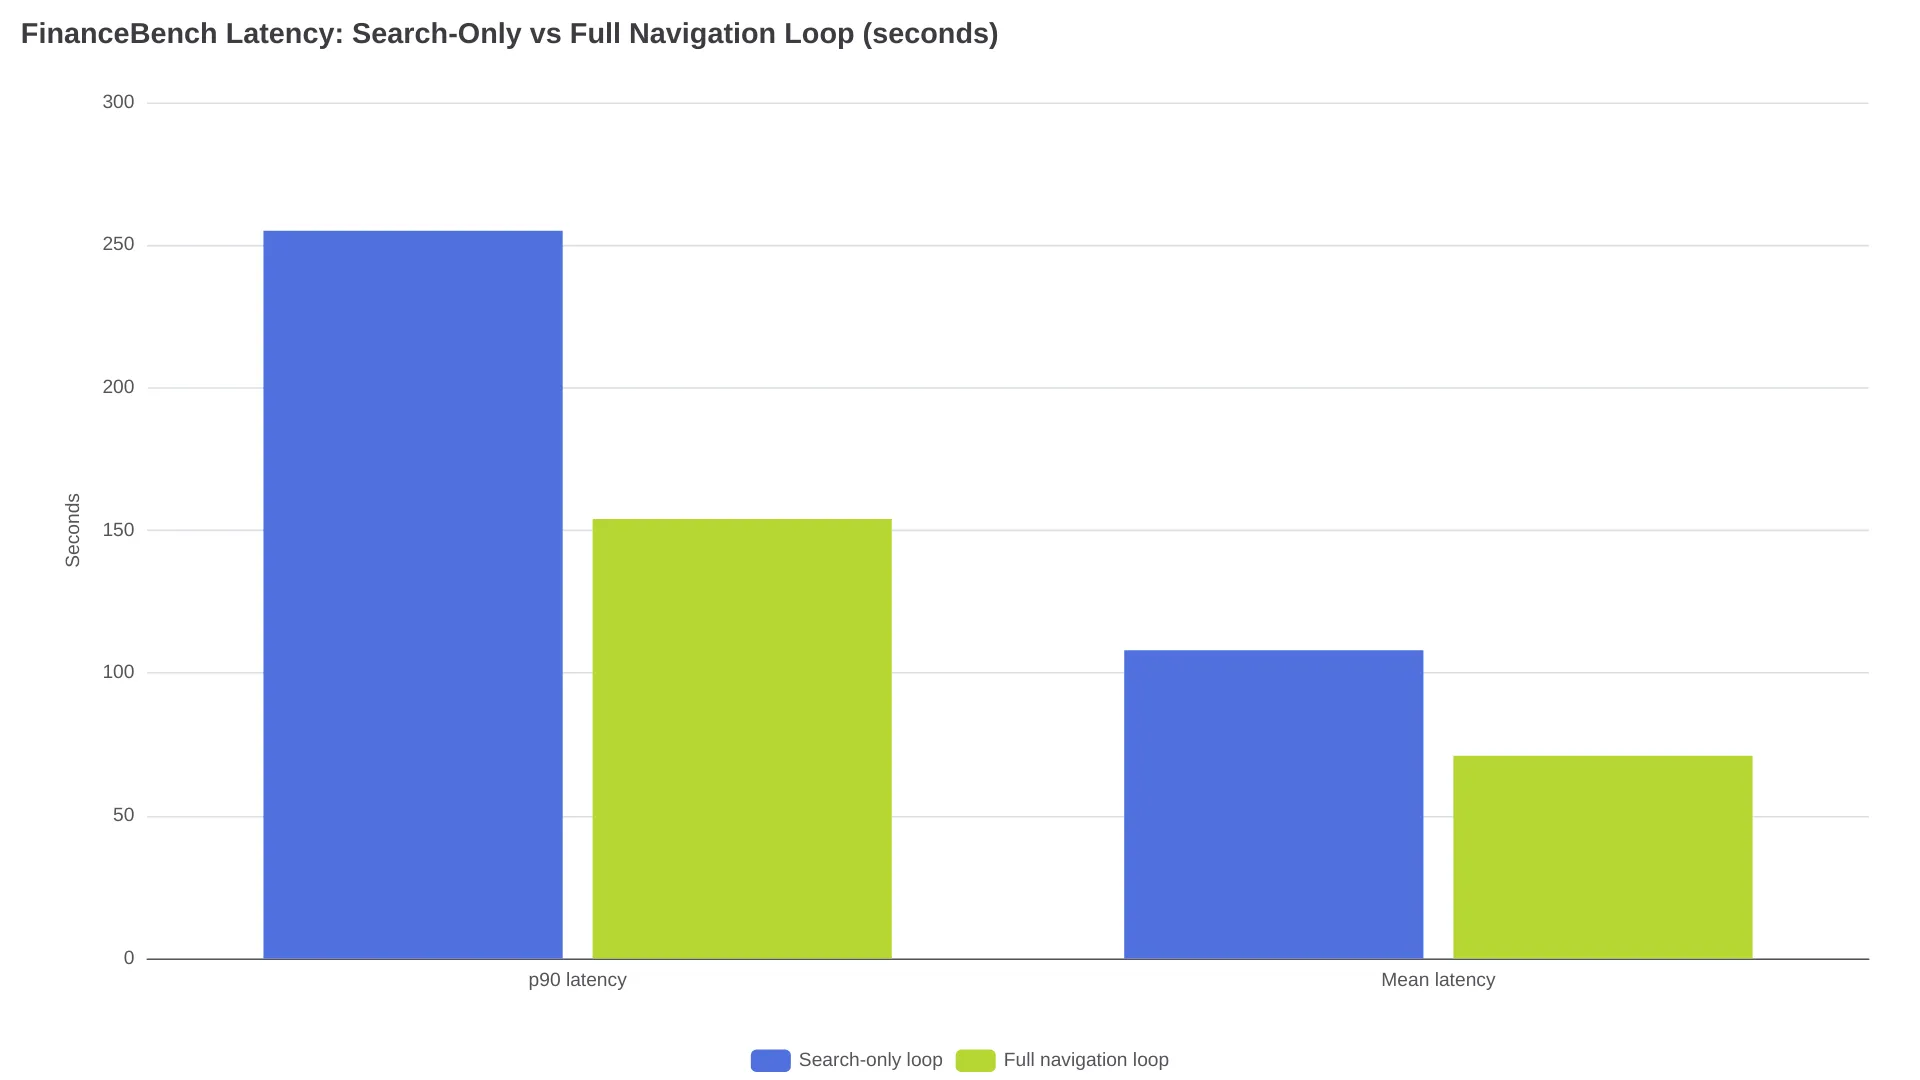
在 FinanceBench 测试中,面对 368 份 SEC 文件、约 53,900 页内容和 150 个问题,Mistral 表示,其新推出的 Agentic Search 层相比单次检索 RAG,采用仅搜索循环时可将回答准确率提高 47 至 53 个百分点;启用完整导航循环后,最高可提升 59 个百分点,同时 Token 用量最多降低约三分之一。不过,代价也很明确:完整循环的 p90 延迟仍为 154 秒,平均延迟为 71 秒。
Mistral Agentic Search 于 2026 年 8 月 20 日发布,是面向企业复杂语料的检索层,适用对象包括监管申报文件、合同和扫描版 PDF。它并不是网页搜索的升级版;为了换取准确率,用户需要接受这套循环可能耗时数分钟。
Mistral Agentic Search 到底是什么
Mistral Agentic Search 是一个于 2026 年 8 月 20 日发布的检索层。它在既有索引外增加了由五种工具构成的多步循环:search、open、navigate、read 和 grep。它可通过 Mistral Search Toolkit 使用,也已集成到 Studio 与 Vibe 的 Libraries 中。索引仍归你所有,无需微调;当仅靠分块检索无法回答问题时,由 Agent 循环继续处理。
五个工具如何协同:search、open、navigate、read、grep
理解这套机制,最直观的方式是看 Mistral 给出的案例:查询 1953 日历年度美国国防支出。一次 search 调用找到了 1 月至 6 月的数据,却遗漏了 7 月至 12 月。Agentic 路径则进行了两次搜索,定位到 treasury_bulletin_1954_02.pdf,随后读取第 15 页的表 3,最终返回全年 12 个月的数值,合计为 44,463 百万美元。
| 工具 | 作用 |
|---|---|
search | 在索引中查询可能相关的来源 |
open | 打开已定位到的文档 |
navigate | 在文档内跳转至页面、表格或章节 |
read | 提取当前位置的内容 |
grep | 按模式匹配精确的词元、代码或标识符 |
单次 RAG 会检索一组固定分块,并在一次调用中完成回答;如果初始检索结果不理想,它无法再请求另一份文档。这个循环则可以比对来源、沿着脚注和表格继续追踪,也能从不完整结果中恢复。Mistral 的说法是,这种交换带来的不是更多无效重试和轮次,而是更少。
官方基准数据实际说明了什么
公告给出了两组基准测试,均为厂商自行报告,使用 Search Toolkit 的开箱默认配置,未做调优。Mistral 对此的表述是:“这些结果是下限,不是上限。”FinanceBench(Islam 等,2023;开放版本位于 GitHub)包含 368 份 SEC 10-K、10-Q 和 8-K 文件;按 Mistral 的统计,每份约 147 页。测试共设 150 个问题,Mistral 的方案通过一个经过人工标签校准的 LLM 进行判定。
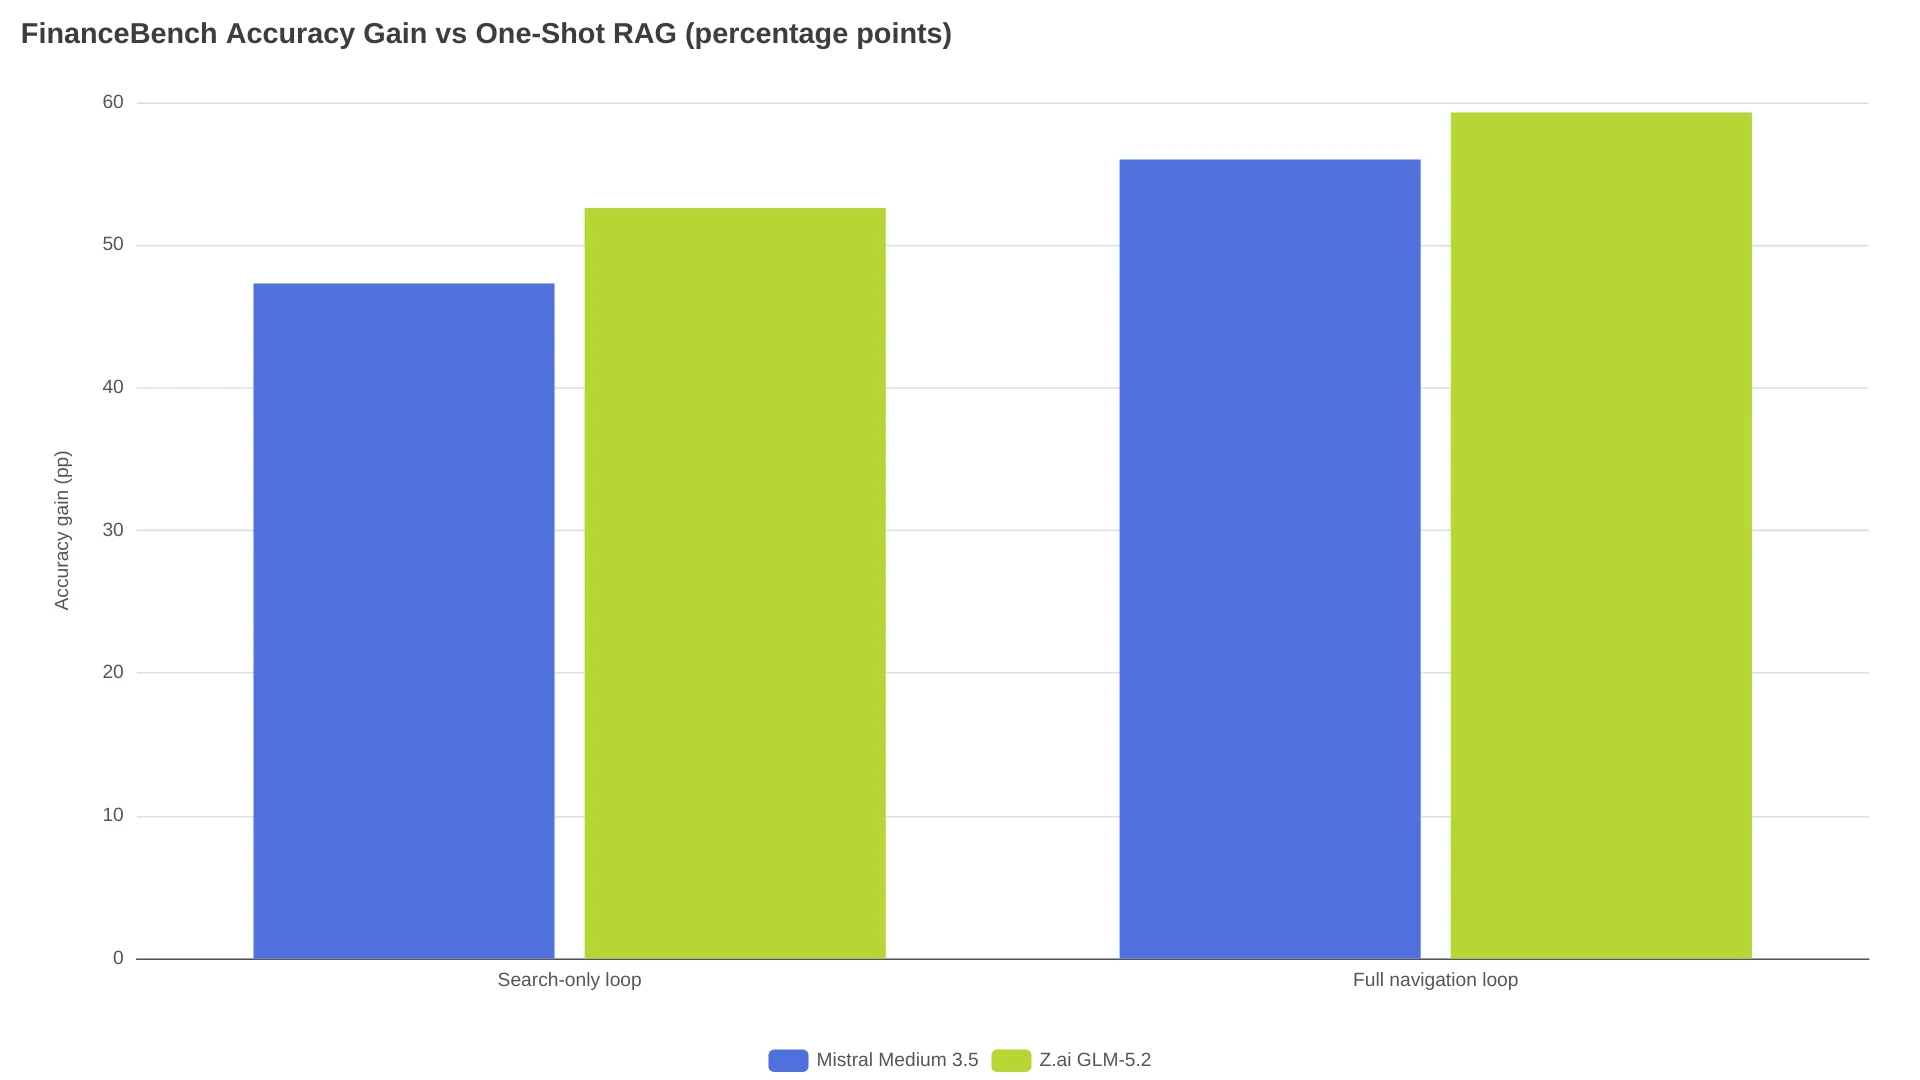
在仅搜索循环之上加入导航工具,即 open、navigate、read 和 grep,Mistral Medium 3.5 的准确率进一步提高 8.7 个百分点,GLM-5.2 则进一步提高 6.7 个百分点。与仅搜索循环相比,完整导航循环在 Mistral Medium 3.5 上少用了 23.9% Token,在 GLM-5.2 上少用了 33.7%。延迟也同步下降:p90 从 255 秒降至 154 秒,平均延迟从 108 秒降至 71 秒。这里要注意比较对象:Token 降幅是相对于仅搜索的 Agentic 循环,而非相对于单次 RAG。
难度更高的是 OfficeQA Pro:它包含 696 期美国财政部历史公报、约 89,000 页以表格为主的扫描政府 PDF,以及 133 个问题。GLM-5.2 在完整循环下达到 51.9% 准确率,提升 45.6 个百分点,这意味着其单次检索基线为 6.3%;Mistral Medium 3.5 则提升了 27.1 个百分点。导航机制最多还能减少 7.0% 的交互轮次。
Mistral 同时测试了自家的 Mistral Medium 3.5 和第三方 Z.ai GLM-5.2,两者都呈现出相同的提升趋势。公告还引用 Kimi 的研究,称 GLM-5.2 在 Claude Code harness 下的 OfficeQA Pro 成绩为 41.4%,而在 Mistral 的 harness 下为 51.9%;但文中并未链接 Kimi 的一手来源,因此这 10.5 个百分点的 harness 差异仅是 Mistral 的说法。Mistral 的结论是:“检索质量随模型能力提升而提升”,并认为瓶颈在 harness,而不在模型本身。
哪些场景仍该选单次 RAG
Mistral 自己也强调,索引检索仍是基础能力,只有初始结果不足以支撑回答时,才需要进入 Agentic 循环。实际选择主要取决于文档形态和可接受的延迟预算:
| 你的工作负载 | 建议起点 |
|---|---|
| 在篇幅短、结构清晰的文档中直接查找信息 | 单次 RAG |
| 高频关键词或语义检索 | 单次 RAG |
| 答案位于已知位置 | 单次 RAG |
| 包含表格和脚注的申报文件、合同、手册 | Agentic Search |
| 以表格为主的扫描 PDF | Agentic Search |
| 答案分散在多份文档中,且需要交叉核对 | Agentic Search |
| 要求交互式延迟,即数秒内响应 | 单次 RAG |
如果产品无法接受 154 秒的 p90 延迟,再高的准确率也无济于事。但若是批量分析财务报表,情况就不同了。
Agentic Search 不等于 web_search 工具
搜索这个产品时,Google 很可能会先展示 Mistral 的 websearch 文档,但两者不是同一项服务。web_search 和 web_search_premium 属于 Agents API,用于带引用的实时网页检索;根据 Mistral API 定价页,两者价格分别为每 1,000 次调用 30 美元和 50 美元,模型 Token 费用另计。Agentic Search 的方向恰好相反:它深入检索你自己建立索引的语料,不会查询开放互联网。两者解决的问题不同,而且只有前者公布了价格;Agentic Search 的公告中没有出现任何费率。
两种上手方式
- Search Toolkit。一套用于数据摄取、嵌入和索引的开放模块,可部署在云端或本地环境。解析器、分块方式、嵌入模型、Vespa schema、排序配置和混合检索均可配置。
- Studio 和 Vibe Libraries。托管方案。Search Starter App 可使用默认配置,基于你的语料建立本地索引;在做任何调优之前,这是复现基准设置最快的方式。
无论选择哪条路径,都应先用同一批有代表性的问题分别测试单次 RAG 和完整循环,再比较回答质量、Token 用量和 p90 延迟,之后再决定是否投入。
发布时仍未解答的问题
Mistral 尚未公布 Agentic Search 的定价,基准测试结果也均由厂商自行报告;在发布时,尚无独立上手复现可供参考。最早的公开反馈还停留在初步印象:
“mistral 刚刚把 agentic search 加入 api,这是正确的一步。将 Perplexity 风格搜索封装成原生 agent 工具,让我们不用再自己编写脆弱的网页抓取管线,也不用管理代理轮换。” — @AbdoKerdawy,AI 产品开发者(X)
关于 Token 的说法也已引发质疑,而 Mistral 的公告并未完全回应:
“Mistral 的 agentic search 检索工具声称能将单次搜索失败减少超过 40%。如果它绕过数据库查询,是否会减少你需要花费的 Token 数量?” — @therawlogs,独立博主(X)
官方给出的回答,是相较于仅搜索循环,Token 用量降低 24–34%。这一结果能否在基准语料之外成立,正是对开放 FinanceBench 数据集进行独立测试后才能确认的问题。
同类产品面对的是相同的物理约束:Mixedbread 的 Toast-1 agentic search 模式将循环限制为最多四轮、八个并行检索调用,其文档也直接说明它比单次搜索更慢。为了准确率而支付延迟成本,是这一类厂商的共同选择。
常见问题直答
Mistral Agentic Search 能通过 Agents API 使用吗?
不能。它通过 Mistral Search Toolkit 以及 Studio 和 Vibe 中的 Libraries 提供;Agents API 的 web_search 工具是独立的实时网页产品,定价也单独计算。
Agentic Search 真的能减少 Token 用量吗?
根据官方基准,完整导航循环在 FinanceBench 上比仅搜索的 Agentic 循环少用 23.9–33.7% Token;目前尚未有公开的独立复现结果。
哪些模型可用于 Agentic Search?
Mistral 测试了 Mistral Medium 3.5 和 Z.ai GLM-5.2,两者均获得一致的提升。Mistral 将这一层描述为模型无关,且无需微调。
Mistral Agentic Search 的价格是多少?
Agentic Search 本身尚未公布价格。Mistral 定价页中每 1,000 次调用 30 美元的价格,属于较早推出的 web_search Agent 工具。
尚未解决的取舍其实很简单:这是用分钟级等待换取准确率。对于申报文件、合同和扫描版政府记录的批处理任务,OfficeQA Pro 和 FinanceBench 完整循环结果带来的 45 至 59 个百分点准确率提升,以及相较更慢循环约三分之一的 Token 降幅,是合理的交换;但对于任何面向用户的场景,71 秒的平均延迟仍难以接受。在 Mistral 之外有人重新跑完 FinanceBench 之前,页面上最亮眼的数据依然只是厂商自己的结果。
延伸阅读:GLM-5.2 API guide 和 GLM-5.2 review,介绍了 Mistral 测试中使用的第二个基准模型。