 AIREITER
MiniMax 在 H3 模型卡中将预处理层称为“决定最终输出质量的关键”;而 Reddit 上一条获得 220 个赞的 H3 提示词讨论帖,则几乎是一份针对乱码对白的故障报告。本篇 MiniMax H3 提示词评测把官方格式与创作者实测、失败案例逐项对照:从这些反馈看,镜头控制与参考素材控制明显比对白和音频更可靠;而想要拿到最佳结果,有时反而要有意识地偏离官方语法。
MiniMax H3 的提示词格式,到底是什么
官方的 MiniMax H3 提示词,本质上是一份由三个字段构成的结构化文档:integrated_multimodal_description、overall_soundscape 和 non_diegetic_music。其中包含带时间码的镜头、持续使用的说话人 ID,以及 <d> 对话标签。
之所以需要这套格式,是因为 H3 依赖一种结构化中间表示。正常情况下,这一步由托管预处理器 H3-Context-IR 完成;MiniMax 没有将它纳入开放权重发布。使用托管 API 时,系统会把宽泛的自然语言需求改写为相应结构;而本地运行 33B 开放权重版本时,无论通过 SGLang、vLLM、Diffusers 还是 ComfyUI,你都得自己写出这套结构。
MiniMax 还在官方 GitHub 仓库中提供了可移植的 h3-prompt-writing skill:两份指南文件 base-en.txt 和 ref-en.txt,任何编程 Agent 都能直接读取,无需调用外部 API。创作者会在 Claude 或 Cursor 中运行它,把自然语言需求转换为完整格式。@AI__TSUBAKI 就记录了自己用这套流程制作电影感短片的方式。
写提示词前必须知道的规格边界
| 限制项 | 规格 | 对提示词的影响 |
|---|---|---|
| 片段时长 | 4–15 秒,24 FPS | 时间戳必须严格递增,且不能超出视频时长 |
| 音频 | 32 kHz 立体声,与视频联合生成 | 环境声和配乐字段必须填写,允许使用 N/A |
| 分辨率 | 默认 768p;2K 通过 H3-Regenerate-2K 获取,仅限 API | 先在 768p 测试,提示词定稿后再为 2K 付费 |
| 任务类型 | T2VA(文本)、I2VA(0.00 秒首帧)、FL2VA(首帧+尾帧)、L2VA(尾帧)、Ref2VA(全能参考) | 每种类型都需要自己的对齐说明句 |
| 参考素材上限 | 9 张图片 + 3 段视频 + 3 段音频,共 12 个文件;每类媒体总时长 ≤15 秒 | 参考越多,路由关系越复杂,不一定更好 |
| 提示词长度 | 官方示例约为 300–700 词;纯文生视频上限约 7,000 个字符 | 官方手册明确将无参考的过短提示词列为失败模式 |
一个完整但最精简的可用提示词,只需三个字段、一条镜头指令、一名画面中可见且说出引号对白的人物,以及无配乐设置,十行就能写完:
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
字段语法的完整说明,包括所有标签、对齐句和模板,可参阅我们的 MiniMax H3 提示词指南。这篇评测只讨论一个问题:这套语法到底值不值得花时间掌握。
官方格式的三项承诺,经得起验证吗
官方指南隐含了三项承诺。综合已引用的实测报告,前两项得到的正面反馈更多,音频遵循度则明显逊色。
承诺一:结构化提示词能让结果更贴近预期
这一点的证据最充分。X 创作者 @AIWarper 在改用官方结构后,发布了一组前后对比:
“我强烈建议你遵循 Minimax 发布的提示词指南。它确实能大幅提升结果与预期的一致性……我上一篇帖子没有采用推荐的提示词结构。”——@AIWarper,306 个赞
第三方测试日志也在细节层面得出了相同结论:测试者要求视频在准确的 00:05.000 切镜,结果实现了;脚本中的产品证言被逐字说出;在一段 6 秒的 I2VA 视频里,首帧构图保持稳定。
分镜测试也基本一致。@aimikoda 的分镜被作为连续镜头指引执行;@nanyuan0412 的分镜同样被照着完成,没有自行发挥。唯一例外是他们忘写声音字段,结果几乎没有声音。
反复出现的瓶颈不是模型拒绝执行,而是节奏控制。u/Relevant_One_2261 写道:“最大的问题一直是节奏。”对白塞不进时长、时间戳排得过密,是最常见的结构性失败原因。
承诺二:描述镜头动作,比描述你想要的画面结果更有效
一个被修复的构图失败案例证实了这一点。r/StableDiffusion 的一名用户希望行走中的人物始终完整入镜,只写了“entire subject remains visible throughout”这句结果描述,但连续失败。后来,他们把目标改写成 H3 更能理解的镜头语法:
“镜头以大幅度向后拉出,速度与人物前行速度一致,始终保持全身构图。”——u/Powerful-Goal52,原发帖人确认有效
这正对应 H3 的三个镜头维度:运动类型、幅度和速度;同时也符合每个镜头只写一条相机指令的规则。下面是常见目标和 H3 指令之间的转换方式:
| 你想要的结果 | H3 更容易执行的指令 |
|---|---|
| 人物行走时始终完整可见 | 以人物步行速度进行大幅度 Pull Out |
| 轻微强调主体,同时不破坏构图 | 小幅度、慢速 Push In |
| 展示静止人物周围的环境 | 中幅度 Truck Left 或 Truck Right |
| 改变机位高度但不俯仰 | 慢速 Pedestal Up / Pedestal Down |
官方提示词指南列出了 13 类运动类型:Zoom、Push、Pull、Pan、Tilt、Truck、Pedestal、Arc、Tracking、Static、Shake、Roll 和 POV;每一类还要用幅度和速度修饰。实际使用中,Zoom 是焦距变化,Push 则是相机实体移动,两者不能混用。
承诺三:把音频拆分为两个字段,声音就会干净可控
这恰恰是最薄弱的一层。把画内环境声与画外配乐分开设计,本身是合理的;但模型的实际遵循度并不稳定:
“我会这么写,但大约 20% 的时候它还是会自己加音乐,笑死。”——u/TheElectriking,谈及
non_diegetic_music: N/A
这条引文所在的 220 赞讨论帖还列举了其他典型问题:片段交界处的音频伪影、角色说出随机乱码,以及台词被错误的人物说出。u/krigeta1 表示,自己传入 3 段定制音频参考后,得到的却是“随机的声音,或者不是我分配给角色的音频”。另一个讨论帖则解决了一个问题:原本应该由画面角色说出的对白总被读成画外音,修复方法是把说话人 ID 明确绑定到画面中可见的角色。
画面文字同样脆弱。社区 Wiki将其概括为“精确文字很脆弱”:涉及品牌的关键文字,最好作为图片参考提供,或在后期合成。也有相反看法:@web4miko 表示,根据其测试,H3 在文字和上下文理解方面“甚至赢不了 Seedance 2.0”。在这些已引用的报告中,音频路由、精确文字和高密度上下文,都是反复出现的弱项。
哪些时候该故意不按官方格式写
在已引用的横向对比和一手测试中,有三种偏离官方格式的做法值得了解。在投入完整结构化写法前,先知道它们会更省时间。
有时引号比 <d> 标签更靠谱。 r/StableDiffusion 上一组对比测试约有 105 个赞、81 条评论。原帖作者发现,去掉指南中的 <d>[Language]...台词...</d> 标签,改为直接用引号写对白后,语音变得干净;而带标签的写法反而生成了未要求的音频。一位做过类似测试的评论者也认同:
“官方的对白提示词写法问题多得离谱……引号方案也不是完全没问题,但远没有
<d></d>标签那么容易出错。”——u/networking_noob
实际策略是:先试 <d>,因为它是模型训练时的标准路径;但如果出现乱码或额外生成的对白,就用引号重试同一句台词,不必重写整段提示词。
non_diegetic_music: N/A 可以单独作为有效控制项。 u/Nextil 称,即便忽略大部分其他结构,这一行也能防止模型加入音乐。如果你只愿意采用一项结构化写法,就选它:不需要的配乐,是这些报告中反复出现的投诉。
参考素材越重,文字反而该越少。 当图片承担身份保持、视频承担动作参考时,提示词的任务就只剩下素材路由和新增动作。@aimikoda 最广泛传播的模板中,有一个获得超过 1,300 次收藏,之所以极简正是这个原因。@CharaspowerAI 还展示了 MiniMax 自己的 Design Agent:只需一句“act as an expert FPV director and turn this into something viral”,它就能自动扩展成完整的结构化提示词。一个参考素材路由块可以是这样:
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
之后,提示词只需要描述新镜头。结合这些报告,更实用的工作流是:先锁定静帧,让参考素材承担主要信息,只把文字花在真正发生变化的部分。
故障排查:官方手册没有告诉你的事
官方提示词指南讲到语法就停了,却没有说明生成结果翻车后该怎么处理。下表根据前述失败报告整理:
| 症状 | 可能原因 | 处理方式 |
|---|---|---|
写了 N/A 仍被加入音乐 | 有用户观察到约 20% 的生成会发生泄漏 | 重新生成;避免在提示词其他位置请求任何“音乐氛围” |
| 错误角色说出台词 | 说话人和音频的路由发生冲突 | 明确把说话人 ID 绑定到画面中可见的角色 |
| 画面内对白被读成画外音 | 缺少口型同步关联 | 明确角色在画面中可见;若确实需要旁白,加入“lips remain closed” |
| 音频参考被忽略 | 超出 3 段 / 15 秒限制,或未分配具体作用 | 为每段音频指定角色;压缩音频参考总长度 |
| 本地模型忽略中文对白 | ComfyUI 复用了 Qwen tokenizer;命令行编码破坏了文本 | 使用仓库要求的 tokenizer + Unicode 安全的提交方式 + <d>[Chinese] 台词</d>(社区反馈的修复方案) |
| 长单镜头(>15 秒)崩坏 | 超出 4–15 秒的设计范围;物体变平、连续性漂移 | 拆成 15 秒片段,并提前规划片段之间的连续性 |
本地部署这一行尤其值得再强调一次。根据 @eternityspring 的报告,“H3 不会说中文”最终追溯到 tokenizer 复用和编码问题,而不是提示词本身。
成本账:Token、迭代次数与可移植性
结构化并非没有代价。官方仓库公布了三种可复现实例的 Context-IR Token 使用量,而参考素材数量增加时,数字增长非常快:
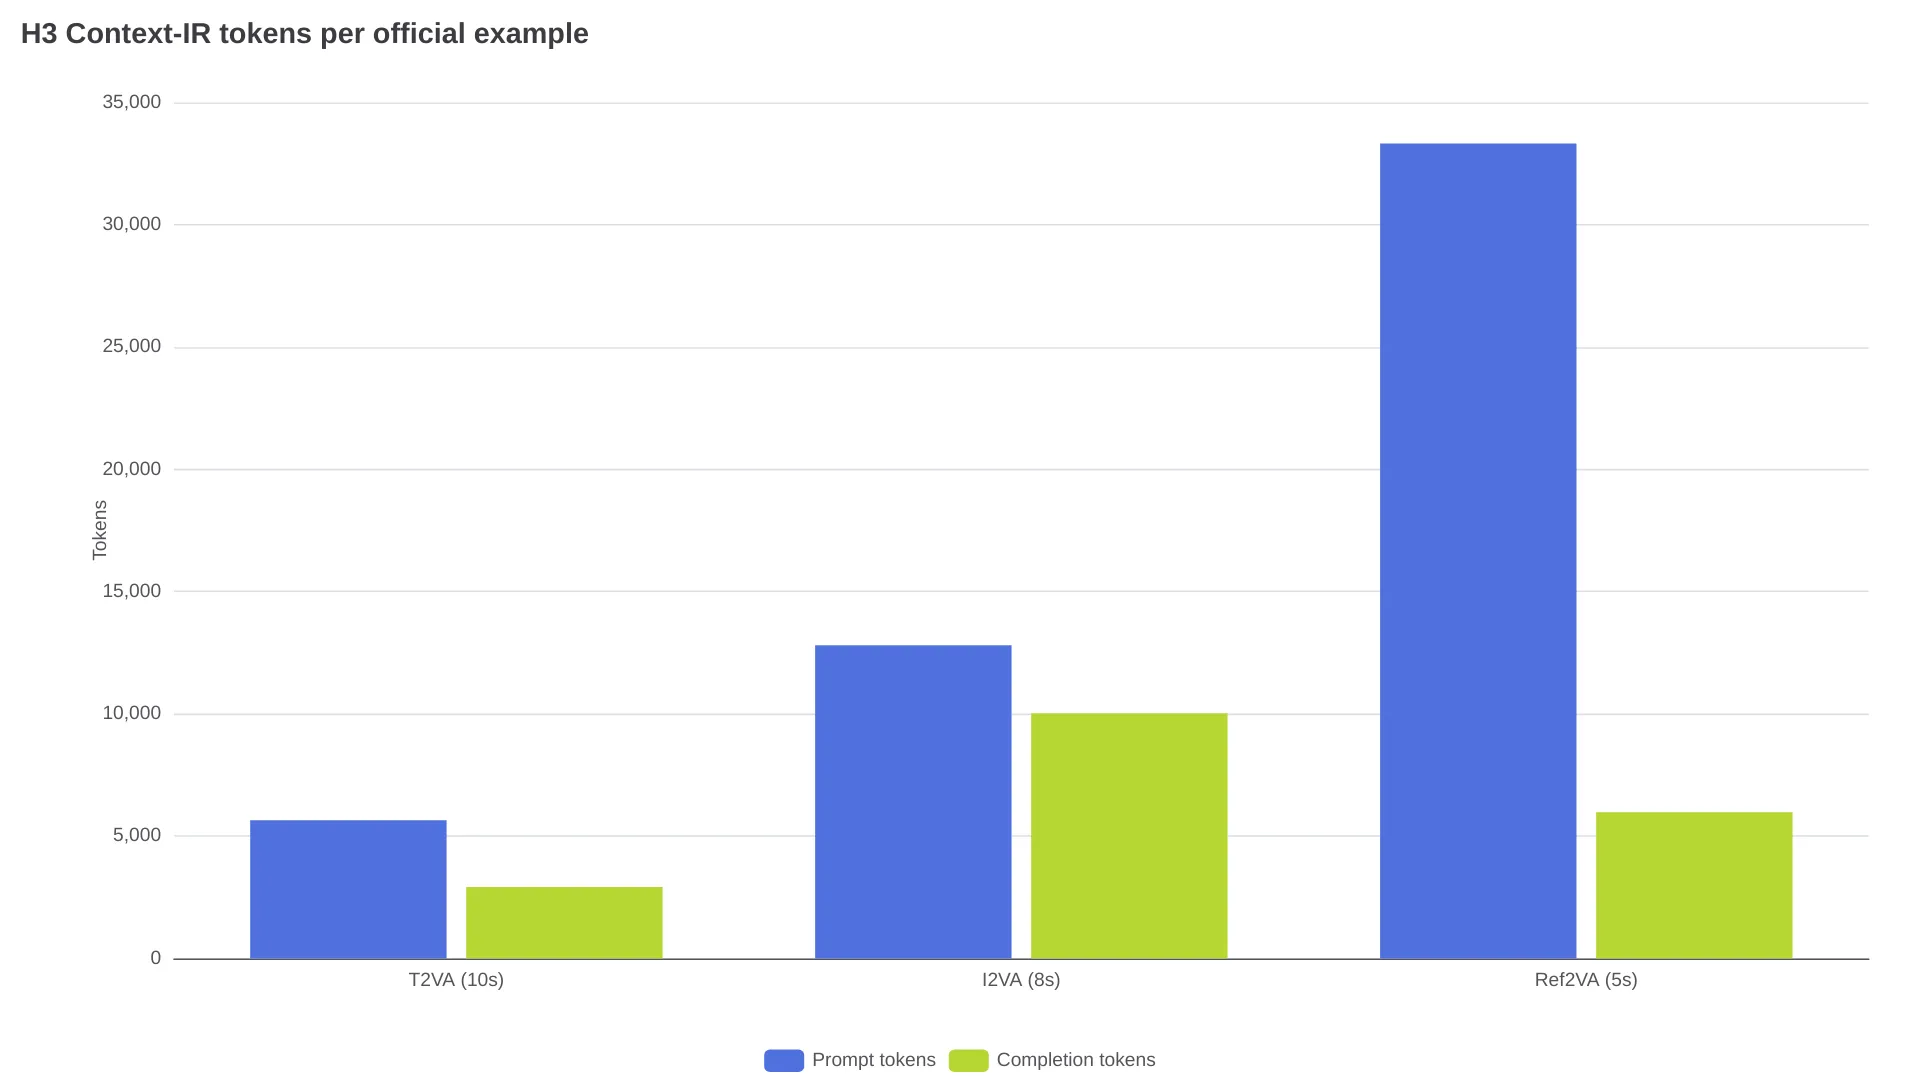
一次纯文本生成会消耗 8,565 个预处理 Token;一个多模态参考任务则会消耗 39,299 个,其中 33,323 个来自提示词侧。本地运行时,这些 Token 会增加预处理延迟;托管工作流中,即便价格按生成秒数计算,它们也会增加处理开销。
时间成本同样真实存在。一位 X 创作者记录过,自己为了一个三人环绕镜头提示词打磨了 48 小时才得到满意结果(@LoveUolanda)。更省钱的迭代方式是先在 768p 定稿:一条 6 秒测试约需 $0.68,确认提示词后再上 2K。中继平台模型页面列出的 MiniMax H3 价格为 768p $0.1125/秒,2K $0.1825/秒。
最后一项隐性成本是可移植性。H3 的字段、说话人 ID 和标签是一种方言,不是行业标准。一篇跨模型实操指南指出,Veo 3.1 偏好带内联 SFX: 标签的普通段落,Seedance 2.0 则采用六槽位描述;两者都不接受 H3 的字段、说话人 ID 或标签。为 H3 建好的提示词库,换到其他模型时不是复制粘贴,而是重新改写。
MiniMax H3 提示词评测 FAQ
MiniMax H3 必须使用结构化提示词格式吗?
不必须。使用托管 API 时,Context-IR 会把宽泛的自然语言请求改写为内部表示。结构化格式最适合本地开放权重部署,以及需要精确切镜、时间戳和说话人路由的场景。
怎样阻止 MiniMax H3 添加背景音乐?
最后加入 non_diegetic_music: N/A,并且不要在提示词任何其他位置要求音乐氛围;仍可能出现泄漏,因此重新生成属于正常情况。
MiniMax H3 的提示词应该写多长?
MiniMax 官方示例约为 300–700 词,纯文生视频最多接受约 7,000 个字符;当参考素材已经承担身份和动作信息时,提示词应该变短,而不是变长。
H3 提示词可以直接复用到 Seedance 或 Veo 吗?
不可以。H3 的命名字段、说话人 ID 和标签都具有模型专属性;Seedance 使用六槽位格式,Veo 接受普通段落,因此每个目标模型都需要单独改写。
为什么本地 H3 部署会忽略非英语对白?
通常是工具链问题,而非模型问题:复用 Qwen tokenizer 的配置,或会破坏 Unicode 的命令行环境,会在生成前就损坏对白。应使用仓库提供的官方 tokenizer,以及 <d>[Language] 对话格式。
结论:哪些人值得学这套格式
| 你的任务 | 建议 |
|---|---|
| 带对白的多镜头影片 | 学习完整格式;预留音频重试次数,并准备好引号写法作为备选 |
| 产品动画 / 静态图动画(I2VA) | 学习轻量版:对齐说明句 + 运动指令 + 声音字段 |
| 分镜项目或角色一致性系列 | 值得学——参考素材承担主要工作,提示词保持精简且便于路由 |
| 一次性单条视频、轻度使用 | 大部分都可以跳过:普通描述 + non_diegetic_music: N/A 就够用 |
| 搭建跨模型通用提示词库 | 不建议——每个模型的方言都要单独适配,按模型分别写 |
如果你的工作涉及多镜头、时间戳或参考素材驱动的创作,就该学习这套格式:这是目前已有文档证明、也更容易复现其遵循度的场景。若只是一次性短片,则可以略过大部分结构;对于对白密集的音频内容,也应预期会需要重试,而不是期待模型绝对服从。
社区对这笔取舍本身也看法分裂:同一个月里,既有人花 48 小时死磕镜头提示词,也出现了一篇获得 880 个赞的帖子,其中一位评论者写道:“读手册居然还挺让人兴奋。”在模型对音频字段的遵循度追上其镜头控制能力之前,更实用的策略是:让 Agent 起草结构,自己核对音频字段,先用 768p 低成本测试,再决定是否提交 2K 生成。