 AIREITER
Liquid AI 的 LFM3 用六款约 20 亿参数的模型覆盖文本、视觉、音频和全模态交互,但截至 2026 年 10 月 27 日,Liquid 自己的定价页仍没有 LFM3 的费率。这一空白,决定了 LFM3 目前究竟是面向边缘设备的低价专用模型,还是只能下载后自行部署的发布版本。
LFM3 一句话概括:六款 2B 专用模型,API 价格暂未公布
LFM3 不是单一检查点,而是 Liquid AI 面向设备端专用智能推出的第三代基础模型家族。整个家族共享在 22 万亿 tokens 上预训练的 LFM3-1.7B-Base 主干,并包含六款模型:LFM3-1.7B、LFM3-VL-2B、LFM3-Audio-2B、LFM3-Omni-2B、d1-2B 和 d1-Omni-2B(公告)。
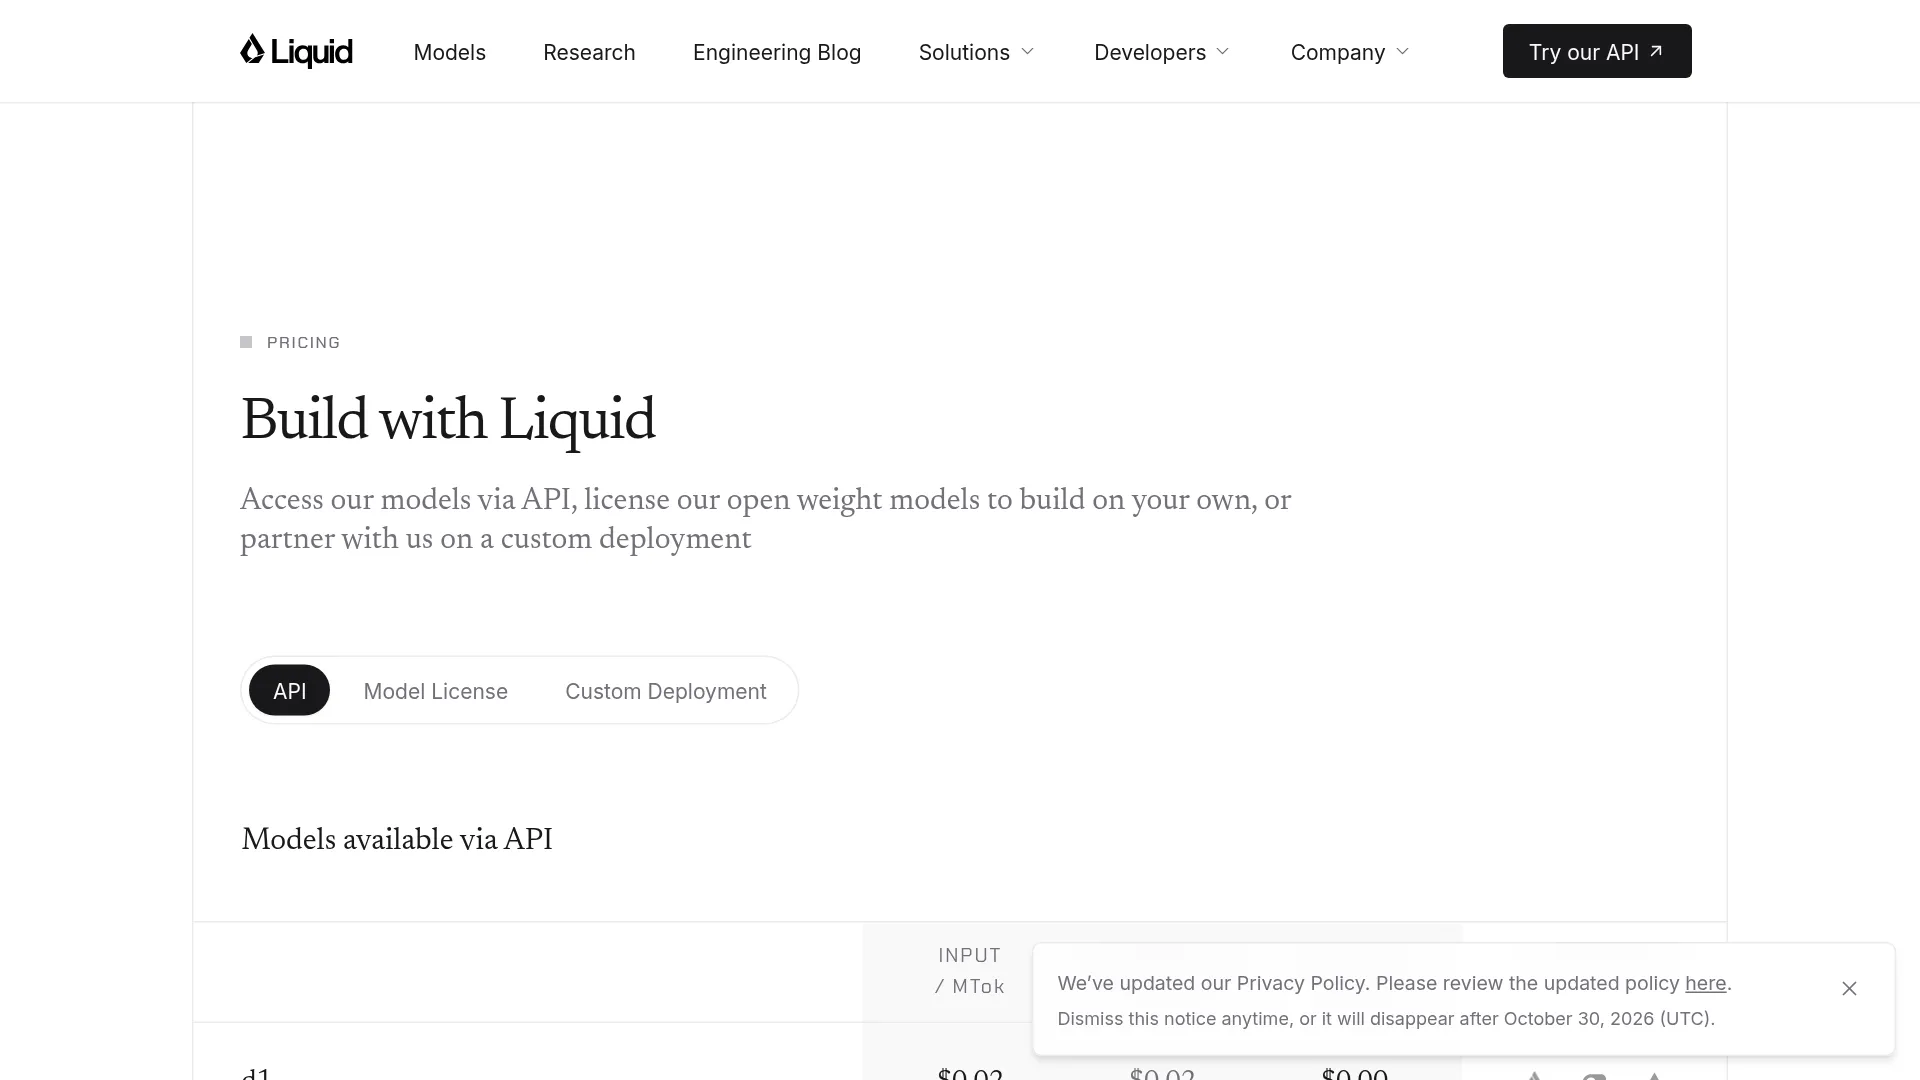
我在 10 月 27 日查看了 Liquid AI 的定价页:页面没有 LFM3 条目,只有下方表格中的 d1、d1-ultra 和 LFM2.5 费率。LFM3 公告称,模型权重可通过 Hugging Face、Liquid Playground 和 Liquid API 获取,但目前能直接核实的只有前两种方式。新组织仍可获得 2 美元的 Liquid Console 免费额度(定价页)。
六款模型怎么选:不同任务对应不同版本
六款 LFM3 检查点共用同一主干,但支持的输入和输出类型各不相同。
| 模型 | 大致规模 | 输入 | 输出 | 适用场景 |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | 文本 | 文本 | 本地智能体、工具调用、结构化输出 |
| LFM3-VL-2B | 1.9B | 文本、图像、视频 | 文本 | 图像和视频理解、视觉智能体 |
| LFM3-Audio-2B | 2B | 文本、音频 | 文本、语音 | 语音聊天、识别、合成,以及 18 种语言的翻译 |
| LFM3-Omni-2B | 2B | 文本、图像、视频、音频 | 文本、语音 | 统一的多模态助手 |
| d1-2B | 2B | 文本、图像、视频 | 校准后的答案 | 分类、信息提取、单次决策 |
| d1-Omni-2B | 2B | 文本、图像、视频、音频 | 校准后的答案 | 带置信度分数的多模态感知 |
LFM3-1.7B 支持 256K tokens 的上下文窗口,采用由 24 层组成的三路混合架构:13 层门控短卷积、5 层带 256-token 窗口的滑动窗口注意力,以及 6 层全局注意力(公告)。最后 3.5 万亿 tokens 的中期训练加入了智能体轨迹和工具调用,这也解释了 Liquid 为什么将文本模型定位为适用于 Hermes Agent、Pi 和 OpenClaw 一类的运行框架(公告)。LFM3-VL-2B 是 Liquid 第一款支持视频输入的视觉模型;LFM3-Omni-2B 则是其第一款全模态模型,可以同时处理音轨和画面(公告)。
决策模型的工作方式与其他版本不同。d1-2B 和 d1-Omni-2B 不进行自回归生成,而是通过一次前向传播直接返回带概率的校准答案(公告)。厂商公布的 d1-2B 决策延迟为:NVIDIA H100 上 5.7 毫秒,AMD MI325X 上 3.8 毫秒;对于带有 10 秒音频片段的 d1-Omni-2B,这两个数字分别升至 12.4 毫秒和 8.2 毫秒(公告)。
哪些是 Liquid 的说法,哪些已经可以自行验证
Liquid AI 给出的基准数据均来自厂商,独立测试出现前应将其视为厂商声明。下面所有数据都来自 Liquid 的公告。
| 模型 | 厂商公布的指标 | LFM3 数据 | 此前版本 / 竞品数据 |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02(LFM2.5-2.6B) |
| LFM3-1.7B | 规模 / 速度 | 在 8K 上参数量减少 35%,单参数速度比 LFM2-1.2B 快约 25% | — |
| LFM3-VL-2B | 62 项视觉平均分 / 编码器 | 平均分 71.4;编码器为 164M FLOPs,减少 2.2 倍 | 平均分 57.6;声称与 Qwen3.5-2B 编码器性能持平 |
| LFM3-Audio-2B | UTMOSv2 / 延迟 | 3.83;首 token 最低 50 毫秒;在 M4 Max CPU 上达到实时速度的 87 倍 | 3.22(LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0(d1-3B) |
我直接核实到的是:Hugging Face 上的 LiquidAI LFM3 集合列出了六款模型,并提供量化、MLX 和 ONNX 版本;LM Studio 的模型目录也已经出现了 LFM3 的桌面版本。分数只能作为参考方向,不能当作性能保证。平均分会掩盖 OCR、定位和视频子项的差异,而 4-bit 版本的 1GB 数据也不包含 KV cache 和应用本身的开销。
“现在做东西的速度真是快得离谱。”——@Nklockiewicz,通过 MLX/ExecuTorch 在飞行模式下的 iPhone 上运行 LFM3,速度达到 40 tok/s(来源)
“它们的速度和智能水平通常都超出同等规模模型的预期,但以我的经验来看,目前还不够聪明,无法胜任‘真正的工作’。”——u/spaceman_,r/LocalLLaMA(来源)
上线前必须看懂的 1000 万美元许可证门槛
Liquid AI 的开放权重许可证在企业年收入超过 1000 万美元前免费(定价页)。开发者、研究人员、非营利组织,以及年收入低于 1000 万美元的企业,都可以下载、运行、微调并将所有开放 LFM 用于生产环境;微调结果可以保持私有,也可以部署到移动端、边缘设备或本地环境,并且没有 copyleft 要求(定价页)。
年收入超过 1000 万美元的企业需要购买商业许可证,价格由销售团队根据部署规模确定。研究、教育和非营利用途无需收入限制,仍可免费使用(定价页)。LFM Open License 会在达到这一门槛后终止免费商业授权;如果要把模型权重嵌入商业应用,正式集成前仍应让法律顾问确认署名、再分发和出口条款。
本地运行:1GB 在实际使用中远远不止 1GB
LFM3-1.7B 的 4-bit 版本大约需要 1GB,但这个数字只计算了权重(公告)。实际运行时还要加载运行时环境、长上下文所需的 KV cache,以及视觉或音频编码器。因此,尤其是在 VL 和 Omni 版本处理视频帧或音频片段时,应在此基础上为内存预留额外空间。
建议先从 LFM3-1.7B 开始,只有确实需要时再选择 VL、Audio 或 Omni,并在测试前查看对应模型卡列出的额外依赖。LFM3 的 Ollama、LM Studio、llama.cpp、MLX 和 ONNX 路径,均可在 Hugging Face 集合和 LM Studio 目录中找到。
如果模型卡示例要求使用 trust_remote_code=True,请固定 commit hash、检查仓库代码,或先在隔离环境中运行,因为这个选项会执行仓库中附带的代码。Liquid 在公告中提到支持 18 种音频语言,但没有提供逐语言质量表,因此非英语输出仍需使用自己的数据验证。
现在怎么调用 API:入口和计费方式
Liquid 已宣布提供 LFM3 API,但公开定价页仍未单独列出价格;页面显示的调用入口包括 Liquid Console、OpenRouter 和 Vercel AI Gateway(定价页)。
| 10 月 27 日列出的 API 模型 | 输入 / MTok | 缓存输入 / MTok | 输出 / MTok |
|---|---|---|---|
| d1 | $0.02 | $0.02 | $0.00 |
| d1-ultra | $0.042 | $0.042 | $0.00 |
| LFM2.5-24B-A2B | $0.05 | $0.025 | $0.70 |
| LFM3-1.7B / VL / Audio / Omni 文本费率 | 未列出 | 未列出 | 未列出 |
这项缺失本身就是目前的价格结论:现阶段规划 LFM3 时,应按自托管算力加工程时间预算,而不是按每 token 的价格预算。如果现在有供应商报价提供 LFM3 tokens,应将其与页面列出的 d1 和 LFM2.5 基准价比较,并确认对方是在代理 Liquid Console,还是运行自己的模型权重。页面列出的 d1 输出价格为每百万 tokens $0.00,因此对于高吞吐量的检查流程,d1 可能很有吸引力。
LFM3 常见问题
LFM3 API 多少钱?
截至 2026 年 10 月 27 日,Liquid AI 没有列出单独的 LFM3 token 价格;公开页面只展示 d1、d1-ultra 和 LFM2.5-24B-A2B 的费率。
LFM3 可以免费商用吗?
根据 LFM Open License,年收入低于 1000 万美元的企业可以免费用于商业生产环境;规模更大的企业需要购买商业许可证。
LFM3 能在手机或笔记本电脑上运行吗?
可以。文本版本的 4-bit 权重约占 1GB,此外还需要运行时开销;Ollama、LM Studio、llama.cpp、MLX 和 ONNX 都有对应路径。VL、Audio 和 Omni 版本则需要为编码器及媒体处理预留更多内存。
LFM3 比 Qwen 或 Gemma 更适合边缘智能体吗?
我查看的发布日结果中没有发现独立对比;Liquid 宣称 LFM3 击败 Qwen3.5-2B 和 Qwen2.5-Omni-7B,但这些结论来自厂商(公告)。在切换之前,最好使用自己的运行框架,将 LFM3 与 Gemma、Qwen 进行测试。
可以用一块 GPU 微调 LFM3 吗?
Liquid 提供了用于 SFT、DPO、GRPO 和持续预训练的 notebook,并表示每款模型都能在单块 GPU 上完成微调(公告),但没有公布显存或数据集大小要求。
便宜的私有专用模型,还是需要运行框架配合的小型通用模型
如果数据必须留在设备上、媒体内容不能离开本地,或者决策量太大导致云端按 token 计费难以承受,LFM3 就很合适。但在广泛知识、长篇创造性推理,以及无需调试运行框架就能直接达到理想质量这些方面,它仍有不足。下载一个版本,在自己的提示词和硬件上测一遍,让实际结果而不是发布会图表来决定是否采用。