 AIREITER
2026 年 8 月 19 日,Liquid AI 在 LFM2.5-2.6B repo 里新增了一个 1.59 GB 的 Q4_0 文件,和原有文件并排放着:大小相同、名字几乎一样,实际却是两种模型。新增版本采用 QAD,即量化感知蒸馏,能挽回 4-bit 量化损失的大部分质量,官方给出的保留率也相当可观。问题在于,如果这两个文件里下错了一个,你跑的就是未经修补的旧版。
QAD 到底修补了什么
QAD 是 quantization-aware distillation(量化感知蒸馏)的缩写。Liquid AI 针对 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 和 LFM2.5-2.6B 这四个模型进行训练:让低精度学生模型在训练中接受高精度教师模型的蒸馏,同时直接面对 Q4_0 的舍入误差,并学会适应这些误差。
同一仓库中原有的 Q4_0 文件则属于训练后量化(PTQ):先完成 BF16 模型训练,再把权重直接降精度,没有任何环节去补偿量化误差。根据 Liquid AI 的发布文章,四个 QAD 检查点在涵盖推理、指令遵循、工具调用和 Agent 行为的测试套件中,整体平均可达到各自 BF16 平均分的“约 97%”;每项结果均取五次运行的均值。QAD 是训练阶段的改进,不是新文件格式。产物仍是 llama.cpp 已可直接运行的标准 GGUF Q4_0。
两个同尺寸文件:别被命名坑了
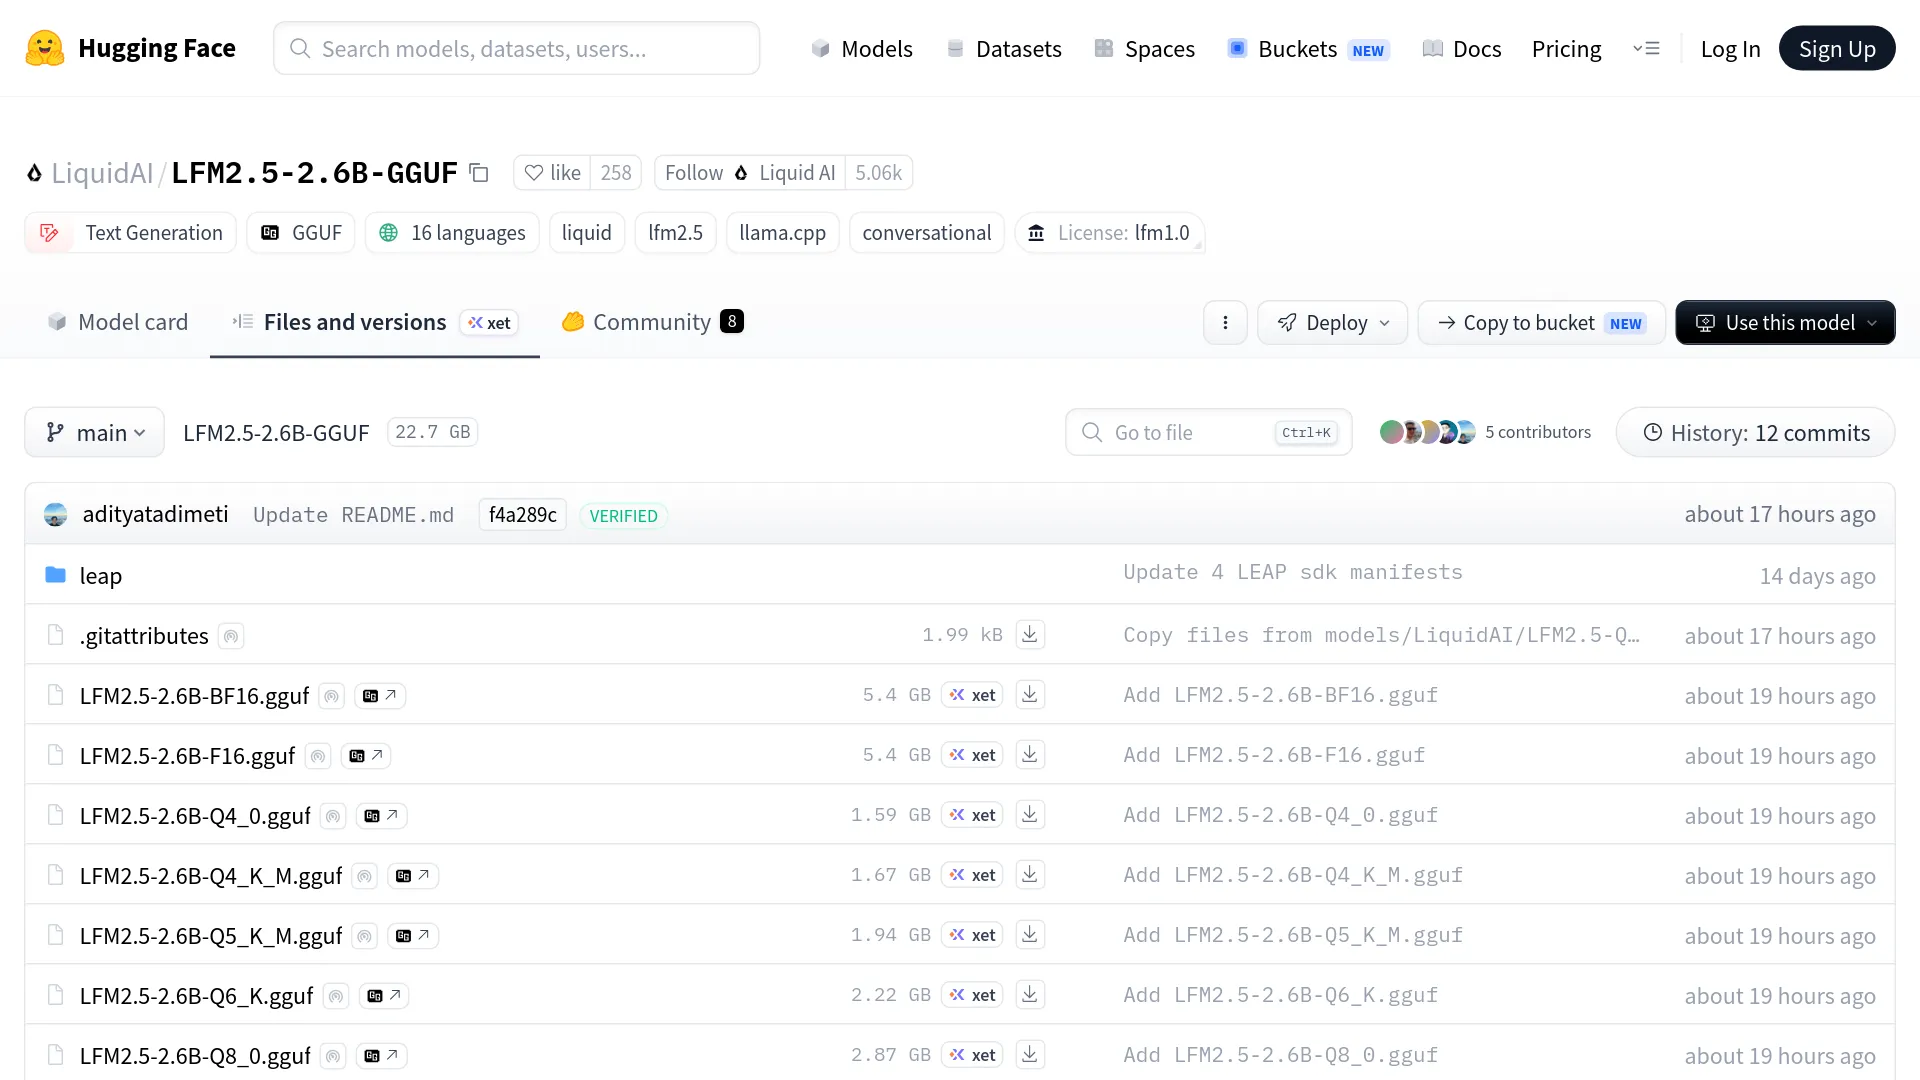
LFM2.5-2.6B 仓库同时有 LFM2.5-2.6B-Q4_0.gguf 和 LFM2.5-2.6B-QAD-Q4_0.gguf,列表里都显示为 1.59 GB。仓库默认提供的命令片段指向的是 Q4_K_M,而不是 QAD,因此直接复制粘贴甚至不会下载任一 QAD 文件。必须明确指定文件名。
发布后数小时内,社区就已经有人踩到这个坑:
“该去哪里下载?我在 huggingface 上看到了,但不确定那是普通版本还是 QAD。能指导一下吗?”——X 上的 @Chitacc72
早期用户 @MarMarLabs 对比仓库文件后发现,新旧 Q4_0 构建版只相差约 4 KB,在文件浏览器里根本看不出来。解决办法是让 --hf-file 指向准确的 QAD 文件名:
# Liquid AI 发布文章中的官方示例
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B,使用官方模型卡给出的采样参数
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
230M 和 1.2B-Instruct 仓库也适用同样的 --hf-file 写法。服务端部署方面,@nicolasembleton 发现 Hugging Face 生成的命令并不完整后,给出了可用的简写:llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0。冒号后的限定符才是选中 QAD 构建版的关键。
官方数据能证明什么,不能证明什么
Liquid AI 的基准测试表显示,各 QAD 检查点保留了 BF16 基线质量的 96.5% 至 97.4%。测试集包括 GPQA Diamond、MMLU-Pro、IFEval、IFBench、Multi-IF 和 BFCLv4;两个小模型额外包含 GSM8K,两个大模型额外包含 AIME25,全部结果取五次运行的平均值。
| 检查点 | 保留的 BF16 质量 | 质量结论 | 解码吞吐量 |
|---|---|---|---|
| LFM2.5-230M | 97.1% | 在方差范围内与 Q5_K_M 持平 | 比 Q5_K_M 快 +4–33% |
| LFM2.5-350M | 96.5% | 在方差范围内与 Q5_K_M 持平 | 比 Q5_K_M 快 +4–33% |
| LFM2.5-1.2B-Instruct | 97.4% | 与 Q4_K_M 持平 | 比 Q4_K_M 快 +3–14% |
| LFM2.5-2.6B | 96.6% | 与 Q4_K_M 持平 | 比 Q4_K_M 快 +3–14% |
吞吐测试覆盖四个目标平台:MacBook Pro 和 NucBox EVO-X2 的 GPU,以及 Samsung Galaxy S26 Ultra 和 Raspberry Pi 5 的 Arm CPU。对于 230M 与 1.2B 模型,Liquid AI 还称 QAD Q4_0 可与 Unsloth 的 UD-Q4_K_XL 持平,后者在文章中被称为强劲的外部 PTQ 检查点。
不过,发布文章没有给出各单项基准分数、各设备的原始 tokens-per-second、文件尺寸、RAM 占用,也没有方差条。呈现出来的只有百分比区间和“持平”结论。社区很快补上了文件大小这部分算术:
“所以你的意思是,我可以把本地 LFM2.5-2.6B 从 F16 换成 QAD Q4_0:5.4 GB -> 1.6 GB,21 -> 64 tok/s……同时保留约 97% 的 BF16 性能?”——@firedUp_Neyu,根据 Liquid 的发布图表计算
文件大小部分确实对得上:官方仓库里的 F16 为 5.4 GB,QAD Q4_0 为 1.59 GB。tok/s 则是他从图表中读出的数值,并非 Liquid AI 以文本形式明确公布的数据。
发布信息没说清的三件事
如果你正在考虑把生产部署切到这些文件,下面三个空白需要留意。
目前仅覆盖四个检查点。发布时 LFM2.5-VL-450M 和 LFM2.5-8B-A1B 都没有 QAD 构建版,X 上的发布讨论中也已经有用户向 Liquid AI 索要 8B 版本。如果你的设备目标就是这两个模型之一,那么 QAD 目前对你没有任何改变。
imatrix 仍是悬而未决的问题。QAD 文件是为 Q4_0 训练的,但生成时没有使用 importance matrix,量化关注者立刻指出了这一点:
“这个 QAD Q4_0 GGUF 没有使用 imatrix 生成,而 imatrix 本来还能进一步提升 QAD 训练模型的质量。”——u/Chromix_,r/LocalLLaMA
不到 3B 的模型,能力上限依然不到 3B。量化修复不会抬高模型本身的能力天花板,LocalLLaMA 讨论帖里就有实际案例。一位 NPU 用户这样评价:
“我刚在 NPU 上部署 LFM2.5 2.6B 来做会议纪要。以这个尺寸来说确实令人印象深刻,但生成的摘要比大模型差太多了。”——u/DerDave
这属于模型侧限制,而不是量化侧问题:KikoCis 量化报告记录到,Q8_0 在 SWE-bench Verified 上解决的实例数为 0/6;1.2B 用户也反馈质量会随运行环境大幅波动——一个 Ollama 配置下,10 个提示中有 9 个输出乱码;另一个单板计算机环境里,却能以低于 5W 的功耗稳定工作。如果某项任务确实需要前沿级质量,通过低成本 LLM API用大模型交叉检查本地输出,跑完整套测试只需几美分。
QAD Q4_0 和 Q4_K_M,该选哪个
对于这四个检查点,在 RAM 紧张的 llama.cpp 部署中,QAD Q4_0 是值得优先测试的厂商支持型 4-bit 默认选择。它与普通 Q4_0 同为 1.59 GB,却通过训练达到 Q4_K_M(1.2B、2.6B)或 Q5_K_M(230M、350M)的质量,同时解码分别快 3–14% 或 4–33%。但如果你本来就在跑 Q4_K_M,而且 RAM 有余量,那就继续用;80 MB 并不是你真正需要解决的问题。
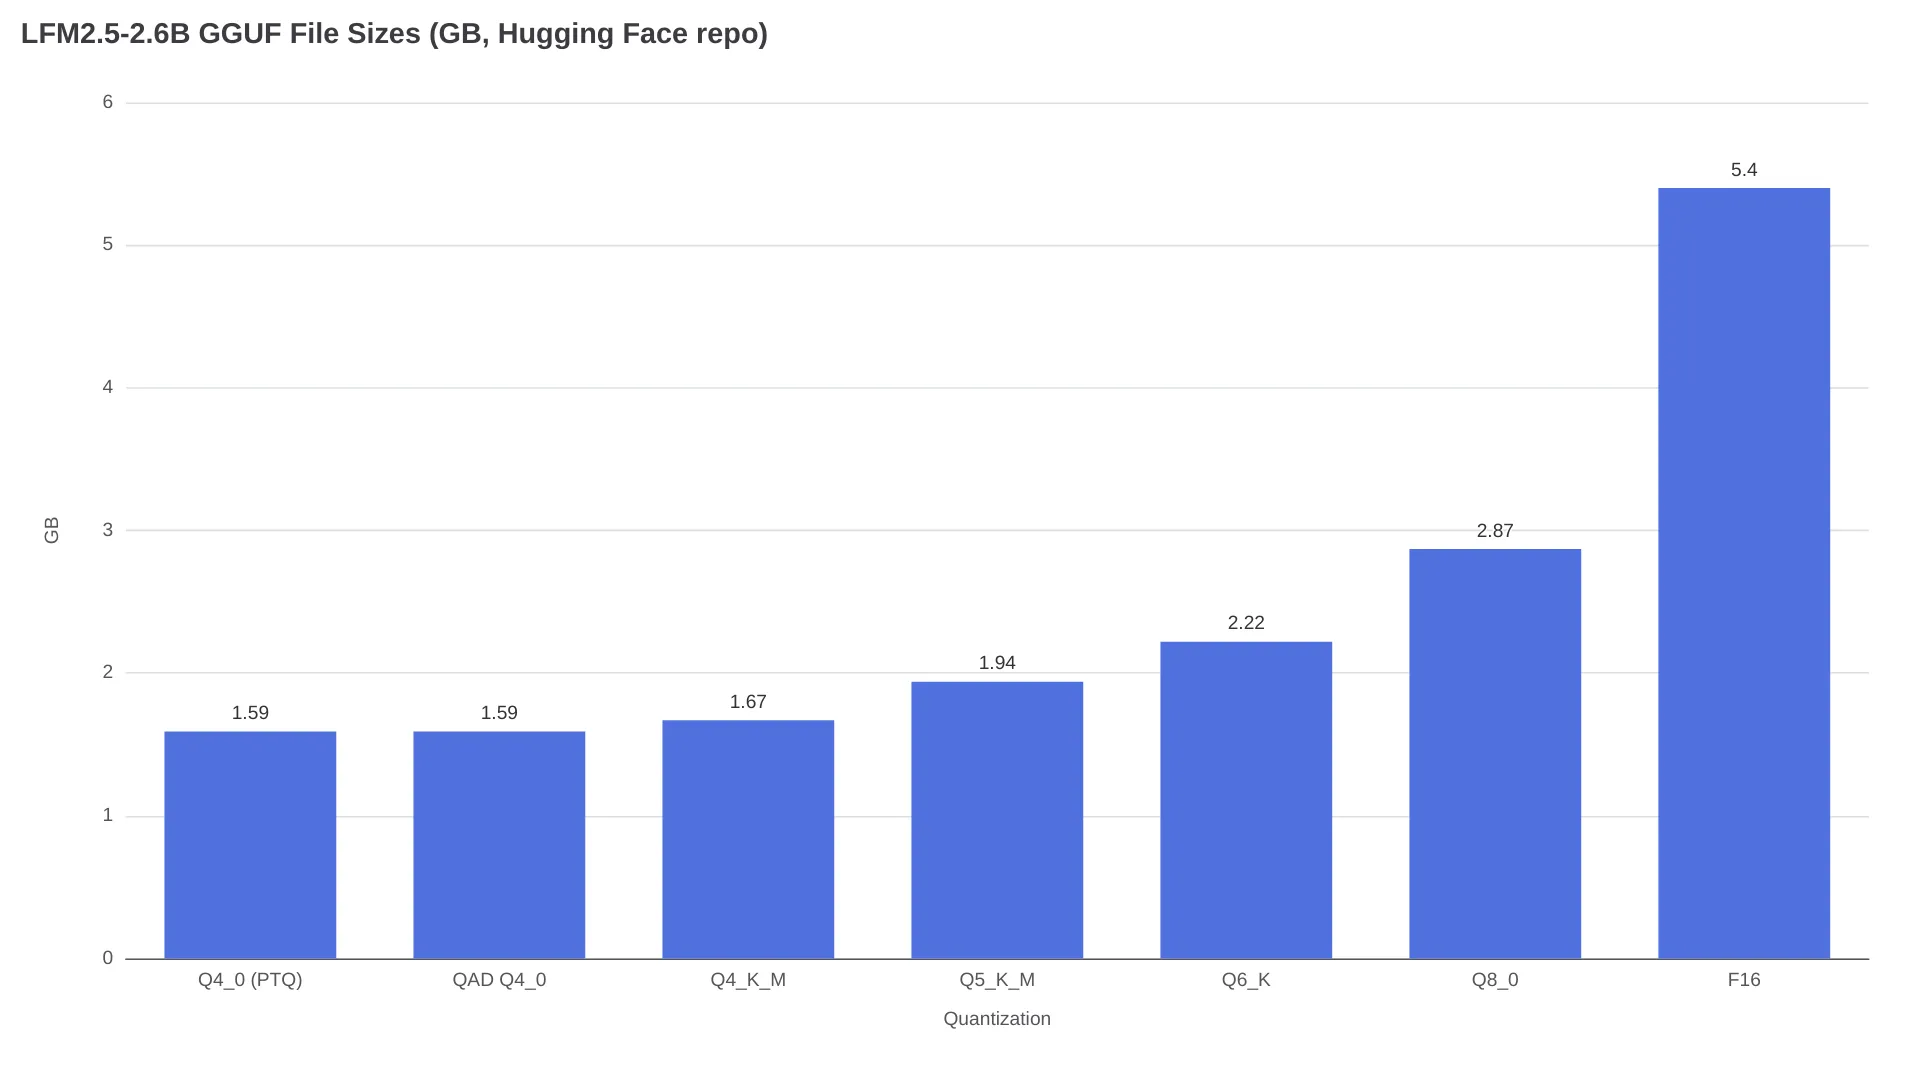
| 文件(2.6B) | 大小 | 定位 | 适合何时选择 |
|---|---|---|---|
| Q4_0(旧 PTQ) | 1.59 GB | 未经修补的基线版本 | 跳过,现在已有 QAD |
| QAD Q4_0 | 1.59 GB | 达到 BF16 的 96.6%,与 Q4_K_M 持平 | 3–4 GB RAM 预算、CPU 解码、手机、Pi |
| Q4_K_M | 1.67 GB | Liquid 文档的默认推荐 | 你的运行时无法选择 QAD 文件 |
| Q5_K_M | 1.94 GB | 根据 KikoCis,top-1 相对 F16 为 91.4% | 6 GB+ RAM |
| Q6_K / Q8_0 | 2.22 / 2.87 GB | 接近无损 | 8 GB+、质量优先 |
需要补充的是这些“持平”结论的背景:KikoCis 的 PTQ 阶梯测试显示,这个模型的 Q4_K_M 相对 F16 的 top-1 token 一致率为 84.36%,Q6_K 为 95.07%,Q8_0 为 98.23%。Liquid 的说法是:QAD 能以相同字节数弥合 4-bit 的保真度差距——这来自他们自己的五次运行数据,尚无独立复现。发布当天的讨论里,有一句很好的校准:
“这不是‘Q4_0 击败 K-quants’,而是这四个检查点专门针对 Q4_0 训练过。”——@MarMarLabs
不要把这一优势泛化到其他模型上。其他模型的 Q4_0 文件仍然只是普通 PTQ。
内存方面,发布文章没有提供 RAM 数据,因此可参考 KikoCis repo 的计算:2.6B 的 f16 KV cache 约为 16 KB/token,32K 上下文约占 0.54 GB,原生 128K 窗口约占 2.15 GB;使用 --cache-type-k q8_0 --cache-type-v q8_0 可将缓存占用减半。QAD Q4_0 权重为 1.59 GB,加上 32K 上下文约为 2.13 GB,尚未包含运行时开销;128K 则会超过 3.7 GB。因此应把 4 GB 视为比较勉强的配置,并在目标运行时中实际确认分配情况。
常见问题
QAD Q4_0 比 Q4_K_M 更好吗?
对这四个检查点来说,Liquid AI 的数据表明,QAD Q4_0 能以更小文件和更高解码速度达到 Q4_K_M 的质量;对于两个最小模型,甚至达到 Q5_K_M。因此在 RAM 有限时,答案是肯定的。但这些数据由厂商测试、重复五次得出,目前尚无独立复现。
Ollama 或 LM Studio 会自动识别 QAD 文件吗?
不会。根据官方仓库页面,Ollama 文档给出的方式是 ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M,Hugging Face 的默认命令片段也指向 Q4_K_M。任何支持 GGUF 的运行时都能加载 QAD 文件,但你必须通过明确文件名或 :QAD-Q4_0 限定符主动选择它。
LFM2.5-2.6B QAD Q4_0 需要多少 RAM?
权重占 1.59 GB;KikoCis 的计算显示,f16 KV cache 在 32K 上下文约为 ~0.54 GB,在 128K 时约为 ~2.15 GB。权重加缓存的理论值,在 32K 时接近 2.13 GB,在 128K 时为 3.74 GB,均未计入运行时开销。使用 Q8_0 KV-cache 量化可将缓存成本减半。
哪些 LFM2.5 模型有 QAD 检查点?
截至 2026 年 8 月 19 日,只有 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 和 LFM2.5-2.6B。VL-450M 与 8B-A1B 变体均没有,尽管已有用户在发布讨论中要求 Liquid AI 推出 8B QAD 构建版。
LFM2.5 QAD 检查点可以商用吗?
这些仓库标注为 LFM Open License v1.0。社区仓库将条款概括为:年收入低于 $10M USD 的实体可商用;达到或超过这一门槛时,需要单独获取 Liquid AI 商业许可证(KikoCis 的说明)。实际发布产品前,请自行阅读许可证原文。
97% 的说法经过独立验证了吗?
目前还没有。96.5–97.4% 的保留率来自 Liquid AI 随发布公布的五次运行平均值;本文撰写时,尚未出现第三方对 QAD 文件的基准测试,r/LocalLLaMA 上关于 imatrix 的问题也仍未有定论。
今晚就做一次自己的 A/B 测试
真正重要的是你的任务错误率,而不是某个基准平均分。拿十条真实提示——工具调用 JSON、你的信息提取 schema、你的语言——在完全相同的设置下分别跑两个文件:
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
按文件统计解析失败次数和工具选择错误次数,不要凭感觉下结论。这里确实存在尚未完全消失的取舍:从纸面上的每 GB 质量平均值看,QAD Q4_0 更占优;但你的部署会遇到什么故障——例如推理消耗掉 token 预算后出现空回答,或特定温度下格式漂移——取决于运行时和具体任务。只有你自己的这十条提示,才能给这种差异定价。