 AIREITER
如果你的任务需要反复提交超长提示词,并且能够稳定命中缓存,K3 通常更合适;如果你在构建需要内置思考控制的智能体,Claude Opus 5 更值得优先考虑。本文只比较官方已说明的限制和集成行为,并未在缺少同一提示词基准测试的前提下判定两者谁的质量更高。
先看结论:按任务类型选
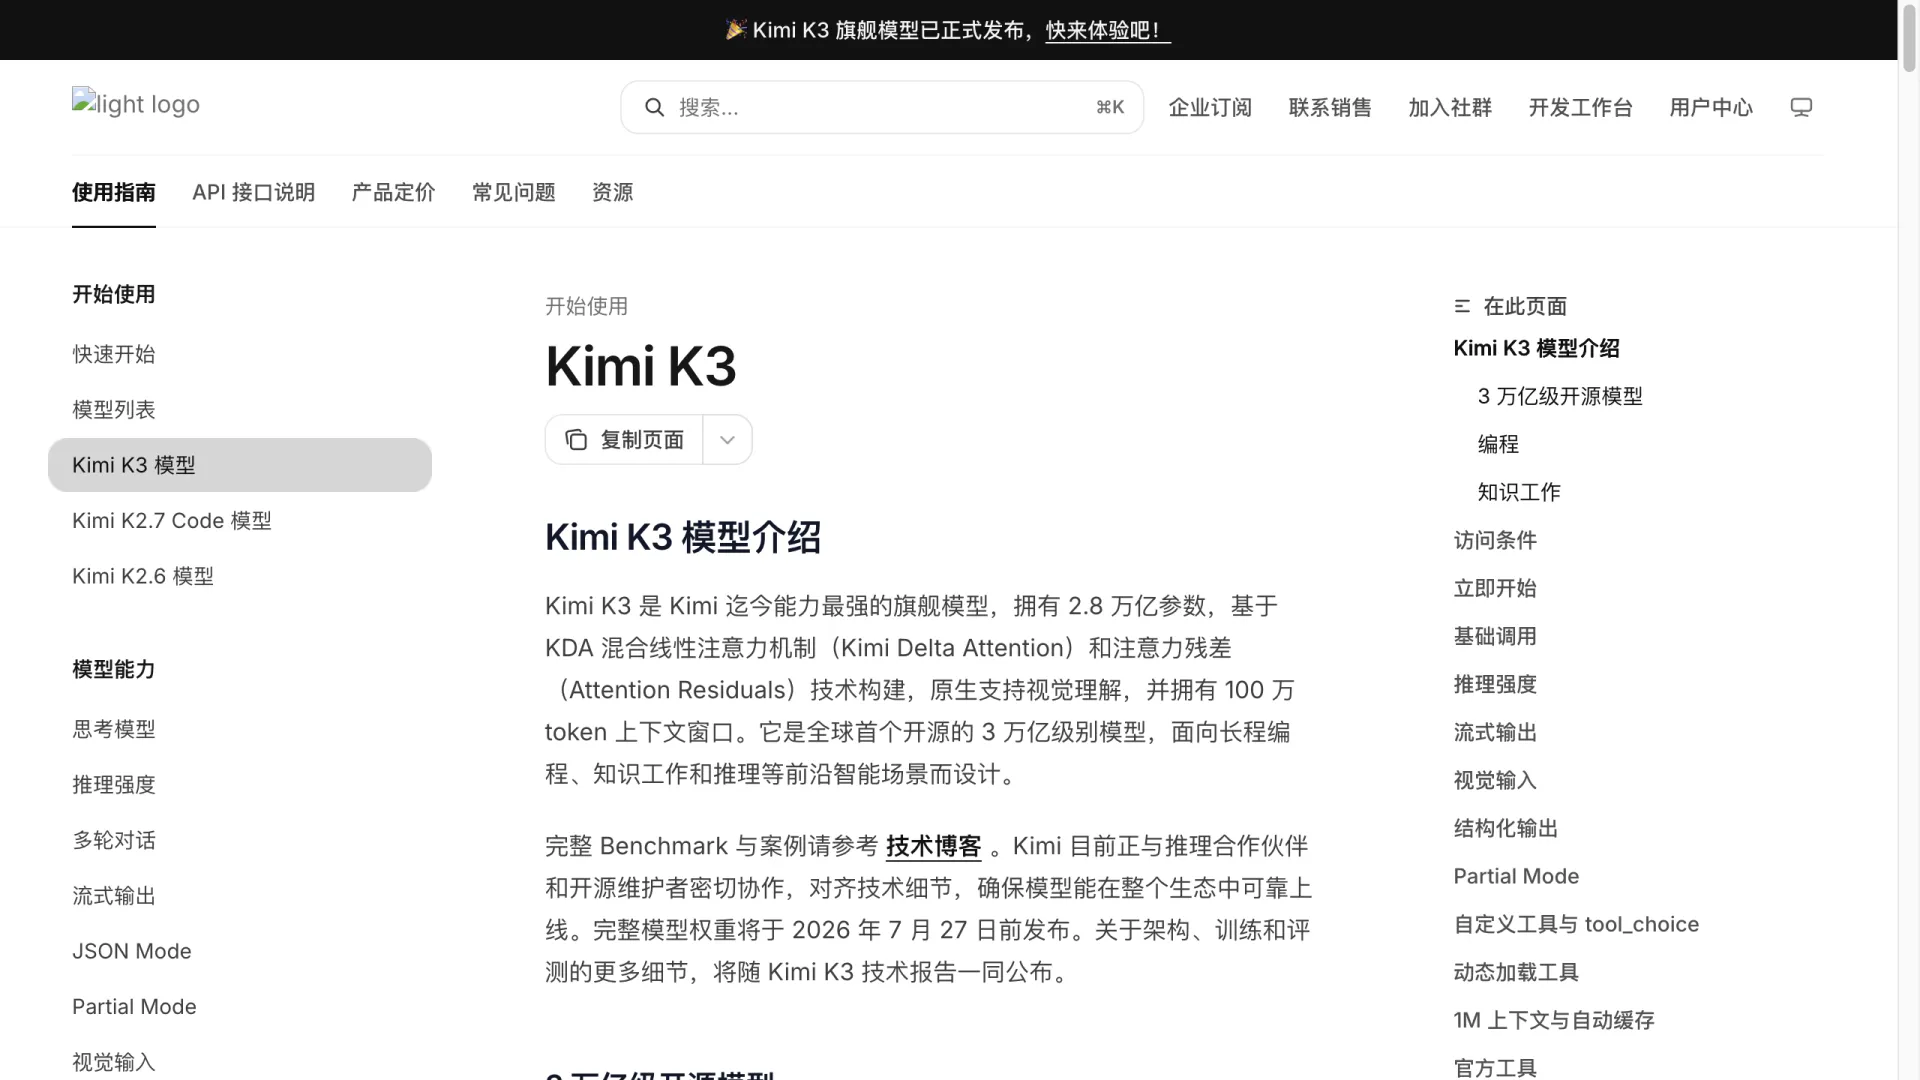
需要百万级上下文窗口、且输入成本高度依赖缓存的团队,可以优先看 Kimi K3;更看重默认思考能力和 effort 控制,而非极限上下文长度的团队,则更适合 Claude Opus 5。
| 决策维度 | Kimi K3 | Claude Opus 5 | 更适合的选择 |
|---|---|---|---|
| 上下文窗口 | 1,048,576 tokens | 200,000 tokens | 超大输入选 K3 |
| 标准输入价格 | 缓存命中 ¥2/M;未命中 ¥20/M | $5/M | 按下文示例汇率计算,K3 更低 |
| 标准输出价格 | ¥100/M | $25/M | 按下文示例汇率计算,K3 更低 |
| 工具使用 | 已有工具调用和工具选择控制的文档说明 | 支持工具使用;关闭 thinking 存在已说明的边界情况 | 取决于工具 schema 和 thinking 设置 |
| 接入方式 | Kimi API | Claude API 和列出的云服务路径 | 确认是否支持你的指定服务商 |
价格与上下文,直接决定使用成本
截至 2026 年 8 月 7 日核查,Kimi K3 官方定价页显示:缓存命中时,每百万输入 tokens 为 ¥2;未命中时为 ¥20;每百万输出 tokens 为 ¥100。该页面同时标注了 1,048,576-token 的上下文窗口。对于能够实际命中缓存的重复长提示词任务,这套组合更有成本优势。
截至 2026 年 8 月 7 日核查,Claude Opus 5 官方模型文档列出的标准 API 价格为:每百万输入 tokens $5、每百万输出 tokens $25,上下文窗口为 200k。
仅按原生币种的 token 成本计算,一次包含 180k 输入和 8k 输出的请求,K3 在缓存命中时为 ¥1.16,未命中时为 ¥4.40;Opus 5 按标准费率则为 $1.10。这一请求没有超过 Opus 5 的上下文窗口,但实际账单仍取决于你的合同汇率、缓存资格以及最终计费的输出量。
工具调用与思考机制,是集成时真正的分界线
Kimi 的 K3 API 文档明确涵盖工具调用、工具选择、动态工具加载、JSON mode 和结构化输出。对于受 schema 严格约束、需要按工具路由的应用,这些控制项尤其重要。
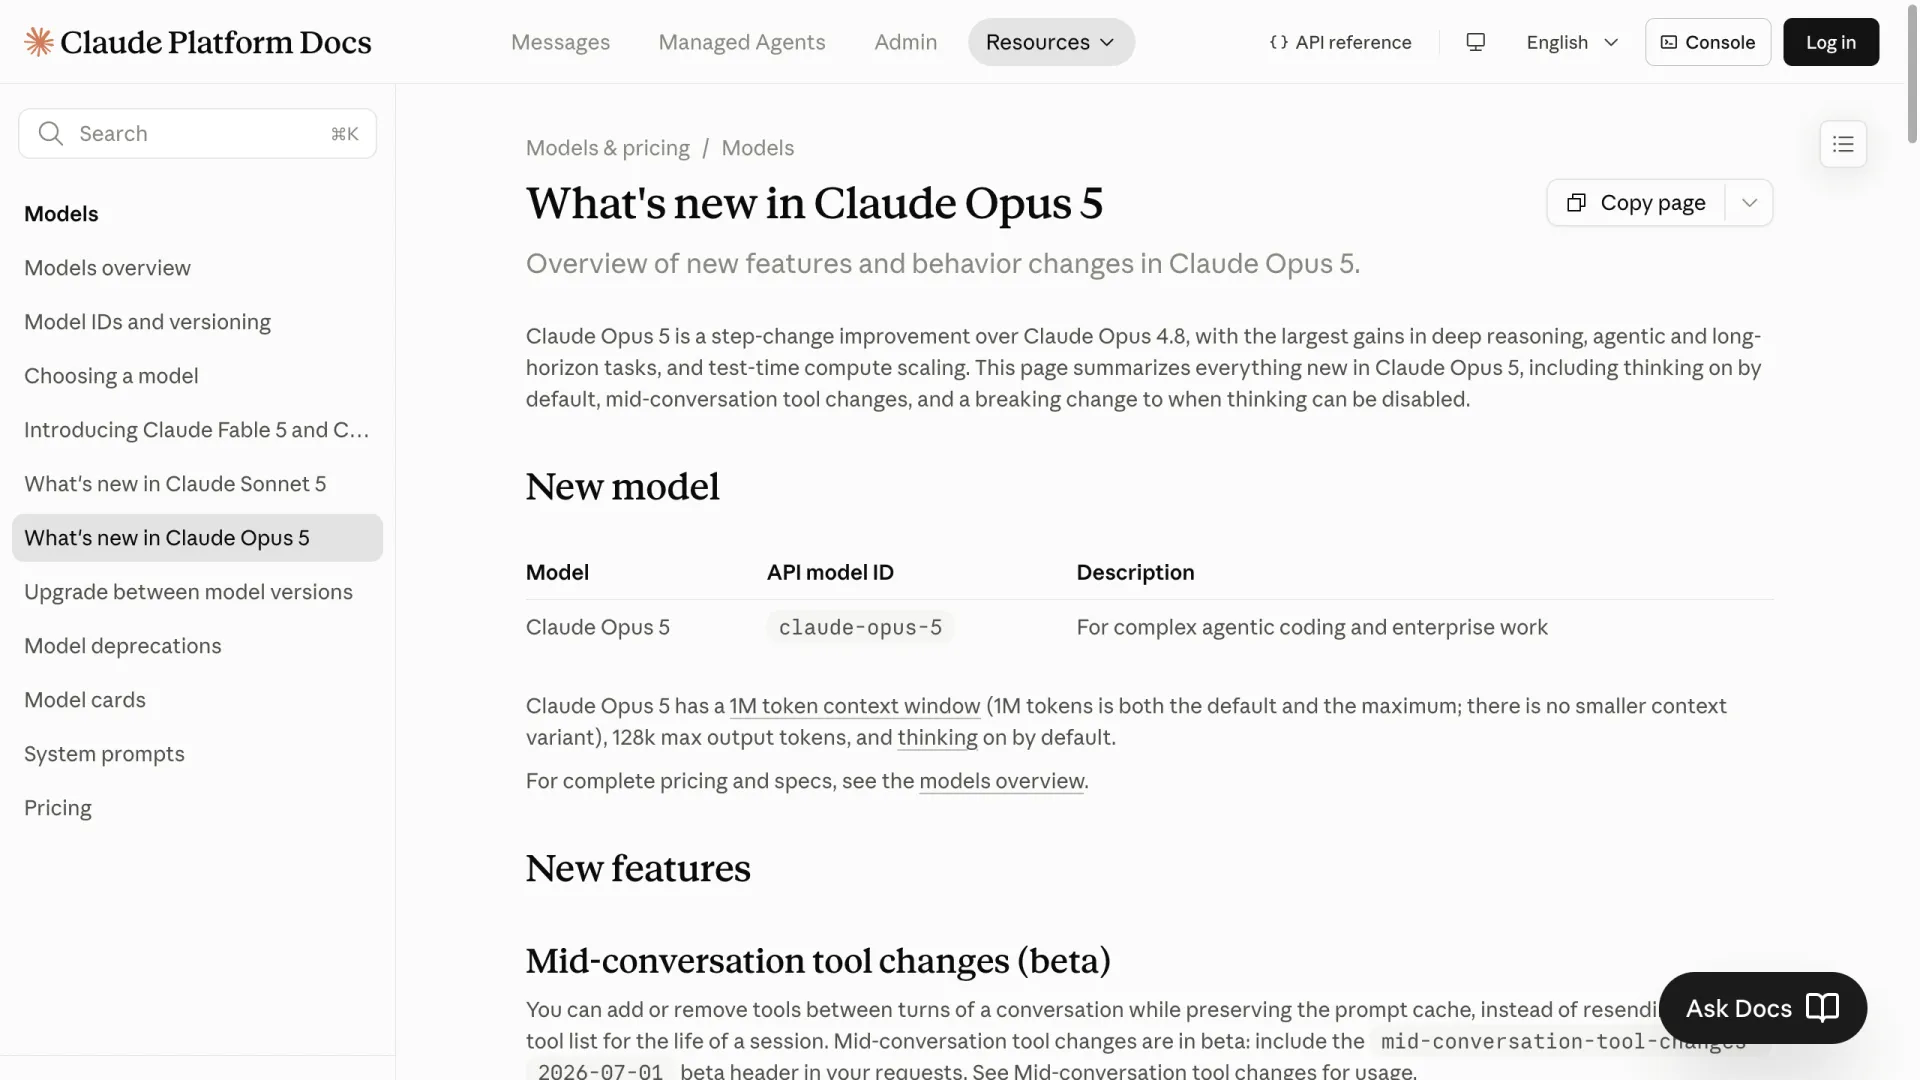
Claude Opus 5 默认启用 thinking,模型会在每一轮自行决定思考量,effort 参数则用于控制思考深度。Anthropic 的文档说明了一项破坏性约束:在高 effort 下不能关闭 thinking;而在关闭 thinking 时,模型偶尔会把工具调用写进可见文本,而非输出 tool_use block。
若工具调用必须保持稳定的结构化形式,Opus 5 应保留 thinking;如果核心需求是明确的工具控制和面向 schema 的输出,K3 更合适。
常见工作负载下,分别该怎么选?
长文档与知识类任务
当资料集合超过 Opus 5 已说明的 200k 上下文限制时,K3 更有优势。
如果语料可以放进 200k 上下文,Opus 5 默认启用 thinking 的行为,比单纯比较上下文大小更值得关注。
编程与长周期智能体
如果默认 thinking 和 effort 控制的重要性高于将整个代码仓库塞进一次提示词,那么新建智能体时可以选择 Opus 5。
如果智能体需要超大且可缓存的上下文,可选择 K3,但应在接近生产环境的任务中验证它的工具调用协议。
成本敏感的 API 工作负载
对于可缓存、输入占比较高的任务,值得先对 K3 做价格测试,并记录缓存状态,因为其缓存命中与未命中的输入价格差异很大。
对于 Opus 5,应使用有代表性的工作负载测量实际计费输出,因为它默认启用 thinking。
在最终确定前,应通过两个 API 运行有代表性的提示词,并记录缓存命中率、工具调用有效性、延迟和计费输出量。