 AIREITER
如果你的编码 Agent 上下文通常不超过约 150K token,Hy3 是更明智的选择:输入价格与对手大致相当,推理能力则更强。但一旦会话很长、代码仓库很大,或者生产环境需要高并发,DeepSeek V4 Flash 会凭三项 Hy3 无法匹敌的指标胜出:1M token 上下文窗口、明确标注的 $0.0028 缓存命中价格,以及 2,500 请求的并发上限。这就是 hy3 vs deepseek v4 flash 的核心结论。以下判断基于 2026 年 7 月 14 日核对的 DeepSeek 官方文档与 OpenRouter 实时报价、第三方基准数据,以及 Hacker News 和 Reddit 开发者日常同时使用两款模型后的反馈。
两款模型,押注方向完全不同
腾讯在 2026 年 7 月 6 日发布了正式版 Hy3,此前的预览版自 4 月 23 日起已上线。按官方说法,它是一款 Mixture-of-Experts 模型,总参数量 295B、激活参数 21B,核心思路是腾讯所称的“快慢思考混合”:模型会按请求自行决定投入多少推理。上下文窗口最高为 256K token。权重以 Apache 2.0 协议开放,API 则通过 Tencent Cloud TokenHub 提供。
DeepSeek V4 Flash 于 2026 年 4 月推出,是 V4 系列的高速档位。它同样是开放权重的 MoE 模型;根据 Artificial Analysis 数据,总参数量为 284B、激活参数 13B。它采用 MIT 协议,目标则截然不同:以低成本承载 1M token 上下文。模型支持思考与非思考两种模式,默认开启思考,最大输出为 384K token。
两者参数规模看起来相近,设计重点却不同。Hy3 更注重每个 token 的推理质量;Flash 则优先服务超长上下文、缓存效率与吞吐量。后文绝大多数实际差异,都源自这条分界线。
| 规格(核对日期:2026-07-14) | Hy3 | DeepSeek V4 Flash |
|---|---|---|
| 参数量 | 总计 295B / 激活 21B | 总计 284B / 激活 13B |
| 上下文窗口 | 256K | 1M(最大输出 384K) |
| 推理机制 | 快慢思考混合 | 思考 + 非思考模式 |
| 许可证 | Apache 2.0 | MIT |
| 发布时间 | 2026 年 7 月 6 日(预览版 4 月 23 日) | 2026 年 4 月 |
| 官方 API | Tencent Cloud TokenHub | api.deepseek.com(OpenAI + Anthropic 格式) |
跑分能说明什么,不能说明什么
在 Artificial Analysis Intelligence Index v4.1 上,Hy3 得分为 41,DeepSeek V4 Flash 在高强度推理模式下为 37。四分差距确实存在,大致相当于 Flash 与低一个梯队模型之间的距离,但还谈不上跨代差异。两者都属于“能力很强、但并非前沿”的区间。
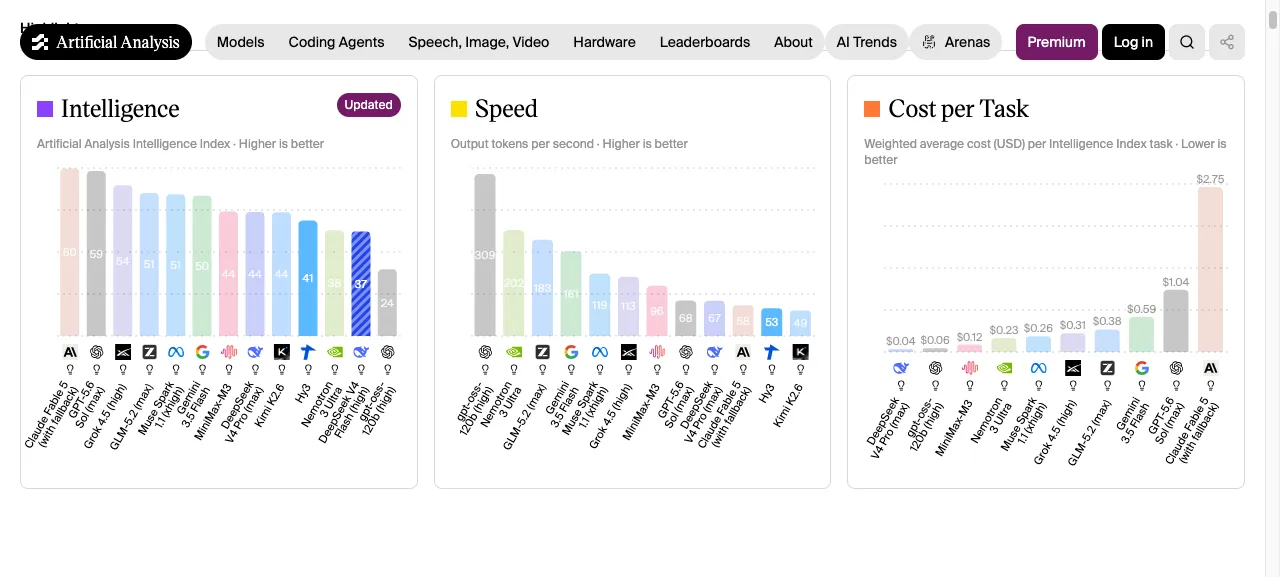
不过,在据此做决定前,有两点需要先说清楚。
首先,Agent 编码基准对两者的评价都更严苛。Hacker News 发布讨论串中,有评论者找到了 Hy3 的 DeepSWE 成绩:28%,而 GPT-5.4 在最高推理强度下达到 52%。这两款中国模型都还无法接近前沿 Agent 编码能力;它们竞争的对象是彼此,而不是排行榜顶端的模型。
其次,两家厂商自行发布的基准表都应保持常规怀疑。Hy3 的发布成绩在 HN 讨论中很快被质疑“benchmaxxed”,而 DeepSeek 的表格也只覆盖了它选择运行的评测。更值得作为依据的是上面的第三方数据:Hy3 略聪明一些,但差距小到足以被价格和上下文能力反转。
价格:标价并不是重点
这里有两份价格表,均于 2026 年 7 月 14 日核对,不能混为一谈。DeepSeek 在 API 文档中公布了准确的官方每 token 价格。腾讯尚未为正式版 Hy3 发布同等的英文费率表——新闻稿仅提到 TokenHub 上 Hy3 预览版输入价格约为每百万 token $0.18——因此下表 Hy3 一列采用的是 OpenRouter 的挂牌价格,这属于聚合平台价格,并非一手官方报价。
| 每 1M token | Hy3(OpenRouter 聚合平台) | DeepSeek V4 Flash(官方 API) |
|---|---|---|
| 输入 | $0.14 | $0.14(缓存未命中) |
| 输入,已缓存 | $0.035 | $0.0028(缓存命中) |
| 输出 | $0.58 | $0.28 |
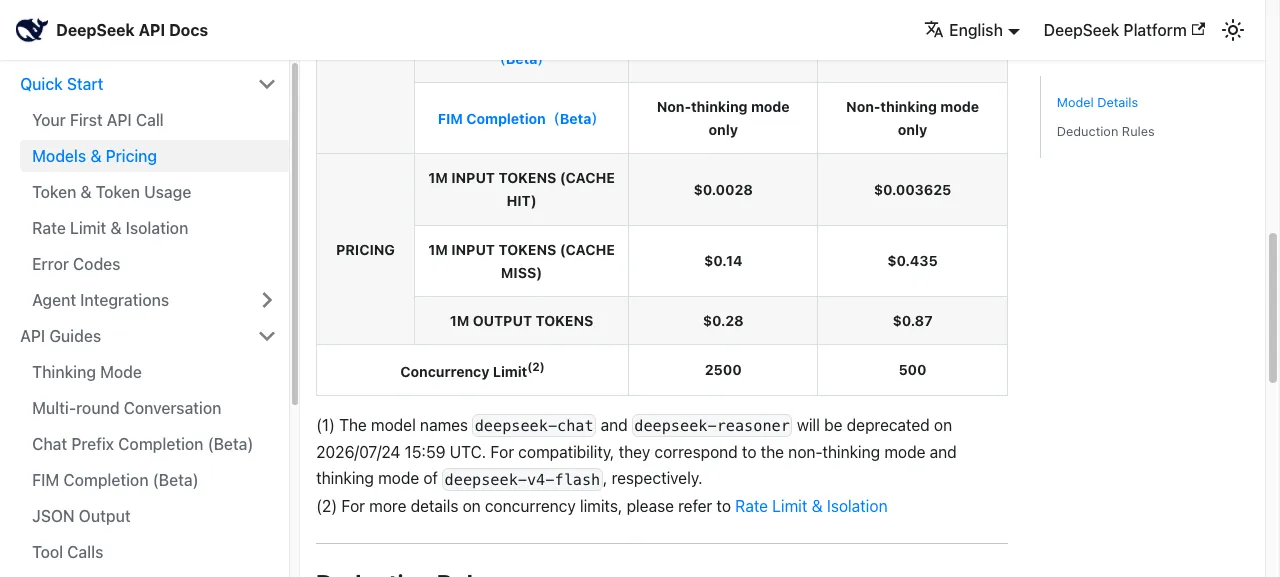
两者的输入标价完全一样。真正拉开差距的是另外两行。
缓存命中才是成本分水岭
DeepSeek 的缓存命中价比其缓存未命中价低 50 倍,也比 OpenRouter 上 Hy3 的缓存价格低 12.5 倍。(两项缓存价格并不完全等价:DeepSeek 是官方 API 价格,而 Hy3 是 OpenRouter 底层供应商对缓存读取的收费;但它们确实是你现在会实际支付的价格。)对于运行 Agent 的用户,这比本文其他任何数字都更重要。Agent 每一轮都会重新发送不断增长的上下文,包括系统提示、工具定义、文件内容和对话记录。一个 40 轮会话中,绝大部分输入 token 都是重复内容。若缓存命中率为 90%,Flash 的有效输入价会从每百万 token $0.14 降至约 $0.017;Hy3 则降至约 $0.045。两者都不贵,但 Hy3 仍接近 3 倍,而且会话越长,差距越大。
Hy3 的输出成本更高
两者都是推理模型,因此思考 token 都按输出计费。Hy3 的输出价格为 $0.58,超过 Flash 的 $0.28 两倍,所以每一段较长的推理链,Hy3 用户的成本大约都是两倍。Flash 还有 Hy3 没有的一个调节手段:针对格式化、信息提取、简单修改这类机械任务,可切换为非思考模式,避免为不需要的推理付费。deepseek-v4-flash-vs-deepseek-v4-pro 的对比文章详细说明了这一模式切换在实际中的用法。
免费档是 Hy3 的真实优势
Hy3 有一项明确优势:OpenRouter 提供 tencent/hy3:free 零成本版本,虽然有限流,但确实可用。若只是先评估模型再决定是否投入,这比没有免费 API 档的 Flash 更有吸引力。Hy3 预览版目前也仍标价 $0.063/$0.21,低于正式版;如果你能接受 4 月的检查点,这也是一个选项。
超长上下文背后的隐性成本
256K 上下文听起来很充裕,直到你让 Agent 真正面对一个代码库。r/hermesagent 的一位 Reddit 用户在同一套框架中运行两款模型后,形容 Hy3“除了上下文大小之外几乎一样,因此需要频繁压缩”。上下文压缩不只是使用体验问题:每次压缩都要消耗输出 token 来生成摘要、丢失细节,并让提示缓存失效,之后重建缓存时又得支付缓存未命中价格。
如果自行部署,差距会变成架构层面的问题。V4 架构的稀疏注意力设计——DeepSeek 将该机制称为 lightning indexer——让其 KV 缓存远比 Hy3 的常规注意力机制轻量。这些都是单用户报告,并非标准基准测试,但该 HN 讨论串中的数据相当醒目:一名同时在两台 DGX Spark 上运行两者的评论者称,DeepSeek V4 Flash 可在 KV 缓存中容纳 3M token,而量化到 FP4 的 Hy3 约只能容纳 130K token。另有人估计,等 llama.cpp 完整支持 indexer 后,Flash 的完整 1M 上下文预计只需约 6GB RAM。Flash 在激进量化下也已有良好记录:同一讨论串中,多名用户称它即使在 2-bit 下仍能保持连贯性;Hy3 尚未有同等验证。
如果你的使用场景始终远低于 200K token,这一节的成本对你没有影响,Hy3 多出来的四个智能指数分数等于白拿。反之,上下文税会不断累积:更多压缩、更频繁的缓存失效,以及每个会话更多的内存占用。
上线后的开发者实测反馈
我看到的最有价值信号,并不在任何基准表中,而是开发者把两款模型放进编码 Agent 后描述出的性格差异。
同一 Hacker News 讨论串中,一位用户取消 Anthropic 订阅后改以 DeepSeek V4 Flash 和 Pro 作为日常主力,之后又试用了 Hy3。他对 Flash 的评价是:速度很快,但“经常建立完全错误的心智模型,然后一路朝错误方向冲”,需要经常纠正并压缩历史。在他的体验中,Hy3“没那么快,但目前看来更能稳定地沿着正确方向推进”,而且随着上下文增长,劣化程度也更低。同一讨论串的其他用户则认为,以这一参数规模而言,Hy3 的世界知识与文字质量优于 Flash。
不过,Reddit 对纯编码输出的倾向恰好相反。r/LLMDevs 的同任务对比给出的排序是“DeepSeek V4 Flash > Hy3 > GLM”,同时也认为 Hy3“在实用编码工作流上很有潜力”。在 r/opencode,反复出现的看法是:Flash 对日常 Agent 工作已经“绰绰有余”。
还要把运营记录纳入考虑。Hy3 上线后的需求超过腾讯服务能力:HN 讨论串中的用户报告了严重限流;一名跟踪 OpenRouter 公开使用排名的用户指出,该模型一个月内从榜首降至第 8 至第 9 位,并将下滑直接归因于这些限制。相比之下,DeepSeek 在官方 API 文档中明确了 Flash 的 2,500 请求并发上限,是 V4 Pro 获准并发数的五倍。对于生产流量,一家供应商公布了容量保证,另一家则有拥堵历史。
不同场景怎么选
- 上下文低于约 150K token 的 Agent 编码:选 Hy3。推理质量更高、更不容易偏离任务,输入标价也与 Flash 相同。之所以采用 150K 而不是完整的 256K,是因为 Agent 上下文增长很快,压缩开始前应预留余量。
- 长会话、大型仓库、大文档 RAG:Flash 通常更合适。1M 窗口配合 50 倍缓存折扣,是完全不同的成本级别;Hy3 的压缩开销会逐渐吃掉其智能优势。
- 高流量生产 API:选 Flash。明确的 2,500 并发、稳定的服务记录,以及可用于低成本批量调用的非思考模式,都是优势。
- 写作、研究与世界知识任务:选 Hy3。社区反馈和 AA 知识评测都显示,在这一规模上它更占优。
- 本地部署:大多数硬件条件下选 Flash。它的 KV 缓存效率和量化韧性有更多实战证据;腾讯在发布讨论串中引用的 Hy3 服务建议是八张 H20 级 GPU。
- 先评估再决定:Hy3 的 OpenRouter 免费档可以零成本试用。请用自己的任务跑一遍,再决定是否相信任何人的基准表,包括本文。
去哪里使用这两款模型
DeepSeek V4 Flash:官方 API同时提供 OpenAI 格式端点(api.deepseek.com)与 Anthropic 格式端点(api.deepseek.com/anthropic),因此只要修改 base URL,就能接入兼容 Claude 的工具链。还需留意同一价格页上的迁移截止日期:旧模型名 deepseek-chat 和 deepseek-reasoner 将于 2026 年 7 月 24 日弃用,分别映射为 Flash 的非思考和思考模式。OpenRouter 上的价格为 $0.09/$0.18,略低于官方费率,但不提供官方 API 的缓存命中价格。
Hy3:Tencent Cloud TokenHub 是官方渠道。OpenRouter 提供正式版、更便宜的预览检查点和免费档。SiliconFlow 曾推出上线促销。若有足够 GPU,也可依据 Apache 2.0 协议自行部署。Hy3 API setup guide 介绍了如何获取密钥并完成首次调用。
常见问题
Hy3 可以免费使用吗?
部分可以。OpenRouter 提供限流的 tencent/hy3:free 免费档;腾讯面向消费者的产品 Yuanbao 和 ima 也免费使用 Hy3。但通过 TokenHub 或 OpenRouter 付费档获得的生产 API 访问,仍按 token 计费。
Hy3 就是 Tencent Hunyuan 吗?
是。Hy3 是腾讯 Hunyuan 模型产品线的第三代,腾讯如今将其品牌定为“Tencent Hy”。预览版于 2026 年 4 月 23 日上线,正式版于 2026 年 7 月 6 日发布。
Hy3 和 DeepSeek V4 Flash,哪个更适合编程?
社区结果会随任务形态而变化。同任务 Reddit 对比中,Flash 的原始输出排名高于 Hy3;但长会话 Agent 用户则反馈 Hy3 更能稳定维持正确方向。短小、范围明确的任务更适合 Flash 的速度;如果是多小时 Agent 会话,且跑偏代价很高,则 Hy3 更合适,前提是上下文始终宽裕地控制在其 256K 窗口内。
DeepSeek V4 Flash 能本地运行吗?
可以,而且比 Hy3 更实际。其权重采用 MIT 协议,架构的 KV 缓存异常轻量,用户也报告称,在配备约 96GB RAM 的机器上,即使使用 2-bit 量化仍能获得可用质量。
为什么 hy3 vs deepseek v4 flash 的价格对比这么复杂?
因为至少存在四份价格表:Tencent TokenHub、OpenRouter 上的 Hy3 正式版与预览版报价,以及拥有单独缓存命中价格的 DeepSeek 官方 API。应按自己的流量模式比较有效价格:缓存输入主导 Agent 工作负载,而 DeepSeek 的 $0.0028 费率在这一点上很难击败。
最终结论
从现有第三方证据看,Hy3 是更强的模型;DeepSeek V4 Flash 则是更强的服务。对于生产 API 工作负载,我默认推荐 Flash:它的缓存成本、上下文窗口和已公布的并发能力会产生叠加优势,四分的基准领先不足以抵消。只有当单次提示的推理质量比规模化能力更重要时,才优先考虑 Hy3;而且先试试它的免费档,因为用自己的任务验证不需要成本。