 AIREITER
如果你的日常工作是写代码、运行、修改,再继续迭代,GPT-5.6 Terra会是更快也更省钱的选择:实际完成时间大约只有一半,生成 token 少得多,在终端 Agent 任务上也略胜Claude Sonnet 5。不过,面对真实项目中的 Bug 修复,两者基本打平;综合推理能力上 Sonnet 5 微幅领先。更现实的一点是,Sonnet 5 目前已经全面可用,而 Terra 仍在通过预览权限逐步开放。下面会结合一次实测、公开基准、速度和价格差异,按任务类型告诉你该选谁。
| 任务类型 | 更推荐 |
|---|---|
| 交互式写码、运行与修改 | Terra |
| 终端 / CLI Agent | Terra |
| 真实仓库 Bug 修复 | 基本打平 |
| 计算机操作 / 桌面 Agent | Sonnet 5 |
| 最高难度的多步推理 | Sonnet 5 |
| 单任务实际成本最低 | Terra |
实测 GPT-5.6 Terra:一条值得参考的数据
我在 2026 年 7 月通过聊天端点,以 temperature 0 给 GPT-5.6 Terra 出了一道规模不大、但暗坑不少的题:实现 LeetCode #8 的字符串转整数函数 my_atoi。它需要正确处理前导空格、可选正负号、遇到首个非数字字符时停止,以及 32 位整数溢出截断。随后,我用 20 个覆盖边界条件的测试用例验证结果,包括空字符串、"words and 987"、低于 INT_MIN 的 "-91283472332"、"+-12",以及正负上下界的截断情况。
Terra 在客户端观测的 5.5 秒内通过了20 个中的 20 个测试,只生成了193 个 output tokens。它的溢出保护写法也比较干净:在乘以 10 之前,先检查 value > (2**31 - ... - digit) // 10,避免内部先发生溢出、再回头截断:
while i < n and "0" <= s[i] <= "9":
    digit = ord(s[i]) - ord("0")
    if value > (2**31 - (1 if sign == 1 else 0) - digit) // 10:
        return 2**31 - 1 if sign == 1 else -2**31
    value = value * 10 + digit
    i += 1
这里必须把局限说清楚:这只是一次单项小测试,不是完整基准,而且只测了 Terra。我没有可供测试的真实 Claude Sonnet 5 API 端点,因此下文所有 Sonnet 5 数据都来自明确标注的公开来源,并非我自己的实跑结果。这次 Terra 测试更适合看作其 token 效率的一条具体样本,而不是对模型能力的最终裁决。
不同任务,各有胜场
把公开基准拆开看,答案并不是谁全面碾压谁,而是任务类型决定优劣。
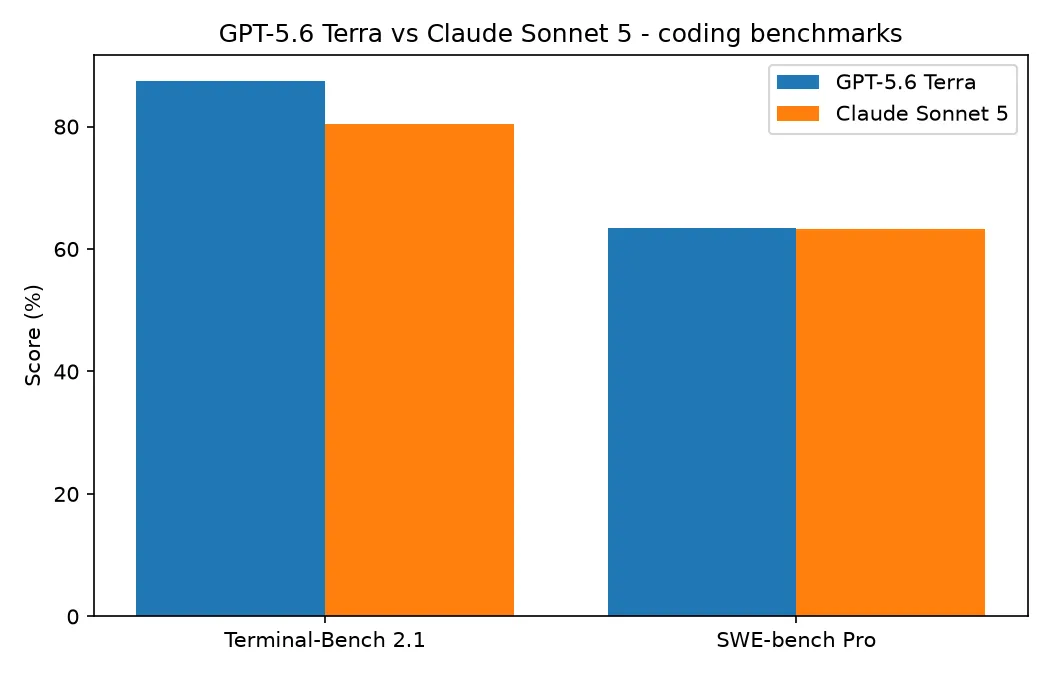
在衡量终端驱动式 Agent 编程能力的 Terminal-Bench 2.1 上,Terra 得分为 87.4%,Sonnet 5 为 80.4%。如果你的工作高度依赖 CLI Agent 和 Shell 自动化,这个差距确实有意义。至于在真实代码仓库中修补 Bug 的 SWE-bench Pro,两者则几乎没有差别:63.4% 对 63.2%。对于日常最常见的多文件、脏乱复杂的修复任务,谁都谈不上明显占优。
再看综合推理,Sonnet 5 略微领先。根据 Artificial Analysis截至 2026 年 7 月的数据,Sonnet 5 的 Intelligence Index 为 53,Terra 为 52;其中 Terra 使用 xhigh effort,Sonnet 5 使用 max effort。Sonnet 5 在计算机操作 Agent 基准 OSWorld-Verified 上也拿到了 81.2%,而 Terra 在这一方向的公开数据相对有限。简单总结:终端 Agent 选 Terra,仓库 Bug 修复可以抛硬币,最难推理和桌面 Agent 工作则更偏向 Sonnet 5。
速度和延迟:实际体验差距很明显
基准分数通常不会告诉你一个最直观的问题:加载动画到底要看多久。Artificial Analysis 的测试显示,Terra 的生成速度为每秒 118 个 output tokens,Sonnet 5 为每秒 71 个;首 token 延迟则是Terra 16.3 秒,Sonnet 5 198.7 秒。后一个数字属于极端情况,并非 Sonnet 5 的默认表现:它对应 Sonnet 5 的 max 推理强度,模型会在输出前先进行较长的思考。降低推理强度后,TTFT 会明显缩短,但整体排序不变:Terra 仍然更早开始输出,也更早结束。
Merge 做过一次实战搭建测试,结论也一样:生成一个营销首页时,Terra 用时 60.2 秒,Sonnet 5 用时 136.6 秒;Terra 生成了 10,677 个 output tokens,Sonnet 5 则为 17,870 个。我自己的 atoi 测试也能印证这一点:Terra 只用 193 个 token,就给出了能正确处理全部边界截断的实现。有限的公开数据和实测都指向同一个结论:Terra 输出更精炼,首字更快;Sonnet 5 则会使用更多 token 和时间,其中部分投入在你未必需要的推理过程中。
如果你正处于高频的“修改—运行—再修改”循环中,这种延迟会迅速累积。如果只是提交一个困难的 Agent 任务后离开等结果,影响就小得多。
价格:标价接近,单任务成本更值得看
两家的标准 API 定价差距不大,通常不足以单独决定选择。
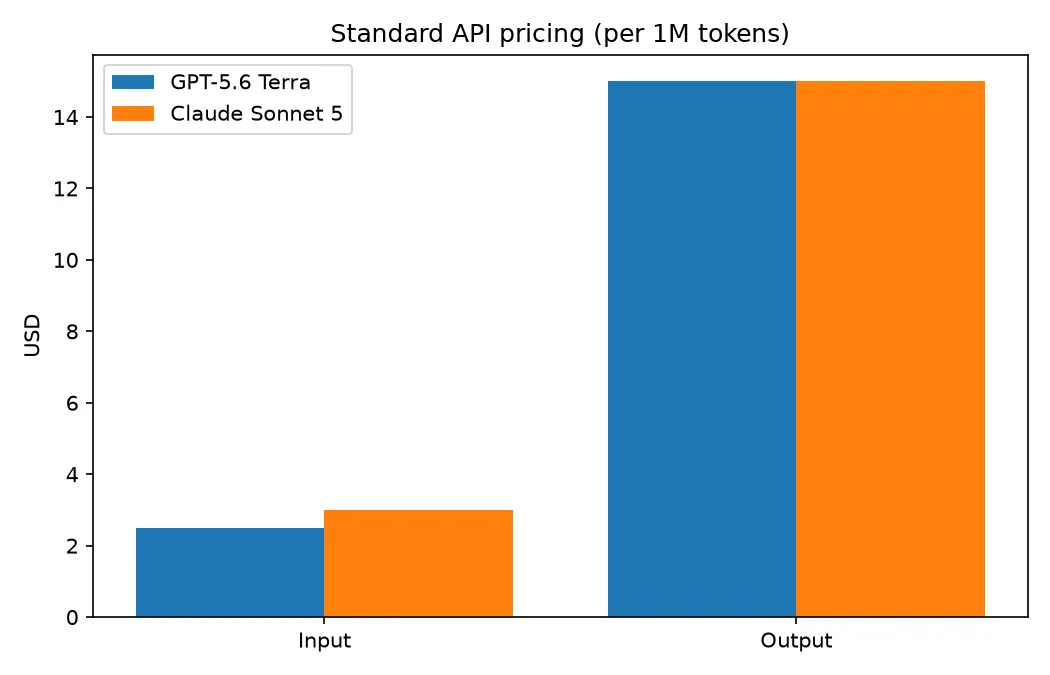
Terra 的标价是每百万 input tokens 2.50 美元、每百万 output tokens 15 美元。Sonnet 5 的标准价格为input 3 美元 / output 15 美元,但 Anthropic 正在提供限时2 美元 / 10 美元的优惠价,持续到2026 年 8 月 31 日。因此在此之前,Sonnet 5 的表面价格更低。两者都提供 100 万 token 上下文窗口和 128K 最大输出。对于相近的日常使用质量,Terra 的价格大约是上一代 GPT-5.5 档位的一半,因此它的性价比优势不只是相对 Sonnet 5 而言。
讨论这两个模型的成本时,常见的三个数字其实衡量的不是同一件事:
- 每 token 标价:Terra 的 input 更便宜,output 价格相同;Sonnet 5 的优惠价则暂时低于两者。
- 混合指数价格:Artificial Analysis 给出的数值是 Terra 2.17 美元、Sonnet 5 1.54 美元,但这是按测试时的推理强度、以 3:1 的 input-output 比例计算的混合值,并不等于你的单任务实际账单。
- 完成单个任务的实际成本:由于 Terra 为同样结果生成的 token 更少,它通常在这一项胜出。Merge 的搭建测试中,Terra 成本为 0.120 美元,Sonnet 5 为 0.179 美元;即使 Sonnet 5 的 output 有折扣,Terra 仍便宜约三分之一。
对大多数实际工作负载而言,真正反映账单的还是单任务成本,而这一项更有利于 Terra。两者都可通过兼容 Anthropic 和 OpenAI 的 API 访问,也包括一些以折扣价格转售访问权限的第三方网关;若标价是硬约束,这些渠道也值得考虑。
开发者实际在用什么
基准成绩和社区选择未必总是一致,因此开发者的讨论也值得一看。2026 年 7 月,X 上的风向整体更偏向 GPT-5.6 系列,主要原因是成本。一位开发者提到,他们重做了整套 Agent 集成链路,将 Opus 4.8 换成 Terra、Sonnet 5 换成 Luna,并评价新模型“速度极快、能力很强而且更便宜”。另一位开发者表示自己“基本不再使用 Claude”,主要的 Agent 编程组合变成了搭配 Grok 的 Cursor,以及搭配 Terra/Sol 的 Codex。
Terra 也被一些人视为 Claude 卡住时的破局模型。一位开发者称,Terra 修复了“Claude Sonnet 5 没能搞定”的 Bug,还通过一条提示词生成了完整的网站 UI。当然也有更克制的评价:一位开发者指出,Terra“在找 Bug 上不如 Sol 那么激进,但任务能完成”。这很符合 Terra 的定位:稳定、省钱的主力工具,而不是不惜代价追猎漏洞的模型。
但这并不会削弱 Sonnet 5 的吸引力。它目前已覆盖所有套餐层级,能够接入 Claude 成熟的工具链和自适应思考工作流,而且在大规模 Agent 任务中也能稳定处理长上下文。对于已经统一使用 Claude 的团队来说,这种延续性往往比每个任务节省几美分更有价值。
到底该选哪个
关键不在于谁是绝对“更强”的模型,而在于你的工作负载长什么样。就我最常做的编程工作而言——快速迭代、终端 Agent,以及关注单任务成本——我会默认选 Terra,同时把 Sonnet 5 留给那些推理负担特别重的任务。
- 选择 GPT-5.6 Terra:如果你高频进行交互式编程,在意修改—运行循环中的延迟,依赖终端或 CLI Agent,或者希望压低单任务实际成本。它最突出的优势就是速度和 token 效率。
- 选择 Claude Sonnet 5:如果你的任务更依赖最高难度的多步推理、长上下文 Agent 运行或计算机操作能力;或者你已经深度使用 Claude 生态,希望今天就在所有套餐中获得可用模型。其持续到 8 月 31 日的 2 美元 / 10 美元优惠价,也很适合先试用。
对大多数每天持续交付功能的开发者来说,Terra 的速度和成本组合更有优势。若任务确实需要高强度推理,或者切换技术栈带来的折腾不值得,Sonnet 5 依然是更稳妥的选择。两者足够接近,最终的决胜因素应当是你的工作流,而不是排行榜。
常见问题
GPT-5.6 Terra 比 Claude Sonnet 5 更好吗?
如果看速度和高成本效率的编程能力,是的:Terra 更快、单任务成本更低,也在终端 Agent 基准中领先。但在最高难度推理和计算机操作任务上,Sonnet 5 至少不落下风,且往往更强。不存在适用于所有场景的单一赢家,关键取决于任务类型。
Claude Sonnet 5 适合编程吗?
适合。在真实仓库 Bug 修复的 SWE-bench Pro 上,它与 Terra 基本持平,分数分别为 63.2% 和 63.4%;在 OSWorld-Verified Agent 任务中则领先。相比 Terra,它的短板是速度和首 token 延迟,而不是代码质量。
Terra 比 Sonnet 5 便宜多少?
按标价计算,Terra 为 2.50 美元 / 15 美元,Sonnet 5 的标准价格为 3 美元 / 15 美元;不过 Sonnet 5 截至 2026 年 8 月 31 日的 2 美元 / 10 美元优惠价会暂时更低。若看单任务实际成本,Terra 通常仍然更有优势,因为它生成的 output tokens 更少。
Terra 和 Sonnet 5 的上下文窗口一样吗?
实际可以视为一样:两者均提供 100 万 token 上下文窗口和 128K 最大输出,因此上下文长度不会成为你的决定因素。
GPT-5.6 Terra 现在已经到处都能用了吗?
还没有完全普及。Sonnet 5 目前已在所有套餐层级提供,而 GPT-5.6 在部分地区仍仅向预览用户和指定 API 合作伙伴开放。如果你现在就需要上线到生产环境,这会是一个实际需要考虑的问题。