 AIREITER
r/codex 上最近反复出现一个问题:"以前我用 GPT-5.5 extra-high,现在该选 Sol 还是 Terra?" 先说结论:GPT-5.6 Sol 的 API 标价与 GPT-5.5 完全一致,而且在智能体基准测试中表现更强。对于长时间运行的 Agent 和网页浏览任务,升级几乎不需要额外付费。
不过,“标价一样”不等于最终账单一样。Sol 新增了 GPT-5.5 没有的缓存写入收费,而且它会思考得更久;即使价目表纹丝不动,单个任务的成本也可能成倍增加。
标价没变,账单为什么变了
GPT-5.6 Sol 和 GPT-5.5 的标准 API 定价完全相同:每百万输入 token $5.00、每百万输出 token $30.00,缓存输入则为 $0.50。我在 2026 年 7 月 29 日从 OpenAI 定价页提取了两行数据:
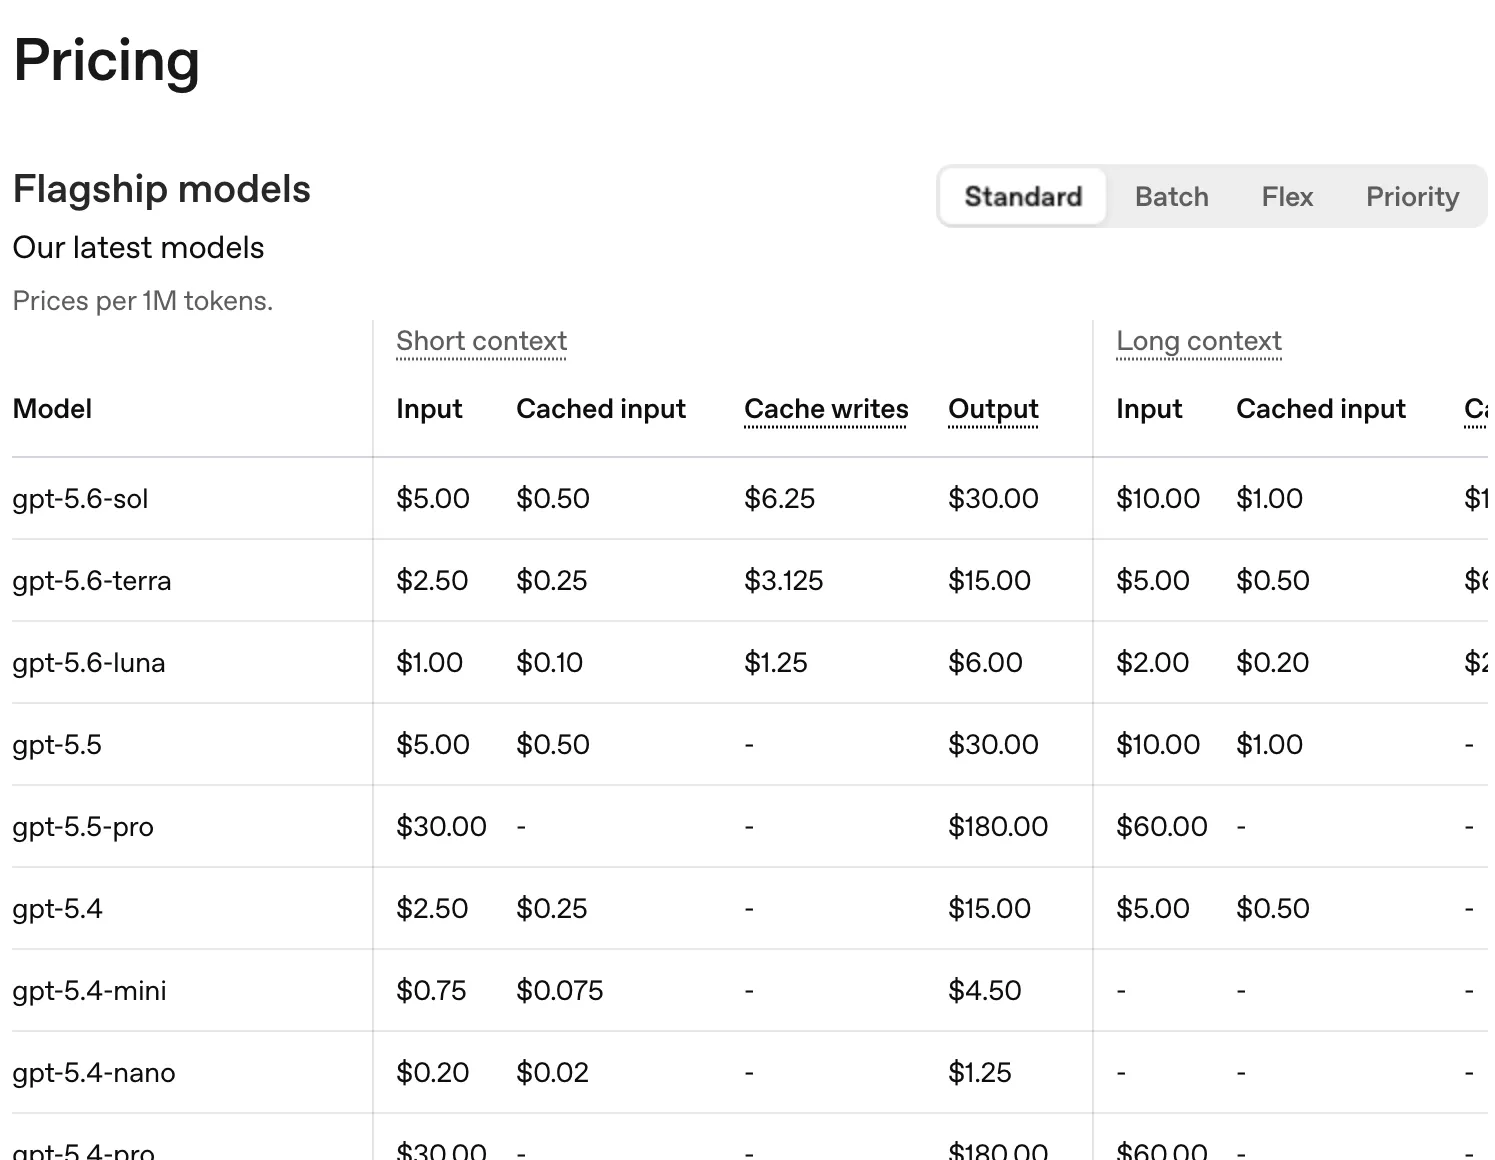
真正拉开差异的是表中的三项:
| 计费项 | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| 输入 / 输出(每 1M tokens) | $5.00 / $30.00 | $5.00 / $30.00 |
| 缓存输入 | $0.50 | $0.50 |
| 缓存写入 | $6.25 | 不收费 |
| 长上下文(>272K)输入 / 输出 | $10.00 / $45.00 | $10.00 / $45.00 |
迁移时最容易踩坑的,就是缓存写入这一项。GPT-5.6 引入了显式缓存断点,最短缓存生命周期为 30 分钟(具体机制可参考 Vellum 的解析)。写入价格是非缓存输入的 1.25 倍,读取则仍享受 90% 折扣。按上表计算:缓存片段写入一次要 $6.25,每次读取再加 $0.50;相比每次非缓存重传 $5.00,从第二次复用开始缓存就能回本。但如果你的流水线写得比读得多,就会多出 GPT-5.5 从未收取过的一笔费用。
第二项成本与思考时间有关。Sol 在回答前会推理更久,而推理 token 按输出 token 计费。迁移到 Codex 的用户已经直接感受到了这一点:
“5.6 sol médium 的成本是 5.5-xhigh 的三倍,但代码质量相同(至少与 5.5 刚发布时相比是这样)。”—— r/codex,“GPT 5.5 and 5.6 conversion table”
也就是说,费率表没变,单任务成本却涨到三倍,原因是模型为了得出结果用了三倍 token。另一方面,OpenAI 的 GPT-5.6 发布公告称,在其内部对比中,GPT-5.6 比 GPT-5.5 少用 22% 输入 token 和 23% 输出 token。这两种说法并不矛盾:单次推理本身的效率提高了,但更高的推理强度会让模型思考得多得多。你的实际体验,取决于所选的推理强度。
从数据看,GPT-5.6 Sol 到底强在哪
单看原始智能水平,GPT-5.6 Sol 与 GPT-5.5 在独立测评中几乎打平:Artificial Analysis 的 Intelligence Index v4.1 给 Sol(medium)打出 54 分,GPT-5.5(high)为 53 分;两者的综合成本也同为每百万 token $4.35。真正明显的提升在其他维度:
- 首 token 延迟:Sol 为 4.13 秒,GPT-5.5(high)为 16.67 秒,相差 4 倍。对于交互式工具,以及需要连续发起几十次调用的 Agent 循环,这会是日常使用中最直观的升级。
- Agent 基准表现:Sol 在 Terminal-Bench 2.1 上取得 88.8%,BrowseComp 上达到 92.2%。这一代最大的进步集中在长程工具调用任务上。
- 上下文能力:Sol 的上下文窗口为 1M tokens,GPT-5.5 为 922K;同时,推理状态可以跨对话轮次延续,相关说明见上文链接的 Vellum 分析。
- 输出速度:这是唯一的退步。Sol 的流式输出速度为 65 tokens/秒,低于 GPT-5.5 的 77.3 tokens/秒。批量生成任务会更慢,而不是更快。
CodeRabbit 的长程编码测试套件覆盖五种语言、100 多个任务,Sol 的通过率为 63.7%。在代码审查基准中,Sol 相比基线集成多发现了 7.4 个百分点的问题。不过有一个前提:Sol 的审查精度只有 31.6%,即它能找回更多真实问题,但也会带来更多噪声。同一批测试者还记录到,Sol 一旦在简单修改上走错方向,可能连续消耗 8 轮才停下来。更擅长马拉松任务,不代表不会钻牛角尖。
用三个相同提示词实测两者
基准测试更偏向长程任务,但多数 API 调用其实很短。因此,我在 2026 年 7 月 29 日向 gpt-5.6-sol 和 gpt-5.5 分别发送了同样的三个提示词:一个 Python 日期处理 Bug 修复任务、一个恰好存在两个正确答案的约束逻辑谜题,以及一个严格的 JSON 信息提取任务,其中藏着一个陷阱——缺少年份的日期必须按规则返回 null,不能自行猜测。每项任务只调用一次 API,使用默认推理强度,不使用工具,也不重试。这只是小样本测试,不是基准测试。
两个模型都答对了三题。GPT-5.5 用 calendar.monthrange 修复了 12 月崩溃的 Bug;Sol 则手写了正确的闰年判断表。两者都准确找出了两种有效的部署顺序,在提取任务中返回了逐字节一致的 JSON,并且都拒绝为“the 14th of July”凭空补上年份。
token 消耗和速度则各有胜负:
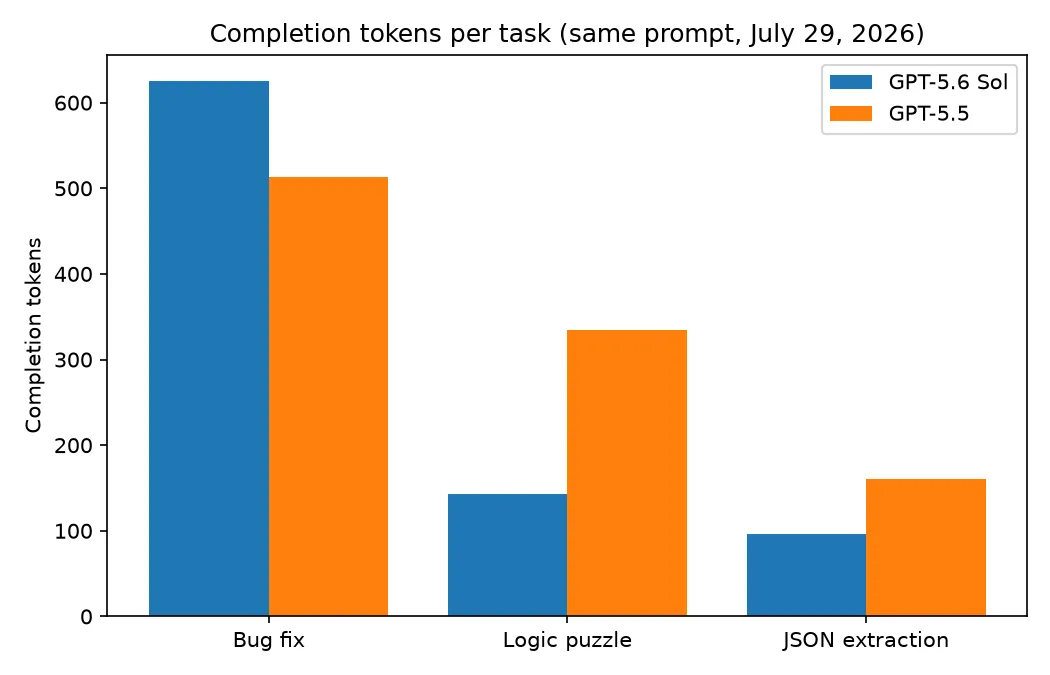
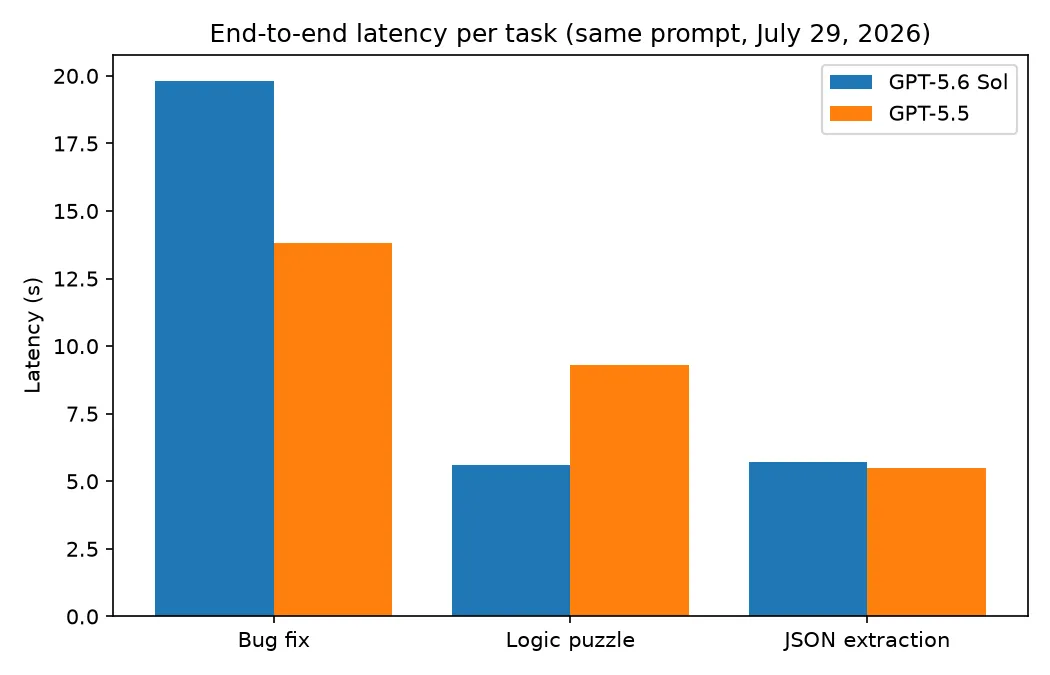
Sol 的总完成 token 更少,为 864,对比 GPT-5.5 的 1,007;但在代码任务上,它既更慢也更“健谈”:耗时 19.8 秒、使用 625 个 token,而 GPT-5.5 为 13.8 秒和 513 个 token。逻辑题则正好相反,Sol 用 143 个 token 在 5.6 秒内完成,GPT-5.5 则用了 334 个 token 和 9.3 秒。观察两者之后,我的判断是:对于短小且定义明确的任务,两者可以互换;仅凭这次测试,没有任何理由足以推动迁移。升级的价值完全建立在上文基准测试所体现的 Agent 和长上下文能力上。
从 GPT-5.5 推理强度迁移到 5.6,怎么选
根据上文 Vellum 的分析,直接使用 gpt-5.6 这个模型 ID,默认会路由到 gpt-5.6-sol。这意味着,只是替换别名就升级的用户,会在没有主动选择的情况下直接进入旗舰档位,也承担旗舰级账单。若要有意识地迁移,以下三点可作为映射依据:
- GPT-5.5 xhigh → Sol medium:这是社区目前的实用对应关系。上文引用的 r/codex 报告认为,两者代码质量大致持平,但在发布初期 Sol 的单任务成本约为 3 倍。应把它当作需要用自身提示词验证的起点,而非保证。如果你的工作负载原本运行在 5.5 high 且对预算敏感,那么定价为 $2.50/$15 的 GPT-5.6 Terra可能更接近需求,其费率是 Sol 的一半。
- 最高档推理时间会明显膨胀。ChatGPT Pro 用户反馈称,原本 5.5 Pro 只需 5–10 分钟的任务,GPT-5.6 会思考 20–50 分钟。这是 ChatGPT 端的观察,但同一套推理栈在 API 中会按输出 token 收费。三个 5.6 档位都支持
reasoning.mode: "pro",因此这个上限由你主动开启。 - 旧提示词可能拖累新模型。Every.to 测试团队发现,只有删掉为旧模型准备的防御性指令后,Sol 的输出才显著改善。比如“始终再次检查 X”这类规则,会让 Sol 过度验证、过度构建。迁移模型之后,也该重新审查系统提示词;GPT-5.5 曾经需要的谨慎脚手架,如今可能成了额外税负。
哪些场景该换,哪些场景先别换
如果你的工作负载是 Agent 类任务——多步骤工具调用、浏览研究,或仓库规模的编程会话——应当切换到 GPT-5.6 Sol。88.8% 的 Terminal-Bench 成绩和 92.2% 的 BrowseComp 成绩正体现于此;首 token 延迟降低 4 倍,也会在每一轮循环中持续累积优势。在同样的 $5/$30 费率表下,能力提升本身无需额外付费,前提是额外推理 token 和缓存写入费用没有吞掉这部分差额。1M 上下文和跨轮次持续推理,也省去了 5.5 流水线过去必须自行搭建的两套补丁方案。
如果你的流量主要是短小、定义明确的调用——信息提取、分类、一次性代码修复、高量生成——暂时留在 GPT-5.5 更合适。我的三个提示词测试中,两者在这类任务上打成平手;而 Sol 较慢的流式输出速度(65 对 77.3 tokens/秒)会让批量任务明确变差。缓存写入密集型流水线在迁移前也应先算清 $6.25 这一项。至于如果你想要的是相近质量下更低的账单,答案是 Terra,不是 Sol。
我的正面对比测试通过 AIReiter 完成。它通过同一个 API key 提供 gpt-5.6-sol 和 gpt-5.5,因此只需替换模型字符串,就能完成完整的 A/B 测试——用自己的真实流量对比每个任务的成功率、端到端延迟和完成 token 数。
常见问题
GPT-5.6 Sol 比 GPT-5.5 更好吗?
在 Agent 任务上,答案很明确:Terminal-Bench 2.1 为 88.8%,BrowseComp 为 92.2%,首 token 延迟也低了 4 倍。对于短小的一次性任务,独立评分只相差 1 分(Artificial Analysis 为 54 对 53),我的同提示词测试也没有发现正确率差距。
GPT-5.6 Sol 比 GPT-5.5 更贵吗?
标价完全相同:每百万 token 输入 $5、输出 $30。不过 Sol 新增了 GPT-5.5 从未收取的 $6.25 缓存写入费;在更高推理强度下,它每项任务还会消耗更多推理 token。r/codex 用户测得,在与 5.5 xhigh 质量相当时,单任务成本约为 3 倍。
GPT-5.5 xhigh 在 GPT-5.6 中对应什么?
Sol 的 medium 推理强度可提供接近的代码质量,但单任务成本约为三倍。如果成本持平比能力上限更重要,Terra 是经济性上更接近的选择。
升级后还能继续使用 GPT-5.5 吗?
可以。GPT-5.5 仍以未变的费率列在 OpenAI 定价页上(于 2026 年 7 月 29 日核实,见上方截图),目前没有任何因素强制你迁移。
一张表做决定
| 你的工作负载 | 建议选择 | 决定性因素 |
|---|---|---|
| 多步骤 Agent、网页浏览、仓库规模编程 | GPT-5.6 Sol | Terminal-Bench 88.8%、首 token 延迟低 4 倍、费率表相同 |
| 短文本提取 / 分类 / 一次性修复 | GPT-5.5(暂时) | 同提示词测试表现持平;5.5 流式输出快 19% |
| 大量写入提示词缓存 | GPT-5.5,或先重构架构 | Sol 新增 $6.25/1M 缓存写入费 |
| 相同质量,更低账单 | GPT-5.6 Terra | $2.50/$15,仅为 Sol 价格的一半;参见上方 Terra 与 5.5 的对比 |
| 最大推理深度 | Sol,搭配 reasoning.mode: "pro" | 5.5 需要 5–10 分钟的任务,可思考 20–50 分钟 |