 AIREITER
同样的单价,GPT-5.6 Sol 跑一次任务消耗的 Token 却可能翻倍以上。开发者 Vincent Schmalbach 在 1,715 次 Codex 会话中统计到,GPT-5.6 Sol 每次会话平均消耗 1,645 万 Token;而在可比的 1,667 次会话样本中,GPT-5.5 的平均值仅为 730 万 Token,前者达到后者的 2.25 倍。更值得留意的是,Responses API 还存在一项已被记录的缺陷:Sol 的计费 output_tokens 似乎可能被放大 6 倍甚至更多。如果你的 GPT-5.6 账单看起来不太对劲,它很可能确实有问题。
GPT-5.6 Sol 的实际 Token 消耗有多高
开发者 Vincent Schmalbach 跟踪了 Token 消耗情况,将两个各为 14 天的 Codex 使用周期进行对比:GPT-5.5 xhigh 与 GPT-5.6 Sol xhigh 的会话数量几乎相同。
| 指标 | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| 会话数 | 1,667 | 1,715 |
| Token 总数 | 12.17B | 28.22B |
| 每次会话 Token 数 | 7.30M | 16.45M |
会话数只增加了 2.9%,单次会话 Token 用量却增长了 125%。在工作负载大致相同的前提下,总消耗从 121.7 亿跃升至 282.2 亿,相当于增加了 2.32 倍。
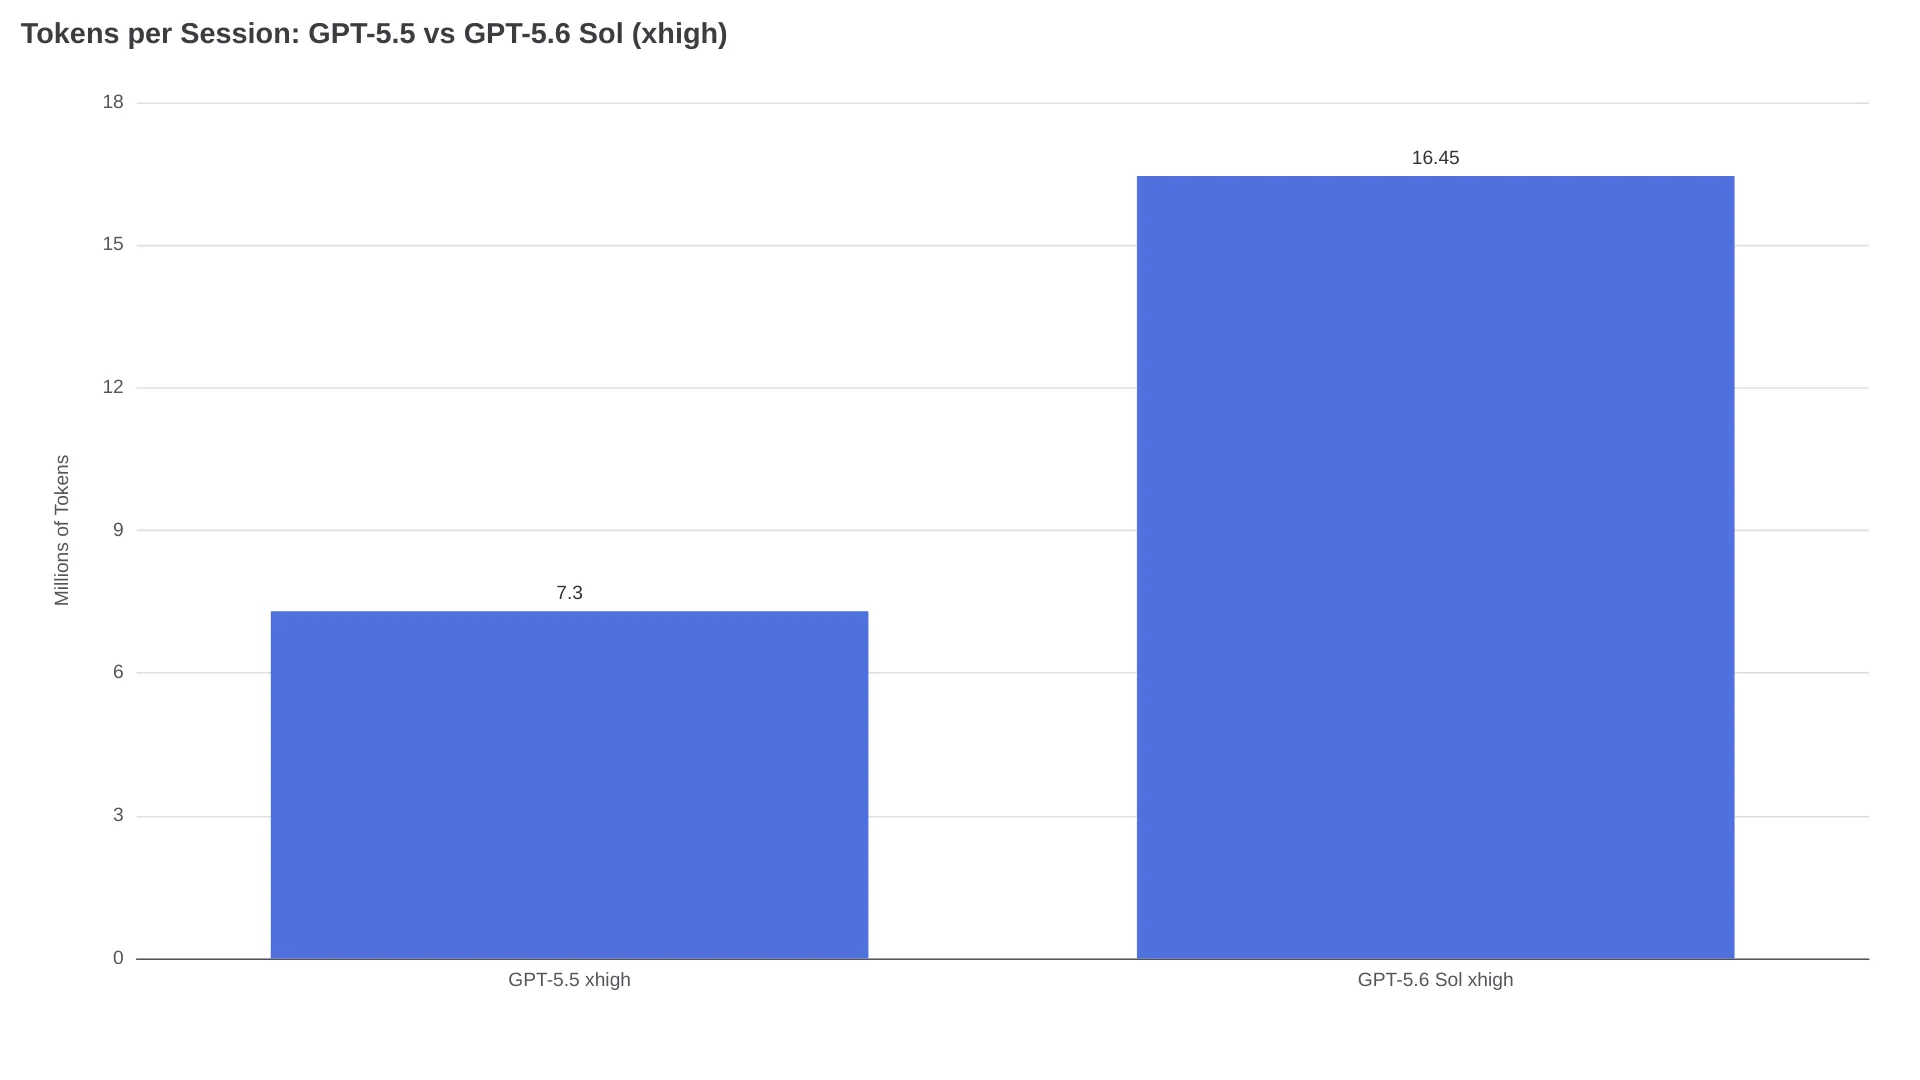
OpenAI 的定价页面显示,GPT-5.6 Sol 的输入价格为 $5/1M,输出价格为 $30/1M,与 GPT-5.5 完全一致。单价不变、Token 用量达到 2.25 倍,意味着单项任务的成本也大约升至 2.25 倍。此外,GPT-5.6 Sol 新增了缓存写入附加费,费率为输入价格的 1.25 倍;GPT-5.5 则没有这项费用。
“GPT 5.6 Sol 简直是 Token 熔炉。即使是 medium 或 high 的 Sol,Token 也消耗得惊人。5.6 只会用于复杂规划或棘手的 Bug。”—— r/codex 用户
Schmalbach 的三份订阅过去足以支撑一周的高强度工作,现在大约一天的中等强度使用就会耗尽。
Sol 为什么更费 Token
从基准成绩与 Token 效率的关系看,Sol 比竞品更高效。在 Artificial Analysis Coding Agent Index 中,它达到同等分数所需的输出 Token 少于 Claude Fable 5。但真实会话里,Sol 的推理策略更激进:会制定计划、回溯、验证,并探索替代方案。代价就是每项任务的 Token 消耗更高,尽管每个 Token 产出的有效工作也更多。
一个会抬高输出 Token 计费数的已报告缺陷
除了实际用量更高,Responses API 中还有一项已有记录的核算缺陷,似乎会抬高 output_tokens 字段,而计费正是基于该字段计算。OpenAI 正在调查,但尚未公开确认根本原因。
一位开发者在 710 次 GPT-5.6 调用、共计 22,922 次推理调用中记录了这一问题。GPT-5.6 是首个会在单次响应中输出多个 reasoning 项目的模型系列:Sol 的中位数 k=9,Terra 为 k=4。API 中的一个累加器会在生成过程中,针对每个推理项目额外累加一次当前的推理总量,再叠加正确的最终统计值。
其公式为:
output_tokens ≈ R × (k + 3) / 2其中 R 代表实际推理 Token 数,k 为推理项目数量。对于中位数 k=9 的 Sol,这会将计费 Token 数大约放大至 6 倍;对于 k=4 的 Terra,则约为 3.6 倍。
真实账单中会出现什么情况
已有记录中最极端的案例是:一次 GPT-5.6 Terra 调用只返回了四个字符的答案 d1d4,却被计入 466,818 个输出 Token;实际推理 Token 仅为 21,064 个。
| API 报告项目 | 数值 |
|---|---|
output_tokens(计费值) | 466,818 |
reasoning_tokens(实际值) | 21,064 |
| 可见输出 | d1d4(4 个字符) |
| 推理项目数(k) | 41 |
当 k=41 时,公式预测 R × (41+3)/2 = 21,064 × 22 = 463,408,与实际计费数的误差在 0.7% 以内。报告者还通过其计费仪表盘进行了验证:汇总 API 的 output_tokens 并按公开费率计算后,得出的费用与仪表盘账单精确到 0.1 美分。其 GPT-5.6 调用的约 $320 计费金额中,约 $284 属于多收费用。
这个 Bug 早于 GPT-5.6 就已存在
当 k=1 时,也就是 GPT-5.6 之前的模型所输出的单个推理项目,公式会化简为 R × 4/2 = 2R,即固定的 2 倍多收。报告者还将其与 OpenAI 自己的使用量导出数据进行了交叉验证,数据时间为 2026 年 5 月:
| 模型 | 计费输出 Token | 真实数量 | 倍率 |
|---|---|---|---|
| o3-mini | 25,408,973 | 12,376,132 | 2.02x |
| gpt-5.4-nano | 11,718,610 | 5,844,140 | 2.00x |
| o1 | 778,989 | 335,944 | 2.01x |
| o4-mini(对照组) | 12,054,680 | 9,160,567 | 1.01x |
GPT-5.6 并非这一缺陷的源头。它只是首个将推理拆分为大量项目的模型,因此把原本不易察觉的 2 倍问题放大成了更高的倍数。原因在于,推理内容以约 512 Token 为一段输出,因此 k ≈ ceil(R/512)。代入公式后可得 output_tokens ≈ R²/1024 + 3R/2,这意味着多收的费用会随推理长度呈二次增长:思考量翻倍,账单大致可能变成四倍。
截至本文撰写时(2026 年 8 月),OpenAI 员工已回应这一 Bug 报告并要求提供更多数据,但尚未公开确认修复方案或账单调整措施。
7 月 30 日降价后的 GPT-5.6 定价
2026 年 7 月 30 日,OpenAI 将 Luna 的价格下调了 80%,Terra 下调了 20%。Sol 的价格则维持不变。以下为 OpenAI 定价页面列出的当前费率:
| 模型 | 输入(短) | 缓存输入 | 缓存写入 | 输出(短) | 输出(长) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
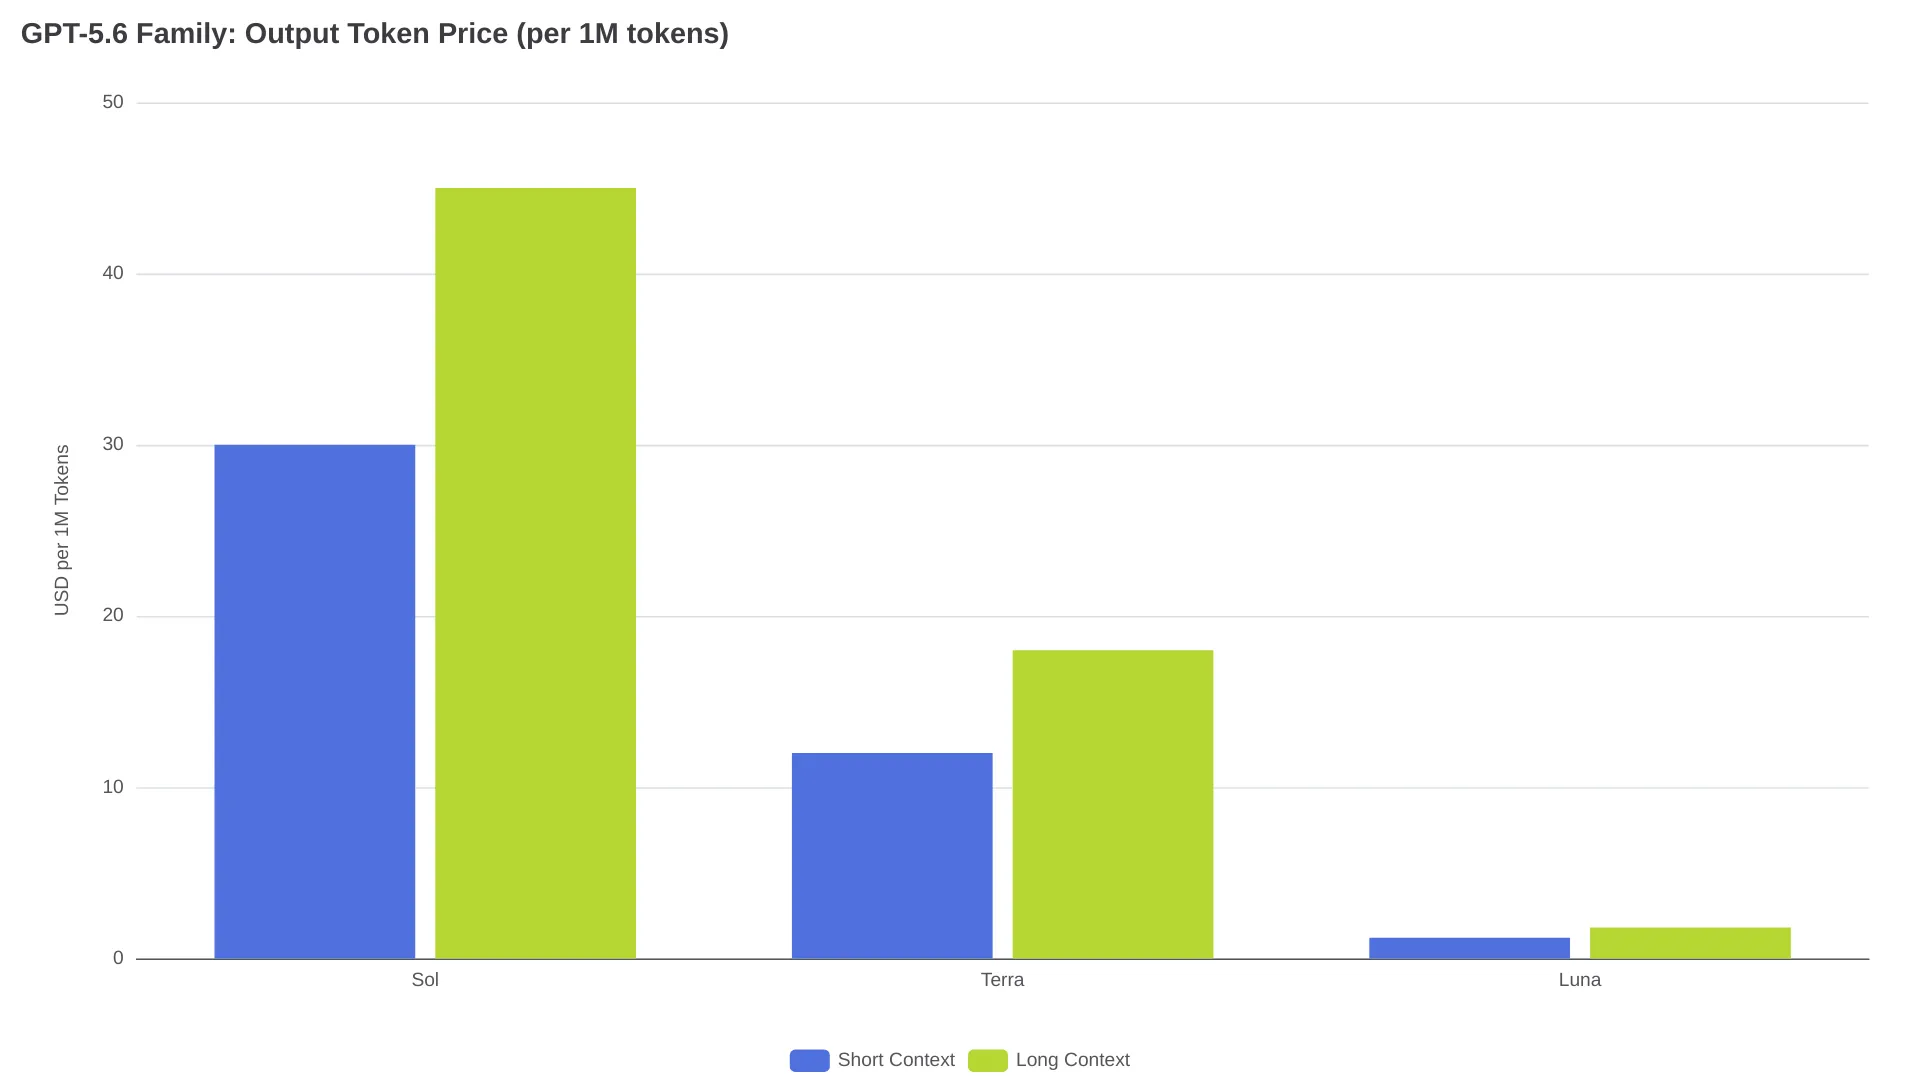
Sol 的单 Token 价格与 GPT-5.5 相同,但单项任务的 Token 消耗高出 2.25 倍,因此实际单任务成本大约会翻倍。
缓存写入成为新增收费项。GPT-5.6 对缓存写入收取输入价格 1.25 倍的费用,Sol 为 $6.25/1M;GPT-5.5 则不收取缓存写入费。如果工作负载的缓存命中率较低,这会在原本的输入成本之上增加 25% 的附加成本。
Luna 的价格现已低于 GPT-5.4 nano。降价后,Luna 的输入/输出价格为 $0.20/$1.20,而nano 的价格为 $0.20/$1.25,Luna 因此成为 OpenAI 产品线中最便宜的模型。
降低 GPT-5.6 Token 账单的三种方法
日常任务改用 Terra
Terra 的输出价格为 $12/1M,比 Sol 的 $30/1M 低 60%。在 Artificial Analysis Coding Agent Index 中,Terra 的得分略高于 Claude Fable 5。经历 7 月的 20% 降价后,Terra 的 $2.00/$12.00 定价也低于旧版 GPT-5.5 的费率。
那么 Sol 什么时候仍然值得用?多步骤调试、大型代码库的架构规划、安全分析等任务,都能从更长的推理链中受益。至于常规编程、分析和内容生成,Terra 往往能以更低的 Token 消耗交付可比的结果。
降低推理强度设置
reasoning.effort 参数决定模型生成多少推理 Token,而已报告的计费缺陷会随推理项目数量 k 直接扩大。在 medium 设置下,Sol 输出的推理项目少于 xhigh,因此计费数的放大程度也会相应降低。
“我使用 Terra Ultra,实际感觉它的 Token 使用效率比 GPT 5.5 高得多。”—— r/codex 用户
这种“Token 熔炉”现象主要集中在高推理强度的 Sol 上。将 reasoning.effort 从 xhigh 或 max 调低至 medium 或 high,是最能直接降低成本的一项调整。
尽量提高缓存命中率
GPT-5.6 引入了显式缓存断点,并将缓存最短保留时间设为 30 分钟。缓存读取可享受 90% 折扣,Sol 的输入成本可从 $5.00/1M 降至 $0.50/1M。但缓存写入的价格是输入费率的 1.25 倍,Sol 为 $6.25/1M。
建议调整 Prompt 结构:将系统消息和固定上下文放在缓存断点之前。具体盈亏平衡点取决于你的工作负载——缓存写入溢价为输入费率的 25%,缓存读取节省 90%,因此需要让读取节省超过写入附加费的命中率。对于多数请求都共享较长系统 Prompt 的工作负载,这一点通常很快就能实现。
常见问题
OpenAI 是否承认了这项计费缺陷?
OpenAI 员工 Mark G. 于 2026 年 7 月 12 日回复了社区论坛中的报告,要求提供请求 ID 和时间戳以便调查。截至 2026 年 8 月,OpenAI 尚未公开确认修复方案或追溯性的账单调整。
如何确认我的账户是否受到计费缺陷影响?
对于包含多个推理项目的任意响应,将 usage.output_tokens_details.reasoning_tokens 与可见完成内容的 Token 数相加。如果 usage.output_tokens 比这个总和高出超过几个百分点,论坛报告中记录的累计重复求和行为就可能正在影响你的账单。你可以从 OpenAI 控制台下载使用量 CSV,并按模型分别核查。
我应该从 Sol 切换到 Terra 吗?
对于大多数 API 工作负载,Terra 成本更低,而且在编程基准测试中表现具有竞争力。Sol 的优势主要体现在最困难的任务上:OpenAI 自身的基准测试显示,在多步骤推理与安全研究这类长时间思考回报最高的场景中,Sol 相比 Terra 的领先更明显。