 AIREITER
GLM-5.3-Flash 的输入价格低至 $0.15,但这只是成本计算的起点。缓存命中率、输出 token、强制推理机制,以及约 320B 参数的模型权重,都会影响你究竟该选 API,还是走开放权重自托管路线。
目前实际生效的价格
Z.AI 官方定价页显示,GLM-5.3-Flash 的新输入价格为每 100 万 token $0.15,缓存输入为每 100 万 token $0.03,输出为每 100 万 token $0.50。页面还列出了一项临时 5 折优惠,截止时间为 2026 年 9 月 9 日 24:00,时区为 UTC+8(新加坡时间)。
| GLM-5.3-Flash 计费项目 | 标准价 / 100 万 token | 优惠价 / 100 万 token |
|---|---|---|
| 新输入 | $0.15 | $0.075 |
| 缓存输入 | $0.03 | $0.015 |
| 输出 | $0.50 | $0.25 |
| 缓存输入存储 | 限时免费 | 限时免费 |
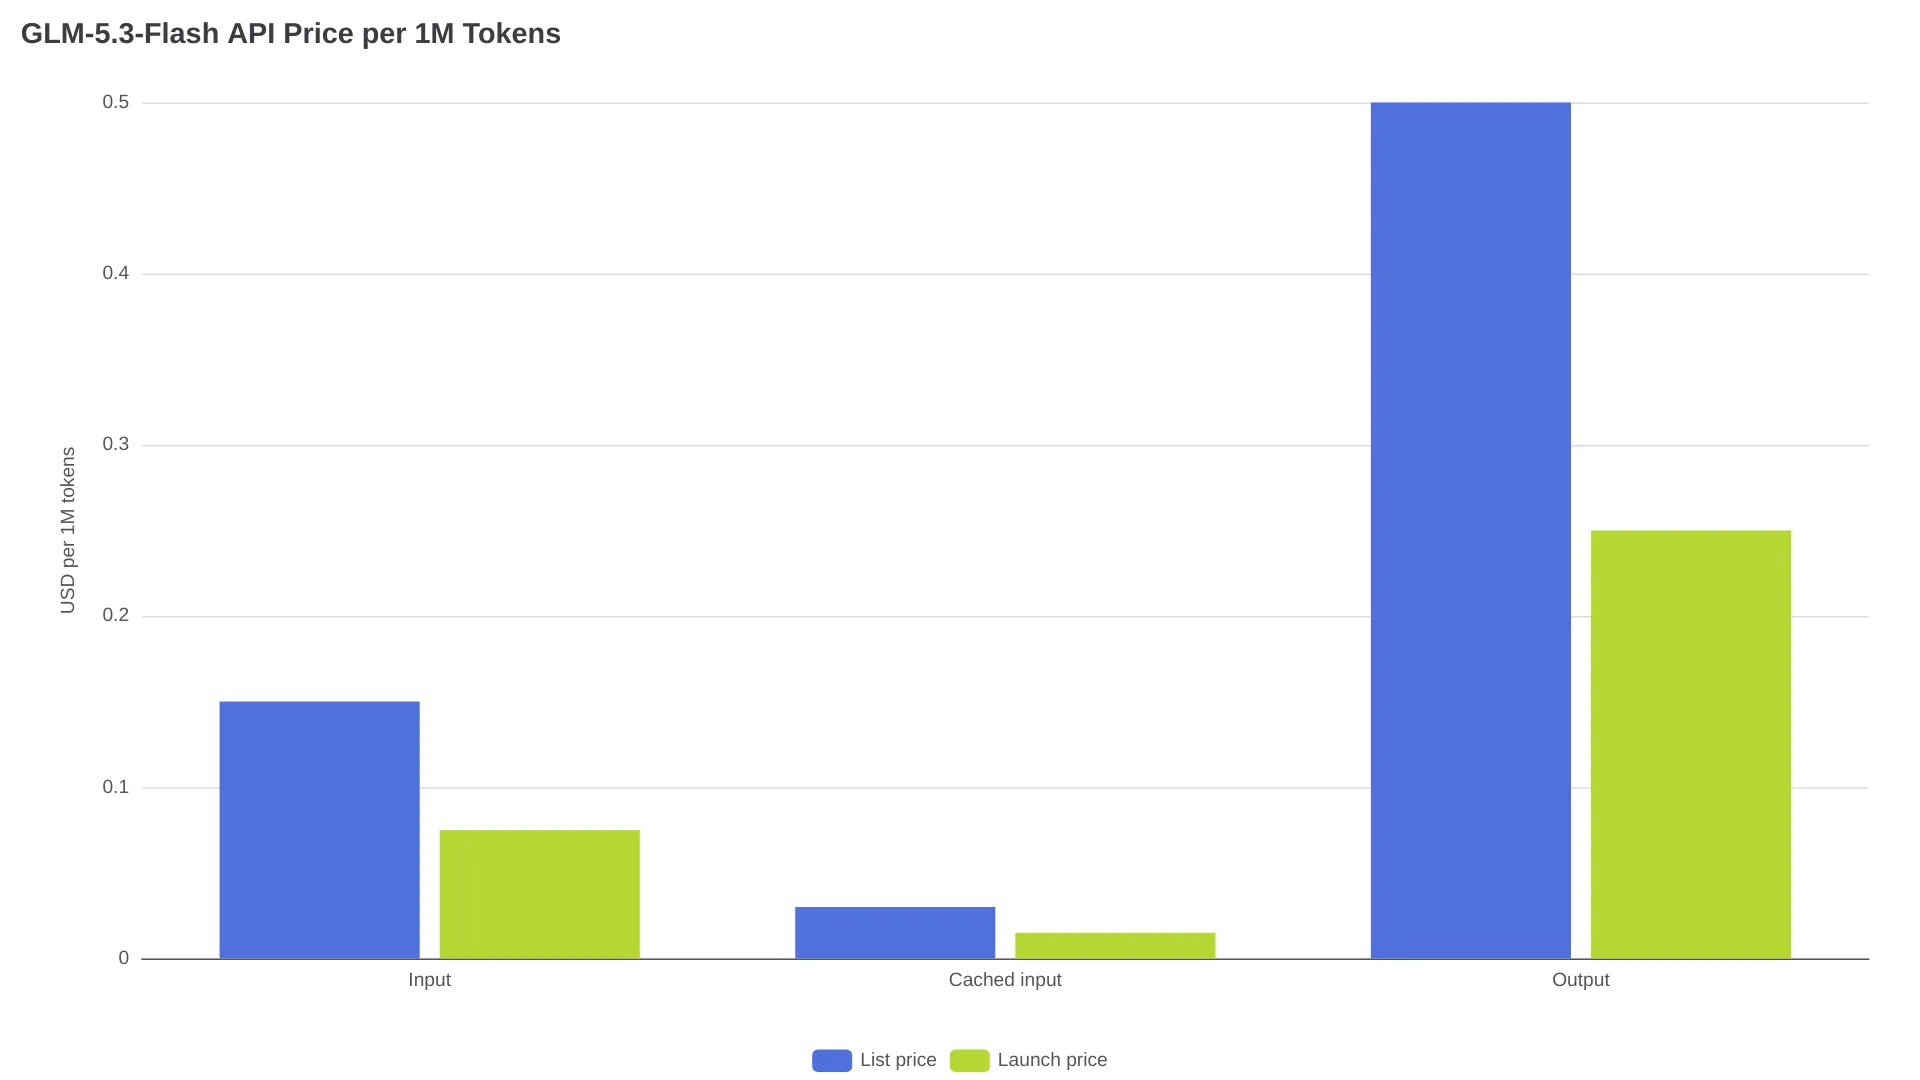
这 5 折应视为短期促销价,而不是生产环境预算的长期基准。Z.AI 的发布公告指出,ox-alpha 是该模型此前的预览名称。
同一份官方价目表中,标准版 GLM-5.3 的新输入、缓存输入和输出价格,分别为每 100 万 token $1.40、$0.26 和 $4.40。按标准价计算,Flash 的输入和输出价格都低约 89%。但这只是价格对比,并不意味着两者在质量、延迟或运行特性上完全一致。
你买到的是 API 服务,不是一款缩水的本地模型
GLM-5.3-Flash 是一款采用 MIT 许可证的开放权重多模态模型,总参数量为 320B,每个 token 激活 18B 参数。官方 Hugging Face 模型卡提供了公开的 zai-org/GLM-5.3-Flash checkpoint 及本地部署路径;Z.AI 在发布资料中则说明,它支持 100 万 token 上下文窗口,以及文本、图像和视频输入。
“18B 激活参数”指的是被选中的专家计算量,并不等于模型的总内存占用。完整权重、KV cache、运行时开销、多模态处理与上下文长度,仍然决定了本地部署是否可行。
| 使用方式 | 提供的能力 | 主要限制 |
|---|---|---|
| Z.AI API | 托管推理服务,按输入、缓存输入和输出 token 计费 | 账户限额与推理延迟 |
| 官方 checkpoint | 可用于自托管或适配的 MIT 许可权重 | 对内存要求很高,具体取决于精度和量化方式 |
| 社区量化版本 | 可用于部分本地运行环境的更小模型文件 | 构建质量、模态支持、速度和兼容性各不相同 |
低 token 单价与低托管成本是两回事。流量有波峰波谷时,API 只会随实际请求产生费用;自托管则需要持续预留推理容量,即使空闲时也是如此。
真实工作负载下的 API 计费
GLM-5.3-Flash 的实际成本取决于新输入、被识别为缓存的输入,以及生成输出之间的构成:
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
按标准价计算,1000 万新输入 token 加 200 万输出 token 的费用是 $2.50:输入为 $1.50,输出为 $1.00。促销期间,同样的用量成本为 $1.25。
| 工作负载 | 标准价计算方式 | 标准价合计 | 优惠价合计 |
|---|---|---|---|
| 1000 万新输入 + 200 万输出 | $1.50 + $1.00 | $2.50 | $1.25 |
| 200 万新输入 + 800 万缓存输入 + 200 万输出 | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 10 万新输入 + 1 万输出 | $0.015 + $0.005 | $0.020 | $0.010 |
Artificial Analysis给出的每百万 token $0.10 综合成本,是基于缓存命中、输入和输出按 7:2:1 构成的特定工作负载。它适合横向比较这一类用量,不应被当成 GLM-5.3-Flash 的通用费率。
想节省缓存费用,前提是实际发生缓存命中。Z.AI 的Chat Completion 响应 schema提供了 usage.prompt_tokens_details.cached_tokens 字段,因此生产环境应记录该字段,而不是因为提示词看起来重复,就假定能享受缓存折扣。r/opencodeCLI 中一位用户这样评价发布初期的成本表现:
“There's a 50% discount offer until September 9th, and its context consumption is much better than in dsv4f...” — u/CriteriumA, Reddit discussion
优惠截止日期由 Z.AI 价目表确认;其中的对比和使用感受则仅代表该评论者的观点。稳定且重复的上下文可能提高缓存复用率,但并不能消除输出、重试、工具调用或账户限额带来的成本。
一份简明的预算表
预算至少应拆成四行:新输入、缓存输入、输出和付费工具。Z.AI 对 Web Search 的定价为每次 $0.01,因此频繁调用搜索的 Agent,实际费用可能超过只计算 token 的预估。
| 月度用量假设 | 标准价计算公式 | 月度成本 |
|---|---|---|
| 1 亿新输入 + 2000 万输出 | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 2000 万新输入 + 8000 万缓存输入 + 2000 万输出 | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| 100 次 Web Search 调用 | 100 × $0.01 | $1.00 |
这些只是算术示例,并非配额说明。重试请求和中途放弃的 Agent 运行也应单独计入。如果输出量较大,为 max_tokens 设定合理上限,并在合适场景下调低 reasoning_effort,往往比优化一小段提示词前缀更有效。
迁移前需要确认的 Z.AI API 限制
Z.AI 官方 API 的通用基础 URL 为 https://api.z.ai/api/paas/v4/,聊天补全接口为 https://api.z.ai/api/paas/v4/chat/completions。认证方式是 Bearer API key。Z.AI 在其API 介绍中说明,可通过自定义基础 URL 使用兼容 OpenAI 的 Python、Node.js 和 Java 客户端接入。
当前Chat Completion 参考文档在 thinking 和 reasoning 说明中提及 GLM-5.3-FLASH,但其渲染出的模型枚举中没有显示 glm-5.3-flash;不过官方定价页和发布资料均列出了 Flash SKU。在切换生产流量前,应先用小请求验证确切的托管模型 ID。
| 集成要点 | 已确认的限制 |
|---|---|
| 需要测试的托管模型 ID | glm-5.3-flash;请根据在线账户 schema 确认是否接受 |
| 托管接口 | https://api.z.ai/api/paas/v4/chat/completions |
| 认证 | Authorization: Bearer YOUR_API_KEY |
| 思考模式 | GLM-5.3-FLASH 使用启用状态的 thinking;深度由 reasoning_effort 控制 |
| 推理强度 | low、high 或 max |
max_tokens 最大值 | 当前参数参考中为 131,072 |
| Coding Plan | 使用独立的 key、端点和积分体系;它不是通用 API 余额。参见 Z.AI 的 Coding Plan 快速入门 |
Z.AI 将 max 设为默认推理强度。不同推理强度的 token 单价不变,但推理过程可能改变输出用量和等待时间。至于账户限额,Z.AI 要求用户通过账户专属的速率限制面板查看;其公开说明没有给所有 API 账户设定统一的数值上限。
开放权重与托管 API:怎么选部署方式
官方模型卡提供了 Transformers、vLLM、SGLang、TokenSpeed 和 KTransformers 的本地部署示例,但这些示例并不意味着它能在消费级 GPU 上实现实用部署。
如果流量间歇性出现,或缺少高内存推理硬件,优先使用托管 API。若利用率能长期维持较高水平,或数据处理控制权足以抵消运维成本,再考虑分布式或本地部署。低精度文本版本也未必能复现官方多模态配置。
自托管在哪个阶段开始划算
GetDeploying 的估算认为,4-bit 部署约需 192 GB GPU 内存,8-bit 约需 384 GB,BF16 则需 768 GB。该网站估计,一套 $2.90/小时的 MI300X 配置若持续运行,每月成本约为 $2,088;在输入输出比为 5:1 的情况下,API 与自托管的成本平衡点约为每小时 1400 万 token。
这些是第三方估算,并非 Z.AI 对硬件需求的保证。192 GB 的 4-bit 配置被标为紧张配置;KV cache、运行时开销、多模态处理、批处理和空闲时间都会改变盈亏平衡点。在选择本地推理前,应比较每小时基础设施成本、利用率、实际每小时 token 吞吐、缓存命中率和单次任务完成成本。
GLM-5.3-Flash 与 GLM-5.3:选择分界线
Flash 与标准版 GLM-5.3 的价目体系和部署定位不同。
| 比较项 | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| 标准输入价格 | $0.15 / 1M | $1.40 / 1M |
| 标准缓存输入价格 | $0.03 / 1M | $0.26 / 1M |
| 标准输出价格 | $0.50 / 1M | $4.40 / 1M |
| 临时优惠 | 截至 2026 年 9 月 9 日 UTC+8,5 折 | 未显示对应的 Flash 同类优惠 |
| 开放权重 checkpoint | 列有官方 MIT checkpoint | 单独的模型条目;不要据此推断权重相同 |
| 多模态定位 | 原生多模态;Z.AI 描述支持图像/视频输入 | 应单独评估标准版 GLM-5.3 的覆盖能力 |
| 本地部署 | checkpoint 较大,需要高内存推理服务 | 请参考其自身的模型与部署文档 |
如果 token 成本、多模态输入或开放权重路径是关键需求,且应用可以接受强制推理和服务商限制,建议先选择 Flash。只有在实测确认标准版 GLM-5.3 的额外价格能换来对应用真正重要的能力或可靠性差异后,再考虑标准版。
常见问题
GLM-5.3-Flash API 目前的价格是多少?
官方标准价格为:每 100 万 token 输入 $0.15、缓存输入 $0.03、输出 $0.50;上方价目表列出了临时 5 折后的价格。
缓存输入是否按 $0.03 的费率计费?
是的,前提是 Z.AI 将这些 token 识别为缓存输入。缓存输入存储被单独列为限时免费,因此不能将存储状态和缓存命中计费混为一谈。
GLM-5.3-Flash 是开源的吗?
更准确的说法是:它提供采用 MIT 许可证的开放权重 checkpoint。该许可证允许广泛使用,但这款总参数量 320B 的模型仍需要大量内存、兼容的软件和推理服务能力。
我能在普通笔记本电脑上运行 GLM-5.3-Flash 吗?
作为实用的全精度部署,基本不可行。即使第三方给出的 4-bit 估算也在 192 GB GPU 内存左右,而 18B 激活参数并不能消除完整 checkpoint 的存储和运行成本。
GLM-5.3-Flash 比 GLM-5.3 更快吗?
“Flash”体现的是成本和激活计算量定位,并非适用于所有场景的延迟保证。Artificial Analysis 的报告显示,在其测试设置中,经由 Z.AI 的输出速度为每秒 48.7 token,首个回答 token 的时间为 42.57 秒;推理时间和工作负载形态可能主导用户感知到的响应速度。
Coding Plan 是否提供相同的 API 余额?
不是。Z.AI 的 Coding Plan 快速入门说明,Coding Plan 使用独立的 key、独立端点,且访问范围仅限官方支持的工具和产品。不能把 Coding Plan 订阅直接换算为按美元/每 token 计算的公共 API 预算。
当流量间歇出现、硬件尚未购置时,API 是风险更低的选择;本地部署则是另一种经济决策,取决于持续利用率、内存条件和数据控制需求。