 AIREITER
无论是把录音整理成可用文字,还是从麦克风实时输出字幕,Gemini 3.5 Transcribe 都值得纳入评估范围。它在内容清理、自定义词汇和多语言处理方面颇有吸引力,但文件 API 和 Live API 的限制差异很大:前者适合生成可长期保存的转写稿,后者更适合时延敏感、时长较短的实时场景。
先说结论:不需要实时字幕,就优先选文件 API
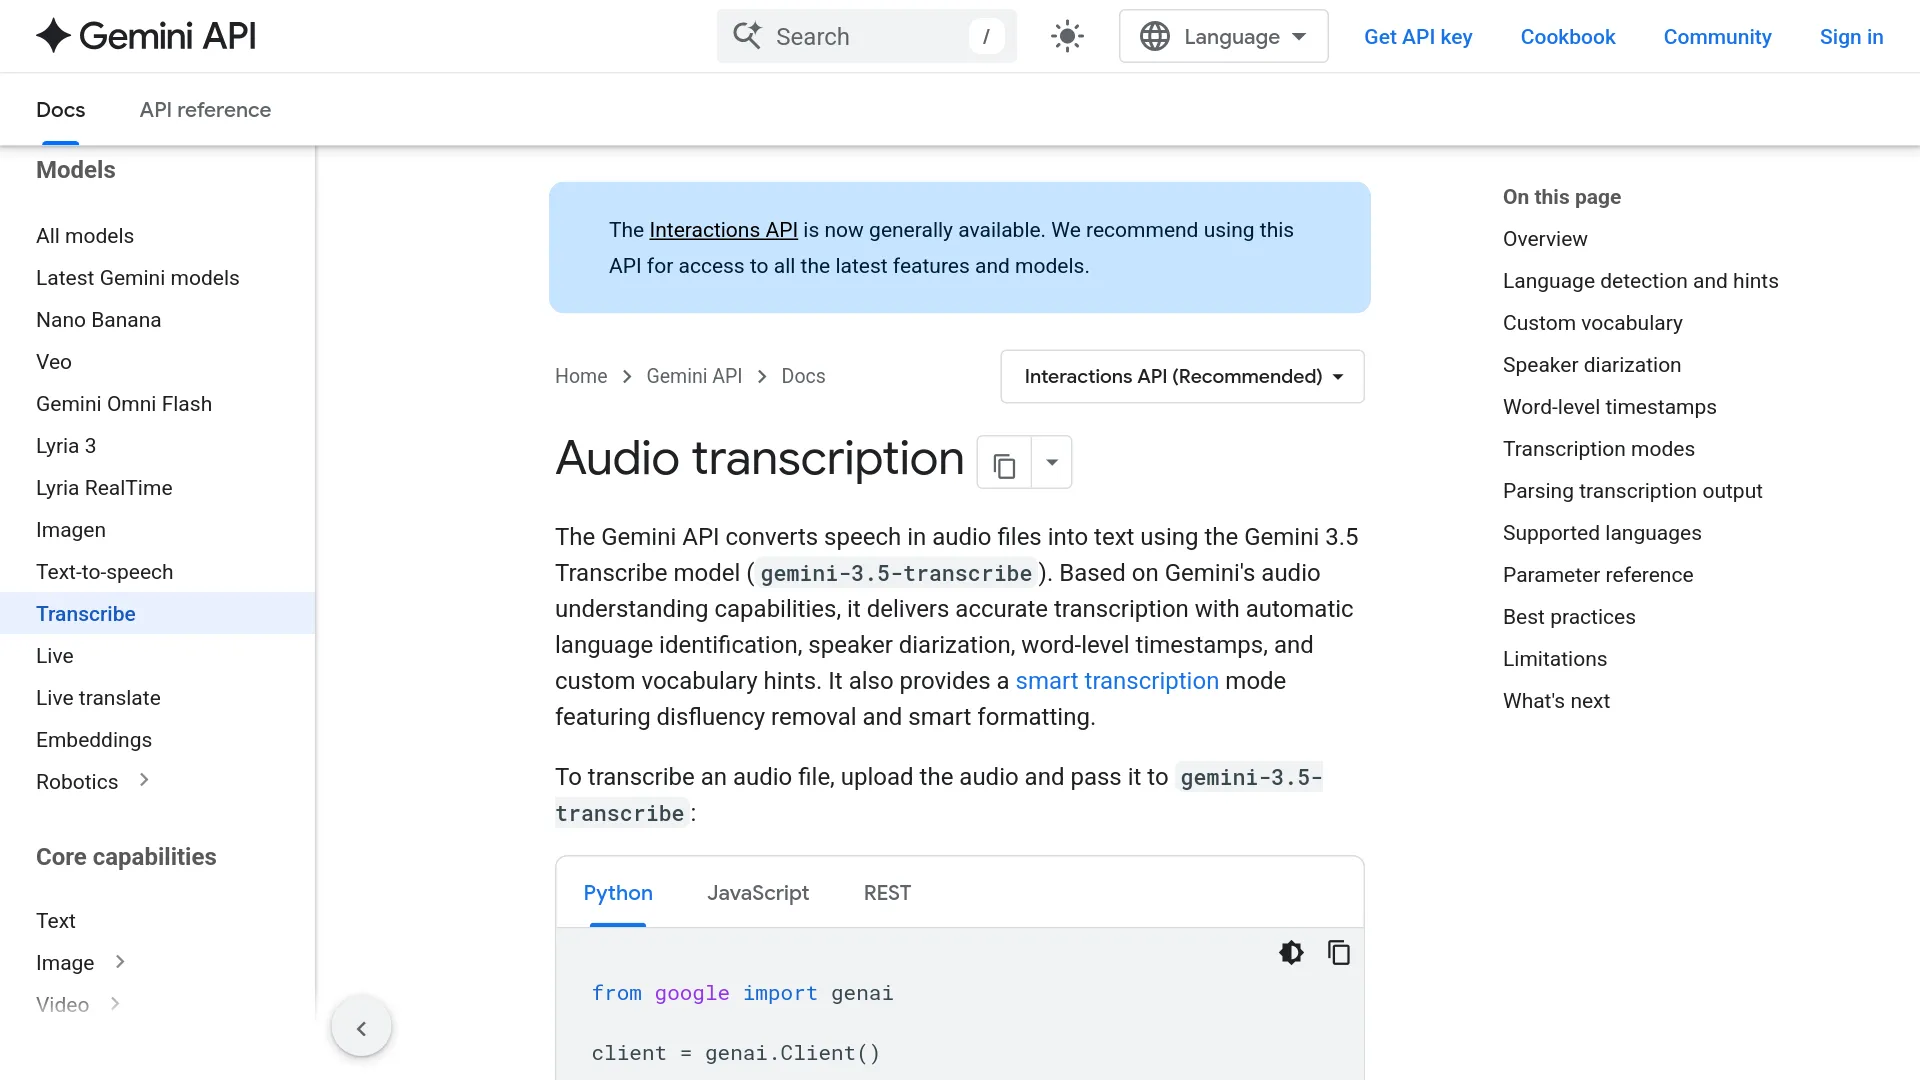
Gemini 3.5 Transcribe 是 Google 专门用于语音转文字的模型系列,自 2026 年 8 月 26 日起以公开预览版提供。针对录音文件和实时音频,Google 分别定义了不同的模型 ID、传输方式、输出事件和使用限制。
| 需求 | 模型 ID | API 路径 | 关键限制 |
|---|---|---|---|
| 会议、通话、上传的录音 | gemini-3.5-transcribe | Interactions API | 标准一元请求最长 1 小时;启用说话人分离或词级时间戳时最长 30 分钟 |
| 实时字幕、麦克风输入、语音界面 | gemini-3.5-transcribe-live | Live API | 连续会话最长 10 分钟;不支持实时说话人分离或词级时间戳 |
如果你要做会议归档、通话分析或字幕制作,建议从 gemini-3.5-transcribe 开始;如果是字幕预览或按键说话界面,则使用 gemini-3.5-transcribe-live。Google 的录音转写指南和 Live API 指南分别介绍了两套工作流。
目前仍处于预览阶段
Google 于 2026 年 8 月 26 日发布 Gemini 3.5 Transcribe,并通过 Google AI Studio 和 Google Antigravity 提供公开预览版开发者 API。企业用户则可以通过 Gemini Enterprise Agent Platform 使用预览版。预览状态意味着其区域覆盖、配额和稳定性可能与正式商用的语音服务不同,因此在投入重要业务量之前,最好先用具有代表性的音频进行测试。
Gemini 3.5 Transcribe 的价格,换算成实际使用成本
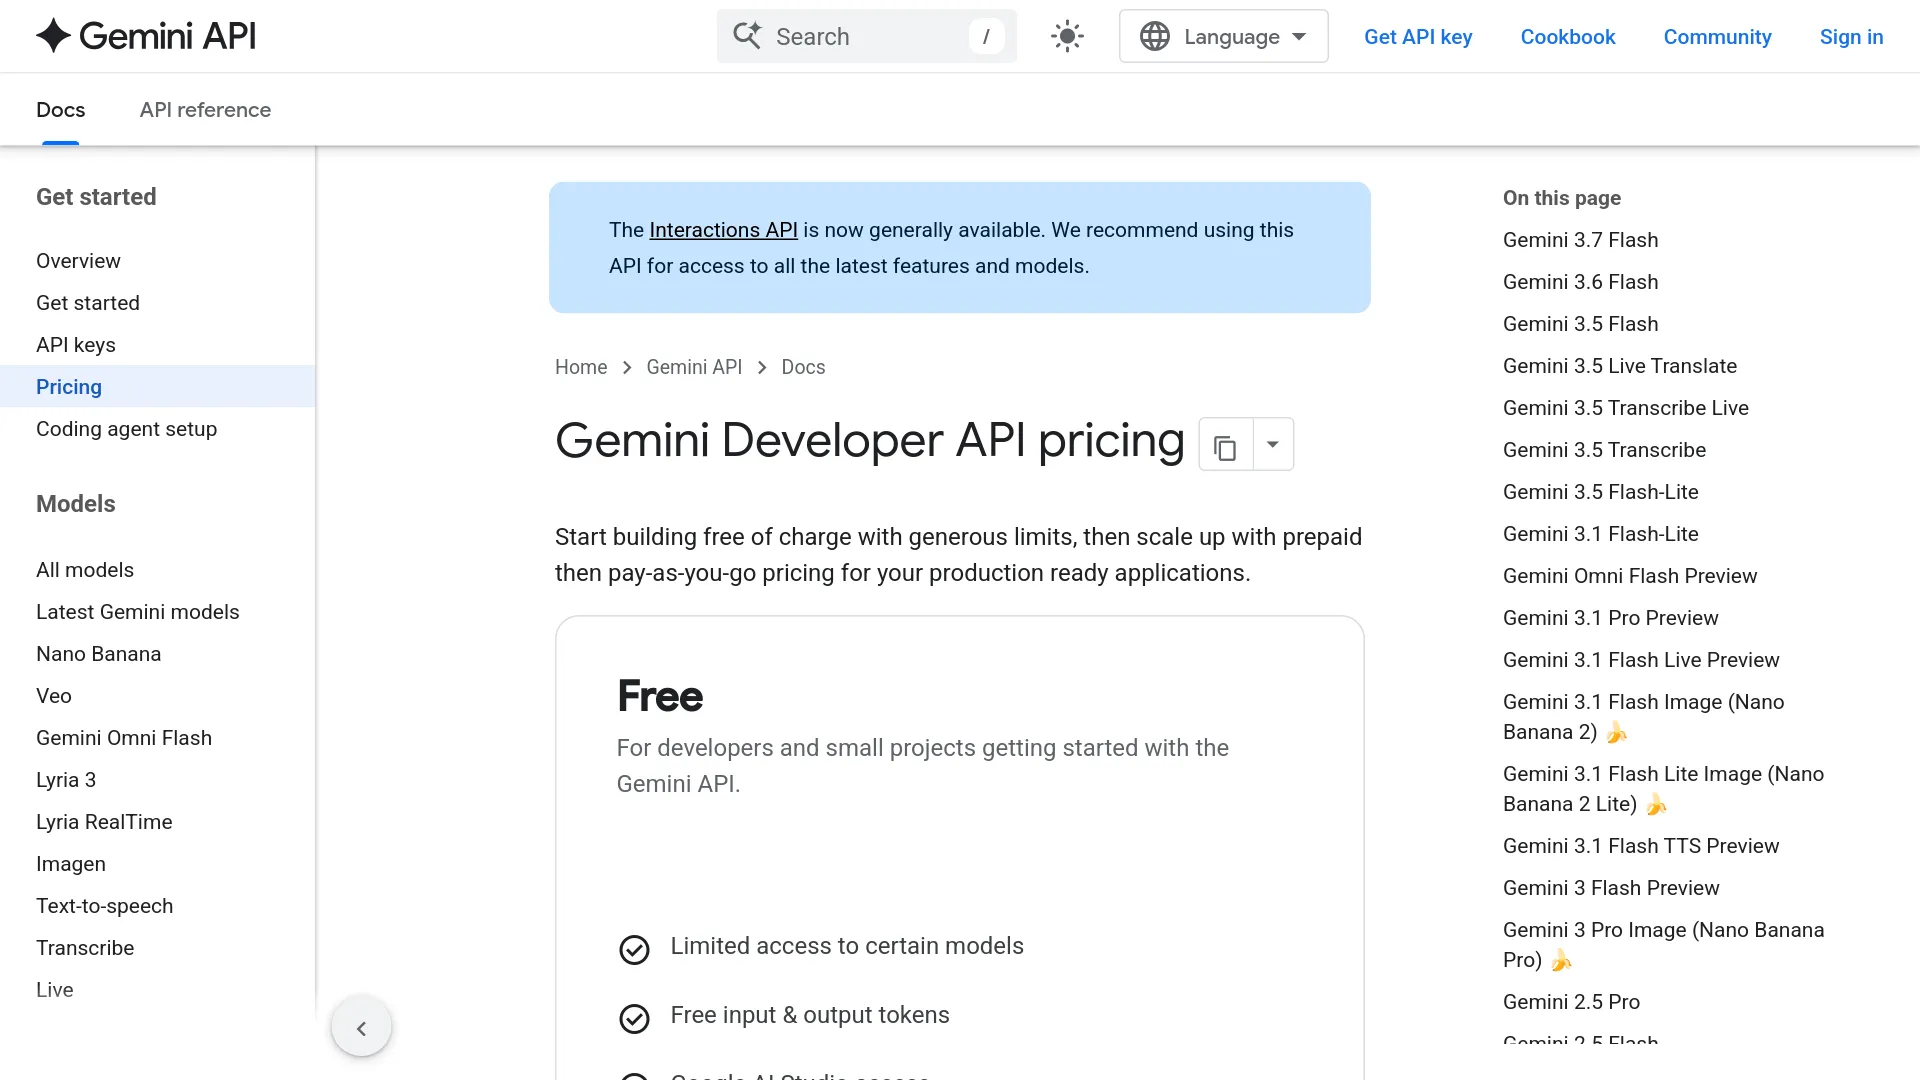
Google 的 Gemini API 定价页面采用按 Token 计费,而不是直接给出固定的转写单价。目前的价格快照显示,gemini-3.5-transcribe 的音频输入为每百万 Token 2 美元,文本输出为每百万 Token 12 美元。
Google 的音频文档显示,音频按每秒 32 个 Token计算,也就是每分钟 1,920 个音频 Token。因此,仅按每百万 Token 2 美元的音频输入价格计算,每分钟约为0.00384 美元,还未计入文本输出和其他可计费 Token。
| 模型 | 公开定价依据 | 参考综合估算 | 参考 1 小时成本 |
|---|---|---|---|
gemini-3.5-transcribe | 每百万音频输入 Token 2 美元 + 每百万文本输出 Token 12 美元 | 约 0.005 美元/分钟 | 约 0.30 美元/小时 |
gemini-3.5-transcribe-live | 实时音频和文本处理按 Token 计费 | 约 0.009 美元/分钟 | 约 0.54 美元/小时 |
综合估算会受到转写文本长度影响,因此只能用于预算规划,并不代表保证不变的每分钟费率。输出内容较密集、重复携带上下文或增加额外指令,都可能改变最终账单。由于预览版价格可能调整,正式投入规模化使用前应再次核对当前定价表。
真正影响生产落地的功能取舍
逐字转写,还是智能整理
VERBATIM 是 Google 转写文档中的默认模式。它会保留语气词、重复、停顿、说到一半的改口,以及原始口语中的自我纠正。如果转写稿要作为记录、证据、字幕底稿,或交给质检流程使用,这通常是更稳妥的选择。
SMART 更像是一次面向可读性的整理:它会去除口头停顿和不流畅表达,处理自我纠正,补充标点和结构,还能格式化日期、货币、数字、列表和段落。比如用户说出“周二——不,周三”,清理后的结果可能只保留“周三”。
Smart 模式不能与说话人分离或词级时间戳同时使用。如果应用既需要易读的会议纪要,又要保留可审计性,建议先请求逐字转写,再单独对副本进行清理。
自定义词汇与中途切换语言
Google 文档显示,系统支持覆盖 85 种以上区域语言的自动语言检测,也支持同一段音频中途切换语言。如果已知语种,可以传入 en-US 或 es-ES 这样的 BCP-47 代码,引导识别。
自定义词汇最多支持1,000 个术语,但 Google 的实际建议是,通常控制在100 个以内效果更好。词表应优先放产品名、缩写、人名、医学术语或技术词汇等容易识别错误的内容,不要把普通词语大量塞进去。
说话人标签与词级时间戳
录音文件可以返回说话人归属和词级时间信息。API 文档列出的上限是8 位说话人;Google 的发布文章则重点展示了最多 3 位说话人的归属能力,并将 3 位以上说话人的支持标记为实验性功能。
词级时间戳只能在逐字模式下启用,可为每个词提供开始和结束偏移。Google 提醒,时间戳可能降低整体转写准确率。同时启用说话人分离或时间戳时,标准音频时长上限也会从 1 小时降至 30 分钟。
| 需求 | 是否支持 | 注意事项 |
|---|---|---|
| 录音中的说话人标签 | 支持 | 文档上限为 8 人;3 人以上的归属能力仍属实验性 |
| 录音中的词级时间戳 | 支持 | 仅限逐字模式;可能降低准确率 |
| 实时转写中的说话人标签 | 不支持 | 需要识别说话人时,应使用录音转写 |
| 实时转写中的词级时间戳 | 不支持 | 实时输出以增量结果和语句为导向 |
| 同时使用 Smart 模式与标签或时间戳 | 不支持 | 需要这些标注时请选择逐字模式 |
如何通过 Gemini 3.5 Transcribe API 发送录音文件
Google 的录音转写指南将流程分成三步:上传文件,把返回的文件 URI 传给 Interactions API,然后从 interaction.output_text 中读取完整转写结果。
- 通过 Files API 上传音频。对于几秒以上的录音,或后续还要重复使用的文件,应采用这条路径。
- 保存返回的文件 URI 和 MIME 类型,例如
audio/mp3。 - 通过 Interactions API 将 URI 发送给
gemini-3.5-transcribe。 - 读取文本输出;如果请求了相关功能,还可以检查
word_info注释中的说话人和时间信息。
使用官方 SDK 时,上传并转写可以简化为下面这样:
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
在 Files API 上传并获得 FILE_URI 后,对应的精简版 REST 请求如下:
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
如果要生成更易读的转写稿,可以加入启用 smart 模式的转写配置:
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
如果需要说话人标签和词级时间信息,则应改用逐字模式:
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
不要把 smart 配置与说话人分离或时间戳组合使用。根据 API 文档中的模式规则,这不是单纯的格式偏好,而是功能设计上的取舍。
实时转写是怎么工作的
Live API 会通过 gemini-3.5-transcribe-live 建立双向流式连接。客户端持续发送音频,并接收两类文本事件:
interim_input_transcription:不断变化的低延迟中间结果,适合字幕或界面预览。input_transcription:已经定稿的文本,可提交到转写稿或应用状态中。
Google 的实时转写指南要求使用原始16 位 PCM、16 kHz、单声道、小端序音频。建议每个音频块约为100 毫秒,每块大约包含1,024–2,048 帧。浏览器和移动端客户端不应暴露普通 API key,而应使用受限的临时令牌;Google 示例使用的是一次性令牌,有效期为 30 分钟。
实时端点支持自动语言检测、BCP-47 语言提示、自定义词汇,以及 VERBATIM 或 SMART 输出。但它不支持实时说话人分离或词级时间戳。连续会话最长只有10 分钟,更长的音频流需要由应用自行管理会话,并拼接多段转写结果。
在判断语句边界时,Live API 提供三种方式:
- 自动 VAD:由服务器检测语音的开始和结束。
- 混合 VAD:由客户端检测语音结束,服务器检测作为备用方案。
- 手动 VAD:由按键说话界面明确发送活动开始和结束事件。
早期数据能说明什么,不能说明什么
Google 援引 Artificial Analysis 的数据称,流式转写平均 WER 为4.0%,非流式转写为2.6%。其发布文章还给出了 FLEURS 测试结果:流式 WER 为5.50%,非流式 WER 为5.04%;与 Chirp 3 相比,最终转写耗时提升了 70%。
这些数据来自厂商报告或厂商引用的发布资料,并不是独立完成的 Gemini 3.5 Transcribe 横向测试。公开的 koedesk STT benchmark测试过 Gemini 3.5 Flash 和其他引擎,但没有直接测试 Gemini 3.5 Transcribe。
早期用户关心的实际问题还包括文件和实时转写的时长限制、WER 所使用的参考文本,以及在安静片段中电话号码或订单号是否足够可靠。与其只看平均 WER,不如用真实业务中的代表性音频测试人名、ID、数字、说话人切换、时间戳偏移和延迟。
什么情况下适合用 Gemini 3.5 Transcribe,什么情况下应该再等等
| 场景 | 适配度 | 建议的起始配置 |
|---|---|---|
| 整理会议纪要或口述内容 | 较强 | 文件 API、SMART;已知语言时明确提供语言提示 |
| 法律、合规或存档记录 | 有条件适合 | 文件 API、VERBATIM;关键段落人工复核 |
| 多人参与的录音通话 | 有条件适合 | 文件 API、VERBATIM + 说话人分离;单次会话控制在 30 分钟以内 |
| 与单词时间同步的字幕 | 有条件适合 | 文件 API、VERBATIM + 词级时间戳;验证时间和准确性 |
| 实时字幕 | 短时场景表现较强 | Live API;只将最终事件写入已提交文本 |
| 长时间运行的语音代理 | 需要额外工程处理 | 在 10 分钟限制前切分会话,并处理重连 |
| 离线或机密数据的本地处理 | 不太适合 | 文档中的工作流会将音频发送到 Google 服务;可以考虑自托管 ASR 方案 |
Gemini 3.5 Transcribe 最适合成为更大工作流中的第一步:先清理语音、保留技术词汇、识别说话人,再把结构化文本交给后续系统。如果你的唯一需求是低成本的逐字转写,或者必须完全离线处理,它就不是理想选择。
Gemini 3.5 Transcribe API 常见问题
Gemini 3.5 Transcribe 免费吗?
Google 为 Gemini API 使用提供免费层,但配额和模型可用性可能变化。付费使用按 Token 计费;当前定价页面给出的参考综合估算是,录音转写约 0.005 美元/分钟,实时模型约 0.009 美元/分钟。
文件模型和实时模型有什么区别?
gemini-3.5-transcribe 通过 Interactions API 处理上传的录音,并支持录音中的说话人分离和词级时间戳。gemini-3.5-transcribe-live 则通过 Live API 流式接收原始 PCM,返回中间和最终事件;它的会话最长 10 分钟,并且不支持实时说话人分离或词级时间戳。
能否一次请求处理 3 小时的录音?
使用专用录音转写配置时不行。标准一元请求上限为 1 小时,启用说话人分离或词级时间戳后上限会降至 30 分钟。更长的任务需要在应用层切分音频,并妥善处理上下文和说话人连续性。
Gemini 3.5 Transcribe 支持离线使用吗?
文档描述的工作流会将音频上传或流式发送到 Google 服务。Google 没有说明 Gemini 3.5 Transcribe 存在离线版或自托管版本。
最稳妥的首次接入方式
先拿真实业务中的小样本测试,不要只用干净的演示录音。让同一段音频分别跑一次逐字模式和 smart 模式:前者检查保真度,后者评估可读性。人名、数字、说话人切换、时间戳漂移和成本,都应该单独记录。
把原始转写稿保留为事实来源,面向用户的笔记使用 smart 输出,同时为上传失败或预览模型变化准备降级方案。只有在客户端已经能够处理 100 毫秒 PCM 音频块、中间与最终事件的差异、临时令牌,以及 10 分钟会话边界后,再考虑迁移到 Live API。