 AIREITER
如果只看综合分数、响应速度和单价,Gemini 3.5 Flash 几乎是更顺手的选择:它的输出速度达到 Gemini 3.1 Pro 的 2.6 倍,每个 token 的价格低 25%,在 Artificial Analysis 的 Intelligence Index 中也以 50 分领先 Pro 的 46 分。不过,Gemini 3.1 Pro 在 ARC-AGI-2 上仍高出 5 分,得分为 77.1%,而 Flash 为 72.1%;当上下文超过 128k tokens 时,Flash 的长上下文检索成绩还会从 84.9% 降至 77.3%。所以该选哪一个,最终取决于任务本身:Flash 更适合追求吞吐量和工具调用延迟,Pro 则更偏向多步骤推理深度。把两者揉进一个综合基准分数,往往会掩盖你的实际工作负载到底需要什么。
基准成绩怎么读:两款模型各自强在哪里
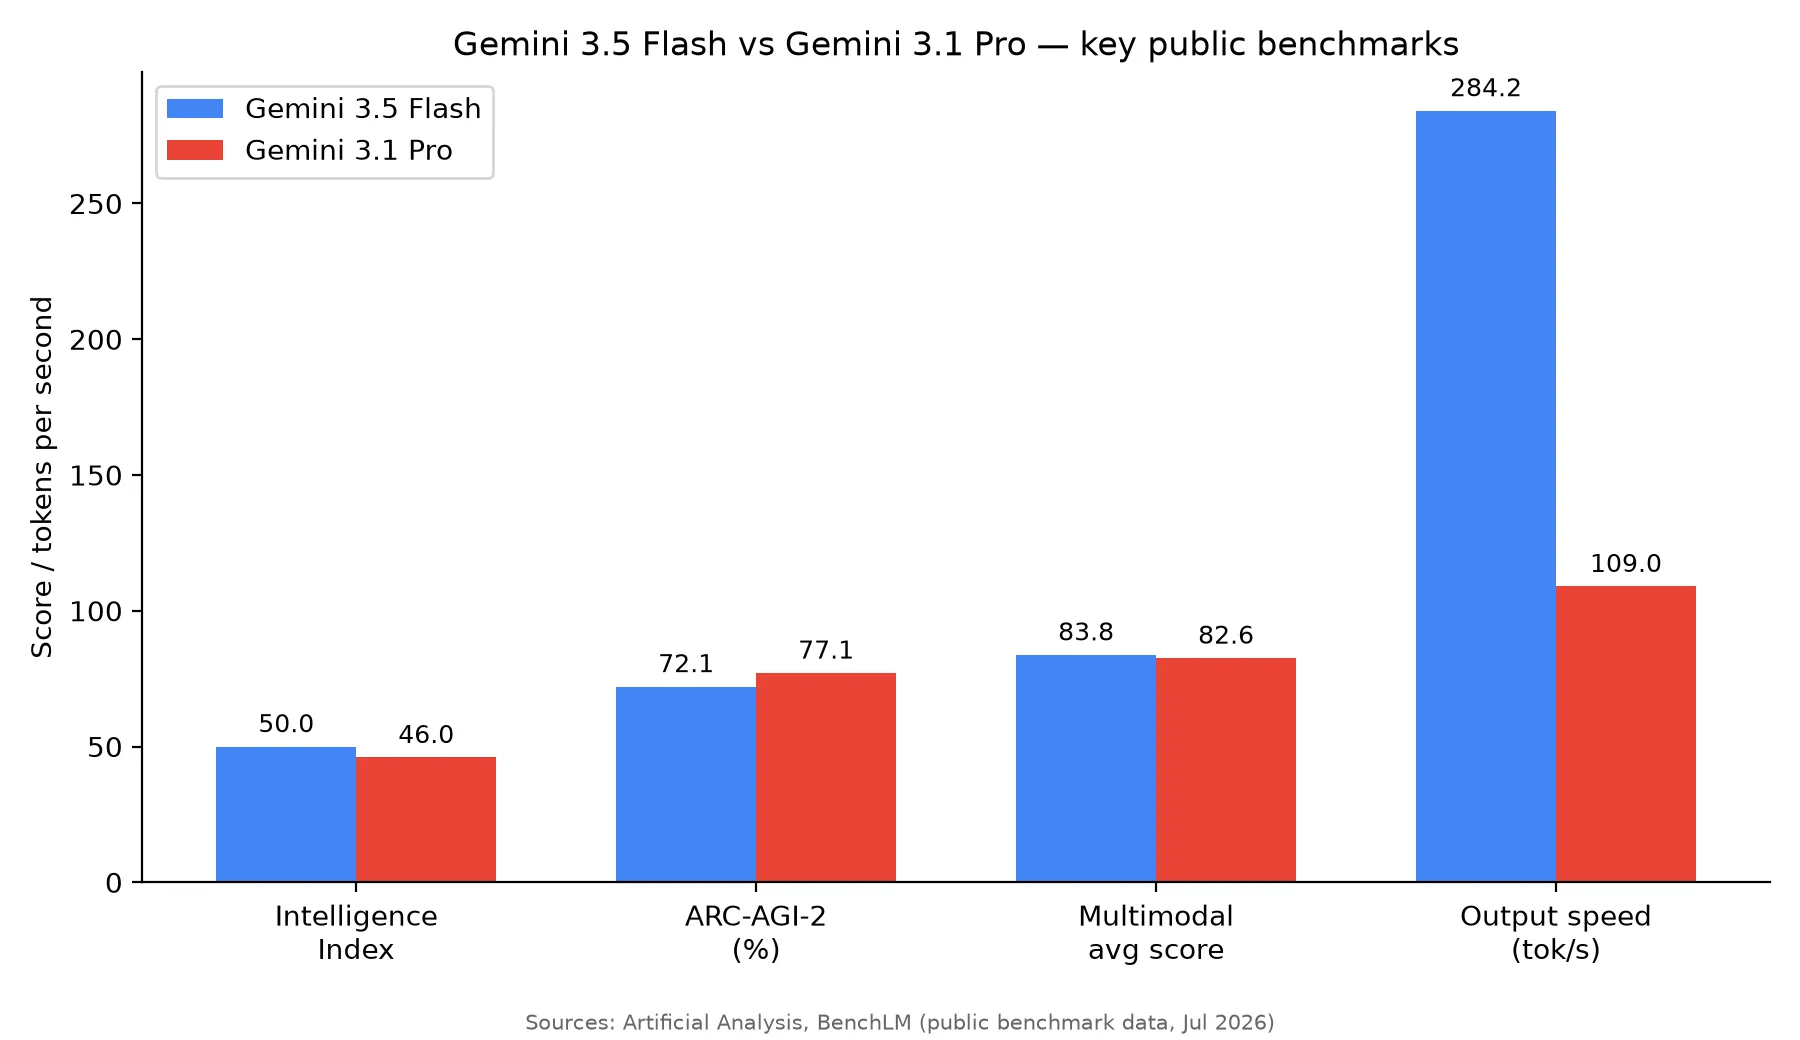
| 指标 | Gemini 3.5 Flash | Gemini 3.1 Pro | 胜出者 |
|---|---|---|---|
| Intelligence Index(Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2,抽象推理(BenchLM) | 72.1% | 77.1% | Pro |
| 128k 上下文下的 MRCR v2(nxcode) | 77.3%(较短上下文时为 84.9%) | 同等长度下未公开报告 | 数据不足 |
| 多模态平均分(BenchLM) | 83.8 | 82.6 | Flash |
| 输出速度(BenchLM) | 284.2 tok/s | 109 tok/s | Flash(2.6 倍) |
| GDPval-AA Elo,真实世界 Agent 任务(apiyi) | 1656 | 1314 | Flash |
凡是衡量吞吐能力和通用任务处理表现的指标,Flash 基本占优。Pro 则在 ARC-AGI-2 所反映的推理深度上有明确且已记录的领先优势。至于长上下文检索,Flash 在超过 128k tokens 后确实出现了成绩下滑,但 Pro 在相同长度下的成绩尚未公开;这项应视为结论未定,而不是直接判给 Pro。相比单一的 Intelligence Index,这种分野更能帮助你判断模型是否适合具体任务。
还要注意 BenchLM 自己提到的方法论限制:两款模型都已公布结果的基准约有 34 项,但其中只有 3 个类别可以直接横向对比;Pro 独有 14 项基准结果,Flash 独有 17 项,而且双方的 thinking budget 设置也并非始终一致。上表可以用来判断大方向,但 ARC-AGI-2 和 MRCR v2 这样差距较大的结果更值得参考;共享指标中仅有 1—2 分的差异,不应解读为决定性领先。
Flash 的领先并非没有边界
在 BenchLM 的对比中,ARC-AGI-2 的 5 分差距,是两款模型在单一类别上最大的差距。ARC-AGI-2 的设计目标就是避免模型依靠模式匹配走捷径,因此,相比常规基准上相近幅度的差距,这 5 分更能说明推理深度的不同。nxcode 的 MRCR v2 结果又提供了同方向的另一项证据:随着上下文接近 128k tokens,Flash 自身的检索准确率会从 84.9% 下滑至 77.3%。Pro 在同等长度下的成绩没有公开,因此这并不是 Pro 已被证实战胜 Flash 的直接对比;但它确实记录了 Flash 的一个退化点,而 Pro 的基准表中并未展示对应数据。
用户观察,不是基准证据:在一则询问高难度任务中更偏好哪款模型的 Reddit r/GeminiAI 讨论帖里,有评论者称 Flash 在“除了长上下文、抽象推理之外的一切方面”都优于 Pro。这只是少量用户观点,不是数据;但它恰好点出了基准测试中呈现的两个例外,因此最多只能作为一个有限的交叉验证,不能单独证明什么。
价格与缓存:真正拉开成本差距的地方
基础定价的差异,实际没有乍看之下那么大:
- Gemini 3.5 Flash:输入 $1.50 / 百万 tokens,输出 $9 / 百万 tokens
- Gemini 3.1 Pro:输入 $2 / 百万 tokens,输出 $12 / 百万 tokens
账面上是 25% 的折扣,而不是 Flash 相对早期 Pro 型号曾有过的 4—8 倍价差。真正更关键的是缓存:
- Flash 的缓存写入免费;缓存输入价格为 $0.15 / 百万 tokens
- Pro 的缓存写入价格为$0.38 / 百万 tokens;缓存输入价格为 $0.50 / 百万 tokens,是 Flash 缓存输入价格的 3 倍以上
对于需要在多轮调用中反复发送同一份系统提示词或文档上下文的工作流——例如聊天 Agent、持续保留代码库上下文的编程助手、多轮客服机器人——这种缓存价格差会迅速累积。单次请求几乎看不出差别,但放到持续一千轮的 Agent 会话里,差距就很明显。
此外,差距也不是固定不变的。apiyi 的价格拆解指出,当上下文超过约 200k tokens 后,两款模型的价格差会收窄到 25—50%,因为在这个规模下,两者的单 token 成本结构趋于接近。如果你的工作负载以超长、单次处理的文档为主,而非短请求的重复调用,Flash 的价格优势就会减弱。
举个具体例子:假设一个客服机器人每天发送 1M 缓存输入 tokens,并生成 500K 输出 tokens。Flash 的成本是缓存写入 $0,加上 $0.15 x 1(缓存输入)和 $9 x 0.5(输出),即每天 $4.65。Pro 在相同负载下,则是 $0.38(一次性缓存写入)+ $0.50 x 1(缓存输入)+ $12 x 0.5(输出),第一天约为 $6.88,首次写入后稳定为每天 $6.50。按一个月计算,约是 $140 与 $195 的差别——当然,这还没把确实需要 Pro 更深推理能力的请求算进去。
Agent 循环:Flash 赢在速度,不等于始终更可靠
nxcode 的 Agent 循环基准测试了一个 8 步 Agent 循环:Flash 完成完整流程约需 25 秒,Pro 则为 100 秒左右,相差 4 倍;步骤越多,这个差距越会放大。在面向真实世界知识工作 Agent 任务的 GDPval-AA 中,Flash 的 Elo 分数为 1656,Pro 为 1314,342 分的领先也是整张基准表中最大的差距。
但前提是 Agent 循环本身运行顺利。ARC-AGI-2 和 MRCR v2 在推理与长上下文任务中呈现的差异,足以让人合理推测:如果循环中某次工具调用返回了意外结果,Agent 需要中途重新规划,Flash 的容错空间可能也会更小——这是基于前述推理深度数据的推断,并非另一项经过单独基准验证的结论。若 Agent 有人工监督,且每一步之间都有人检查输出,Flash 的速度优势几乎是白拿的;如果它要在没有人工介入的情况下连续运行很多步骤,在双方失败率数据公开前,Pro 的推理余量会是更稳妥的选择。
该选哪一个:按任务类型做决策
| 任务类型 | 推荐模型 | 原因 |
|---|---|---|
| 日常编程(测试、PR 审查、编程语言间转换) | Flash | 速度和成本更有优势,推理深度不是主要瓶颈 |
| 深度重构、全新算法设计 | Pro | ARC-AGI-2 的差距会直接体现在多步骤逻辑推理上 |
| 长文档检索(超过 128k tokens 的合同、研究语料) | Pro | Flash 在该长度下已出现明确的 MRCR v2 退化;Pro 的成绩虽未公开,但没有已知弱点的模型是更稳妥的默认选择 |
| 高量级批量生成 | Flash | 免费缓存写入和 2.6 倍吞吐量在规模化场景下最重要 |
| 人工审核输出的 Agent 工作流 | Flash | 可获得速度优势,同时避开无人监督的可靠性风险 |
| 无人监督的高风险 Agent 链路 | Pro | 没有人工在循环中捕捉错误时,推理深度的余量更稳妥 |
| 频繁复用同一上下文的多轮调用 | Flash | 缓存输入价格约为 Pro 的三分之一 |
用一条简单的默认规则,基本就能覆盖上面的大部分情况:优先把请求交给 Flash,除非出现以下三种情况之一——上下文超过 128k tokens 且检索准确率很重要;任务涉及抽象或多步骤推理,例如新算法、法律或研究综合分析;或者 Agent 要在无人监督下运行超过少量步骤。任意一项成立,就更应倾向 Pro;若都不成立,Flash 的速度和缓存价格使它成为成本更低的默认选择。
常见问题
Gemini 3.5 Flash 比 3.1 Pro 更好吗?
在速度、成本和通用基准成绩上,是的。但在抽象推理能力上,也就是 ARC-AGI-2,Gemini 3.1 Pro 仍领先 5 分。对于超过 128k tokens 的长上下文检索,Flash 有已记录的成绩退化,而 Pro 的对应成绩尚未公开;因此这项对比应视为尚无定论,而非 Pro 已确认胜出。哪一个“更好”,取决于你的任务属于哪一类。
Gemini 3.5 Flash 比 3.1 Pro 便宜多少?
基础输入/输出价格大约便宜 25%:每百万 tokens 为 $1.50/$9,对比 Pro 的 $2/$12。更大的节省来自缓存:Flash 的缓存写入免费,缓存输入的价格约为 Pro 的三分之一,因此对多轮调用或高量工作负载尤其有意义。
Gemini 3.5 Flash 适合编程吗?
适合日常编程工作,例如生成测试、PR 审查,以及不同编程语言之间的代码转换。对于深度重构或全新算法设计,Pro 在抽象推理基准上的优势通常会反映在输出质量上。
Gemini 3.5 Flash 的长上下文能力怎么样?
在较短上下文长度下表现不错,MRCR v2 检索准确率能保持在 84.9%。但超过 128k tokens 后会降至 77.3%;对于多文档合同审查这类任务,这个差距有实际影响。Gemini 3.1 Pro 在相同长度下的成绩尚未公布,因此应将其视为 Flash 已知的限制,而不是 Pro 已获确认的优势。
结论
对于多数日常任务和高量工作负载,Gemini 3.5 Flash 是更好的默认选择:速度更快,缓存成本更低,通用基准成绩也足够接近,以至于多数场景下这种取舍并不重要。Gemini 3.1 Pro 则在抽象推理和无人监督的 Agent 链路上证明了更高价格的价值;对于超过 128k tokens 的长文档,Flash 自己的数据已经显示出一个弱点,但 Pro 的数据既无法确认也无法排除其优势,因此在最终押注任何一款之前,值得先自行测试。
本文对比基于公开基准数据(Artificial Analysis、BenchLM、nxcode 和 apiyi),并非亲自进行的 API 测试。Gemini 3.1 Pro 上市时的定位就是侧重推理,这与 Flash 的速度导向不同。截至本文撰写时,Gemini 3.5 Pro 尚未发布;相关报道指向 2026 年 7 月发布。因此这只是一个阶段性快照:待下一版 Pro 落地后,两款模型以及本文的对比结论都需要重新审视。