 AIREITER
Eleven v3 已于 2026 年 2 月 2 日结束 alpha 阶段,正式进入 GA。通过 ElevenLabs API 调用时,模型 ID 是 eleven_v3。ElevenLabs 和 fal.ai 的价格同为每 1,000 个字符 $0.10,因此单价不是选型关键;真正拉开差距的是计费方式、并发能力和语音访问范围。GA 版本也确实解决了一些问题:根据官方 GA 公告,在涵盖 27 个类别、8 种语言的测试中,结构化文本错误率从 15.3% 降至 4.9%。不过集成前仍要围绕两项硬约束设计:单次请求最多 5,000 个字符,而且连官方也明确表示,该模型不适合实时场景。
ElevenLabs Eleven v3 API 能做什么
Eleven v3 API 提供四类接口:生成语音、流式生成语音,以及面向多说话人音频的生成对话和流式生成对话接口。模型支持 70 多种语言,可在文本中直接嵌入音频标签来控制情绪和演绎方式。GA 后,其稳定性也有所提升:ElevenLabs 自己的测试中,72% 的情况下测试者更偏好 GA 版本而非 alpha 版本。
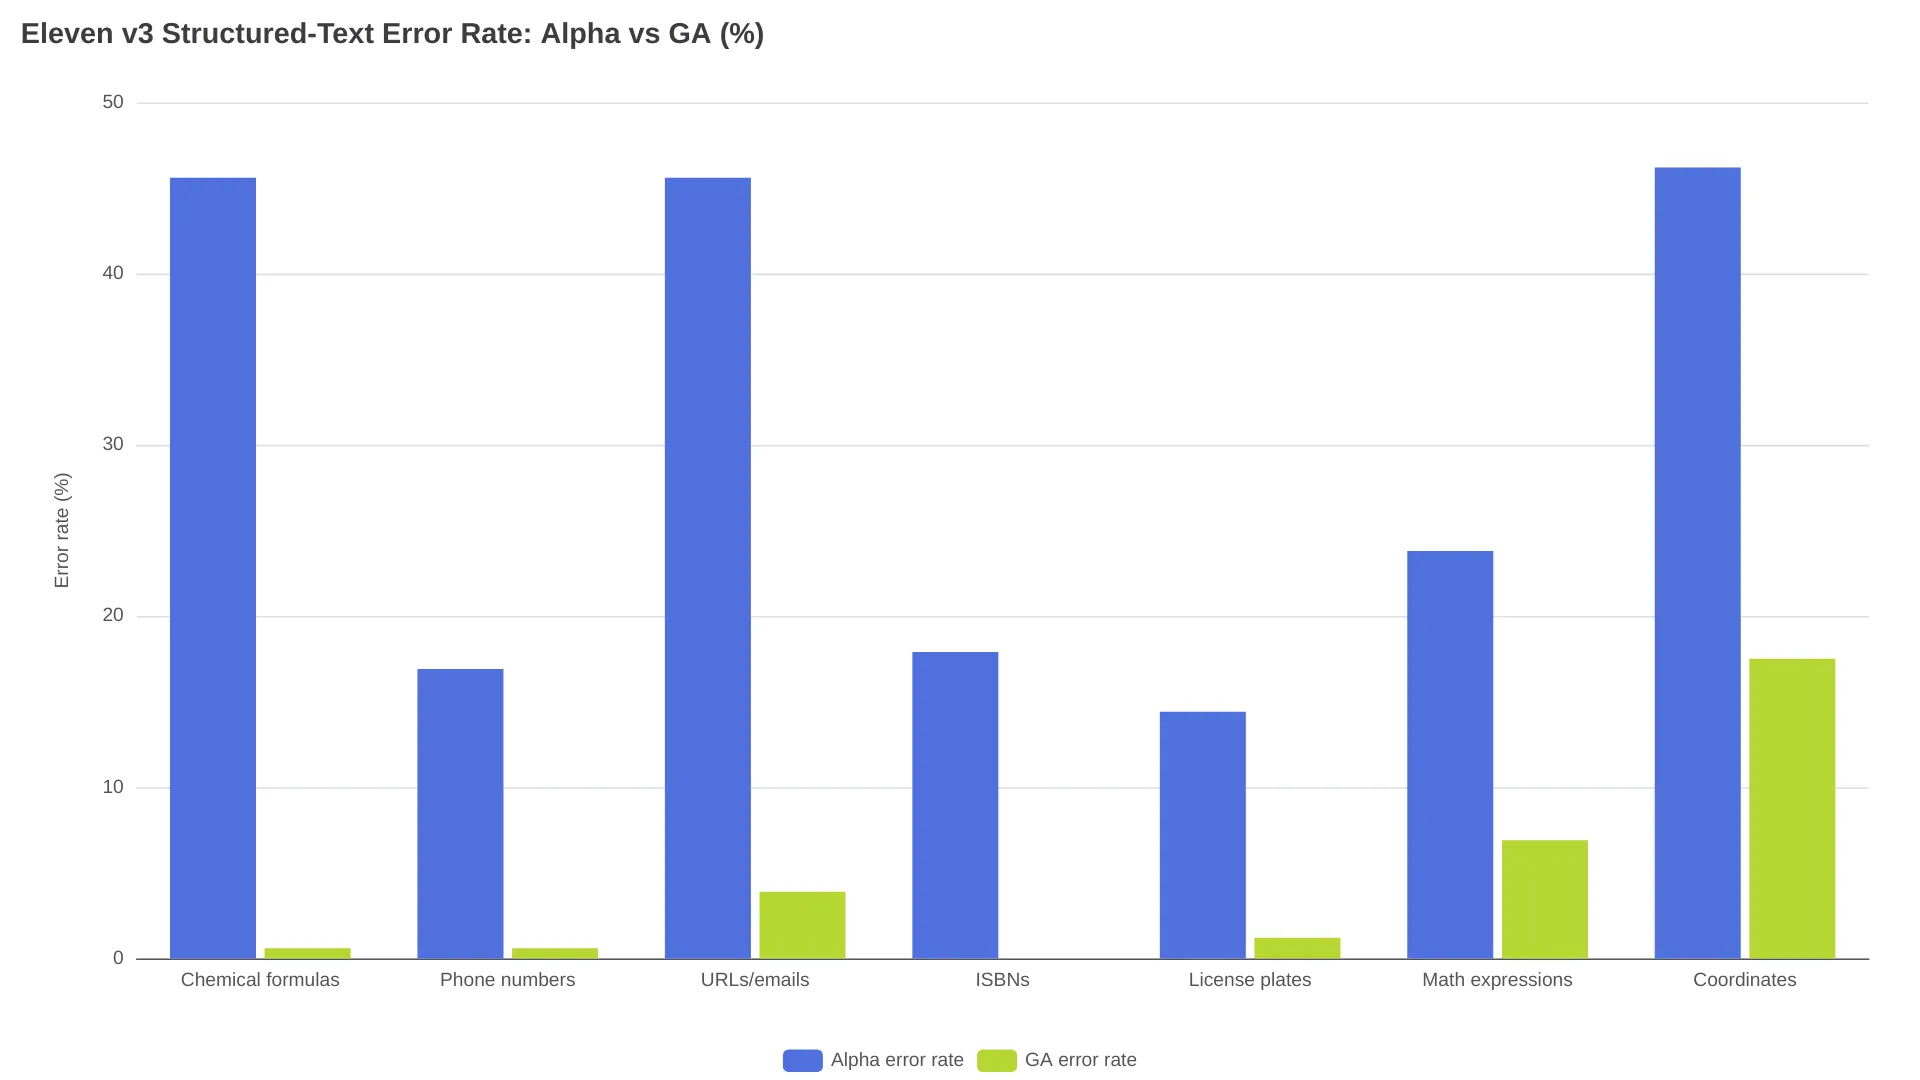
如果你要让 v3 处理结构化文本,建议先看这份基准测试的分类结果:化学式错误率从 45.6% 降至 0.6%,电话号码从 16.9% 降至 0.6%,ISBN 错误率则降为零。地理坐标依然是短板,错误率为 17.5%;数学表达式为 6.9%。用于旁白问题不大,但坐标密集型内容仍有风险。
根据官方模型参考文档,v3 与同系列模型的定位如下:
| 模型 | 模型 ID | 语言 | 单次请求最大字符数 | 标称延迟 | 每 1k 字符价格 |
|---|---|---|---|---|---|
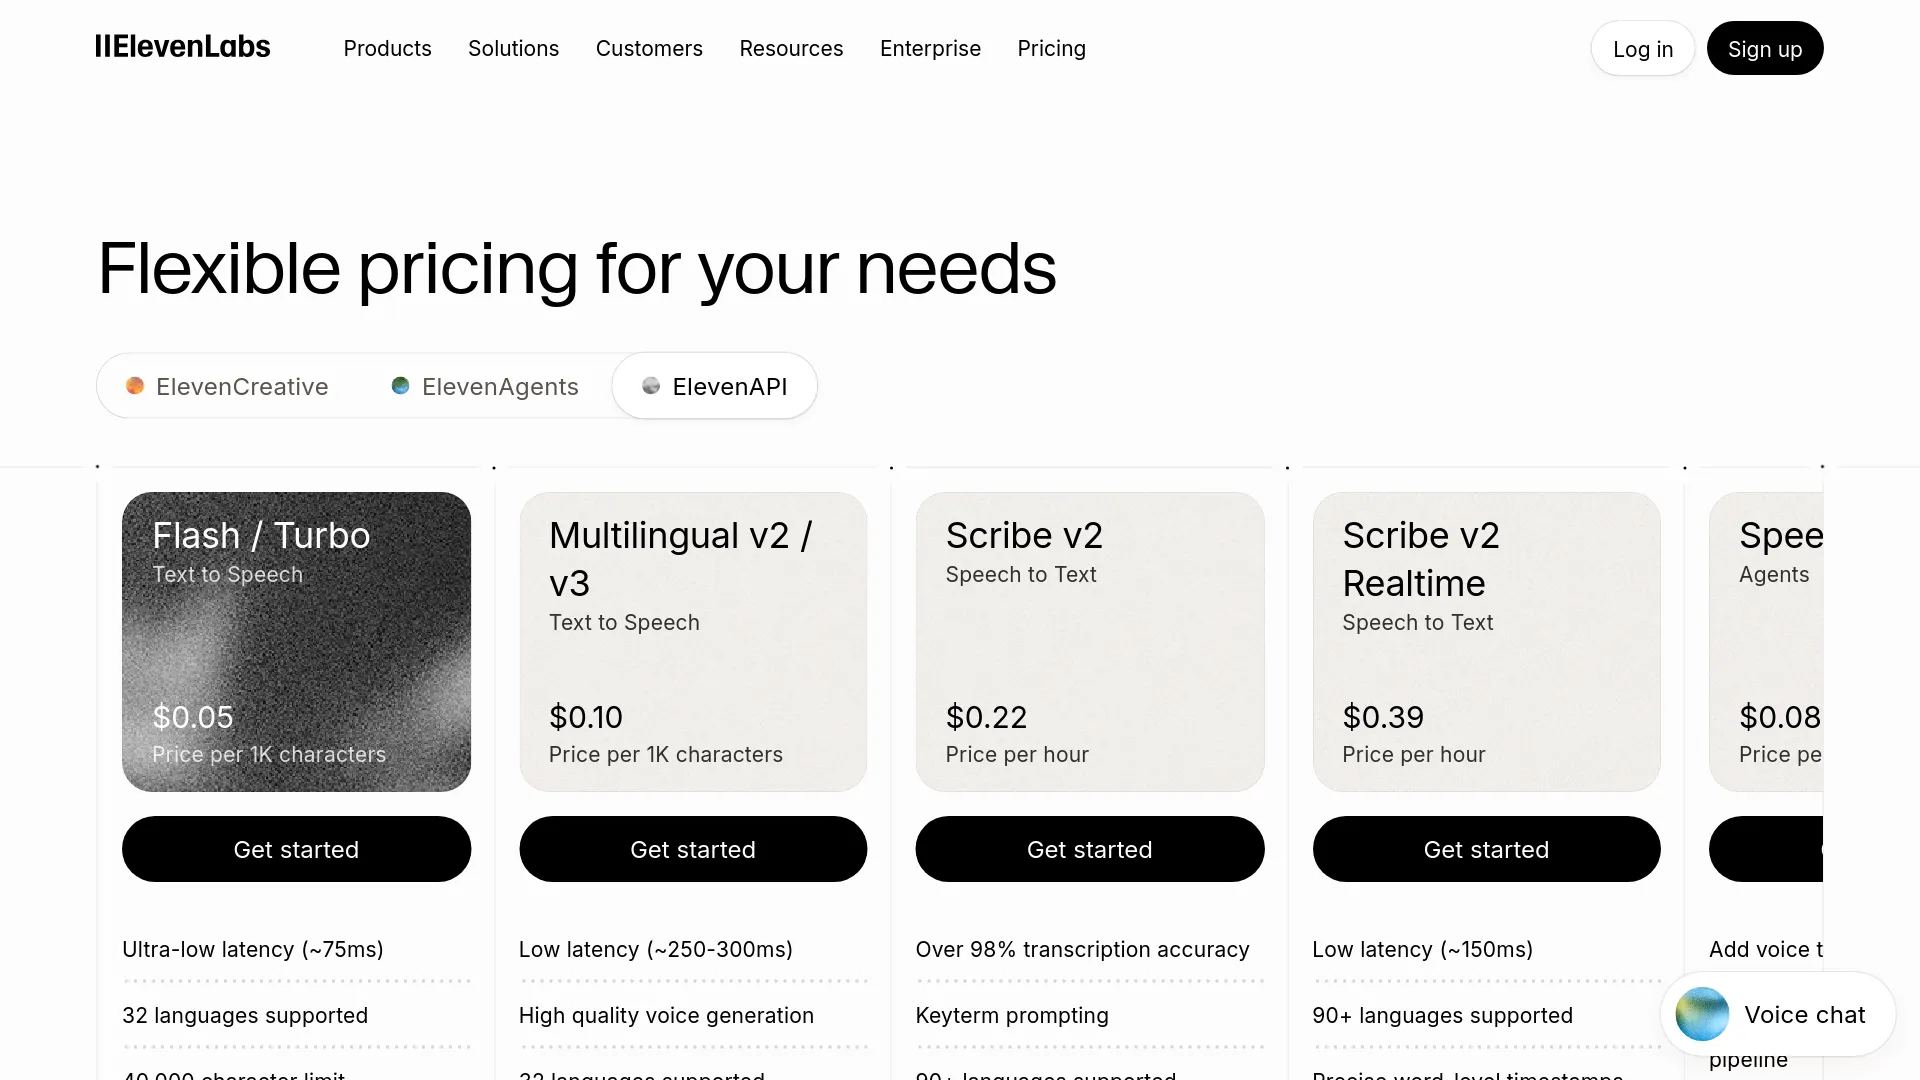
| Eleven v3 | eleven_v3 | 70+ | 5,000(约 5 分钟) | 约 250–300 ms(视套餐层级而定) | $0.10 |
| Eleven v3 Conversational | 通过 Text-to-Dialogue WebSocket | 70+ | 不适用 | 约 280 ms | $0.10 |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10,000(约 10 分钟) | 约 250–300 ms | $0.10 |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40,000(约 40 分钟) | 约 75 ms | $0.05 |
这里有一处文档口径不一致,需要特别注意:定价页将“Multilingual v2/v3”归入 40,000 字符的层级上限,但模型参考文档明确写明 Eleven v3 单次请求上限为 5,000 字符。对 v3 而言,应以 5,000 为准;这是模型级别的具体限制。长文本管线若按 40k 来设计,会直接失败。
价格对比:ElevenLabs 官方与 fal.ai
两家的 Eleven v3 单价完全一致,均为每 1,000 个字符 $0.10;同系列中只有 Flash v2.5 更便宜,为 $0.05/1k。实际差异主要在计费和并行处理能力:
| ElevenLabs 官方 | fal.ai | |
|---|---|---|
| 单价(Eleven v3) | $0.10 / 1k 字符 | $0.10 / 1k 字符 |
| 计费方式 | 订阅套餐含额度,也可按量付费 | 纯按量计费;“无席位许可证、无订阅、无最低消费” |
| 免费层 | 每月 10k Multilingual 字符(20k Flash) | 模型页面未注明 |
| 套餐示例 | Creator $22/月(首月 $11),220k Multilingual 字符 | 不适用 |
| 最高套餐 | Business $990/月,9.9M Multilingual 字符 | 不适用 |
| 并发能力 | 按套餐划分:Free 为 2 个并发 Multilingual 请求,Scale/Business 为 15–30 个,Enterprise 可定制 | Serverless 队列;模型页面未记录按账户限制的上限 |
| 排队代价 | 超过限制后请求进入队列,“通常”额外增加约 50 ms | 批处理可使用带 webhook 的队列 API |
| 控制项(已记录的 schema 加上用户反馈) | 通过 ID 选择语音;稳定性(用户称 v3 有 3 档) | 语音、stability、similarity_boost、speed、language_code、apply_text_normalization、seed、timestamps、output_format |
| 创业公司计划 | 免费 12 个月、33M 字符、更高并发 | 不适用 |
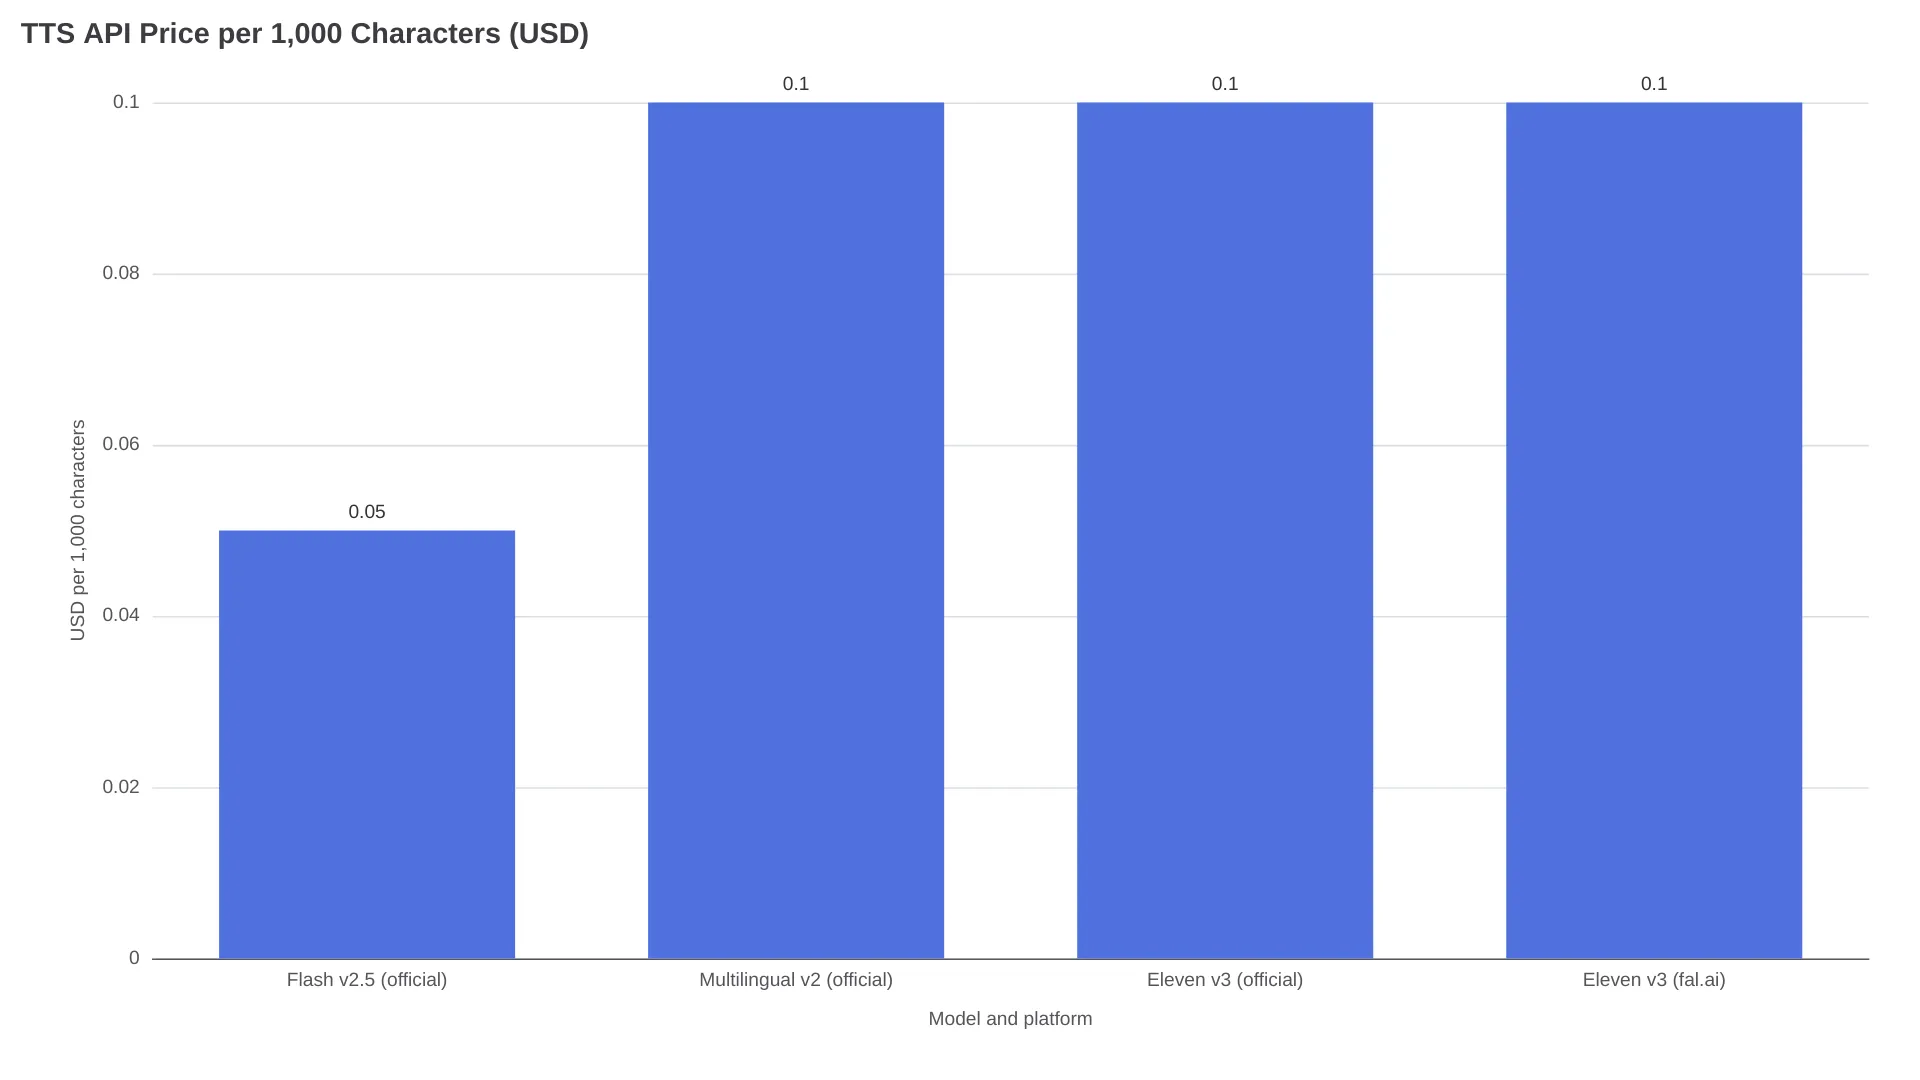
官方路线通过套餐层级来定价并发能力:Free key 并行调用 v3 时,最多只有 2 个并发请求,批量任务会明显受限。fal 则将所有作业放入 Serverless 队列,并提供适合批处理的 webhook 回调。两家平台的定价文档都没有说明空白字符或方括号音频标签是否计入计费字符数;预算时应按会计入处理。
如果你只是偶尔使用 v3,且其他模型本来就部署在 fal 上,可进一步阅读我们的 fal.ai 评测。
音频标签:直接在文本里控制情绪与演绎
音频标签是直接写在文本中的方括号指令。模型会把它们理解为表演指导,而不会将其朗读出来。以下是 fal 模型页面给出的最小示例:
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| 类别 | 可用示例 |
|---|---|
| 情绪 | [happy]、[sad]、[excited]、[angry]、[sarcastically]、[nervous]、[happily] |
| 演绎方式 | [whispers]、[shouting]、[shouts]、[slowly]、[quickly]、[softly] |
| 非语言声音 | [laughs]、[chuckles]、[sighs]、[gasps]、[coughs]、[gulps]、[clears throat]、[applause] |
| 口音 | [british accent]、[southern accent]、[strong canadian accent] |
官方提示词文档对标签行为给出了三条核心规则:第一,没有一份权威的固定标签列表。标签本质上是自然语言指令,ElevenLabs 也表示,除了已公布的示例之外,可能还有更有效的标签,因此测试比死记列表更重要。第二,不支持 SSML 的 break 标签;节奏应通过标点、省略号和换行控制。第三,标签效果会随语音和上下文而变化。问题往往就出在这一点:
“V3 is amazing, certainly the most human sounding” “it still feels like a Beta release to me” —— u/ConcertNeat8147,同一篇帖子中的两句话,r/ElevenLabs 关于 v3 的一线反馈
同一讨论串中,拥有二十年经验的软件工程师 u/poundingCode 表示,加入情绪标签偶尔会让说话人的口音完全改变。ElevenLabs 的员工账号回复称:“这些都是我们目前正在处理的问题。”
同一讨论串中创作者分享的应对方法如下。这些属于社区经验,并非官方建议:
- 加一句预热文本。 在正式内容前放一句无关紧要的话,用来设定语气和音高,生成后再剪掉;语音往往会在生成几秒后“稳定下来”。
- 结尾追加
end.。 在正文末尾加一个换行和单词 “end.”,可避免最后一个词被截断,之后再从音频中剪掉。 - 用省略号结束句子。 有报告称,句末以 “...” 收尾后,词尾截断的情况会减少。
- 把稳定性调到最高。 v3 的稳定性控制有三档,最高档可减少生成开头的声音漂移。
会直接影响集成方案的限制
- 最重要的是 5,000 字符上限。 单次请求最多约生成 5 分钟音频,因此有声书和长文本管线必须切块。应在句子或段落边界切分,不要从句子中间截断;音频标签也要和它所作用的文本放在同一个块里。若希望减少请求次数、使用更大的文本块,Multilingual v2 支持 10,000 字符。
- 官方 API 的并发能力取决于套餐。 根据模型参考文档:Free key 有 2 个 Multilingual 层级并发请求额度(Flash 为 4 个),Scale 和 Business 为 15–30 个,Enterprise 可协商定制上限;超出限制后进入队列,“通常”会增加约 50 ms。该页面还给出了 ElevenLabs 的容量估算:在对话型负载下,并发限制为 5,大致可支持 100 路同时音频播放。单次请求的代价不高,但批处理规模下,配置不足会造成严重影响。
- fal 没有记录任何最大输入长度。 它的 Eleven v3 页面列出了端点、参数和格式,但没有说明输入上限、队列保留时长或重试行为。你可以提交长文本,但这不代表平台对此作出任何保障。
- 时间戳能力分散在两个平台上。 fal 的输入 schema 提供
timestamps布尔参数,可返回逐词对齐数据,适合字幕和口型同步。官方 API 中,v3 的对话输出不带时间戳,这一缺口已有开发者公开提出(r/ElevenLabs:“v3 API, no timestamps?”);目前 fal 的这个参数是获取对齐数据的已文档化路径。
- 实时场景仍然不适用。 ElevenLabs 表示,v3 的延迟更高且一致性存在波动,因此不适合实时和对话式使用。官方给出的替代选项是:面向智能体的 Flash v2.5,延迟约 75 ms;或者在交互场景中仍需保留表现力时,使用通过 WebSocket 提供的 Eleven v3 Conversational,延迟约 280 ms。实时版 v3 已在路线图中,官方称“we're working on a real-time version”,但截至 GA 公告发布时尚未上线。
- 商业用途。 在 alpha 阶段,开发者曾公开询问 v3 输出能否商用;GA 公告已将该模型开放至所有平台,fal 也直接将其端点标注为可用于商业用途。
第一次请求:官方 SDK 与 fal 客户端
官方调用路径,以下内容摘自快速入门文档:
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # or ELEVENLABS_API_KEY env var
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)fal 路径则通过 fal-client 调用 fal.run 端点:
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # default voice
"stability": 0.5, # 0–1, lower = more expressive variation
"timestamps": True, # per-word alignment data
},
)
print(result["audio"]["url"]) # hosted MP3 URL两个平台都明确警告,不能将 API key 直接放进客户端代码,应通过你自己的服务器代理请求。流式场景下,官方 API 提供 stream-speech 端点;fal 则提供 fal.stream,并为批处理任务提供带 webhook 的队列 API。
到底该调用哪个端点?
| 你的场景 | 建议调用 |
|---|---|
| 需要自定义克隆语音(PVC/IVC)或通过 ID 使用设计语音 | 官方:自定义语音以工作区中的 ID 引用;fal 页面只记录了预设语音名称 |
| 已经购买含额度的 ElevenLabs 套餐 | 官方:套餐内字符额度已经支付,fal 的每次调用都会产生新支出 |
| 批量制作有声书或配音,不想订阅,并且需要完成 webhook | fal:其按量付费的队列和 webhook 流程正是为这类场景设计 |
| 希望一把 API key 覆盖图像、视频和 TTS 模型 | fal:v3 可与其他 fal 模型共用同一套客户端 |
| 语音智能体或任何受延迟约束的场景 | 两个 v3 TTS 端点都不合适:请使用 Flash v2.5(约 75 ms)或 Eleven v3 Conversational(约 280 ms) |
| 企业级需求(SOC 2、HIPAA BAA、自定义速率限制、IP 白名单) | 官方:这些 Enterprise 套餐能力已记录在定价页面;fal 的模型页面没有说明其端点涵盖哪些认证 |
常见问题
Eleven v3 的模型 ID 是什么?
eleven_v3。在标准文本转语音端点中,将它作为 model_id 传入。多说话人对话使用独立的 Text-to-Dialogue 端点,而非通过模型参数调用。
Eleven v3 API 支持流式生成吗?
支持。官方 API 提供 stream-speech 端点,会在音频生成过程中持续返回数据;fal 也为同一模型提供 fal.stream。但流式传输并不会让 v3 适用于实时场景,官方仍建议对话式使用 Flash v2.5 或 Eleven v3 Conversational。
Eleven v3 的字符上限是多少?
根据官方模型参考文档,单次请求为 5,000 个字符,约对应 5 分钟音频。定价页中的 40,000 字符数字适用于 Multilingual 层级分组,并非 v3 的专属上限。
Eleven v3 API 怎么收费?
两个路径都是每 1,000 个字符 $0.10:一篇 10,000 字符的故事为 $1.00,1M 字符的有声书为 $100。官方套餐额度可抵扣成本,例如 Creator 为 $22/月,包含 220k Multilingual 字符;fal 则没有订阅制。
Eleven v3 可以使用克隆语音吗?
在官方 API 中可以:专业语音、克隆语音和设计语音都通过 voice ID 引用。不过实际兼容性会有所差异;r/ElevenLabs 用户反馈,已有的 Professional Voice Clones 在 v3 下有时会听起来像不同的说话人,而创作者标明支持 V3 的 PVC 往往表现最好。fal 的 schema 接受语音名称或 ID,但只记录了预设语音,因此私有 ElevenLabs voice ID 在该平台上属于未文档化用法。
Eleven v3 适合实时语音智能体吗?
不适合。ElevenLabs 明确将实时和对话式使用列为不适合 v3 的场景,原因是延迟较高且一致性存在波动。请使用 Flash v2.5(约 75 ms,32 种语言)或 Eleven v3 Conversational(约 280 ms,70 多种语言,支持音频标签控制)。
为什么 Eleven v3 通过 API 生成的声音和网站上不一样?
语音预览并不能代表输入你自己文本后的实际效果,这是r/ElevenLabs 一线反馈中反复出现的问题;同时,v3 不同次生成的输出也会有明显差异。在正式投入前,应使用真实脚本片段、按照你的生产环境稳定性设置,逐一测试候选语音。
延伸阅读:Qwen Audio 3 TTS API 指南 · Replicate 定价与替代方案 · fal.ai 2026 评测