 AIREITER
原始的 facebookresearch/demucs 仓库自 2025 年 1 月 1 日起就已经变成只读状态。不过,Demucs 依然是目前最强的免费本地音轨分离方案之一。前提是:从发布 v4.1.0 的 fork 安装,并接受它最先暴露短板的地方通常是吉他和钢琴。
安装 Demucs,先找维护中的仓库
GitHub 上有两个仓库使用同一份 README,但现在只有一个还在持续修复问题。facebookresearch/demucs 已经归档并设为只读,仓库自己的 README 也指向了其他地址。现在的维护主页是 adefossez/demucs。作者 Alexandre Défossez 写道,这是“我离开 Meta 加入 Kyutai 后,官方维护的 Demucs”,同时也提醒大家“目前预计回复会比较慢,也暂时不会加入新功能”。
这不只是把安装链接换一下那么简单,具体的安装命令也随之改变了。
v4.1.0 到底改了什么
日期为 11/07/2026 的发布说明将 Demucs v4.1.0 概括为:“现代化的打包方式、更轻量的推理依赖、众多修复,以及托管在 Hugging Face 上的预训练模型。”实际使用时,主要区别如下:
| 项目 | 已归档仓库 | 维护中的仓库(v4.1.0) |
|---|---|---|
| 最低 Python 版本 | 3.8 | 3.10 |
| 最快运行方式 | pip install -U demucs | uvx demucs MY_TRACK.mp3(无需安装步骤) |
| 永久安装 | pip install -U demucs | uv tool install demucs(仍然支持 pip) |
| ffmpeg | 必需 | 可选;输出 FLAC,以及处理 sphn 无法解码的格式时需要 |
| 量化模型 | 已包含 | 需要额外安装:uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| 模型权重托管地址 | dl.fbaipublicfiles.com | Hugging Face |
还有一个容易被忽略的坑,最好在提交 bug 前先确认:PyTorch 在 2.2 之后放弃了对 Intel Mac 的支持,Intel Mac 用户因此最多只能用 Python 3.12,并且需要运行 uvx --python 3.12 demucs。
模型怎么选:htdemucs、htdemucs_ft、htdemucs_6s 还是 mdx
-n 参数用来选择模型,而默认模型并不总是最佳答案。Demucs 提供四源模型(鼓、贝斯、其他、人声)、一个六源实验模型,以及较早的 MDX 挑战赛模型。
| 模型 | 音轨数量 | 速度 | 官方提醒 | 适合什么时候用 |
|---|---|---|---|---|
htdemucs | 4 | 基准速度(默认) | 没有特别说明 | 第一次处理、批量任务,以及更看重吞吐量的场景 |
htdemucs_ft | 4 | 约慢 4 倍 | “可能会好一点” | 给真正重视的歌曲做最终导出 |
htdemucs_6s | 6 | 介于两者之间 | 吉他表现“还可以”;钢琴“效果不太好”,会有“大量串音和伪影” | 确实需要吉他音轨,并且能接受不够干净的结果 |
hdemucs_mmi | 4 | 基准速度 | v3 架构,重新训练 | 当 v4 在某首混音上表现异常时,用来做 A/B 对比 |
mdx / mdx_extra | 4 | 基准速度 | mdx_extra 的训练数据包含 MUSDB 测试集 | 较早期的素材,或不喜欢 v4 伪影时 |
mdx_q / mdx_extra_q | 4 | 最快、体积最小 | “音质可能会略差” | 存储空间有限的机器,以及快速预览 |
需要特别留意 htdemucs_ft 这个模棱两可的表述:它要消耗约 4 倍计算资源,但作者本人也只是说效果“可能会好一点”。放到 CPU 上,这个代价非常明显,用户也确实反复提到这一点。
9.00 dB 和 9.20 dB SDR,实际测的不是一回事
这两个数字出现在 README 的同一段里,但不能混为一谈。Hybrid Transformer Demucs 在 MUSDB HQ 测试集上的成绩是9.00 dB SDR。更高的9.20 dB需要稀疏注意力内核和按音源进行微调,而且 README 明确写道,这个稀疏模型“目前没有提供,因为它需要尚未准备好发布的自定义 CUDA 代码”。
所以,任何可以直接下载的模型都无法复现 9.20 dB。在 README 自己的对比表中,已经发布的 v4 微调版本整体 SDR 为 9.0,与使用 1.7k 首混音训练的 Band-Split RNN 持平。
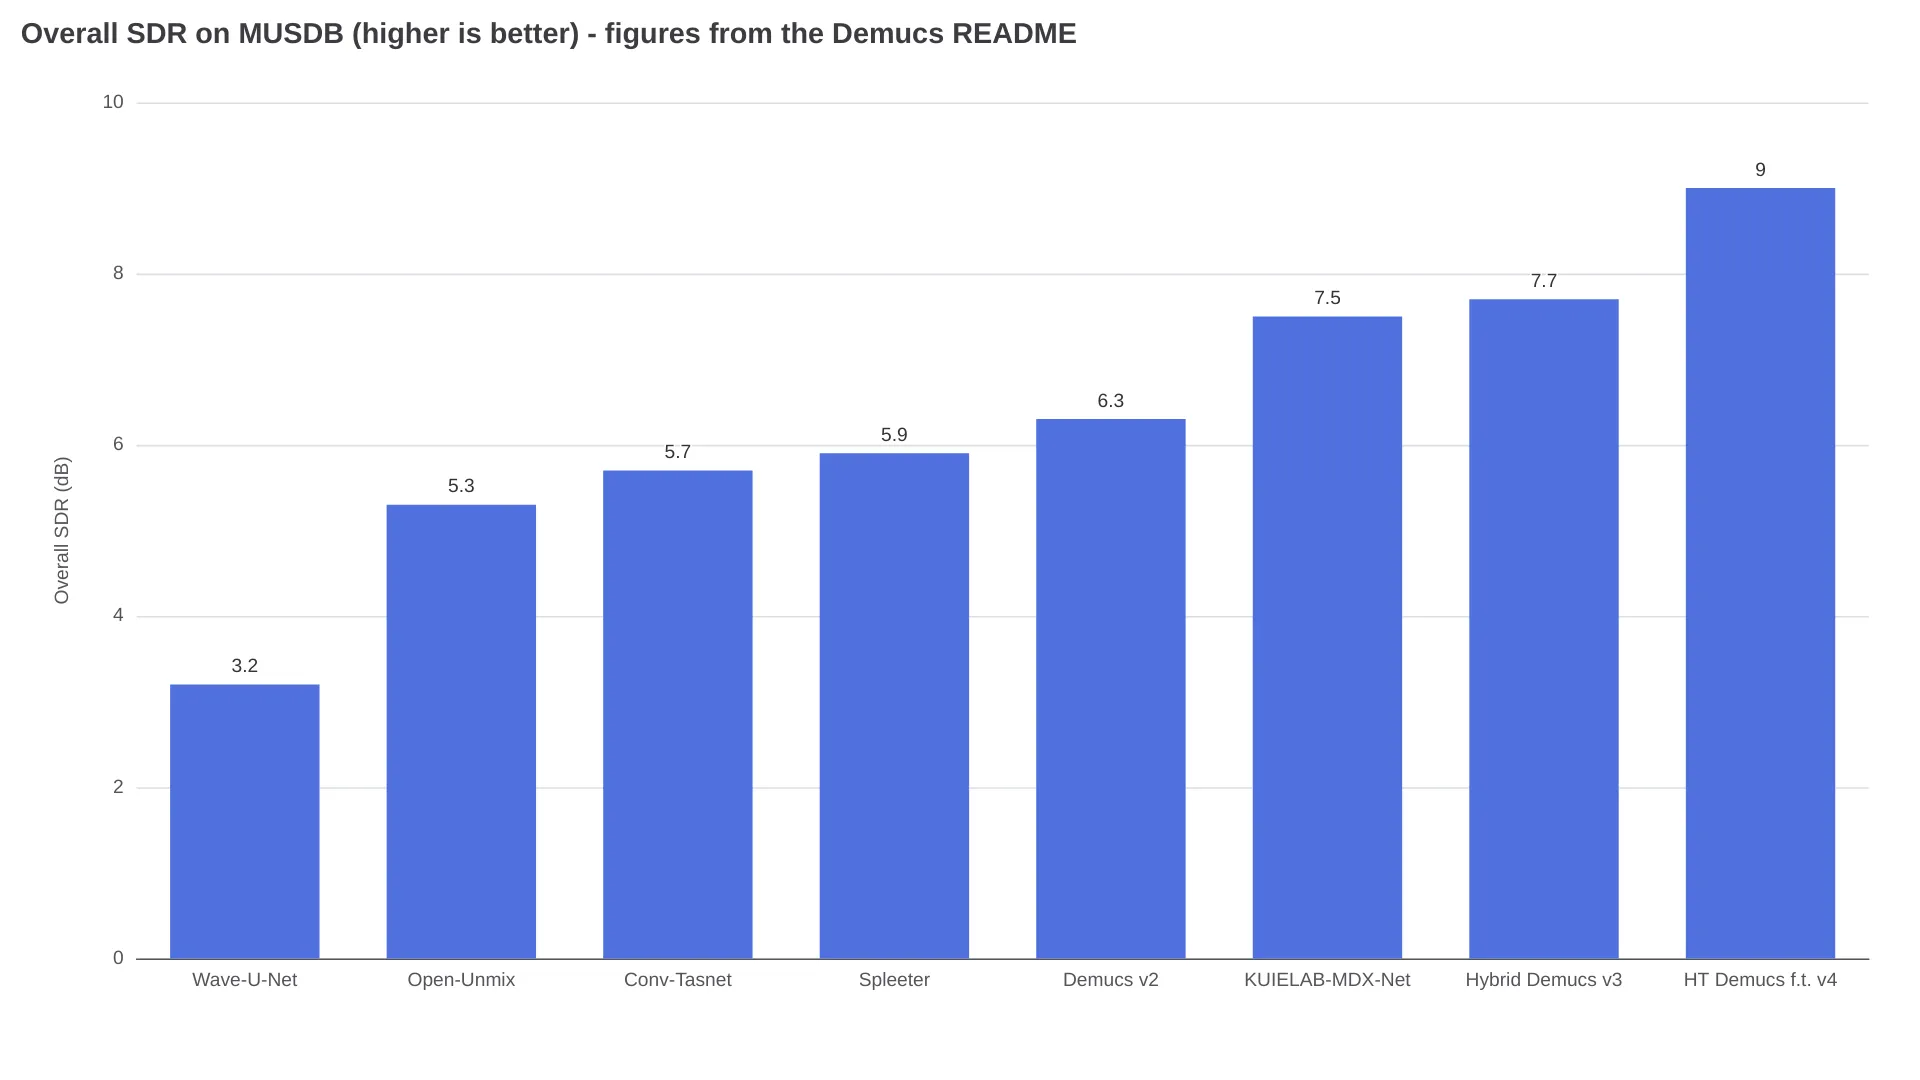
同一张表里,尽管 Spleeter 使用了 2.5 万首歌曲进行训练,成绩仍然只有 5.9 dB;与微调版 v4 相比,大约落后 3 dB。
真正会改变输出结果的参数
大多数 Demucs 任务其实只需要做三个决定:要分出多少条音轨、愿意投入多少计算资源,以及最终输出什么格式。
--two-stems=vocals会进入卡拉 OK 模式,输出vocals.wav和no_vocals.wav。它仍然会先完成完整混音的分离,再进行混音下混,因此相比普通运行既不会更快,也不会更省内存。--shifts=N会对随机平移后的输入进行 N 次预测并取平均,代价是预测速度变为原来的 N 分之一。README 的建议很直接:“除非你有 GPU,否则不要用。”论文使用了 10 次平移;Replicate 托管版本的默认值是 1。--overlap默认值为 0.25,降到 0.1 可以换来一点速度提升。--segment N是解决显存不足的关键参数,但这里有个很容易让照抄命令失效的细节:Hybrid Transformer 模型支持的最大分段长度是 7.8 秒,因此较长的--segment值只对非 HT 模型有作用。- 输出参数包括
--mp3(默认 320 kbps)、--flac(需要 ffmpeg)、--int24和--float32。默认输出是 44.1 kHz、int16 编码的 WAV,保存路径为separated/MODEL_NAME/TRACK_NAME。 --clip-mode的影响比看起来更大:Demucs 默认会缩放各条音轨以避免削波,但这可能破坏音轨之间的相对音量;使用clamp则会改为硬限幅。
同一份文档给出的硬件要求是:至少 3 GB 显存,默认参数大约需要 7 GB。如果显存只有 3 GB 或更少,就使用 --segment 8,并设置 PYTORCH_NO_CUDA_MEMORY_CACHING=1。CPU 运行时,“处理时间大约应为歌曲时长的 1.5 倍”。考虑到用户使用 htdemucs_ft 时反馈的速度,这个估算显得相当乐观。
Demucs 最容易串音的地方,以及用户常用的两遍处理
串音是用户反复提到的问题,尤其当人声与主奏乐器处在相近音域时更加明显。Ryan Herr(@rrherr)在一次提取后说得很直白:
demucs let a lot of sax bleed into the 'vocals' track.
有经验的用户最后往往不会继续调整某个参数,而是改用第二个模型。日本制作人夜凪P(@yonagip,145 个赞)介绍过一种做法:先在 UVR5 中用 MelBand Roformer 把人声和伴奏分开,再只把伴奏送进 htdemucs_ft,继续拆出鼓、贝斯和其他音轨:
Demucs単体だとVoが他に漏れるんだけど (with Demucs alone, the vocals leak into the other stems)
另外两份用户反馈也指向同一个结论:一位制作人表示 htdemucs_ft 的贝斯定义更好,但 CPU 处理速度慢了 4 倍(@hachi_vm);另一位则发布了吉他提取对比,结果显示 htdemucs-6s 明显输给 BS-RoFormer 模型(@junon_12)。这些都是用户个案,不是严格基准测试,但与官方说法一致:Défossez 在 2022 年 12 月宣布六源模型时,就提到观察到了“一些串音和伪影”。
实用结论:如果素材里有萨克斯、主音吉他,或者正在演奏旋律的钢琴,那么 Demucs 单次处理的结果更适合当作起点,而不是最终交付版本。如果需要第二遍处理,可以通过 UVR5 界面使用 Roformer 系列替代模型。
不安装 Demucs,直接把它当 API 调用
如果不想配置 Python 环境,一个使用广泛的托管版本是 cjwbw/demucs on Replicate:运行在 Nvidia T4 硬件上,累计运行次数约 150 万次。页面给出的估算是每次运行约 0.020 美元(1 美元约可运行 50 次),预测通常能在 90 秒内完成。
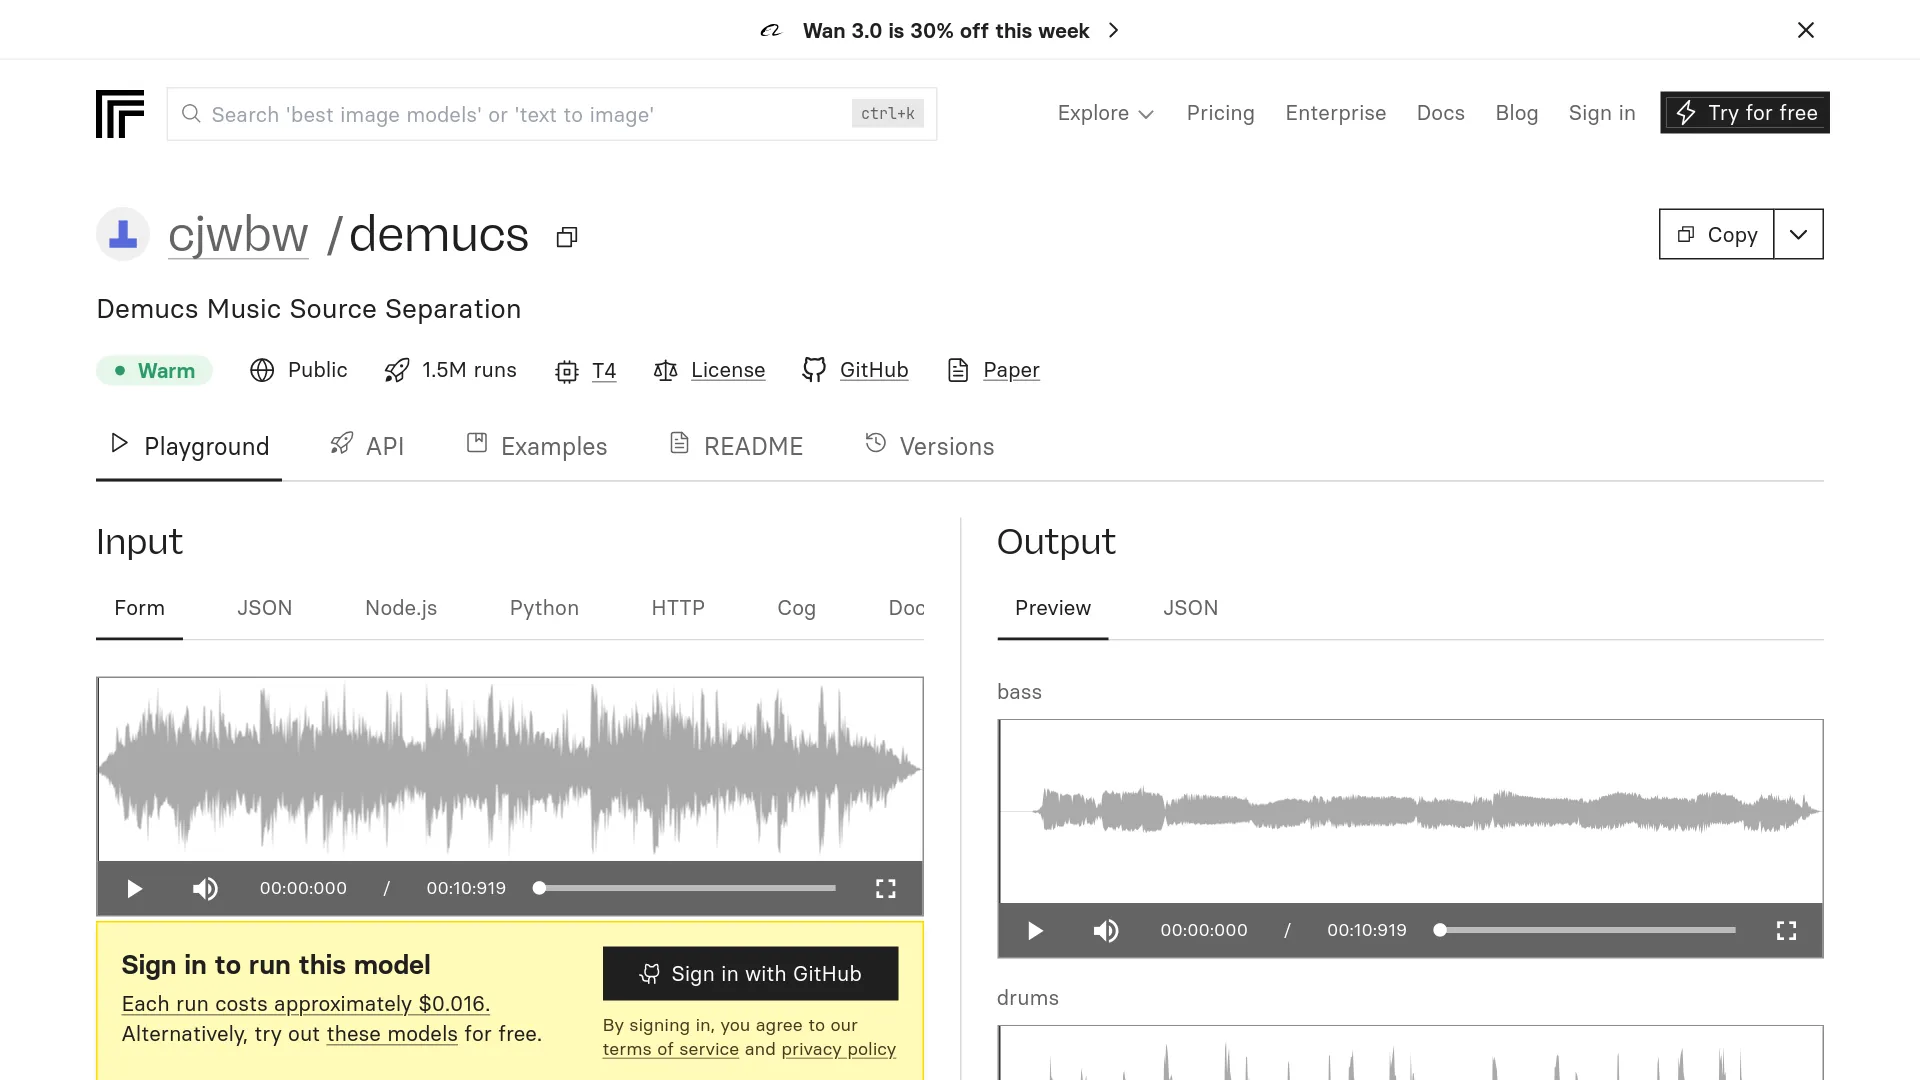
它的输入参数基本对应命令行:model_name(默认 htdemucs)、stem、shifts(默认 1)、overlap(0.25)、clip_mode(rescale)、mp3_bitrate(320)、float32、output_format(mp3)。
不过,这个页面不会主动提醒你一个限制:它的最新版本大约已经是 3 年前的版本,而托管端点固定使用某个快照。你调用的是那个版本,而不是 2026 年 7 月发布的 v4.1.0 打包与依赖更新。运行时间也可能比页面上的 headline 数字长很多;同一模型就有一个公开示例耗时 6 分 18 秒。
一首 4 分钟歌曲,实际要花多少钱
真正会决定工作流的,是每首歌的处理成本,而这个成本取决于一个很多人订阅后才发现的计费细节。
LALAL.AI 按照文件时长 × 选择的音轨分离类型数量计算用量。一首 4 分钟的歌曲如果拆成 4 条音轨,消耗的是 16 分钟,而不是 4 分钟。
同一价格页面列出了一次性充值方案(截至 2026 年 9 月 25 日核对):50 美元购买 750 分钟 Fast Queue,190 美元购买 3,000 分钟,300 美元购买 5,000 分钟。按这个价格计算,一首 4 分钟歌曲进行 4 音轨分离,成本约为 0.96 至 1.07 美元。
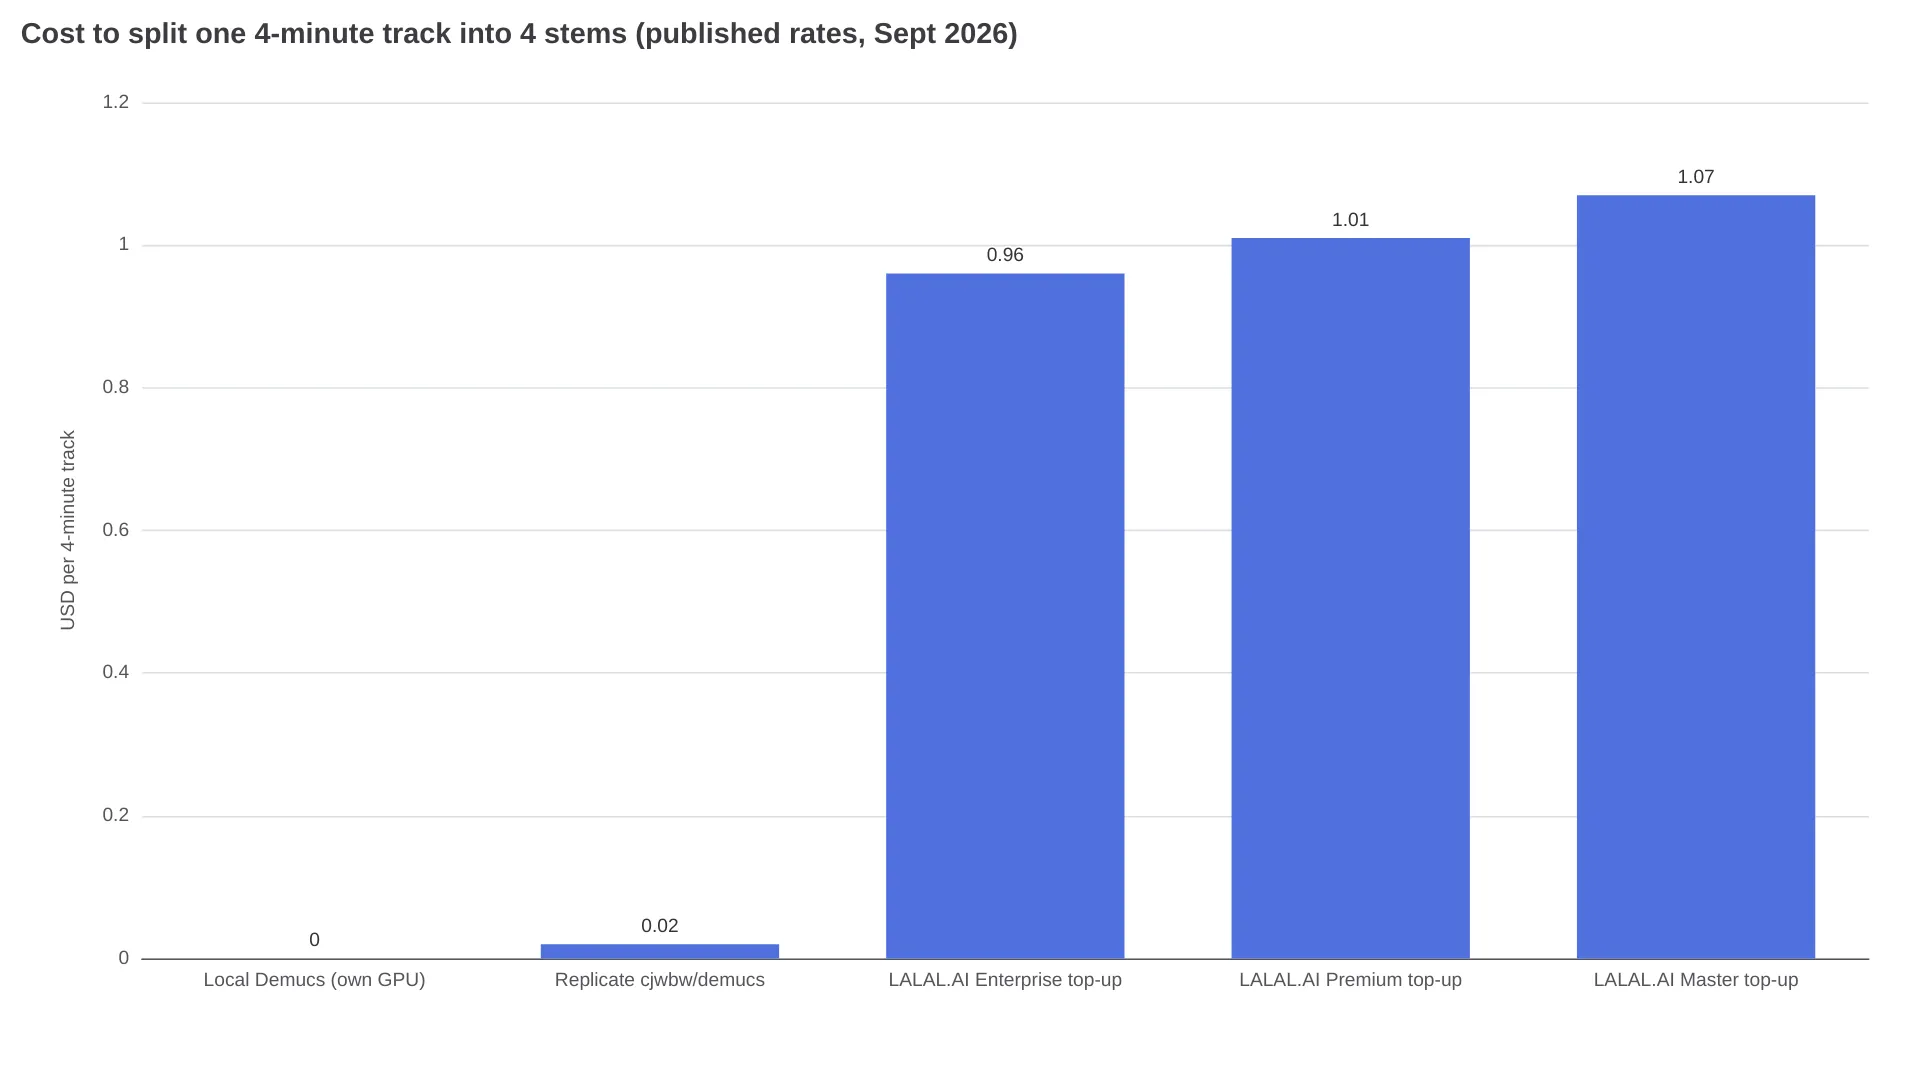
解读这张图时要注意一个修正:LALAL.AI 的这些数字对应的是优先处理价格。付费套餐包含不限量的 Relaxed Queue 分钟数,而且官方表示两种队列“提供完全相同的分离质量”。Fast Queue 买到的只是更短的等待时间。
| 套餐 | 价格 | 包含内容 | 主要限制 |
|---|---|---|---|
| LALAL.AI Starter | 免费 | 10 分钟 Relaxed Queue | 上传文件上限 200 MB |
| LALAL.AI Lite | €6.75/月,按年计费 €81 | 不限量 Relaxed,90 分钟 Fast | 不支持批处理、VST 或 API;分钟数不结转 |
| LALAL.AI Pro | €13.50/月,按年计费 €162 | 不限量 Relaxed,250 分钟 Fast | 唯一支持 API、VST 插件和批处理的套餐 |
| Moises | 未公开发布 | 免费套餐,每月上传次数有限 | 价格表需要登录后查看;宣称支持 27 种音轨类型 |
Replicate cjwbw/demucs | 约 0.020 美元/次运行 | T4,通常低于 90 秒 | 版本固定在约 3 年前 |
| 本地 Demucs | 免费(MIT 许可证) | 不限量、离线处理 | 需要投入自己的 GPU 时间和配置精力 |
Lite 套餐的 90 分钟 Fast Queue,每月大约只能覆盖 5 首 4 音轨歌曲,之后就会转入 Relaxed Queue。如果每周处理的歌曲超过几首,按分钟付费很快就不划算了;而这恰好也是安装 Demucs、花一个下午完成配置开始产生价值的使用量级。
不同需求,该选哪条路
| 你的情况 | 推荐方案 | 理由 |
|---|---|---|
| 偶尔分离,没有 GPU,也不想用终端 | LALAL.AI Starter,之后再考虑 Lite | 10 分钟免费额度可以先测试效果,不必立即付费 |
| 扒歌练习,以手机为主 | Moises | 支持 27 种音轨类型,还有速度和和弦工具;价格需要登录后确认 |
| 处理量大,自己有 GPU | 使用 htdemucs 运行 uvx demucs | 边际成本为零、运行次数不限,素材无需离开本机 |
| 一首重要歌曲的最终导出 | htdemucs_ft,在 GPU 上使用 --shifts 2 | 用 4 倍计算资源换取最后一点质量提升 |
| 需要吉他音轨 | 先用 htdemucs_6s,再在 UVR5 中与 Roformer 系列模型对比 | 官方文档也承认六源模型存在串音 |
| 未发布或受 NDA 保护的素材 | 只用本地 Demucs | 无需上传,MIT 许可证,支持离线处理 |
| 应用后端,没有运维预算 | Replicate cjwbw/demucs | 约 0.020 美元/次运行,不需要维护 GPU 基础设施 |
Demucs 音轨分离常见问题
哪个 Demucs 模型的人声效果最好?
htdemucs_ft 是已发布的四源模型中人声表现最强的选择,处理时间约为 htdemucs 的 4 倍。对于复杂混音,用户反馈更好的做法是两遍处理:先用 Roformer 系列模型分离人声,再用 Demucs 拆分伴奏中的其他音轨。
Demucs 能分离吉他和钢琴吗?
只能通过 htdemucs_6s 尝试。官方 README 在快速测试中将吉他质量描述为“还可以”,并称钢琴源“效果不太好”,会出现“大量串音和伪影”。
运行 Demucs 一定需要 NVIDIA GPU 吗?
不需要。CPU 可以配合 -d cpu 使用,文档估计处理时间约为歌曲时长的 1.5 倍。Apple Silicon 用户可以传入 -d mps。GPU 加速至少需要 3 GB 显存,默认参数大约需要 7 GB。
为什么分离后的音轨重新混合,无法还原原始混音?
为了避免分离伪影造成削波,Demucs 会对每条音轨重新缩放,这可能破坏音轨之间的相对音量。可以使用 --clip-mode clamp 改用硬削波,或者在处理前先降低输入混音的音量。
Demucs 会把音轨保存在哪里?
默认路径为 separated/MODEL_NAME/TRACK_NAME/,保存为 44.1 kHz、int16 编码的立体声 WAV 文件:drums.wav、bass.wav、other.wav 和 vocals.wav。如果指定了 MP3、FLAC、int24 或 float32 输出,格式则会相应变化。
如何解决 CUDA out-of-memory 错误?
降低 --segment(3 GB 显卡的文档建议下限是 8),设置 PYTORCH_NO_CUDA_MEMORY_CACHING=1,或者退回使用 -d cpu。还要记住,Hybrid Transformer 模型的分段长度上限是 7.8 秒,因此把数值调到更高,对这些模型不会产生任何效果。