 AIREITER
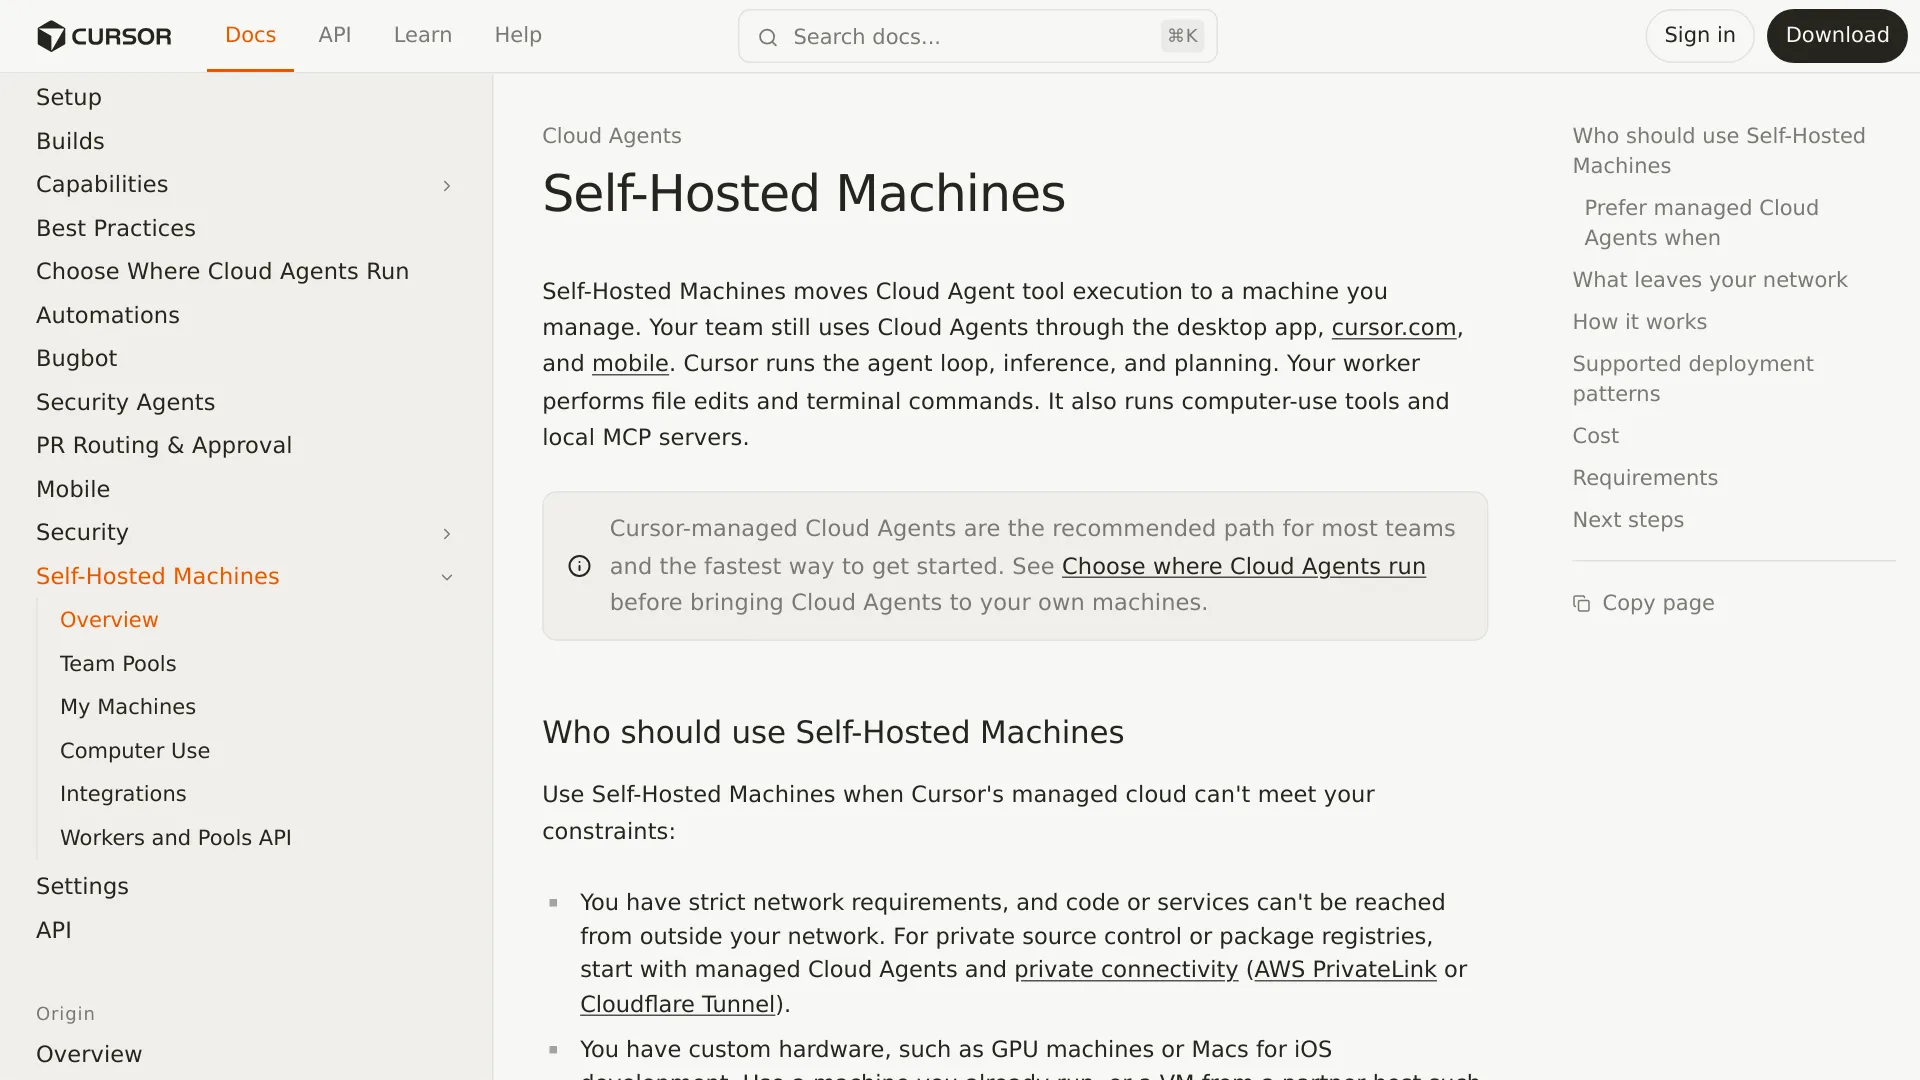
Worker 即使部署在防火墙之后,仍可能把源代码片段、终端输出、代码差异和截图发送给 Cursor。Cursor Self-Hosted Machines 自托管的是任务执行环境,并不是自托管 Agent,也不是与外部网络隔离的 Cursor 部署。
本文重点分析哪些数据会跨越边界,以及各项控制措施究竟能改变什么。内容参考了 Cursor 于 September 2, 2026 announcement、Self-Hosted Machines documentation 和 data-use policy。
先用一张表看懂数据边界
Cursor 会把一次 Cloud Agent 任务拆分到云端和由你管理的 Worker 上执行。“Self-Hosted”描述的是执行位置,并不代表所有系统和数据路径都在你的环境内。
| 数据或系统 | 运行或存放位置 | 是否可能触达 Cursor | 相关控制或限制 |
|---|---|---|---|
| Agent 循环、推理与规划 | Cursor 云端 | 本来就在 Cursor | 不会因 Self-Hosted Machines 转移到你的环境。 |
| 文件修改与终端命令 | 你的 Worker | 执行结果可能返回 | 由 Worker 执行这些工具操作。 |
| 完整代码检出目录与构建缓存 | 你的 Worker | 不会自动传输 | 完整工作副本保留在本地。 |
| 机器本地凭据 | 你的 Worker | 不会自动传输 | 不要让机密出现在命令、输出或构建产物中。 |
| 文件内容与代码差异 | 先在你的 Worker,再进入 Agent 上下文或结果 | 会,在需要时传输 | Privacy Mode 针对的是训练使用,而不是数据传输。 |
| 终端输出与本地 MCP 结果 | 先在你的 Worker,再作为工具结果返回 | 会,在返回时传输 | 结果中可能包含代码或敏感数据。 |
| 截图与桌面串流 | 先在你的 Worker,再在生成或共享时传给 Cursor | 会 | Computer-use 会话可以串流 Agent 桌面。 |
| 视频、截图与日志引用 | Cursor 管理的产物存储 | 会,默认如此 | 阻断产物存储主机即可禁用上传。 |
| 使用 API Key 发起的模型请求 | Cursor 的处理链路 | 会 | BYOK 不会绕过 Cursor 后端。 |
关键区别其实很简单:完整代码仓库可以留在你的机器上,但仓库中的部分上下文仍可能为了推理而跨网络传输。这是对执行位置的部分控制,不代表完全禁止出站数据。
Cursor 到底把哪些东西放到了你的基础设施上
Self-Hosted Machines 把工具执行转移到客户控制的机器上。Worker 可以修改文件、运行命令、访问内部服务、操作浏览器,还能连接本地 MCP 服务器。至于 Agent 循环、推理、规划和会话编排,仍然由 Cursor 云端负责。
Worker 通过 Cursor CLI 命令 agent worker start 启动,并与 Cursor 建立一条长期保持的出站 HTTPS 连接。Cursor 表示,这条连接由 Worker 主动向外发起,因此不需要开放入站端口、不需要公网 IP,也不需要 VPN 隧道。
官方文档描述的会话流程如下:
- 用户在 Cursor 界面中启动 Cloud Agent 会话。
- Cursor 云端的 Agent 循环规划下一步操作。
- Cursor 通过 Worker 连接发送工具调用。
- Worker 执行命令、文件修改、浏览器操作或 MCP 操作。
- Worker 返回结果,供下一轮推理使用。
Worker 仍需要访问 api2.cursor.sh 和 api2direct.cursor.sh;CLI 更新以及部分 computer-use 配置还可能需要访问 downloads.cursor.com。仅允许出站连接可以避免外部主动访问你的网络,但这并不意味着 Worker 变成了离线模型运行环境。
Cursor 将这种架构定位于几类场景:私有代码仓库或托管 Worker 无法访问的服务,需要 GPU 或 Mac 等专用硬件,以及自定义操作系统或构建镜像。如果你的唯一需求是访问私有网络,Cursor 的 runtime decision guide 建议优先考虑带访问控制列表的托管 Cloud Agents、类似 Tailscale 的网络方案、AWS PrivateLink 或 Cloudflare Tunnel。
哪些数据会离开 Worker,Privacy Mode 又改变了什么
Cursor 文档明确列出了 Worker 可能发送的数据,包括文件内容、终端输出、代码差异、截图、本地 MCP 结果以及路由元数据。评估隐私时要分开看三个问题:传输了什么、是否会用于训练,以及会保留多久。
Privacy Mode 管的是训练,不是出站传输
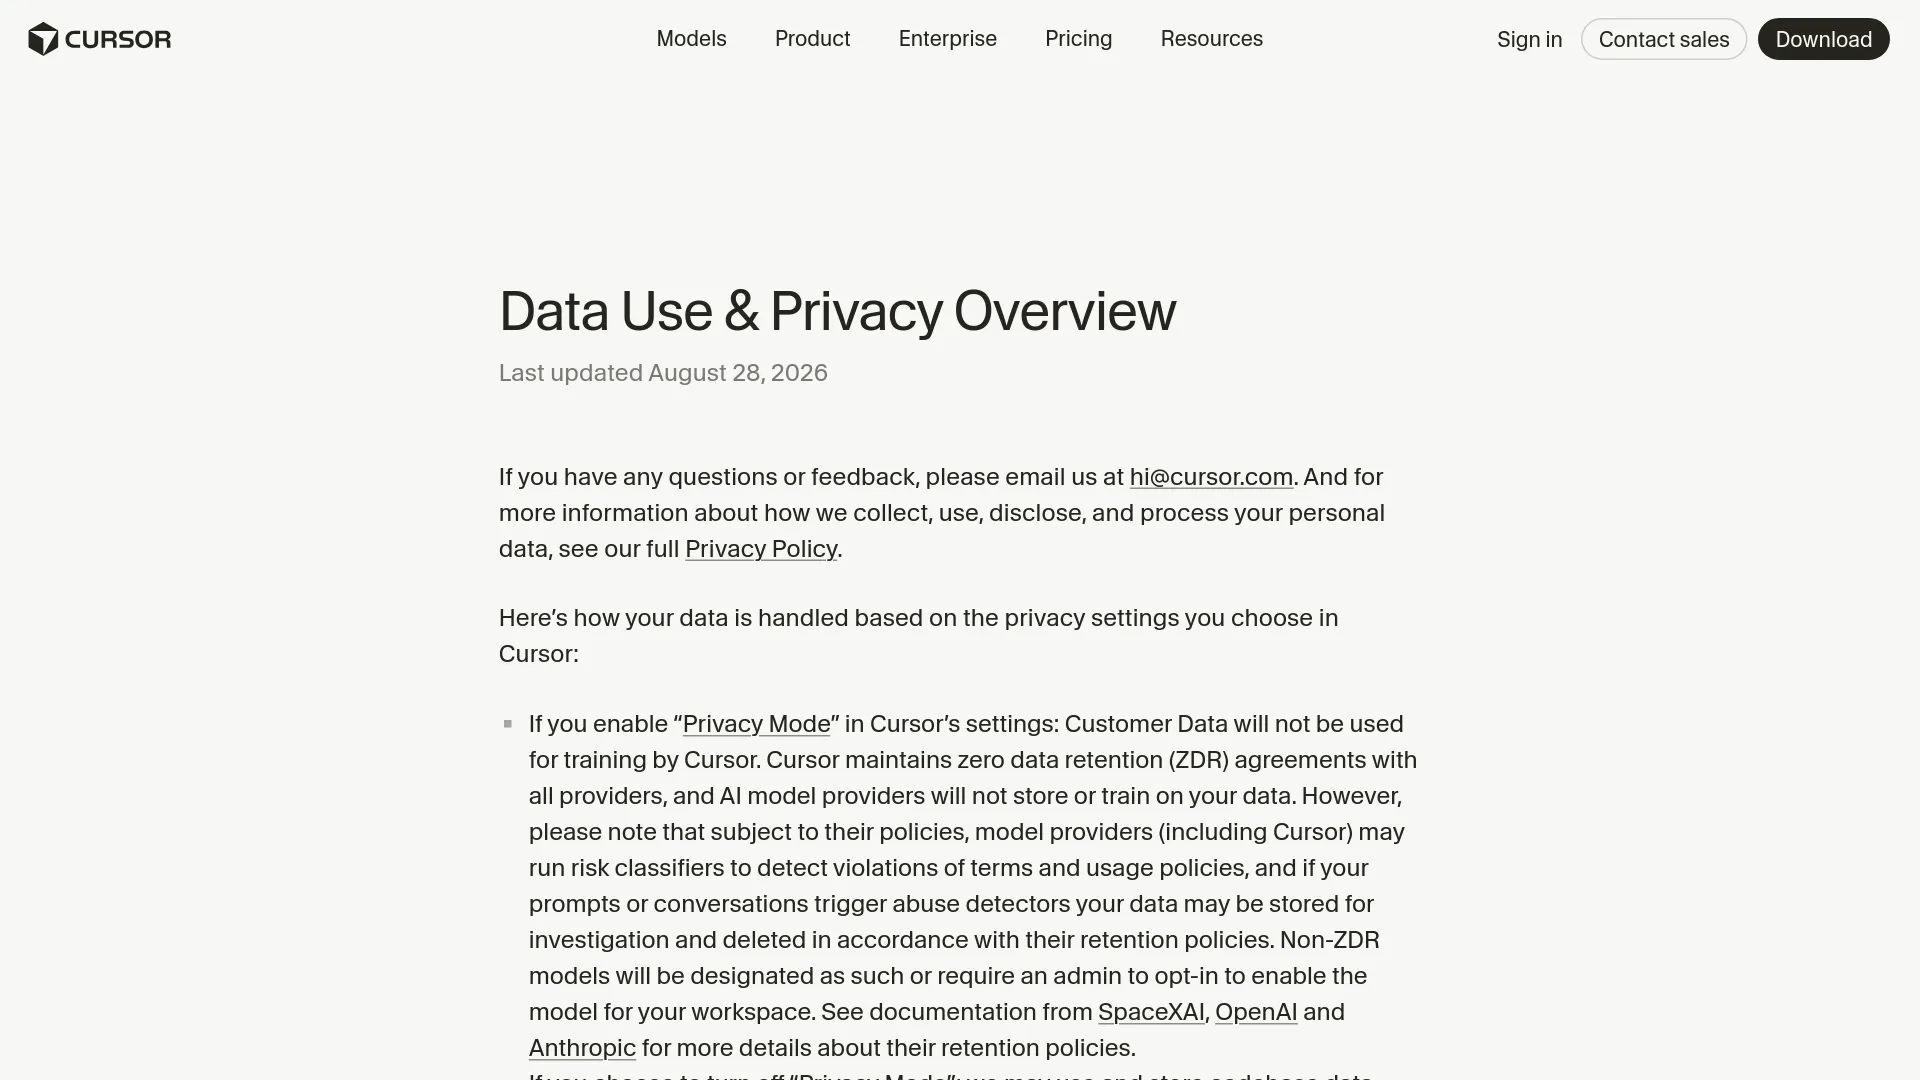
Cursor 的 Data Use & Privacy Overview 于 August 28, 2026 更新。页面称,Privacy Mode 会阻止 Cursor 将 Customer Data 用于训练,并表示 Cursor 已与服务提供商签订零数据保留协议。但同一页面也给出了限定条件:风险分类器可能为了调查问题而保留提示词或对话,系统也可能出于降低延迟和提升网络效率的原因临时缓存文件。
Cursor 表示,缓存文件会使用由客户端生成的密钥加密,而密钥会在请求处理期间保存在 Cursor 服务器上。这是 Cursor 对数据保留和保护方式的说明,并不能证明请求从未到达 Cursor 服务器。
API Key 的细节同样值得注意。Cursor 明确表示,使用自己的服务商 API Key不会绕过其后端,因为请求仍会经过 Cursor,由 Cursor 完成最终提示词构建。BYOK 可以改变模型调用由谁授权,但不能被理解为一条从客户端直达模型服务商的隐私通道。
一位真实用户在评测这一功能时,也指出了同样的架构区别:
“一个重要边界:Cursor 的自托管机器转移的是执行环境,而不是整个 Agent。Cursor 表示,推理和规划仍留在其云端;工具输出会传回去,而且可能包含代码。进行安全评审时,应把它视为自托管执行,而不是自托管 Agent。” — @ham_zax,X
关闭产物上传,也不等于建立数据隔离带
Cursor 提供了一种范围比较窄的方式来阻止产物上传:阻断发往 cloud-agent-artifacts.s3.us-east-1.amazonaws.com 的出站 HTTPS 流量。工具调用和工具结果仍然可以正常工作,但截图、视频和日志引用不会出现在 Pull Request 或 Cursor 控制台中。
如果组织根本不需要视觉产物,这个设置很有用。但它不是完整的隐私方案,因为文件内容、终端输出、代码差异、推理过程中使用的截图以及 MCP 结果,仍可能通过 Agent 会话连接返回。
MCP 的传输方式也会带来一个容易被忽略的区别。Cursor 的 Team Pools documentation 表示,基于命令或 stdio 的 MCP 服务器运行在 Worker 上,可以访问私有网络;HTTP/SSE MCP 服务器则由 Cursor 后端负责 OAuth、会话缓存和认证。因此,评估私有 MCP 端点时,不能只看主机在哪里,还必须审查其传输方式。
按实际约束选择运行时,别被名称带偏
Cursor 提供三种运行时选择。只有当执行边界、硬件或运行环境是明确写入要求,而不是个人偏好时,自托管才是更合适的方案。
| 运行时 | 工具调用在哪里执行 | 适合场景 | 主要责任 |
|---|---|---|---|
| Cursor-managed Cloud Agents | 由 Cursor 管理的隔离 VM | 大多数能够使用托管网络和标准 Ubuntu 环境的团队 | 在你完成环境配置后,Cursor 负责 VM 生命周期、容量、隔离和任务结束后的销毁。 |
| My Machines | 个人用户的笔记本、开发机、Mac 或 VM | 个人工作流、带本地状态的代码仓库,或快速概念验证 | 你负责在线状态、凭据、依赖、清理工作以及代码检出目录。 |
| Team Pools | 由组织管理的 Worker | 企业级 Worker 集群、GPU、Mac、Kubernetes、基于标签的路由和集中式容量管理 | 你的团队负责主机、镜像、密钥、扩缩容、监控、重置和故障处理。 |
如果只是需要访问私有服务,优先考虑托管 Cloud Agents
如果组织可以通过代码仓库权限、网络访问列表、类似 Tailscale 的客户端或受支持的私有连接来定义边界,那么托管 Cloud Agents 可能已经够用。Cursor 的 runtime guide 建议大多数团队使用托管基础设施,并将其描述为运维成本更低的路径。
这样可以省去维护 Worker 集群的工作,同时保留 Cursor 托管的 VM 生命周期管理和弹性并发能力。当然,这并不意味着托管 Agent 不会处理数据;区别在于,执行环境由 Cursor 而不是你的团队负责运维。
单人使用、环境高度可控时,选择 My Machines
My Machines 会把一台个人机器连接到单个 Cursor 账户。对于已经配置好 Mac、开发机或远程 VM 的开发者来说,这种方式很实用,尤其是机器上已有本地依赖和网络访问能力,不必再花时间迁移到其他环境。
代价在于运维责任全部落到用户身上。活跃会话期间机器必须保持在线,用户还要负责清理工作、代码检出目录的新鲜度、磁盘状态、凭据和依赖修复。Cursor’s self-hosted documentation 表示,同一台机器可以运行多个 Agent,但这并不是集中式团队 Worker 集群模式。
只有当集群控制值得付出额外成本时,才选择 Team Pools
Team Pools 面向 Enterprise 团队,使用服务账户认证、共享 Worker 容量、标签和基于控制器的扩缩容。gpu 池可以把任务路由到 GPU 机器,ios 池则可以将任务路由到 Mac。Cursor 文档说明,每位用户最多可使用 200 个 Worker、每个团队最多可使用 1,000 个 Worker,更大规模的部署需要另行讨论扩容方案。
Pool 可以缩容到零,也可以使用持久化 Worker、容器化 Worker、Kubernetes Worker 或合作伙伴托管的 Worker。Cursor 表示,恢复已释放的工作区可能需要几分钟。这种灵活性适合突发型任务,但镜像管理、Worker 重置、容量规划、密钥轮换和监控等工作也会转移给客户。
成本不只是机器,还包括模型调用
Self-Hosted Machines documentation 和 Cursor Models & Pricing page 说明了模型、套餐和基础设施方面的责任,但没有列出单独的 Self-Hosted Machines Worker 费用。现有成本模式是:你仍需通过 Cursor 为所选模型付费,同时还要承担自己运行的机器、容器、集群、存储、网络、监控和运维成本。
因此,在没有特殊网络或硬件需求时,把自托管当作节省成本的方案并不成立。动态 Pool 和休眠机制或许能减少空闲算力,但盈亏平衡点取决于工作负载形态、启动时间以及需要重建多少状态;Cursor 没有公布一个适用于所有场景的统一数字。
启用前必须完成的安全评审清单
请让安全、平台或合规负责人逐项确认,不要因为产品名称里有“self-hosted”就直接视为通过评审。
- 先把边界要求写清楚。明确政策要求留在内网的是完整代码检出目录、工具执行、凭据、推理请求、产物,还是以上全部内容。Self-Hosted Machines 只会把执行 Worker 和完整本地状态置于你的控制之下。
- 对返回的上下文做数据分类。文件内容、代码差异、终端输出、截图和 MCP 结果都可能发送给 Cursor。需要测试这些输出是否可能包含源代码、客户数据、令牌、内部 URL 或生产环境响应。
- 有意识地启用 Privacy Mode。它改变的是 Cursor 声明的训练使用方式和服务商数据保留安排,并不能阻止请求处理、临时缓存或风险检测相关的数据处理。
- 正确理解 BYOK。根据 Cursor’s data-use page,API Key 请求仍会经过 Cursor 后端。
- 单独决定产物是否允许出站。根据是否接受 Pull Request 和控制台中的截图、视频及日志引用,决定是否允许访问
cloud-agent-artifacts.s3.us-east-1.amazonaws.com。如果防火墙支持,优先使用精确主机规则。 - 采用仅出站的访问列表。只允许访问文档中列出的 Cursor 端点,以及你明确启用的更新或 computer-use 主机。Worker 不应需要入站端口或公网 IP。
- 审查 MCP 传输方式。当 MCP 服务器必须访问私有服务时,使用 Worker 侧的 stdio MCP,同时评估返回结果。不要因为 HTTP/SSE MCP 服务本身是私有的,就默认它始终留在你的网络内。
- 隔离并重置 Worker。对于 Team Pools,要明确 Agent 之间如何擦除或重建机器、如何注入凭据,以及如何监控日志。Cursor 的guides and templates是参考架构,并不是完全托管的生产级 Worker 集群。
- 测试故障路径。确认 Cursor 端点、产物存储、Worker、私有镜像仓库或 MCP 服务器不可用时系统会如何表现。阻断产物主机,不等于阻断 Agent 会话。
- 隔离网络工作负载不要用它。如果要求模型上下文不得出站,或推理过程不能依赖第三方云服务,这种架构就不符合要求,因为 Agent 循环仍然运行在 Cursor 云端。
| 你的实际要求 | 决策 |
|---|---|
| 命令、本地状态或定制硬件必须在你的环境中运行 | 使用 Self-Hosted Machines,并配置上下文和产物的出站控制。 |
| Agent 需要访问私有服务,但执行可以在托管 VM 中完成 | 先从托管 Cloud Agents 和受支持的私有连接开始。 |
| 任何模型上下文都不能离开网络,或推理必须完全离线 | 放弃这套架构;它仍然依赖 Cursor 云端。 |
Cursor Self-Hosted Machines 隐私常见问题
Cursor Self-Hosted Machines 是完全自托管的吗?
不是。Cursor 仍会把 Agent 循环、推理、规划和编排放在云端。你的机器负责承载工具执行和本地工作状态。
源代码会离开自托管机器吗?
部分文件内容、代码差异、终端输出、截图和本地 MCP 结果,可能作为 Agent 的输入或工具结果离开 Worker。Cursor 表示,完整代码检出目录和构建缓存会留在 Worker 上,因此这是一条部分边界,而不是非黑即白的隔离线。
Privacy Mode 能阻止数据跨网络传输吗?
不能。Cursor 将 Privacy Mode 描述为:根据其公布的数据保留安排,阻止 Cursor 和模型服务商将数据用于训练。它不会阻止 Worker 发送推理所需的上下文。
BYOK 能绕过 Cursor 吗?
不能。Cursor 的 data-use 页面表示,使用 API Key 的请求仍会经过其后端,由后端完成最终提示词构建。不要把 BYOK 理解为从 Worker 直接连接模型服务商。
可以阻止截图和视频上传吗?
可以阻断发往 cloud-agent-artifacts.s3.us-east-1.amazonaws.com 的出站访问。工具执行仍会继续,但产物不会出现在 Pull Request 或 Cursor 控制台中。其他 Agent 会话数据仍可能返回给 Cursor。
Worker 需要配置入站防火墙规则或 VPN 吗?
Cursor 文档采用的是仅出站 HTTPS 模式。官方表示不需要入站端口、公网 IP 或 VPN 隧道,但 Worker 仍需能够访问文档中列出的 Cursor 端点,以及任务本身需要使用的其他服务。
个人账户或较低级别套餐可以使用 Team Pools 吗?
Cursor 文档将 Team Pools 定位为 Enterprise 功能,并要求使用服务账户 API Key。My Machines 才是面向个人的 Worker 选项;不要默认个人 API Key 可以启动 Team Pool Worker。
Cursor Self-Hosted Machines 可以完全离线运行吗?
不能。Agent 循环和推理仍然运行在 Cursor 云端,Worker 也需要出站连接。如果要求离线或与外部网络隔离,就需要采用另一种架构,在本地部署编排系统和模型推理。
如果团队需要由客户控制的执行环境、私有网络访问、定制硬件或持久化运行环境,可以考虑 Cursor Self-Hosted Machines。但如果你的要求是让 AI 流量完全不出云,就应该选择其他方案:这个功能改变的是命令在哪里执行,而不是 Agent 在哪里思考。