 AIREITER
2026 年 7 月 29 日,我们给 Claude Opus 5、GPT-5.6 Sol、Terra 和 Luna 发出了完全相同的四项任务。最终得到 16 份回答,全部正确。至少在这四个小型验证题上,准确率并不能帮你做出选择。
真正拉开差距的是两个会直接影响账单的指标:Opus 5 的输出计费 token 为 1,642,而 Sol 只有 480;输入超过 272,000 token 后,GPT-5.6 会切换到更高的长上下文价格档,Claude Opus 5 则在完整 1M 上下文窗口内保持统一费率。以 200K 输入、20K 输出的请求形态计算,两款旗舰模型的标价相差不到 7%;但输出量增加或跨过 272K 这条线后,差距会迅速扩大。因此,选谁主要取决于请求形态和模型行为。
四款模型,四道完全相同的题
我们为每个模型提供了相同的用户提示,任务包含四项可机械验证结果的检查:修复一个存在 bug 的 Python median 函数;统计固定字符串中字母出现的次数;计算时钟在 3:15 时形成的 7.5 度夹角;以及在不改变行为的前提下,重构一段刻意写得很乱的 JavaScript 函数。代码类回答均通过边界案例实际执行验证,而不是仅凭肉眼判断。
四款模型全部通过了全部检查。Python 修复方案都正确处理了偶数长度列表;所有模型都给出了正确答案 9 和 7.5;四份重构代码也都通过了行为差异测试,其中包括 falsy 字段和 null 分类筛选器。
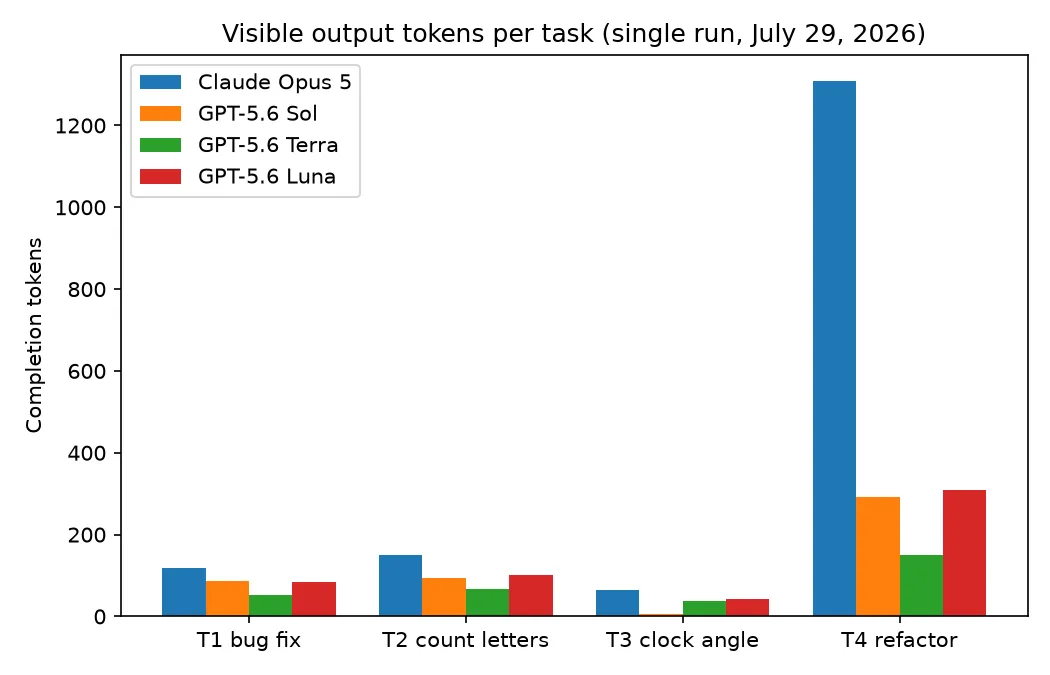
引用这些数字前,需要先说明三个限制。首先,每个模型、每项任务只跑了一次,这是一轮冒烟测试,不是完整基准测试。其次,请求经由一个会注入自身系统提示词的网关发送,因此各请求的输入 token 在 35 到 4,415 之间波动,我们完全排除了这部分数据。最后,两家厂商都会将隐藏推理 token 按输出计费,因此这里的“输出 token”指的是你实际付费的 token,而不是你能看到的文本。
在全部打平的结果中,仍有一项定性差异:Opus 5 给出了四者中最好的重构版本。它把原代码的两个循环合并为一次遍历,将 1.2 倍数提取为具名常量,还保留了一条注释,说明为何有意使用宽松相等比较以维持原有行为。Sol、Terra 和 Luna 的结果同样正确,但更像是对原先双循环结构的直接改写。
比的不是对错,而是 token 和耗时
16 次运行的正确率完全一致,因此实际比较重点转向每个答案的成本。Opus 5 完成四项任务共用时 32.4 秒,计费 1,642 个 completion token。Sol 用时 19.7 秒、480 token;Terra 为 11.7 秒、308 token;Luna 为 15.3 秒、537 token。
| 单次运行,2026 年 7 月 29 日 | 正确 | 输出 token | 总耗时 | 仅输出成本 |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1,642 | 32.4s | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19.7s | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11.7s | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15.3s | $0.0032 |
差距来自推理量,而不是最终答案的篇幅。Opus 5 在重构任务中,最终答案只有 492 bytes,却计费了 1,308 token;回答“7.5”时,它用了 64 token,Sol 则只用了 7 token。Anthropic 文档指出,Opus 5 在 API 中默认采用 high effort,所以这部分差异来自默认设置,并不一定代表不可降低的固定特性;我们测量的是默认行为,而非成本下限。
社区数据也呈现出相同趋势。我们在 7 月 29 日检索时,Google 对该查询的首条结果是 r/Anthropic 上的一篇图表帖:两者的编程得分几乎持平,但 Opus 耗时更长、token 消耗显著更多。一位 r/ClaudeCode 用户的说法则更不客气:
GPT 5.6 Sol 会直接着手完成你交代的事。Opus 5 会先写出 12 卷本《战争与和平》,然后才去完成你交代的事。
不过,调整 effort 设置可能会改写这笔经济账。一位阅读 Artificial Analysis 数据的 Hacker News 评论者指出,high effort 的 Opus 5 每次 intelligence-index 运行成本约为 $1.06,而 max 设置下的 Sol 约为 $1.04;当两款模型都进行高强度推理时,成本已接近持平。
GPT-5.6 不是单一模型:Sol、Terra 与 Luna
GPT-5.6 并非一个单独的模型。OpenAI 提供三个 SKU,而不带后缀的 gpt-5.6,在官方文档中被定义为 gpt-5.6-sol 的别名,也就是三者里最贵的一档。配置中若写的是 gpt-5.6,实际会按该系列最高费率计费,做成本比较前值得先确认这一点。
OpenAI 的模型说明将 Sol 定位为“面向复杂专业工作的前沿模型”,Terra 定位为“兼顾智能与成本”的层级,Luna 则是“针对成本敏感型工作负载优化”。三者均拥有 1.05M-token 上下文窗口、128K 最大输出、2026 年 2 月 16 日的知识截止日期,以及从 none 到 max 的六档可选推理强度。
| 规格,核实于 2026 年 7 月 29 日 | Claude Opus 5 | GPT-5.6(全部三款) |
|---|---|---|
| 上下文窗口 | 1M tokens | 1.05M tokens |
| 最大输出 | 128K(通过 Batch API beta 可达 300K) | 128K |
| 可靠知识截止日期 | 2026 年 5 月 | 2026 年 2 月 16 日 |
| 推理控制 | 自适应思考,effort 默认值为 high | none / low / medium / high / xhigh / max |
| API ID | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
其中有两项规格会直接影响实际选择。Opus 5 的可靠知识截止日期是 2026 年 5 月,比整个 GPT-5.6 系列新三个月,对于涉及 2026 年春季发布内容的任务尤为重要。两者的推理控制也不只是档位数量不同:GPT-5.6 可以通过 none 完全关闭推理;Opus 5 则自适应地管理思考预算,并在此基础上提供 effort 档位。
价格分水岭:统一 1M 费率,对上 272K 阶梯
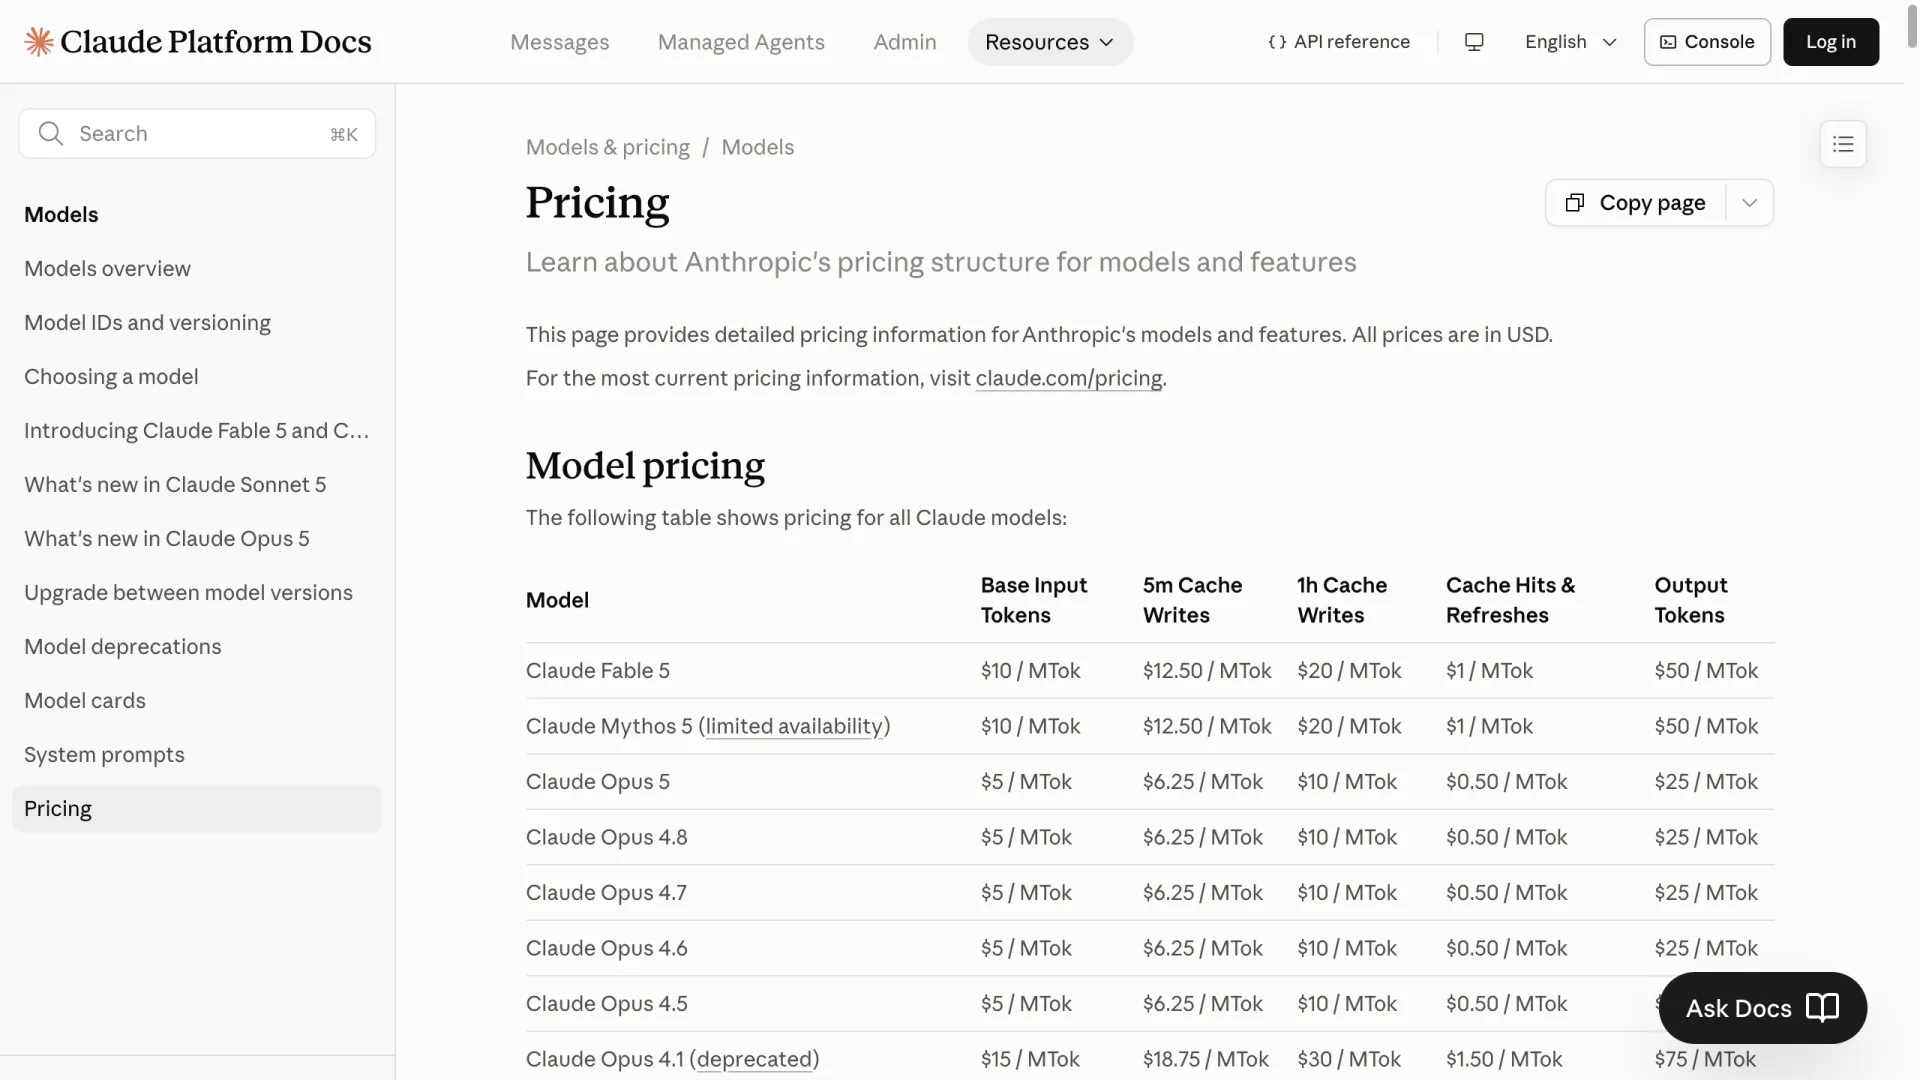
两家厂商都给出了清晰的按 token 计价。输入低于 272K token 时,旗舰模型的价格很接近:两者输入都是每百万 $5,Opus 5 输出为每百万 $25,Sol 为 $30;缓存输入均为 $0.50;Batch 均提供 50% 折扣。按这些费率,200K 输入、20K 输出的一次请求,Opus 5 成本为 $1.50,Sol 为 $1.60。
| 每 1M tokens,2026 年 7 月 29 日标价 | 输入 | 缓存输入 | 输出 | Batch |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
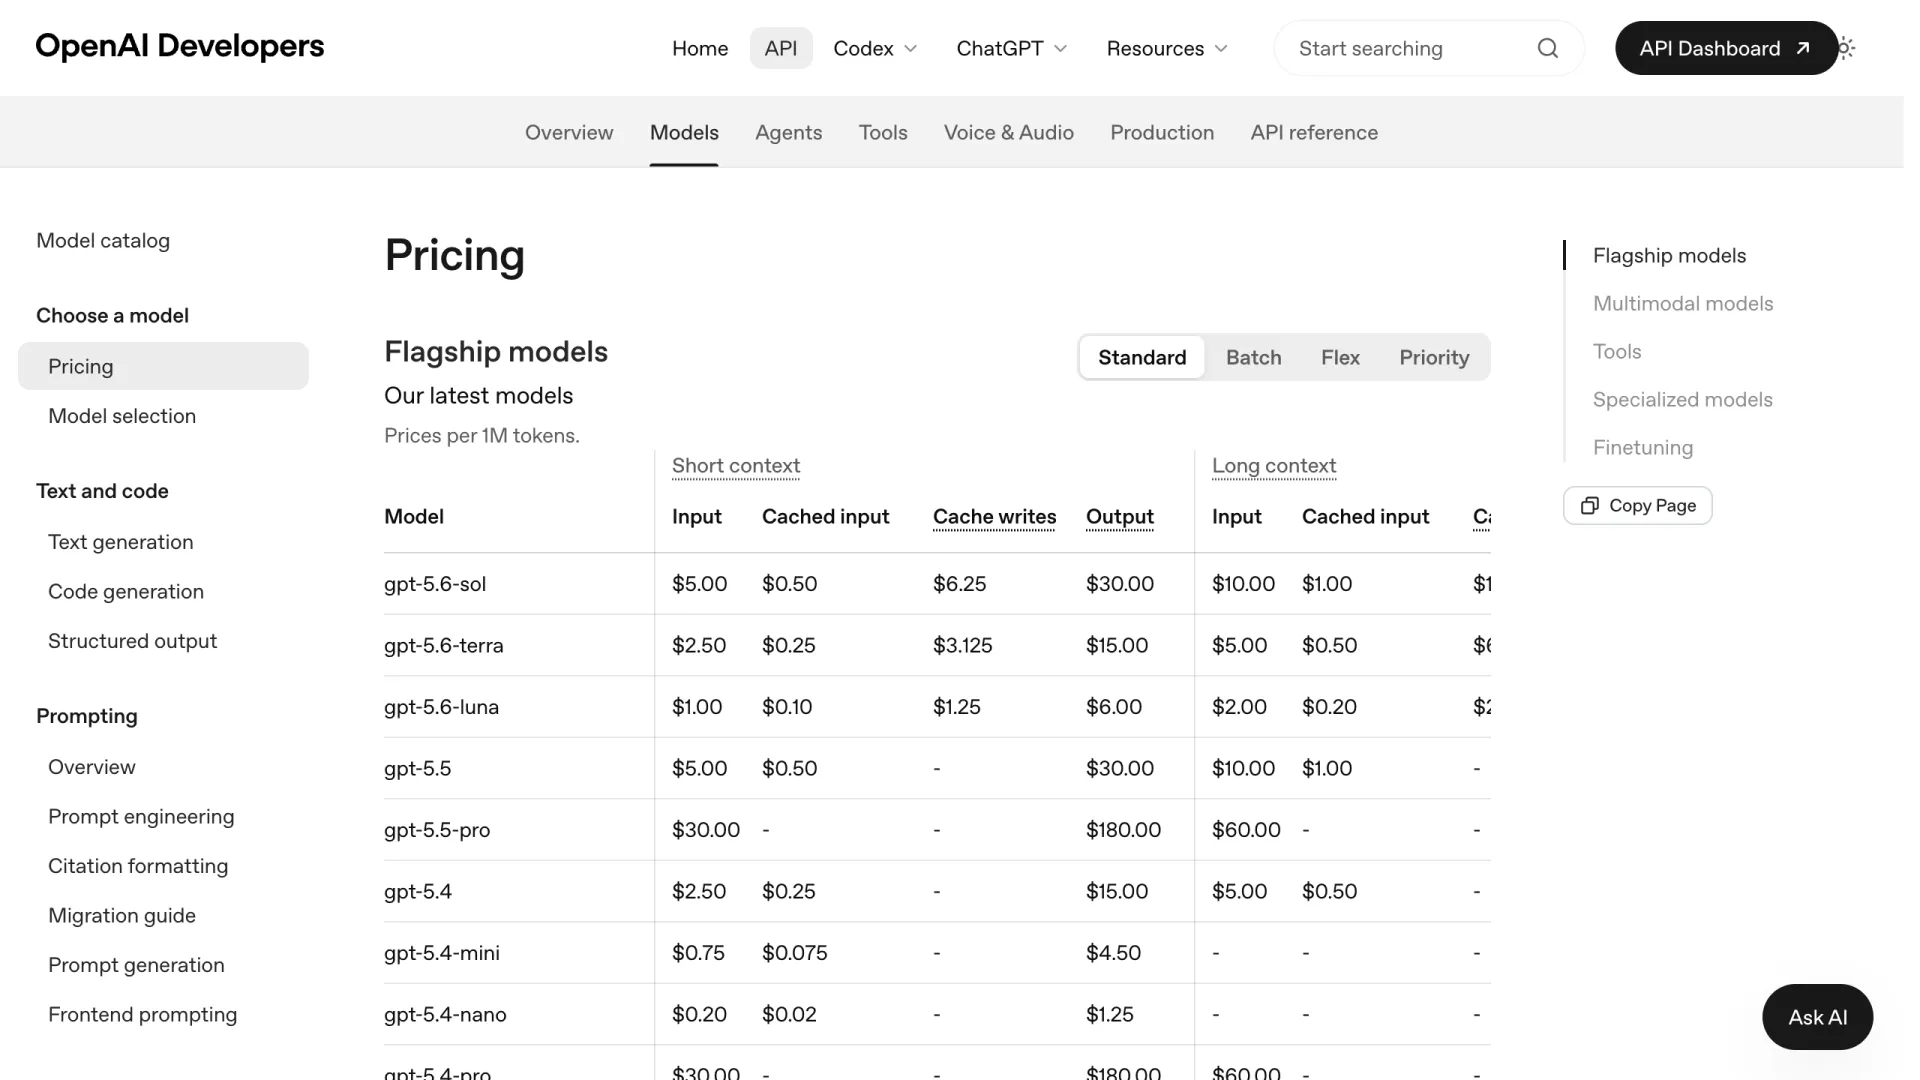
真正的结构性差异出现在 272K 输入 token。OpenAI 定价页为所有 GPT-5.6 型号分别列出了短上下文和长上下文价格:输入超过 272K 后,输入价格变为 2 倍,输出价格变为 1.5 倍,Sol 因此升至 $10 和 $45。Anthropic 的定价文档则用一句话说明了相反的设计:“900k-token 请求的每 token 计费费率与 9k-token 请求相同。”
换算成美元,在每个输入规模都固定输出 20K 的前提下:300K 输入的请求,Opus 5 为 $2.00,Sol 为 $3.90;500K 时为 $3.00 对 $5.90;900K 时为 $5.00 对 $9.90。跨过这一档位后,相同请求形态下 Opus 5 的价格约为 Sol 的一半。
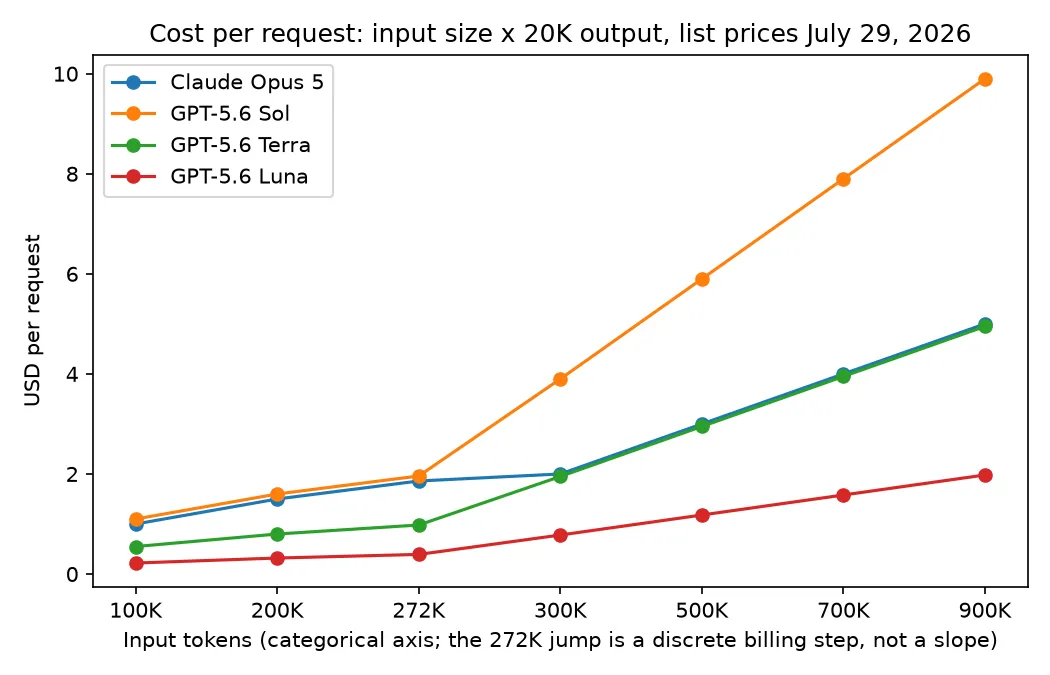
图中还有一个不利于得出“Anthropic 完胜”结论的意外情况。输入超过 272K 后,Terra 翻倍后的输入价格为 $5,与 Opus 5 相同;其长上下文输出价格为 $22.50,也低于 Opus 5 的 $25。在 20K 输出时,Terra 在 300K、500K、700K 和 900K 输入下,单次请求都比 Opus 5 便宜固定的 5 美分。这 5 美分会随输出量变化,而不是随输入规模变化:每百万输出 token 的差额为 $2.50。
做预算规划时,还有三项注记。Anthropic 为 Opus 5 提供处于 research preview 的快速模式,价格为输入 $10、输出 $50;OpenAI 提供优先级层级,价格是标准费率的 2 倍,仅适用于短上下文。美国地区的数据驻留服务,两家厂商都要额外增加约 10%。此外,按照Anthropic 自己的说明,Claude 当前的 tokenizer 对相同文本生成的 token 数,比 4.7 之前的模型约多 30%;因此最可靠的最终检查方式,是先用两家的 tokenizer 分别跑一遍有代表性的提示词,再计算费率。
不同工作负载,该调用哪一款
既然正确率打平,路由决策就应基于请求形态和工作方式。在 r/ClaudeCode 中,有开发者让 high effort 的 Sol 担任审查与 QA agent,看重它的细致程度和浏览器能力;而 r/codex 的其他用户则把大部分工作分流给中等推理强度、价格更低的 GPT 层级,并认为这样能得到最佳成本性能。
| 请求形态 | 推荐调用 | 原因 |
|---|---|---|
| 输入低于 272K、输出占比较高的 agent 循环 | Claude Opus 5 | 输出价格 $25 对 $30;本轮实测中重构判断最佳 |
| 输入低于 272K、对延迟敏感或高并发 | GPT-5.6 Terra | 我们测试中最快且最便宜的通过模型 |
| 输入高于 272K | Claude Opus 5 或 Terra | Sol 的长上下文费率翻倍;Terra 始终比 Opus 5 低 5 美分 |
| 审查、QA 和浏览器驱动的检查 | GPT-5.6 Sol | 六档 effort 可调节审查深度;建议在自己的 QA 数据集上验证 |
| 一次性分类和信息抽取 | GPT-5.6 Luna | $1/$6,且通过了全部四项检查 |
也并非所有人都认同 Sol 适合 QA。有一篇 r/codex 讨论帖认为 Sol 相比 GPT-5.5 是一次退步,同时称赞 Opus 5 能按计划完成更多任务。默认配置的验证成本并不高:四款模型都在 AIReiter 的目录中(Opus 5、Sol),可以将自己的任务并排重跑比较。
这轮对比最值得记住的数字只有一个:272,000 输入 token。低于它时,应根据行为、延迟和 $5 的输出费率差异来选;超过它后,在 Sol 与 Anthropic 的价格比较中,优势转向 Anthropic,不过 Terra 始终比 Opus 5 低 5 美分,Luna 的价格则远低于两者。
FAQ
gpt-5.6 和 GPT-5.6 Sol 是同一个模型吗?
是。OpenAI 的模型参考将不带后缀的 gpt-5.6 列为解析至 gpt-5.6-sol 的别名,因此它按 Sol 的费率计费:输入低于 272K 时,每百万 token 输入 $5、输出 $30;超过后分别为 $10 和 $45。
Claude Opus 5 的长上下文请求会更贵吗?
不会。在常规 API 中,Anthropic 对完整 1M 上下文窗口均按标准费率计费,并明确表示 900K-token 请求与 9K-token 请求的每 token 成本相同。只有可选的快速模式存在溢价,输入为 $10、输出为 $50。
Claude Opus 5 和 GPT-5.6,哪个更便宜?
取决于层级。输入低于 272K 时,Opus 5 的每百万输出 token 比 Sol 便宜 $5,其他价格相同;Terra 和 Luna 则远比两者便宜。输入超过 272K 后,相同请求下 Opus 5 的成本约为 Sol 的一半,而 Terra 仍略低于 Opus 5。
写代码时,Claude Opus 5 比 GPT-5.6 更好吗?
在我们 7 月 29 日的测试中,两者都正确完成了修复、计数和重构;当天 Google 对此查询的首条 r/Anthropic 图表帖,也显示它们的编程得分接近持平。Opus 5 展现出更好的重构判断,但在默认设置下输出计费 token 是 Sol 的 3.4 倍,因此编程场景的选择本质上是经济性与输出冗长度之间的选择。
Opus 5 和 GPT-5.6 的知识截止日期分别是什么?
Anthropic 给 Claude Opus 5 标注的可靠知识截止日期是 2026 年 5 月。三款 GPT-5.6 模型共享 2026 年 2 月 16 日的截止日期,约早三个月。