 AIREITER
7 月 17 日,我们把六款模型放进同一套翻译测试中跑了一遍。结论很直接:注重语气与品牌调性,选 Claude Sonnet 5;需要大批量处理,DeepSeek V4 Flash 每 1,000 个任务约 $0.10,几乎没有对手;若想兼顾能力与响应速度,GPT-5.6 Terra 是最快的全能选手。
我们向每个模型的 API 发送了完全相同的三道翻译题,并直接比较原始输出。令人意外的并不是质量:六款模型都正确翻译了德语技术内容,其中五款在处理日语省略主语的对话时没有出现任何错误。真正拉开差距的是价格——两款看似便宜的模型,每次请求却消耗了大量推理 Token,结果单次翻译成本比 Claude 高出 8–10 倍,已经逼近 DeepL 按字符计费的水平。
2026 年挑选翻译 LLM,关键不再是谁“能不能翻译”——它们都能——而是谁更适合你的内容类型和业务量,同时不会在不知不觉间抬高账单。
不同翻译任务,该选哪款模型
| 你的工作负载 | 推荐选择 | 理由 | 实测每 1,000 个任务成本 |
|---|---|---|---|
| 营销文案、品牌语调 | Claude Sonnet 5 | 读起来像用目标语言原生写成,而不是翻译腔 | ~$1.06 |
| 大批量处理:商品数据流、文档、字幕 | DeepSeek V4 Flash | 三项测试全部正确,成本远低于其他模型 | ~$0.10 |
| 混合型负载、追求最低延迟 | GPT-5.6 Terra | 响应时间 3.0–4.3 秒,格式处理最干净 | ~$0.88 |
| 术语表强制执行、CAT 工具工作流 | DeepL | 提供术语库和集成能力,LLM API 通常不具备 | 每 1M 字符 $27.50 |
以上成本是三项测试任务的平均值:按输出 Token × 2026 年 7 月官方价格计算,再外推至 1,000 条短翻译;完整测量表见下文。有一类场景不在本次测试范围内:实时语音对话。Google 提供专用的 Gemini 3.5 Live Translate 版本,价格为每百万 Token $3.50/$21;我们会提及它,但没有实际测试。
测试方法与样本
2026 年 7 月 17 日,我们用相同措辞、每题仅运行一次,向六款模型发送三种提示词:英译日 SaaS 营销文案,用于考察语气;英译德 API 文档,用于考察术语;以及日译英日常对话,用于考察省略主语和上下文——这是 CJK 语言对中最常见的翻译失误之一。CJK 是中文、日文和韩文的简称,这三种语言也是机器翻译质量投诉最集中的领域。
参与测试的模型包括:GPT-5.6 Terra、Claude Sonnet 5、DeepSeek V4 Flash、DeepSeek V4 Pro、GLM-5.2 和 Kimi K2.6。所有调用均通过同一个网关账户,采用默认设置。因此延迟数据可以相互比较,但实际表现仍会随你的地区和服务商负载而变化。
以下是三段原始文本,保持原样,方便你自行复测:
英译日(营销): "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." 英译德(技术): "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." 日译英(对话): 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
以下是每款模型在每项任务中的完整测量结果:延迟为端到端秒数,Token 数取自 usage 对象中的输出 Token。
| 模型 | 英译日 | 英译德 | 日译英 | 平均单任务成本 |
|---|---|---|---|---|
| GPT-5.6 Terra | 3.0s / 46 | 4.3s / 67 | 3.2s / 63 | $0.00088 |
| Claude Sonnet 5 | 3.5s / 60 | 4.0s / 146 | 3.5s / 111 | $0.00106 |
| DeepSeek V4 Flash | 5.2s / 421 | 4.3s / 371 | 4.7s / 323 | $0.00010 |
| DeepSeek V4 Pro | 16.5s / 769 | 18.0s / 989 | 19.6s / 946 | $0.00078 |
| GLM-5.2 | 30.8s / 1,906 | 29.0s / 1,590 | 35.2s / 1,985 | $0.00804 |
| Kimi K2.6 | 19.6s / 2,849 | 48.5s / 2,235 | 23.6s / 2,413 | $0.01000 |
单任务成本 = 输出 Token × 服务商官方输出价格。每项任务的输入通常为 60–110 Token,即使按 GPT-5.6 Terra 的费率计算,额外成本也低于 $0.0003;文中后面的每百万字符成本图已将其计入。所有价格均为截至 2026 年 7 月 17 日的官方标价,而不是我们账户实际享受的折扣价格。
仅凭三项任务的抽查,无法给 100 个语言对的模型排出完整名次,我们也无意这么做。但即便样本很小,也足以暴露那些稳定存在的差异,而这次看到的差异相当大。
测试一:英译日营销文案
提示词要求把一条 SaaS 落地页文案自然、礼貌地译为日语:“Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters.”
Claude Sonnet 5 给出的文案是:
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
这就是日本文案写手常用的语域:用片假名写“形”的「カタチ」,以及逗号切分出的节奏,都是落地页文案的惯用表达,并非教科书式语法。GPT-5.6 Terra 和 DeepSeek V4 Pro 紧随其后,给出了简洁、商务化的译文,例如「アイデアを、より迅速に形に。」。
DeepSeek V4 Flash 是六款中最直译的一款:「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」语法没有问题,但读起来明显像译文。用于产品页时,建议再经过人工润色;用于帮助中心文章或内部文档,则完全够用。
这里确实存在差距,但并不悬殊:六款模型都能产出可用的日语。只有品牌调性类工作,Claude 每 1,000 个任务多约 $1 的成本才明显值得;在本次其他测试中,这种优势都没有这么重要。
测试二:英译德 API 技术文档
我们翻译了两句 API 文档,内容涉及速率限制、HTTP 429、指数退避和幂等键。六款模型的技术术语都翻译正确,也都采用了自然的德语技术文档写法,例如 Ratenlimit、Statuscode 429、exponentielles Backoff 和 Idempotenzschlüssel。
唯一能看出的细节差异是:GPT-5.6 Terra 给 Retry-After 加上了代码格式,与真实德语 API 文档排版 HTTP 头名称的方式一致。这是个加分项,但谈不上质量鸿沟。
在资源丰富的欧洲语言之间翻译常规技术文档,本次样本没有任何模型出错;到这一代模型,质量差异已经小到难以观察。如果这就是你的全部工作负载,应按价格和速度来选,而不是按质量。这意味着 DeepSeek V4 Flash 默认最值得考虑,价格为每百万 Token 输入 $0.14、输出 $0.28。
测试三:日译英——考验省略主语的对话
日语经常省略句子主语,翻译时必须判断到底是谁做了什么。测试对话中还出现了「根回し」(nemawashi),即在正式决策前私下协调、铺垫共识;这是一个没有直接英文对等词的文化语境词。
六款中有五款正确处理了所有内容。主语归属准确,nemawashi 被译成 “lay the groundwork”、“sound him out beforehand” 或 “give him a heads-up”,都说得通。Claude 的版本最像自然对话,例如“he's probably gonna chew me out”。
18 份输出中唯一真正的错误来自 DeepSeek V4 Pro。它把「先に根回ししといたほうがいい」——对接下来该做什么的建议——译成了 “You should've laid the groundwork first”,即对已错过之事的过去时懊悔。几个小词,意思却完全相反。如果同事说的是前者,你听成后者,接下来的行动会截然不同。
一次运行中的一个时态错误,只是一个数据点,不能据此给模型下结论——我们会在 DeepSeek V4 Flash vs Pro comparison 中更深入比较这两个 DeepSeek 档位。但它提醒了一个实用事实:语言流畅与忠实原意是两种不同能力。句子可以读起来完全自然,意思却错了。合同、医疗内容,或任何误读时态会造成金钱损失的场景,无论选哪款模型,都应预留人工审核。
Token 消耗陷阱:标价不等于实际成本
这是会改变采购决策的一项发现。按每百万输出 Token 的标价看,GLM-5.2 是 $4.40,Kimi K2.6 是 $4.00,都不到 Claude Sonnet 5 的 $10 一半;但在实际完成每条翻译任务时,它们的成本却高出 8–10 倍。
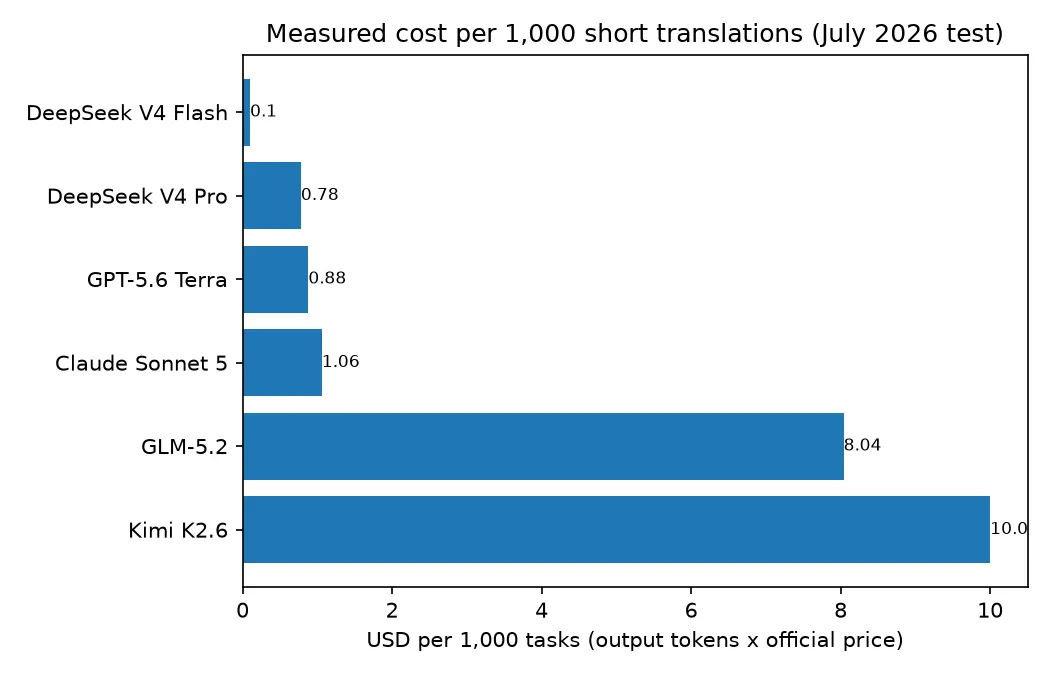
原因在于,两款模型都会在给出答案前运行可见的推理链,而推理 Token 按输出 Token 计费。一句营销文案的翻译结果通常只有 40–60 Token,Kimi K2.6 却输出了 2,849 个 Token,GLM-5.2 输出了 1,906 个。相同任务中,Claude Sonnet 5 只用了 60 个 Token,GPT-5.6 Terra 则为 46 个。
延迟也呈现相同规律。GPT-5.6 Terra 和 Claude Sonnet 5 在三项任务中都在 3–4 秒内响应;DeepSeek V4 Flash 需要 4–5 秒,DeepSeek V4 Pro 为 16–20 秒,而 GLM-5.2 和 Kimi K2.6 每次请求则介于 20 至 48 秒。
这里可以得出两条实操规则。第一,对于翻译这类短文本、高并发任务,别只比较标价,要比较实测单任务成本:跑 20 次请求,再查看 usage 字段。第二,翻译时应关闭或调低推理:DeepSeek 区分思考与非思考端点,GLM 和 Kimi 则在请求体中提供思考参数。本次三项任务中,推理链没有带来任何可观察到的质量提升。
批量翻译时,成本会差多少
将实测 Token 消耗放大到 100 万英文源字符——约 250,000 Token——差距会变得非常明显:
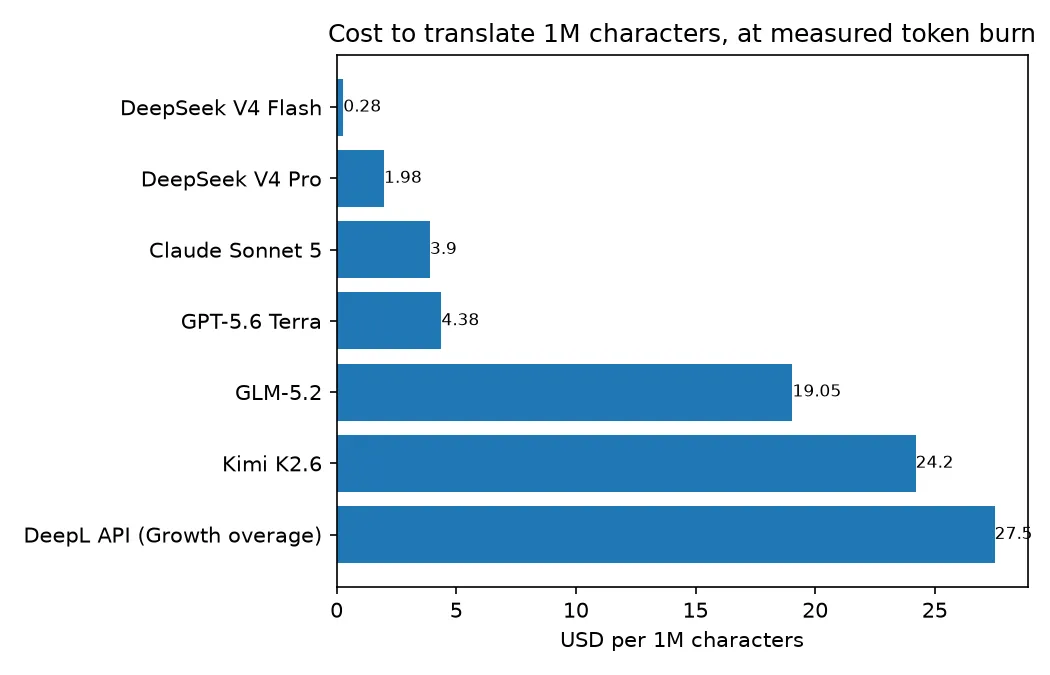
DeepSeek V4 Flash 翻译相当于一整本小说体量的文本,成本约为 $0.28。相同体量使用 DeepL API,按 Growth 套餐超额价格计算需要 $27.50,相差 98 倍。这也与 r/LocalLLaMA 上广泛传播的一篇分析方向一致,文章标题为 "LLMs are 800x cheaper for translation than DeepL";该文得出更大倍率,是因为使用了更小的自托管模型。
再看图表顶部:如果按实测 Token 消耗计算,那些重推理的开放权重模型几乎把与 DeepL 的成本差距抹平。没有 Token 测量数据,单价并不能代表实际成本。
在决定采用前,有三项定价信息值得了解,均已于 2026 年 7 月 17 日核实:
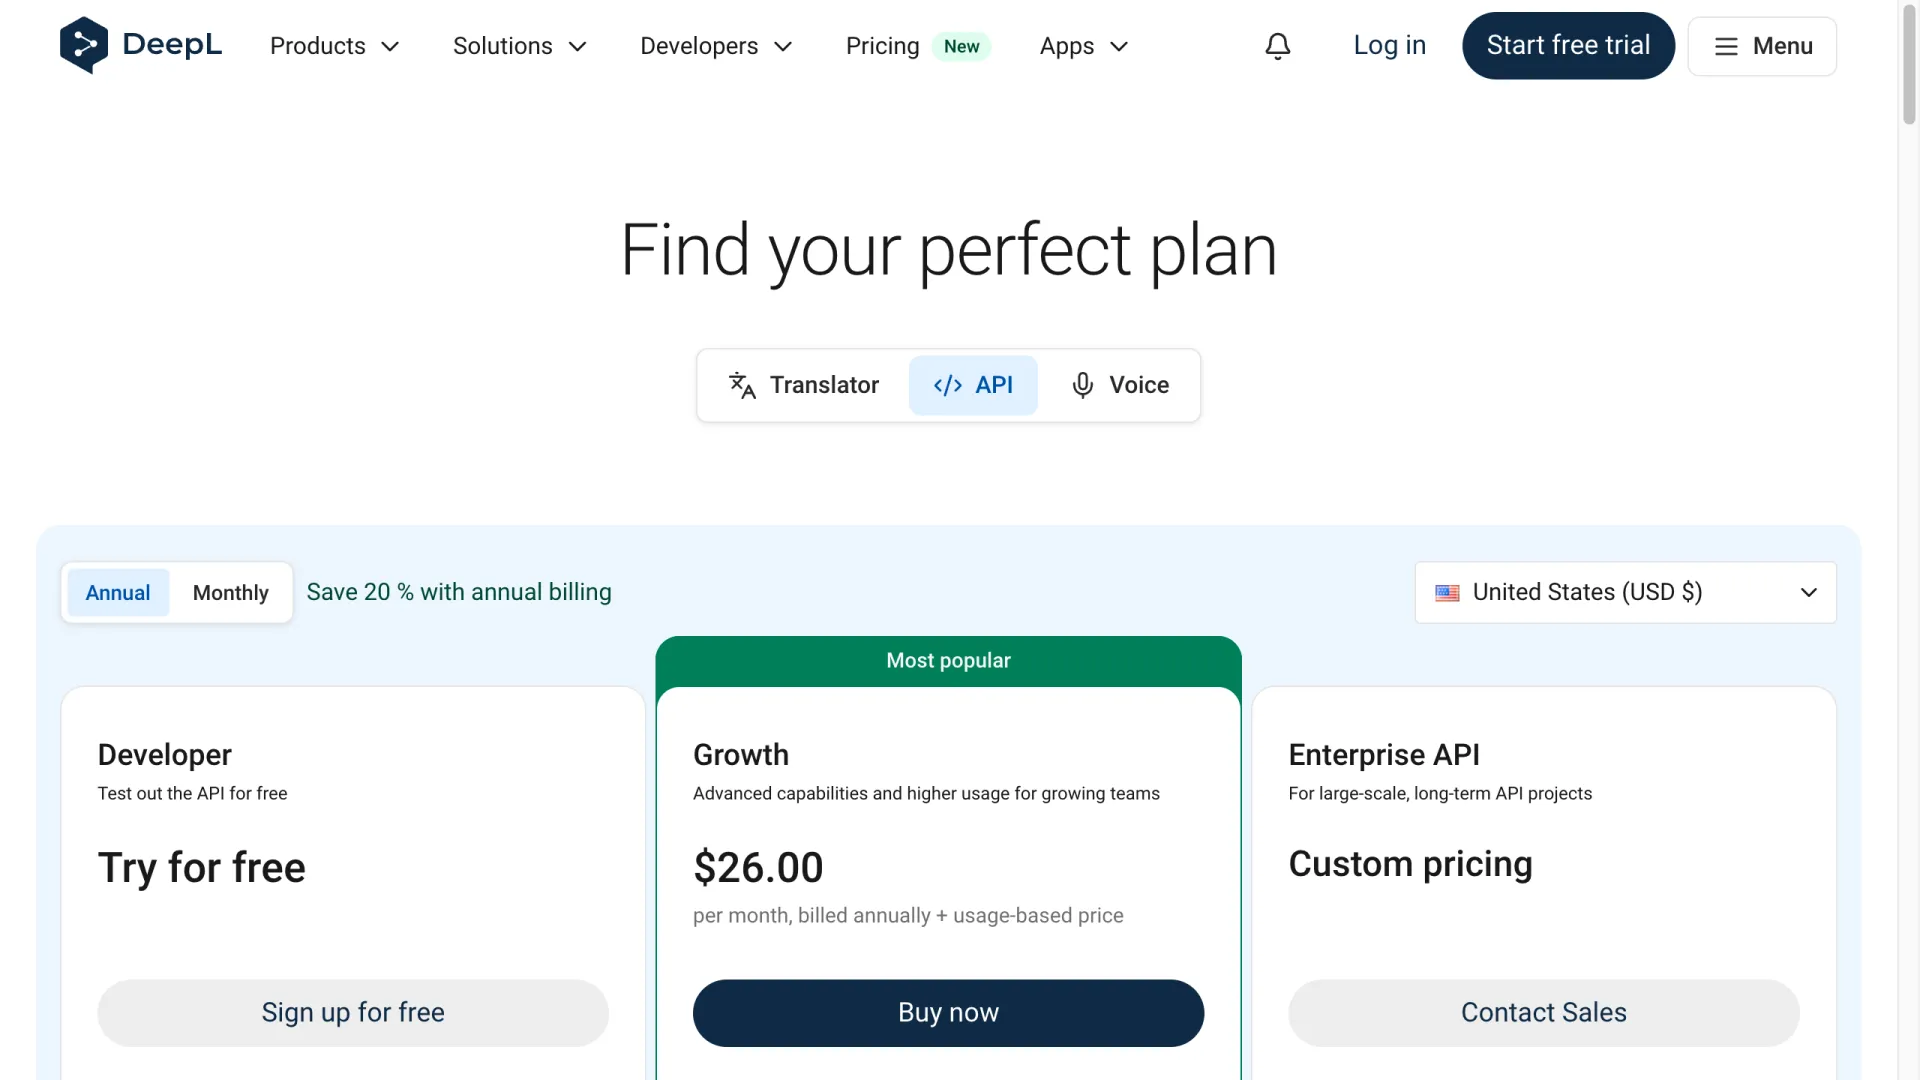
- DeepL 免费层已调整。 API Developer 套餐现在提供一次性 1,000,000 字符额度,不再是旧文档和论坛回答中常见的每月 500,000 字符。Growth 每月 $26,按年付费,包含每年 12M 字符;超出后每额外 100 万字符收费 $27.50。
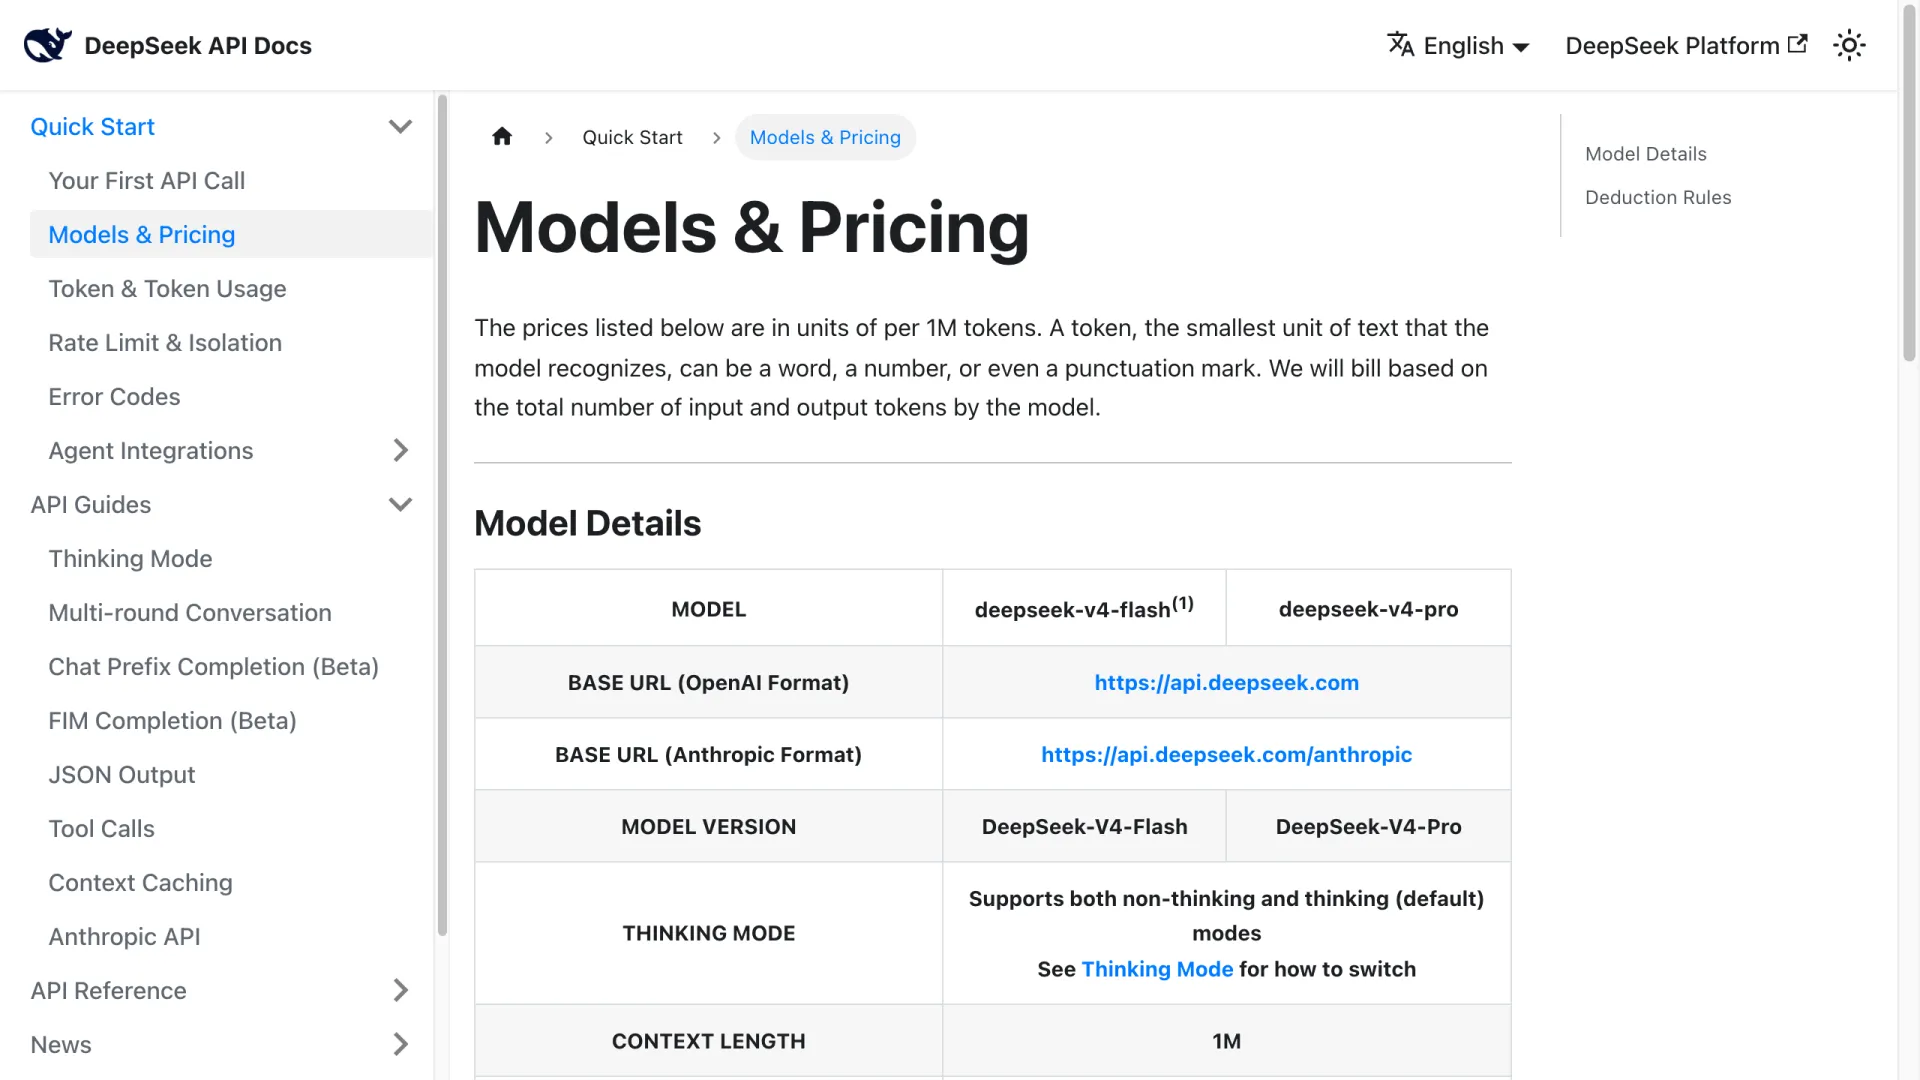
- DeepSeek 的收费仅为其他厂商的一小部分。V4 Flash 每百万 Token 输入 $0.14、输出 $0.28,缓存命中的输入价格低至 $0.0028。旧的 deepseek-chat 模型名称将于 2026 年 7 月 24 日退役。
- Claude Sonnet 5 目前采用引介期价格。截至 2026 年 8 月 31 日,每百万 Token 为输入 $2、输出 $10,之后变为 $3/$15。它更新的分词器对相同文本也会产出约多 30% 的 Token,上述成本计算已包含这一因素。如果计划用到 9 月之后,两项变化都应纳入预算。
- Batch API 能把账单减半。OpenAI、Anthropic 和 Google 都为异步批量处理提供约 50% 的折扣。翻译工作通常不太依赖低延迟,这几乎是白送的优惠:采用批量价格后,GPT-5.6 Terra 每百万字符约为 $2.19,Claude Sonnet 5 约为 $1.95。
DeepL 和 Google Translate 仍然值得选的场景
从每字符成本看,LLM 更有优势;但遇到以下三种需求,传统方案依然更合适:
- 术语必须强制统一。DeepL 提供术语表和术语库,能确保一个术语每次都以相同方式翻译。LLM 只能靠提示词要求并自行验证,这是一种概率性约束,而不是强制执行。
- CAT 工具和翻译流程集成。如果你的翻译记忆库放在 CAT(计算机辅助翻译)工具里,DeepL 的连接器可以直接接入。
- 大规模场景下的亚秒级响应。传统神经机器翻译引擎的响应通常快于通用 LLM;对于内嵌式 UI 翻译,这一点很重要。
实时语音并不适合经典 NMT 或聊天式 LLM。Google 为专用的 Gemini 3.5 Live Translate 版本定价为每百万 Token $3.50/$21,并按分钟收取音频费用;我们已在 Gemini 3.5 Live Translate breakdown 中详细介绍。
对于罕见语言和低资源语言,覆盖范围比质量排名更重要:在比较其他任何指标前,先确认你的语言对是否受支持。DeepL 支持约 30 种语言;大型 LLM 可处理超过一百种语言,但在长尾语言上的质量会逐渐下降。
开源与本地部署方案
GLM-5.2 和 Kimi K 系列都发布了开放权重,因此若自行托管,上文提到的 Token 消耗问题可以解决:你能控制采样设置,并完全关闭推理链。
对于单 GPU 本地翻译,Qwen3-30B-A3B 是 r/LocalLLaMA 关于本地翻译模型的讨论帖中反复出现的推荐,尤其适合欧洲语言译为英语。语言对越冷门,社区越倾向推荐更大的模型。人们选择本地模型,通常是出于隐私考虑——例如合同和未发布产品——或追求零边际成本,而不是绝对质量;在同一批讨论中,托管的前沿模型仍被认为翻得更好。
另一个值得关注的产品是:Kimi K3 本周以开放权重形式发布,托管价格为每百万 Token $3/$15。我们测试 K2.6,是因为 K3 API 访问权限当时仍在逐步开放;如果 K3 延续 K 系列的 Token 消耗习惯,同样需要按实测成本来评估。
如何自己复现这次对比
要复现本文的结论,大约 20 次 API 调用就够:从自己的内容中选两句话,发给每个候选模型,再读取每次响应中的 usage 对象,查看实际 Token 数量。我们这次 18 次请求的总成本低于 $0.15。
麻烦之处在于,你需要管理来自五家供应商的六个 API Key。我们通过一个 AIReiter 账户运行了六款模型;它通过单一 Anthropic 兼容端点转售主流模型 API 访问权限,Claude 系列 Key 的价格约为官方标价的五分之一。一个 Key,就能以相同的请求格式调用上文所有模型。
如果你的翻译量确实不小,花一小时拿自己的内容做抽查,胜过相信任何排名,包括这篇文章。模型之间的质量差距已经足够小,最终应由你的语言对、语调要求和实测 Token 消耗来决定。
常见问题
ChatGPT 和 Gemini,哪个更适合翻译?
在我们的测试中,GPT-5.6 Terra 在三项任务里都很快、准确,且格式干净。我们没有将 Gemini 纳入横向测试,因为它不在我们的网关中;不过其公开价格具有竞争力,3.5 Flash 为每百万 Token $1.50/$9,而且它是唯一提供专用实时语音翻译模型的服务商。
目前最准确的 AI 翻译器是什么?
对于高资源语言对,前沿模型之间的准确性差距很小;我们测试的六款模型都没有在德语技术文档翻译中出错。差异主要体现在语气上——Claude 在日语营销文案中领先——以及省略主语、时态等边缘场景;DeepSeek V4 Pro 就出现了本次样本中唯一的实质性错误。
最好的开源翻译 LLM 是什么?
GLM-5.2 和 Kimi K2.6 都发布了权重,并且在我们的测试中翻译正确;自行托管后,可以关闭导致其托管 API 单任务成本偏高的推理链。对于消费级硬件,Qwen3-30B-A3B 是社区中最常见的推荐。
LLM 能替代人工译员吗?
对于内部文档、客服内容和大批量商品文本,基本可以,具体成本取决于模型,约为 DeepL 每字符成本的 1–16%:DeepSeek V4 Flash ~1%、Claude Sonnet 5 ~14%、GPT-5.6 Terra ~16%。但合同、医疗文本和品牌营销活动则不同。测试三中的时态错误就是一个警示:流畅的输出依然可能颠倒原意,因此在误读代价高的场景,仍应保留人工审核。
2026 年 DeepL 还值得用吗?
在三种情况下值得:需要强制术语表、需要 CAT 工具集成,以及需要亚秒级延迟。除此之外,其按字符计费的成本很难成立;还需注意,免费层现在是一次性 100 万字符额度,不再按月提供。