 AIREITER
Baidu 在模型設定檔中將 max_position_embeddings 設為 32,768,這正是「Unlimited」不再是字面意義的分界點。部署前最該先理解的是:Unlimited OCR 的確能把逐頁 OCR 流程改成一次前向傳遞,但前提是整份文件必須裝得進 32K token 預算,而且掃描品質要有一定水準。
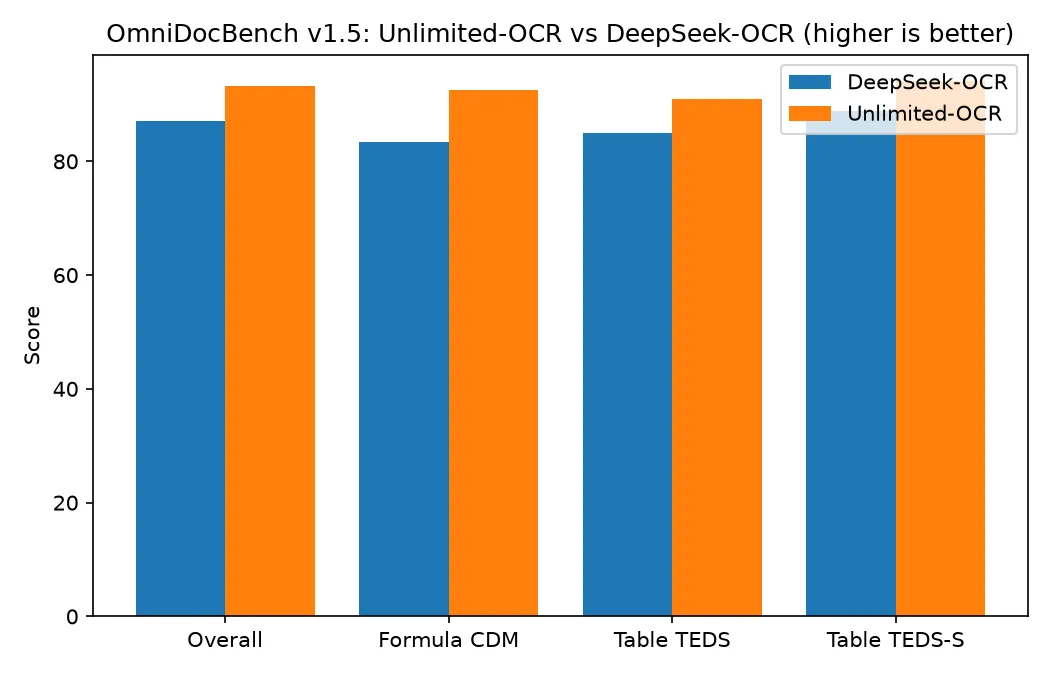
不過,這項限制並沒有削弱此次發表的份量。模型權重採 MIT 授權;safetensors 中繼資料顯示共有 3,336,106,240 個 BF16 參數;在 OmniDocBench v1.5 的總分為 93.23,高於其基礎模型 DeepSeek-OCR 的 87.01。截至 2026-07-29,Hugging Face 過去 30 天下載量為 2,694,935 次,獲得 3,389 個 likes。
32K context 才是多頁解析的真正上限
在多頁處理路徑中,每一頁會先以 1024×1024 編碼,再經過 16 倍壓縮,降至約 256 個視覺 token。也就是說,還沒寫程式前,就能先估算一份文件可容納的頁數。
| 單次處理頁數 | 視覺 token(prefill) | 留給輸出的 token | 每頁輸出預算 |
|---|---|---|---|
| 10 | ~2,560 | ~30,200 | ~3,020 |
| 20 | ~5,120 | ~27,600 | ~1,380 |
| 40 | ~10,240 | ~22,500 | ~560 |
投影片或文字稀疏的合約,40 頁通常能從容處理;但雙欄且內容密集的報紙版面,單頁就可能超過 560 個 markdown token,因此實際可處理頁數會遠低於 40 頁。論文也直接承認:在有限 context length 下,文件解析不可能真正無限,因為 prefill 仍會隨頁數增加。Baidu 的路線圖包括 128K context 版本,以及可按需擷取頁面區塊的「prefill pool」。所以這個名稱所指的,是相對於快取大小不受限的 decode 長度,而不是頁數無上限。
R-SWA 解決了長輸出問題,但沒改變視覺辨識底子
相較於 DeepSeek-OCR,Unlimited OCR 主要改了兩件事。首先,DeepEncoder 視覺堆疊保留下來,也就是 SAM-ViT-B 與 CLIP-L 的級聯架構,訓練期間維持凍結。其次,所有 decoder attention layer 都替換為 Reference Sliding Window Attention:每個新生成的 token 都可注意所有參考 token,也就是視覺 token 加上 prompt,但對已輸出的文字只會回看最近 128 個 token。config.json 可確認這點:sliding_window_size: 128、12 個 decoder layers、64 個 routed experts,且每個 token 啟用其中 6 個。
改善範圍並不侷限於單一項目,尤其反映在需要較長生成內容的版面元素上。在 OmniDocBench v1.5,公式 CDM 從 83.37 提升至 92.61,表格 TEDS 從 84.97 升至 90.93;閱讀順序 edit distance 則從 0.086 降至 0.045,幾乎減半。由於 encoder 沒有重新訓練,這些增益應來自 decoder 的改動,而不是視覺堆疊變得更強。
反過來說,原本 encoder 看不好的內容,新模型依然看不好。延長生成長度,並不會讓褪色傳真的字元辨識變準。
輸出夠長,吞吐量優勢才會出現
當輸出只有 256 個 token 時,兩個模型幾乎沒有差別:分別為每秒 7,229.52 與 7,229.32 token。隨著生成持續,差距才逐步拉開:在 6,144 個輸出 token 時,基線模型已降至每秒 5,822.87 token,Unlimited OCR 則維持每秒 7,847.71 token,約快 35%。
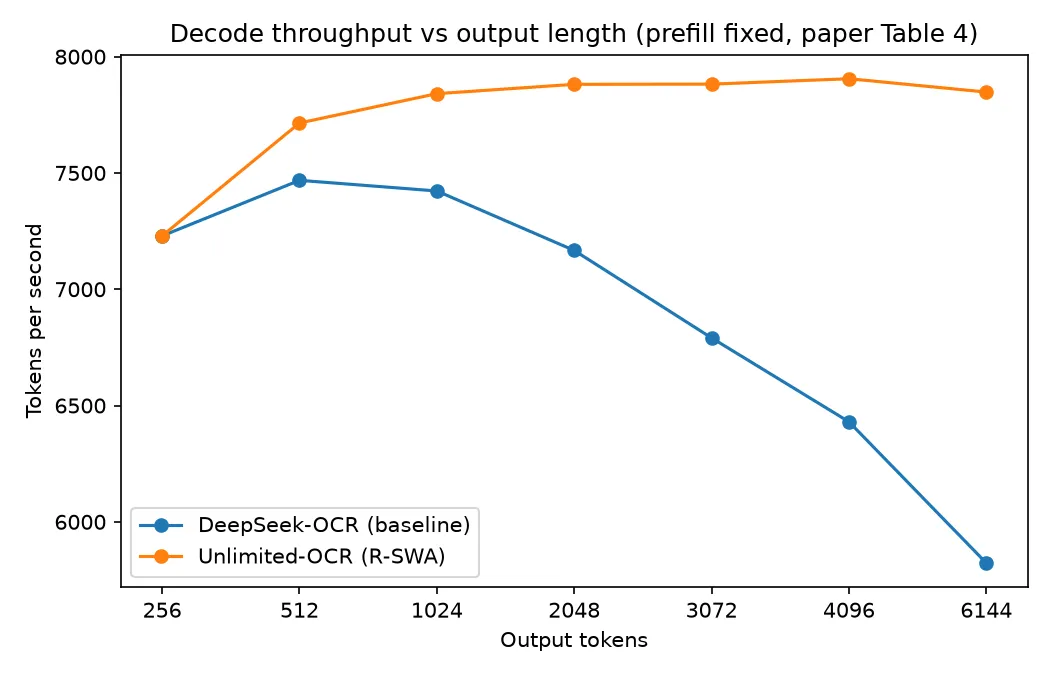
不過,在 base mode、512 並發下執行完整 OmniDocBench 時,優勢縮小至 12.7%,即每秒 5,580 對 4,951 個 token。原因是批次處理已經掩蓋掉不少逐步 attention 成本。高並發的單頁發票處理,幾乎無法從 R-SWA 得到明顯增益。
40 頁前表現穩定,之後誤差開始上揚
論文提供了單次處理時 edit distance 隨頁數變化的數據,而這條曲線並非完全平坦。
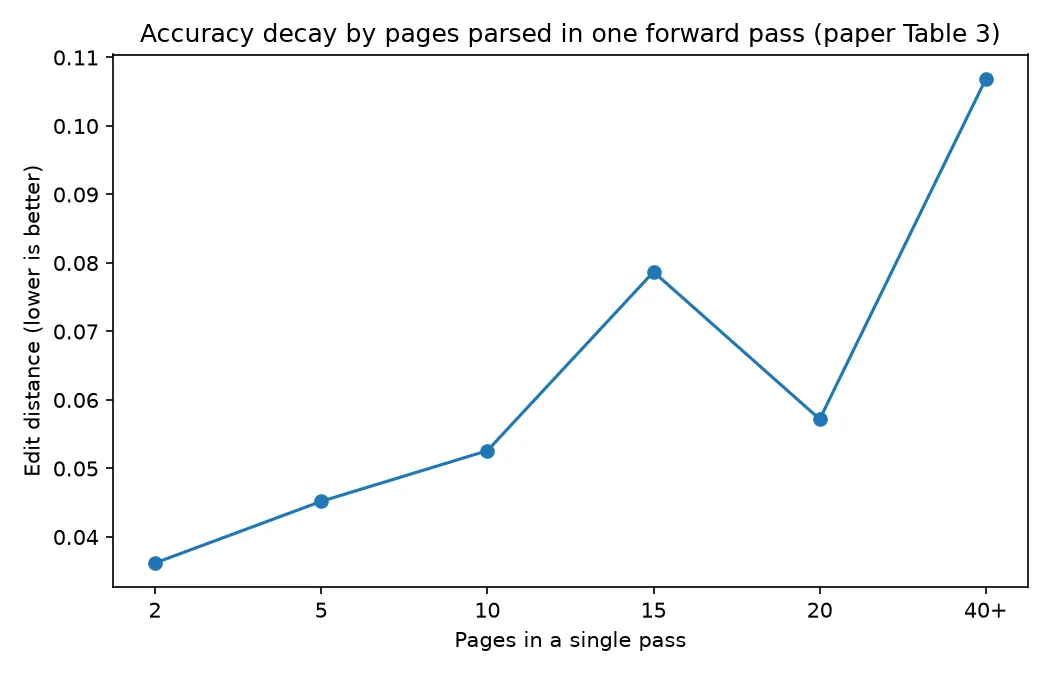
處理 2 頁時,edit distance 為 0.0362;10 頁為 0.0526;到 40 頁以上則升至 0.1069。同時,Distinct-35 從約 99.9% 降至 96.90%,代表輸出開始出現重複 n-gram。值得注意的是,15 頁的測量值為 0.0787,反而比 20 頁的 0.0572 更差,因此這條曲線應視為整體趨勢,而非逐頁保證。Baidu 將重複問題主要歸因於 1024×1024 基礎解析度下的小字,而非 attention drift;這也符合架構取捨:多頁與 PDF 輸入無法使用單張圖片可用的高細節 crop mode。
「8 GB 就夠」背後的 VRAM 算盤
vLLM 教學文件指出,使用 BF16 推論時,單張具備 8 GB 以上記憶體的 GPU 即可運行。但社群回報與此不太一致,而模型本身的設定正好能解釋其中差距。
單一 safetensors 檔案就有 6.673 GB。快取用量取決於 config.json 的四個欄位:num_hidden_layers: 12、num_attention_heads: 10、num_key_value_heads: 10、v_head_dim: 128,以及 use_mla: false。query head 與 key/value head 數量相等,代表這是標準 MHA,沒有 GQA 或 MQA 的共享機制可降低用量。因此每個 token 的 cache 為 2(K 與 V)× 12 layers × 10 heads × 128 dims × 2 bytes = 61,440 bytes,亦即 60 KiB。換算後可得到三個數字:
- 完整 32K prefill:32,768 × 60 KiB = 1.875 GiB cache
- 受
sliding_window_size: 128限制的 R-SWA decode 端:固定 7.5 MiB - 若同一 decoder 不使用 R-SWA,輸出達 6,144 個 token 時:360 MiB,且會線性成長
這些是理論上的 cache 大小,不代表峰值配置。視覺 encoder activations、allocator fragmentation,以及推論引擎預先配置的 cache block 都還要另外計入。因此,模型權重加上長 prefill 很容易擠壓一張 8 GB 顯示卡。有人在 16 GB RTX 4070 Ti Super 上以 SGLang 本機執行時,回報約使用 12 GB,這與上述計算相符,但不能把它當成直接證明。8 GB 應視為短篇單頁文件的最低門檻,而不是處理 40 頁文件的規格。
這些數字也有助於校準對 R-SWA 效益的期待:以這種模型規模來說,限制 decode cache 節省的是數百 MB,而非數 GB。實務上真正顯現的優勢,是每一步 attention 成本不再持續增加,吞吐量曲線量測到的正是這件事。
沒有官方 API,實際部署得自己來
Hugging Face 模型頁面明確顯示「This model isn't deployed by any Inference Provider.」。目前沒有第一方 endpoint,也沒有 Baidu 提供的託管定價頁面。若要自行部署,可選三條路:使用帶有 trust_remote_code 的 Transformers、SGLang,或vLLM recipe。後者要求 vLLM 0.25.0 或更新版本,且必須使用專用的 vllm/vllm-openai:unlimited-ocr container,因為此架構尚未進入穩定版 pip wheel。
有四項設定會直接決定你能否取得正常輸出:
- 註冊 n-gram logits processor:使用
NGramPerReqLogitsProcessor。缺少它時,長文件會在<|det|>座標 token 上反覆迴圈。 - 依輸入類型設定視窗:單張圖片使用
ngram_size: 35搭配window_size: 128;多頁或 PDF 輸入則將 window 設為1024。 - 文字內容必須以指定 token 起頭:使用字面上的
<image>,例如<image>Multi page parsing.。模型並未附帶 chat template。 - 傳入
skip_special_tokens: False:若維持預設值,回傳結果會是空字串。
原始生成結果帶有 grounding markup。若想取得乾淨的 markdown,保留 <|ref|> 中的文字,捨棄 <|det|> 的 bounding boxes 即可。模型也不會原生輸出頁面邊界;若審計流程需要頁碼標記,必須在 prompt 中明確要求。
recipe 提供的已知可用 server 與 request 如下:
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Hopper 顯示卡請使用 unlimited-ocr-cu129 image tag。此外,同一 request 放入多張圖片時,模型會退回非 crop 的 base mode,這正是應使用 window_size: 1024 的情境。
每 1,000 頁成本:自架與託管 API 怎麼選
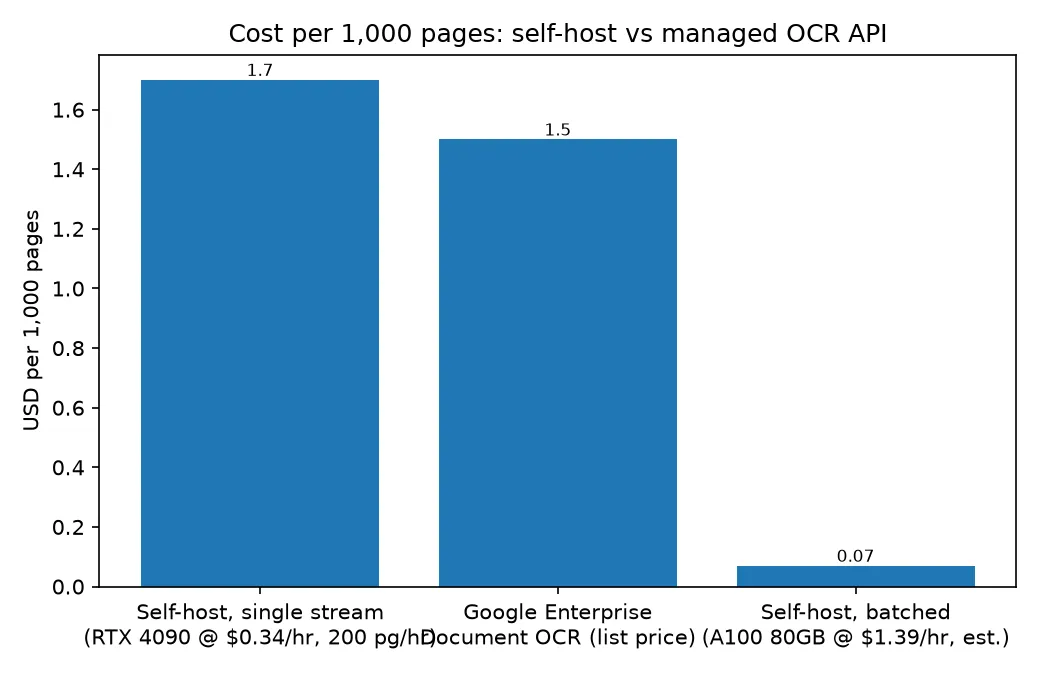
開放權重不收費,但推論絕非零成本。少數公開的實作吞吐量資料之一,來自 Hacker News 討論串中的一位實作者:他透過 Transformers,在 RTX 4090 上每小時將一本日文文法 PDF 轉換約 200 頁。再對照 RunPod 的 Community 方案,4090 租用費率為每小時 $0.34。
| 選項 | 每 1,000 頁成本 |
|---|---|
| 自架、單一串流(4090 每小時 $0.34、每小時 200 頁) | ~$1.70 |
| Google Enterprise Document OCR,每月 1K 至 5M 頁 | $1.50(牌價) |
| Google Layout Parser,相同頁數區間 | $10.00(牌價) |
| 自架、飽和批次理論下限(A100 80GB 每小時 $1.39,模型推估) | ~$0.07 |
以上牌價截至 2026-07-29。Google 每月前 1,000 頁免費,超過 500 萬頁後費率降為 $0.60。表格最後一列是推估下限,不是實測數據,且成本會隨輸出長度變動:以論文在 512 路並發下每秒 5,580 個 token 的成績估算,若每頁輸出 700 個 token,約可達每小時 28,700 頁,也就是每 1,000 頁 $0.05;每頁 1,000 個 token 時約為每小時 20,000 頁、每 1,000 頁 $0.07;內容密集、每頁 2,000 個 token 時,則約每小時 10,000 頁、每 1,000 頁 $0.14。這項吞吐量來自 Baidu 自家的評測叢集,而非租用的 A100,因此該列混合了 benchmark 速率與租用價格。實際部署還要加上閒置容量、失敗頁面的重試、前處理與儲存成本,最終價格都會高於這三個數字。
消費級顯示卡上的單一串流部署,成本大致與 Google 託管 OCR 相當。因此,自架的優勢在於並發能力與資料落地性,而非授權本身。更別忘了,解析只是流程的一半:若要把 markdown 轉為結構化欄位,仍需呼叫長 context 文字模型,計費會回到按 token 而非按頁,不論是自行部署,或透過 GPT-5.6 API 這類服務。
它最容易在哪些地方失手
使用者回報的失敗模式,正符合凍結 encoder 所預期的限制。同一個 4070 Ti Super 測試指出,收據、手寫內容與複雜掃描文件會出現輸出混亂、漏掉區域與結構漂移;乾淨的印刷頁面則能順利通過。Hacker News 討論串中的實作者也描述了 VLM-OCR 在合規工作中特別棘手的一類錯誤:外語詞彙被悄悄翻譯成英文,手寫姓名則被「修正」為模型認為更可能的拼法。這兩者都是單一案例,應將它們列為測試項目,而不是當作已有量測支持的失敗率。
定位同樣重要。Unlimited OCR 並非準確度排行榜上的頂尖模型。根據彙整的 OmniDocBench 排名,PaddleOCR-VL-1.6 為 96.33(廠商自行回報),Unlimited OCR 在 v1.6 則是 93.92;此外,該模型尚未出現在 olmOCR-Bench。它競爭的核心並非逐頁準確度。
值得部署嗎?
如果你目前的 pipeline 需要逐頁跑完再把文字拼回去、文件主要是原生數位檔或乾淨掃描件,且跨頁結構——例如跨越換頁的表格——正讓既有輸出失效,Unlimited OCR 會是合適選項。
若你每天處理的是數千張單頁發票,則不太適合,因為逐頁 pipeline 更容易批次化、成本也更低。若手寫內容或拍攝收據佔輸入中不可忽略的比例,或你現在需要的是 SLA 與 audit trail,而不是一張 GPU 和一個 container tag,它同樣不是理想選擇。
無論如何,正式導入前都應先測試。一個可行的最低標準是:從自家語料挑選 50 份文件,依長度分為 1 至 5 頁、6 至 20 頁、20 頁以上,並依輸入品質分成原生數位檔、乾淨掃描、拍攝文件;其中 10 份以人工輸入 ground truth。接著分別評估 character error rate、閱讀順序 edit distance 與表格 TEDS,不要只看平均分數;同時記錄預計租用 GPU 上的每頁 wall-clock 秒數。再用同一批 50 個檔案與現有方案比較,判斷門檻應設在真正讓下游流程失效的指標上;對欄位擷取而言,通常是表格結構而非原始 CER。至於推論層優化能把數字推進多少,一個處理企業級 PDF 流量的團隊曾回報,在以 Rust 重寫推論層後,character error rate 降至 0.94%。
常見問題
Unlimited OCR 是免費的嗎?
模型權重採 MIT 授權,可從 Hugging Face 或 GitHub 免費下載,也可商業使用。但推論並非免費:視批次化程度而定,每 1,000 頁約需 $0.07 至 $1.70,另加工程投入時間。
Unlimited OCR 有官方 API 嗎?
沒有。模型頁面沒有任何 Inference Provider 部署,因此你找到的任何 endpoint,都是第三方代管開放權重的服務;價格與 rate limit 由該供應商決定,並非 Baidu 制定。
Unlimited OCR 是目前最好的 OCR 模型嗎?
若看準確度排行榜,答案是否定的:PaddleOCR-VL-1.6 在 OmniDocBench 回報 96.33,Baidu 在 v1.6 的成績為 93.92;而且這個模型還沒有 olmOCR-Bench 成績,因此跨 benchmark 的一致性尚未證實。它已量測出的優勢,是以單次傳遞處理 40 頁時仍維持 0.1069 edit distance。
可以在 Ollama 執行 Unlimited OCR 嗎?
官方模型卡只列出 Transformers、vLLM 與 SGLang,且自訂架構需要 trust_remote_code。Hugging Face 上已有社群量化版本,但在你用自己的文件與參考路徑比對輸出前,任何 Ollama build 都應視為未驗證方案。