 AIREITER
Alibaba 在 2026 年 8 月 25 日於 ModelScope 放上一頁倒數頁面,預告 Qwen3.8-Flash-Next 即將登場。這是一個有點特別的模型:Qwen4 這個產品系列還沒正式出現,相關新架構卻先以可運作的模型形式開放。截稿時,模型權重預計在 8 月 26 日 23:00(UTC+8)釋出。這次預覽的重點,不只是展示模型本身,更是讓開源推論生態系能在 Qwen4 到來前,先完成 kernel、量化與服務支援。
Qwen3.8-Flash-Next 到底是什麼?又不是什麼?
Qwen3.8-Flash-Next 是一款多模態 Mixture-of-Experts(MoE)模型,採用 Qwen4 系列預定使用的架構。它不是 Qwen4 本身,比較像是一款技術展示模型:透過可實際運作的版本,提前公開新的注意力機制、層級結構與稀疏模式,讓推論框架在完整 Qwen4 上線前就能開始加入支援。
Qwen 團隊在 Hugging Face 頁面上將它標示為「Upcoming release」以及「A Preview of the Qwen4 Architecture」。ModelScope 倒數頁面則使用了「Onward to the Next-Gen — Lightning-Fast.」這句標語。兩者都是 Qwen 的官方管道,因此可以確認這次發布確實存在;只是截稿時,完整發布流程尚未完成。
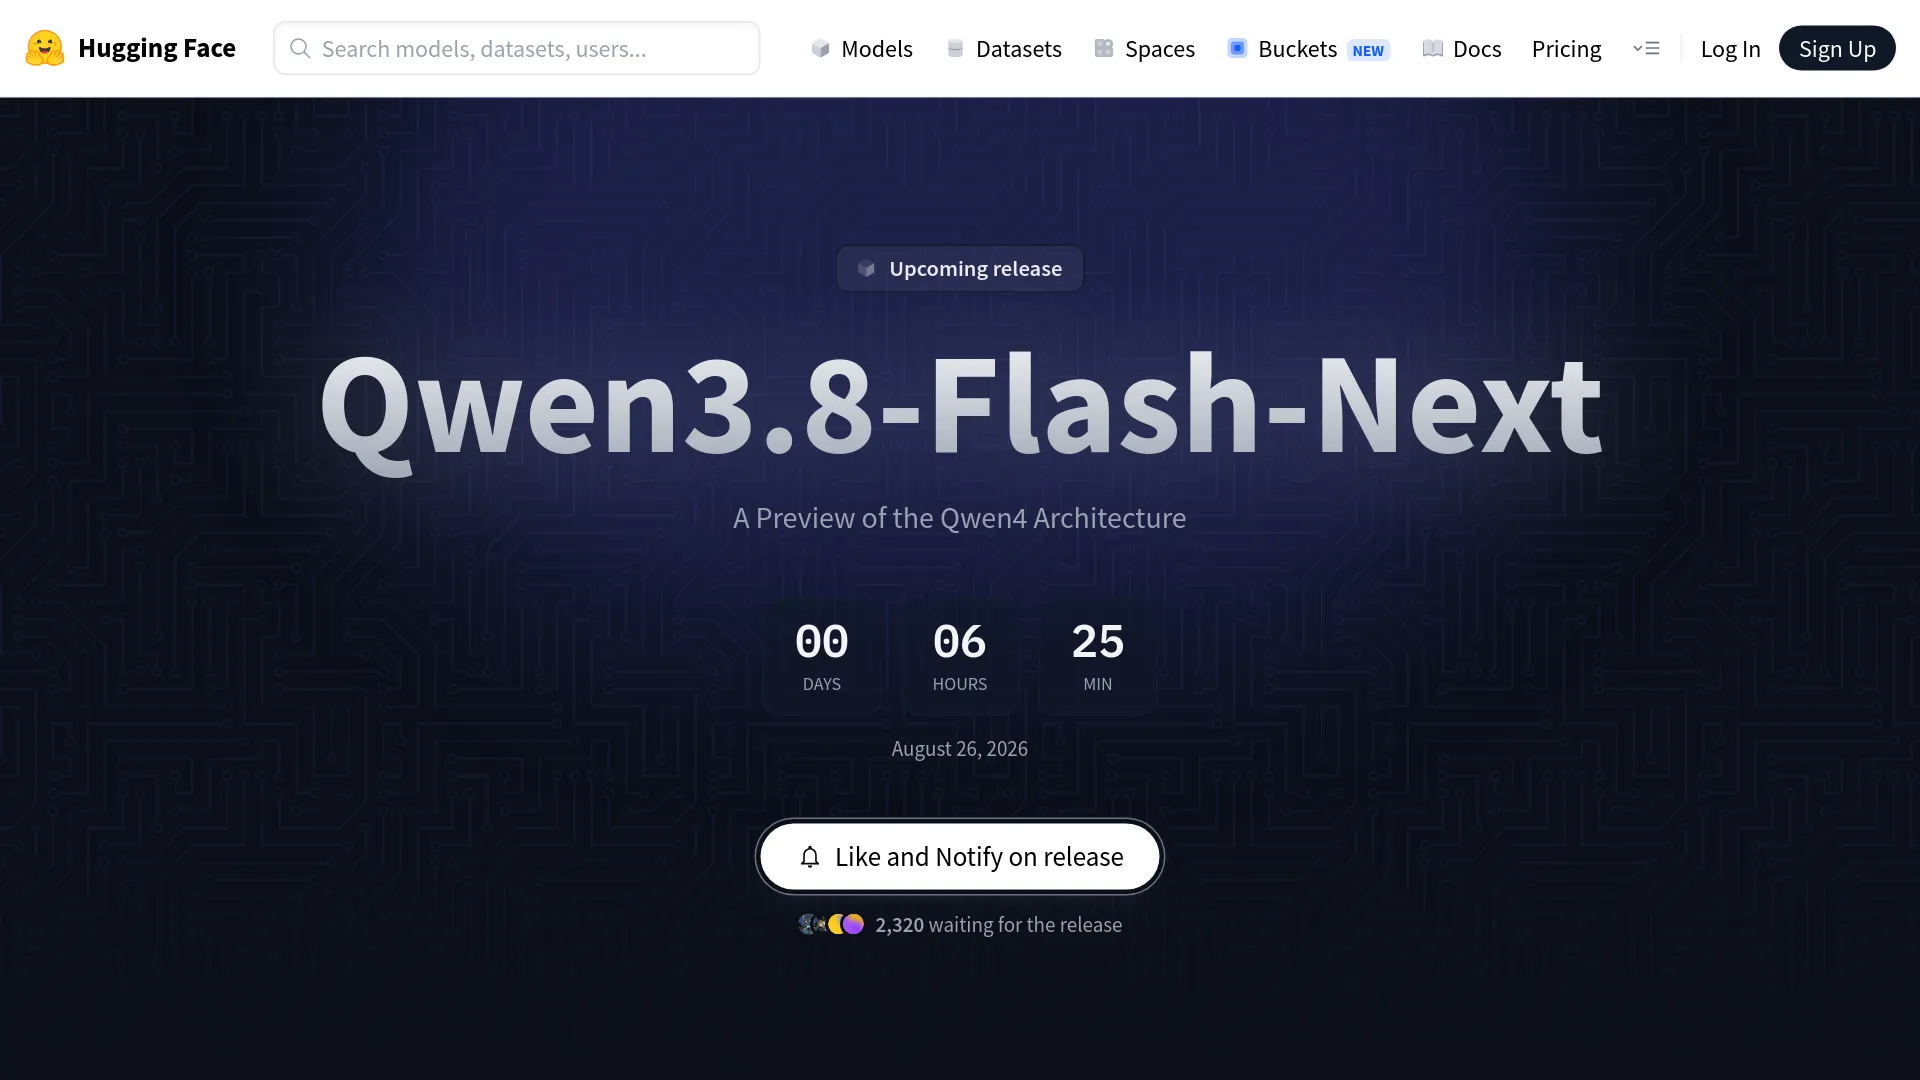
目前可以把資訊分成「官方已確認」與「社群仍在推測」兩部分:
| 官方管道已確認 | 目前仍未確認 |
|---|---|
| 將在 ModelScope 與 Hugging Face 開放權重 | 最終參數量(125B/6B/51B) |
| 多模態(視覺+文字) | 授權條款(依過往慣例,很可能是 Apache 2.0) |
| GDN 混合架構與 Qwen Sparse Attention | 任何形式的基準測試成績 |
FP8 版本(Qwen/Qwen3.8-Flash-Next-FP8) | API 價格或供應情況 |
| Qwen4 的架構預覽 | 上下文長度(社群推測原生 256K,並可延伸至 1M) |
社群目前最常引用的數字——總參數 125B、每個 token 啟用 6B、51B n-gram embedding——來自一張曾短暫出現在 ModelScope、之後被 Qwen 團隊裁減的模型卡。這組數字合理,也獲得多位獨立觀察者反覆提及,但不能視為穩定的官方文件。SaaSCity 創辦人 ghosty 直接說:
「今天發布這個模型基準測試圖表的人,都是自己編的。」
這套架構,會改變推論框架的支援方式
Qwen3.8-Flash-Next 有三個關鍵架構元件,使它與目前 Qwen 產品線的模型明顯不同。對推論框架而言,這不只是改幾個設定值,而是需要加入新的 kernel 程式碼。
GDN 層:固定大小的循環狀態,降低長上下文記憶體成本
Gated Delta Network(GDN) 取代了大多數層中的標準注意力機制。標準 Transformer 注意力需要儲存會隨序列長度增加的 KV cache;GDN 則使用固定大小的循環狀態。在 GDN 層中,無論上下文多長,記憶體占用都維持不變,計算量也從平方級降為線性級。混合架構中的完整注意力層仍會使用 KV cache,以維持精準的資訊檢索能力。
實際影響很直接:長上下文工作負載的成本可大幅降低。一次延續 100K tokens 的對話,不必為 100K tokens 保存等量的 KV cache。根據社群對那張短暫可見的 ModelScope 卡片進行分析,Qwen3.8 架構據稱由69 個 GDN 層與 23 個完整注意力層組成,比例約為 3:1。完整注意力層負責保留全域檢索品質,GDN 層則處理大部分序列運算。
這並不是 Qwen 首次採用類似方向。Qwen3-Next 在 2025 年 9 月推出時,就以總參數 80B、啟用參數 3B 的規模引入 Gated DeltaNet;據報導,Qwen3.5/3.6/3.7 系列也維持了相近的混合模式。Flash-Next 真正的新意,在於把這套架構擴展到總參數 125B,並加入下面兩個元件。
QSA:已知是稀疏注意力,但具體怎麼運作仍是謎
Qwen Sparse Attention(QSA)已經出現在模型卡上,但目前沒有詳細說明。社群普遍認為,它會以稀疏模式取代密集注意力:每個 token 只關注其他 token 的一部分,而不是掃過完整序列。至於 QSA 採用的是學習式稀疏、區塊稀疏、滑動視窗,還是幾種方法的組合,目前都沒有答案。等技術報告發布後,才能判斷 QSA 是漸進式優化,還是真正全新的注意力原語。
51B n-gram 表:不靠獨立草稿模型的推測解碼
最不尋常的設計,是一張擁有 51B 參數的 n-gram embedding 表。社群目前的工作假說是,它可能扮演高速 token 查找機制的角色——本質上相當於整合進模型的推測解碼草稿模型。傳統做法是先執行一個較小的模型,預測接下來幾個 token,再交由主模型驗證;n-gram 表則可能直接提供成本更低的下一 token 候選。
但部署上仍有幾個關鍵問題:這張表是否必須放在 VRAM?能不能以 memory-mapped 方式載入?量化後的表現如何?它是否已經包含在 125B 的數字裡,還是要另外計算?在技術報告或第一批社群基準測試回答這些問題之前,最好把 51B 視為部署規劃變數,而不是固定成本。
Flash-Next 在 Qwen 家族中扮演什麼角色?
Flash-Next 並不是線性產品進化中的下一步,而是另一條平行路線:
| 模型 | 發布時間 | 總參數 | 啟用參數 | 定位 |
|---|---|---|---|---|
| Qwen3-Next | 2025 年 9 月 | 80B | 3B | 首次測試 GDN 架構 |
| Qwen3.8-27B | 2026 年 8 月 | 27B(dense) | 27B | 中階密集模型主力 |
| Qwen3.8-Max | 2026 年 8 月 | 約 2.4T | 約 95B | 旗艦級開放權重模型 |
| Qwen3.8-Flash-Next | 2026 年 8 月 26 日 | 約 125B | 約 6B | Qwen4 架構預覽 |
| Qwen4 | 待定(數個月後) | 未知 | 未知 | 完整的新世代系列 |
社群目前採用的一個估算方式是:sqrt(125B x 6B) = 27B。如果這個估算成立,Flash-Next 的品質可能大致接近 27B 的 dense 模型,但推論計算量更接近 6B 模型。Beer And Code 的 Lucas Souza 也提醒,這只是經驗法則,不是定理;路由品質、資料品質,以及 n-gram 表的實際貢獻,目前都還沒有測量。
多份社群分析都把這項策略形容為「平台布局,而不是基準測試布局」。核心目標是讓 llama.cpp、vLLM 與 SGLang 等推論框架,在 Qwen4 發布前先完成 kernel 支援。Unsloth 也已宣布會從第一天開始投入支援。
真的跑得動嗎?先面對硬體現實
| 格式 | 估計權重記憶體 |
|---|---|
| BF16/FP16 | 約 250 GB |
| FP8 | 約 125 GB |
| Q4/4-bit | 約 65–70 GB |
以上數字只計算模型權重,尚未包含上下文、KV cache 或執行環境額外開銷。Q4 量化模型的主要權重大約就需要65–70 GB,此外還要看 51B n-gram 表需要多少記憶體。如果 n-gram 表必須放進 VRAM,總需求會超過多數單機系統的承受範圍;如果能以 memory-mapped 方式放到系統 RAM,配備 128GB 以上統一記憶體的系統——例如滿配的 Mac Studio(M2 Ultra/M3 Ultra)、AMD Strix Halo、NVIDIA DGX Spark——或許有機會運作。單張 RTX 4090 或 5090 就不用想了。
Reddit 使用者 u/KURD_1_STAN 也反駁了「適合本地端」這種說法:「RAM 價格這麼高,怎麼能說它適合本地端?」把「每個 token 只啟用 6B」與 250GB 記憶體需求放在一起看,這個落差確實存在。X 上的 @Dicklong1999 則指出,稀疏啟用模式意味著有足夠硬體的人或許能獲得合理生成速度,但「125B,一般人基本上可以不用想在本地跑了。」
API 供應與價格,目前可以期待什麼?
截至發布本文時,Qwen3.8-Flash-Next 的 API 價格與供應情況尚未公布。Qwen3.8-Max 在 Qwen 官方價格頁面列出的費用為輸入每百萬 token $2.00、輸出每百萬 token $6.00;考量 Flash-Next 每個 token 只啟用 6B 參數,價格應會便宜許多。FP8 版本相較 BF16 可將權重記憶體需求減半,因此很適合作為 API 服務格式。至於何時能用,仍取決於推論框架的支援進度;模型權重發布後,可以再查看各家供應商目錄。
權重發布前,現在可以先做什麼?
如果你是開發者或研究人員,正在評估 Qwen3.8-Flash-Next 是否值得加入現有技術堆疊,可以先完成以下檢查:
1. 確認硬體條件。如果打算在本地執行,先確認手上有 128GB 以上統一記憶體,或多 GPU 系統。若沒有,就應該以 API 存取為主要方案。
2. 盯緊 Hugging Face 儲存庫。模型卡會是規格、授權條款與上下文長度的第一手可靠來源。可以先收藏 huggingface.co/Qwen/Qwen3.8-Flash-Next。
3. 先準備好評測流程。在權重發布前,把基準測試提示詞與評估腳本準備好。發布後的第一個 24 小時,社群基準測試提供的資訊,可能比任何官方數字都更有參考價值。
4. 不要直接切換正式工作負載。目前沒有獨立基準測試,架構本身又很新,執行時支援尚未成熟,授權條款也還沒確認。現階段適合拿來評估,不要用在一旦出問題就會造成金錢損失的正式工作上。
5. 如果你維護推論工具,現在就可以開始。GDN+QSA 的組合需要 kernel 層級的開發,不是改設定就能完成。越早理解這套架構,就越有機會更快推出支援。
FAQ
權重什麼時候可以取得?
ModelScope 倒數頁面指向2026 年 8 月 26 日約 23:00(UTC+8)。Hugging Face 鏡像通常會在 ModelScope 發布後數小時內出現。Qwen 團隊已透過官方管道確認時間:@Alibaba_Qwen 預告「今晚要丟出什麼驚喜」,@QwenDevs 則直接點名了這個模型。
這就是 Qwen4 嗎?
不是。它是採用 Qwen3.8 命名方式、用來預覽 Qwen4 架構的模型。Qwen4 本身預計還要數個月,不是幾週內就會推出。Flash-Next 的存在目的,就是讓生態系先準備好執行環境支援,等完整系列到來時能直接接上。
它採用什麼授權條款?
尚未確認。近期 Qwen 的開放權重版本(Qwen3.8-27B、Qwen3.8-Max)都採用 Apache 2.0,因此這是最可能的結果。等權重上線後,仍應以模型卡上的資訊為準。
可以在 RTX 4090 上執行嗎?
不行。即使採用 Q4 量化,光是主要權重就需要約 65–70 GB;單張 RTX 4090 只有 24 GB。你需要配備 128GB 以上統一記憶體的系統(例如 Mac Studio、Strix Halo),或多張高 VRAM GPU。
它會擊敗 Qwen3.8-27B 嗎?
不知道。目前沒有任何基準測試。sqrt(125B x 6B) = 27B 這個經驗法則,推測它的品質可能接近 27B dense 模型,但這只是估算,不是實測結果。還是要等針對你實際使用情境的獨立評測。
它會有多快?
每個 token 啟用 6B 參數,代表生成速度理論上應該更接近小型模型,而不是 125B 巨型模型。不過,n-gram 表的記憶體存取模式與 GDN kernel 的效率,都是目前未知的變數。第一批社群基準測試會給出答案。
它會登上 API 平台嗎?
幾乎一定會。FP8 版本本來就很適合 API 服務。AIReiter 和其他平台通常會在 Qwen 模型發布後幾天內加入支援,真正的瓶頸在於各框架對新型注意力機制的支援程度。
去年的 Qwen3-Next 後來怎麼了?
Qwen3-Next 在 2025 年 9 月推出,總參數 80B、啟用參數 3B,並首次引入 Gated DeltaNet。它是一次較小規模的架構測試,證明 GDN 混合方案確實可行;Flash-Next 則是放大規模後的續作。X 上的 @LufzzLiz 認為,去年的 Next 系列「令人失望」——這也正是這次必須等獨立基準測試出爐後再下結論的原因。