 AIREITER
Qwen Audio 3.0 Realtime 是 Qwen 現行產品線中的即時語音能力:你可以直接對模型說話,它也能幾乎同步以語音回應,互動延遲低到接近電話通話的感覺。在阿里巴巴的平台上,這套能力由 Qwen3-Omni / Qwen3.5-Omni Realtime API 提供,例如 qwen3-omni-flash-realtime;若只需要文字轉語音,可使用 Qwen-TTS-Realtime,語音轉文字則有 qwen3-asr-flash。託管版 omni Realtime 模型支援辨識超過 100 種語言、可全雙工對話與打斷發言,單次對話成本低至每分鐘不到一美分。
想快速開始,最直接的選擇是透過 WebSocket 使用 qwen3-omni-flash-realtime。以下會說明各模型的用途、規格、價格、與 OpenAI Realtime 及 Gemini Live 的差異,以及實際接入方式。文中的規格、價格與模型 ID 都連到原始資料來源,主要是阿里巴巴的 Model Studio Realtime 文件 與 Qwen3-Omni model card。這個領域更新很快,若本文數字與現況不同,請以連結內的官方資料為準。
先搞懂 Qwen 音訊模型的命名邏輯
Qwen 的音訊模型經過數個世代演進,理解其脈絡後,要挑對模型就不難:
Qwen-Audio(2023)與Qwen2-Audio屬於音訊理解模型:輸入音訊、輸出文字,不能以語音回話。- 目前的世代將音訊能力整合進 omni 模型。
Qwen3-Omni與Qwen3.5-Omni可接收文字、圖片、音訊與影片,並產生文字與自然語音。 - 即時互動則是一種服務層級:透過 Realtime API 呼叫同一批 omni 模型,模型 ID 會以
-realtime結尾。
因此,「Qwen Audio 3.0 Realtime」無論寫法或標點為何,實際指的都是以即時模式使用的 Qwen3-Omni 家族;本文後續討論的就是這套技術堆疊。
Qwen 即時語音應用:三層模型堆疊
與其把它看成單一模型,更適合將它理解為一條處理管線。正式上線的語音應用通常會碰到三種 Qwen 模型;你可以全數搭配使用,也能分開選用。
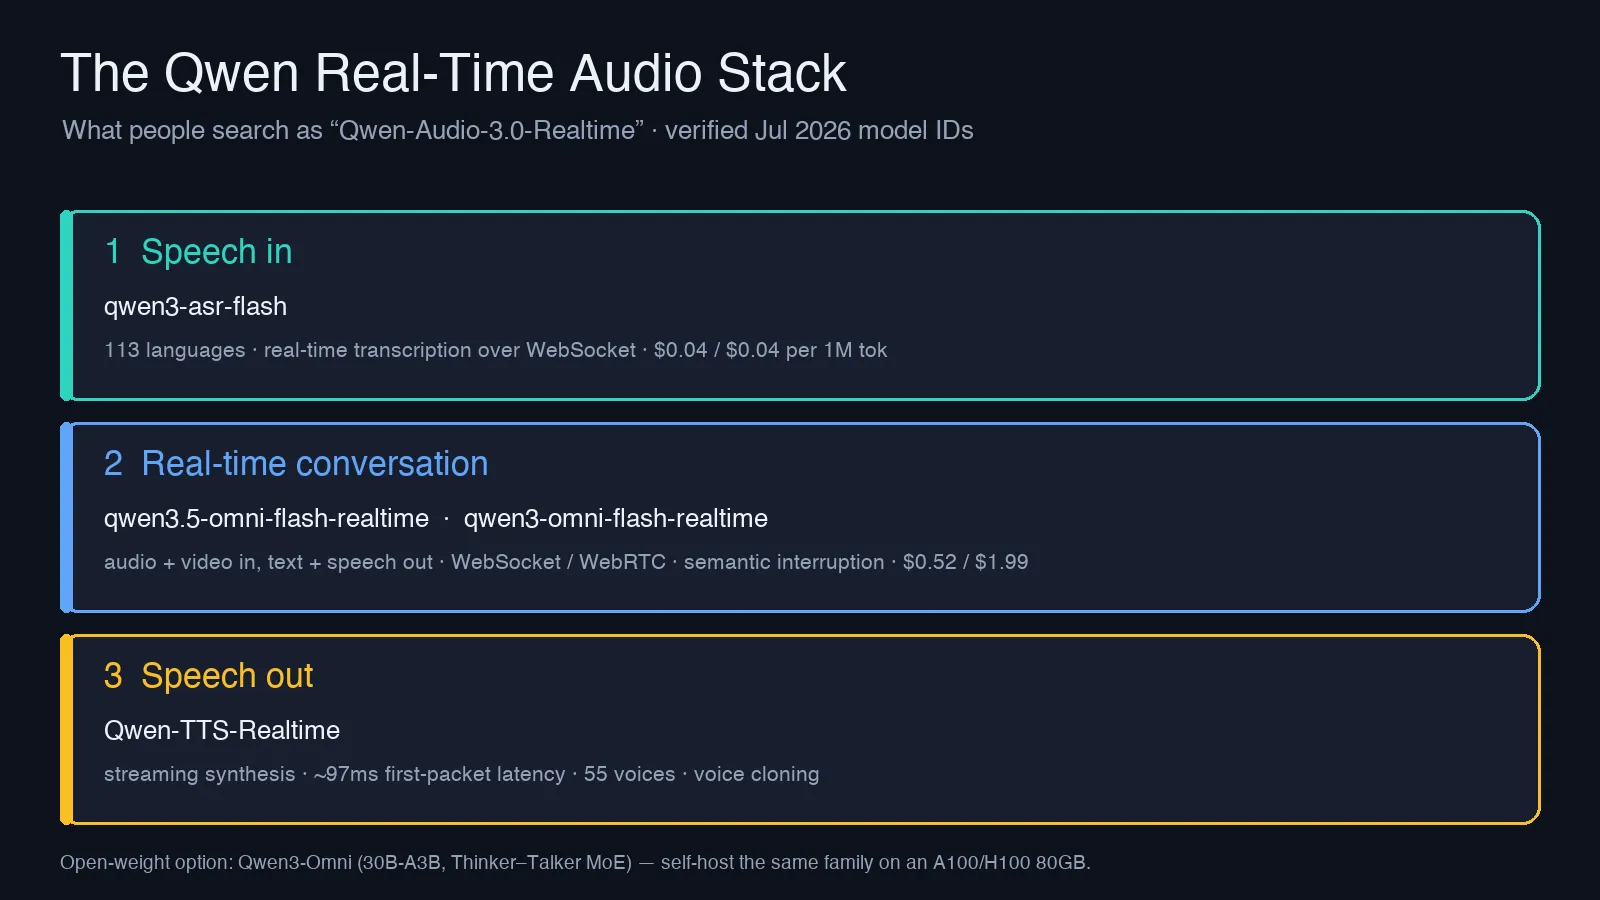
- 語音輸入:
qwen3-asr-flash。 透過 WebSocket 進行串流語音辨識,適合即時字幕與語音代理前端。它支援極廣的語言範圍,定位是價格低廉的逐字稿處理模型。 - 即時對話:
qwen3.5-omni-flash-realtime、qwen3-omni-flash-realtime、qwen3.5-omni-plus-realtime。 這是整套體驗的核心:音訊與影片影格輸入後,透過持續連線輸出文字與合成語音;每輪對話不需要重新建立請求。 - 語音輸出:
Qwen-TTS-Realtime。 專用的串流文字轉語音模型,適合只需將文字轉成聲音的場景,例如朗讀文字 LLM 產生的回答。
若中間層直接採用 omni Realtime 模型,通常不必另外呼叫 ASR 與 TTS,因為它已完整處理語音輸入與輸出。獨立模型的價值在於彈性組合,例如用自己的 STT,再搭配 Qwen TTS。
真正會影響開發的規格
以下數據來自 Model Studio Realtime 文件,不是行銷頁面的宣傳規格。
| 項目 | Qwen Realtime API(omni 家族) |
|---|---|
| 音訊輸入 | PCM,16 kHz |
| 音訊輸出 | PCM,24 kHz |
| 其他輸入 | 圖片/影片影格(JPG,最高 1080p,編碼後 256 KB) |
| 語音辨識 | 113 種語言與方言(託管 API) |
| 語音生成 | 36 種語言與方言 |
| 音色 | 共 55 種(47 種多語言、8 種方言),3.5 模型另支援聲音複製 |
| 連線方式 | WebSocket(Bearer 驗證、手動或伺服器端 VAD)與 WebRTC(SDP 協商) |
| 單次工作階段上限 | WebSocket 最長 120 分鐘 |
| 附加能力 | 語意式打斷、函式呼叫、自動網頁搜尋,以及音量/語速/情緒的語音控制 |
其中幾項特別值得注意。語意式打斷代表模型能區分使用者是在插話,還是只用「嗯哼」這類回應表示自己仍在聽;這是語音代理自然與惱人之間的關鍵差異。WebRTC 支援對瀏覽器端應用很重要,因為它會代為處理回音消除與網路抖動。至於 113 種語言的辨識能力,指的是託管 API;開放權重版本支援的語言較少,後文會說明。
延遲方面,專用的 Qwen-TTS-Realtime 串流路徑,依照 Qwen3-TTS 串流文件,目標是約 97 ms 的首封包延遲。這個數字直接影響語音是否讓人感覺即時,但它衡量的是第一段音訊送達的時間,不是完整回答生成完畢的時間。完整對話迴路則採用適合串流的 Thinker–Talker 架構;Qwen3-Omni 技術報告提到其多碼本設計旨在降低延遲,而社群測試指出,全雙工、可打斷回合的音訊對音訊回應可落在 250 ms 以下。實際結果仍取決於區域、網路與負載,應以自己的實際流量測試,而非只相信單一宣傳數字。
Qwen 即時音訊價格:換算成實際成本
Qwen 託管即時模型的價格,明顯低於封閉式即時 API。以下是每百萬 token 的輸入/輸出費率,資料列於 Portkey 的 DashScope 模型目錄。這是鏡像阿里巴巴費率的第三方彙整資料;正式導入前,請在 Model Studio console 確認即時價格:
| 模型 | 輸入/100 萬 token | 輸出/100 萬 token |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash(轉錄) | $0.04 | $0.04 |
換算成單通對話會是多少? 音訊是高 token 消耗的資料型態:每分鐘音訊約為 427 個 token。假設一段 10 分鐘的語音對話中,使用者說了 5 分鐘,模型也回答了 5 分鐘。在 qwen3-omni-flash-realtime 上,約為 2,135 個輸入 token 與 2,135 個輸出 token,因此成本約是輸入 $0.001 + 輸出 $0.004,合計約半美分/10 分鐘通話。即使放大到大量使用,即時音訊仍很便宜;真正容易被忽略的是輸出端的說話時間,因為語音回答的單價約為輸入端的 4 倍。
規劃預算前,還有兩點要留意:
- 有免費額度,但依區域而定。新加坡國際端點曾提供 100 萬輸入 token 與 100 萬輸出 token、期限 90 天的免費額度;美國端點則沒有。額度可能調整,請先到你所用區域的 Model Studio console 確認目前方案,再將它納入規劃。
qwen3.5-omni層級採用請求大小的分級計價,並非固定單一費率。因此,一次帶入大型上下文的請求,可能會落在與數個小請求不同的價格區間。正式承諾前,請依你的真實流量型態測試。
和 OpenAI Realtime、Gemini Live 相比,Qwen 的位置在哪?
在 2026 年中,通用型前沿 LLM 供應商中,明顯可選的即時語音對語音方案包括 OpenAI Realtime API、Google Gemini Live,以及 Qwen 的 omni Realtime 家族。(ElevenLabs、Deepgram、Cartesia、Hume 等專業語音供應商,在 TTS 與 STT 領域同樣競爭激烈;但這裡比較的是完整多模態模型路線。)競品價格每月都可能改變,與其引用很快過期的數字,更適合從以下面向評估:
- 成本。依上述單通對話費率來看,Qwen 的即時服務位於託管前沿模型選項的低價帶。作為對照,OpenAI Realtime 音訊的價格曾約為每分鐘輸入 $0.06、每分鐘輸出 $0.24(價格拆解見此);以此估算,同一通在
qwen3-omni-flash-realtime約半美分的 10 分鐘對話,在 OpenAI 會接近$1.50。實際採用前仍須確認雙方最新費率,但價差很大。Qwen 也是三者中唯一提供開放權重版本的選擇,可自行託管,讓邊際成本趨近於零。 - 開放性。OpenAI Realtime 與 Gemini Live 都只有封閉 API。Qwen3-Omni 提供開放權重,因此可以從託管服務轉為自行部署,而不必將應用重寫成另一個模型的互動邏輯。
- 品質。第三方報導指出,最高階的
qwen3.5-omni-plus在部分音訊理解基準測試中可追平或超越 Gemini 3.1 Pro。不過,任何單一 benchmark 都只能當作初步假設,最終仍應以自己的音訊資料測試。 - 生態系。OpenAI 與 Google 目前提供更完整的工具、SDK 與社群範例。Qwen 的文件品質不差,但實作時會更常直接處理原始 WebSocket/WebRTC 規格。
實務上的結論很簡單:在意成本,或需要保留自行託管選項時,Qwen 是最強選擇;若你更重視成熟的 SDK 體驗,且願意為此付費,OpenAI 與 Google 目前仍在產品細緻度上領先。想了解封閉式替代方案的完整成本,可參考下方延伸閱讀。
不同需求該選哪個版本?
| 你的情境 | 建議使用 |
|---|---|
| 成本最低的託管完整語音對話 | qwen3-omni-flash-realtime |
| 最佳託管品質、較長工作階段、聲音複製 | qwen3.5-omni-plus-realtime |
| 只需要語音轉文字 | qwen3-asr-flash |
| 只需要文字轉語音 | Qwen-TTS-Realtime |
| 資料必須留在自有硬體 | 自行託管開放權重 Qwen3-Omni(30B-A3B) |
3.5 層級相較於精簡版 qwen3-omni-flash(8 輪),增加了聲音複製、更長的上下文與對話限制,最高可達 100 輪與保留 600 秒音訊。如果還在做原型,先從 Flash 開始;只有在你明確碰到限制時,再升級到 Plus。
如何開始使用 Qwen Realtime
託管版:直接串接。先在 Alibaba Cloud Model Studio 建立 API key,接著以 Bearer 驗證建立 WebSocket 連線;瀏覽器應用則可透過 SDP POST 協商 WebRTC。上傳 PCM 音訊串流後,服務會回傳 PCM 音訊與文字。若不想自行管理 socket,可使用封裝 Realtime 介面的 DashScope Python SDK。以下是最精簡的連線示意,省略錯誤處理:
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. configure the session: voice, output format, server-side turn detection
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. stream microphone audio up as base64 PCM 16 kHz frames
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. read events back; response.audio.delta carries PCM 24 kHz to play
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
使用伺服器端 VAD 時,模型會自行判斷使用者何時說完;若要自行控制回合邊界,可改用手動模式。事件流程和 OpenAI Realtime 的結構非常接近,既有的 Realtime 用戶端程式通常只要小幅修改就能移植。正式上線前,請對照 Realtime 文件確認欄位名稱、音色清單與區域端點主機,因為新加坡與美國部署的設定並不完全相同,而且 API 持續演進。
自行託管。開放權重的 Qwen3-Omni 使用 Thinker–Talker Mixture-of-Experts 架構,總參數量為 30B,約有 3B 參數會啟用。阿里巴巴建議使用 vLLM,而不是單純以 Transformers 部署。針對完整 30B 模型的 BF16 推論,第三方部署指南指出最低需求是一張80GB 顯示卡(A100 或 H100);RTX 4090 這類 24 GB 顯示卡不足以載入完整權重,但量化版本可降低硬體門檻。
但即時服務比批次推論困難得多。自行託管者回報,在並發負載下需要限制 KV cache,才能避免服務停頓;單卡的 token 吞吐量也落後於託管 API。針對串流最佳化的服務堆疊能大幅縮小這個差距:參與 Red Hat AI 與 vLLM 的工程師曾表示,透過重疊管線階段,可將 3 秒片段的語音生成時間從約 8 秒降至約 0.5 秒。這確實是可觀的改善,但也意味著額外工程投入。自行託管能移除每 token 費用,卻增加 GPU 與維運成本;它更適合高且穩定的使用量,而不是原型開發。
目前要使用即時 omni 語音,DashScope 端點是標準途徑。如果你的技術堆疊已經透過單一 gateway 路由多家供應商,前面可加上一層聚合服務;但要先確認該服務的目錄中確實有指定的 Qwen 即時模型 ID,因為不少轉接服務只支援文字與圖片模型,沒有即時音訊層級。
正式開發前必須知道的限制
- 工作階段上限為 120 分鐘。若要支援客服專線、長時間家教等更長的互動,需要實作重新連線邏輯,並在不同 socket 之間保留上下文。
- 區域會影響免費額度與可用性。請針對真正要部署的端點測試,而不是只測試最初註冊的端點。
- 託管版與開放權重版並不相同。託管 API 標示支援 113 種語言辨識與 36 種語言生成;開放權重的 Qwen3-Omni 版本支援範圍較小,只有 19 種語音輸入語言與 10 種語音輸出語言。若特定語言是你的核心需求,務必在預計上線的確切版本上驗證。
- 即時服務成本取決於說話時間,而不是請求數。音訊消耗大量 token,話很多的使用者成本會高於簡短回答的使用者。估算帳單時,應依對話分鐘數,而非通話次數。
常見問題
Qwen 3 支援音訊嗎?
支援。Qwen3-Omni 模型原生具備多模態能力,可接收音訊、文字、圖片與影片,並即時輸出文字或語音回應。
Qwen 能生成音訊,而不只是理解音訊嗎?
可以。早期 Qwen-Audio 只能產生文字;omni Realtime 模型與 Qwen-TTS-Realtime 則可輸出語音,3.5 層級還支援複製聲音。
Qwen 即時音訊是免費的嗎?
有免費試用額度。國際版新加坡端點過去曾提供 90 天、100 萬輸入 token 與 100 萬輸出 token。超出額度後採按 token 計費;完整開放權重的 Qwen3-Omni 若使用自有 GPU 執行,則不需支付模型費用。
如何在本機執行 Qwen 音訊模型?
下載開放權重的 Qwen3-Omni(30B-A3B),並用 vLLM 提供服務。完整模型以 BF16 執行時,大約需要一張 80GB 顯示卡,例如 A100 或 H100;較小的消費級 GPU 只能處理量化版本,無法載入完整權重。
延伸閱讀
主要資料來源:
替代方案的價格比較: