 AIREITER
先講結論:若你製作的是短篇英語或中文音訊內容,Seed Audio 1.0 現在就值得試試;不過實際上應透過第三方 gateway 使用,而非官方 API。ByteDance 這個模型只靠一段提示詞,就能生成完整音訊場景,包含對話、背景音樂與音效。它和單一用途的 TTS 或音樂工具最大的差異,在於可同時處理多角色對話與內建音樂混音。不過,它也有三項明確限制:每次生成最長 2 分鐘、僅支援英語與中文,官方 API 仍採邀請制且尚未公布價格。以下逐一拆解。
Seed Audio 1.0 到底是什麼?
多數音訊工具只專注一件事:文字轉語音、生成音樂,或生成音效。Seed Audio 1.0 的完整名稱是 Doubao-Seed-Audio 1.0,它能在同一條時間軸上一次完成這三件事。例如輸入「深夜便利商店裡的懸疑廣播劇」,輸出的就是已混製完成的音訊,裡面有台詞、環境聲與背景音樂。
它提供三種模式。文字轉音訊(T2A)會依書面描述建立場景;文字加音訊轉音訊(TA2A)可搭配參考片段與文字,讓你引導聲音和風格;若只需要乾淨的人聲旁白,則可使用一般 TTS。該選哪一種,取決於你提供給模型的輸入素材。
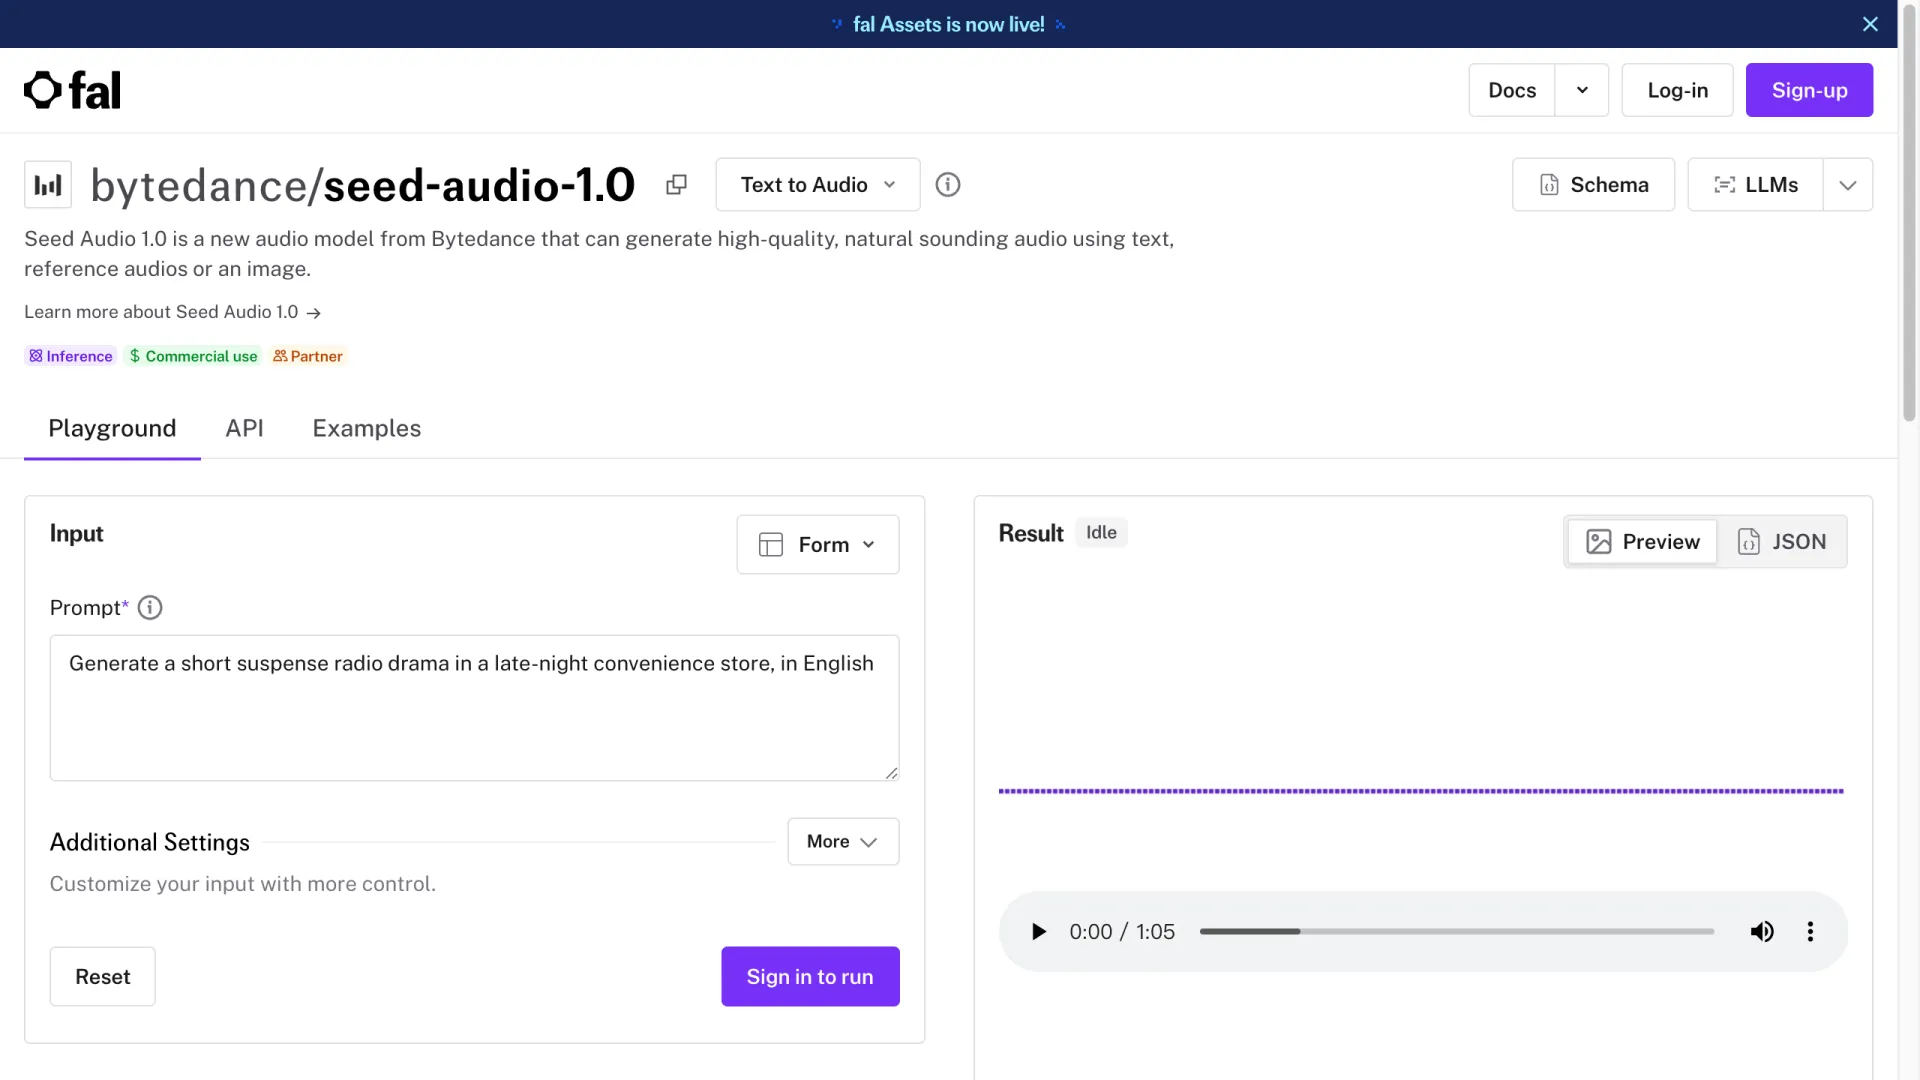
有一點需要先釐清:它算不算語音複製工具?Seed Audio 1.0 能讓同一種聲音詮釋多個角色,也能模仿參考片段的語氣,但產出的聲音是合成結果,並不會綁定特定真實人物的身分。比較準確的定位是 zero-shot 聲音風格化,而不是未經同意就能複製指定人物的工具。它建立在 ByteDance 先前的 Seed-TTS 與 Seed-Music 研究之上,因此能把富有表現力的語音與音樂生成能力整合到同一個模型中。
先看這些規格,判斷適不適合你的需求
在開始之前,先確認你的使用情境能否接受這些硬性限制。以下數據已對照 fal 與 EvoLink 的模型頁面:
| 規格 | 數值 |
|---|---|
| 單次生成最長輸出 | 120 秒(2 分鐘) |
| 文字提示詞上限 | 約 1,500–2,000 個字元(來源說法不同,請以主控台為準) |
| 參考音訊 | 最多 3 段,每段 ≤30 秒 |
| 支援語言 | 僅英語與中文 |
| 輸出格式 | WAV、MP3、PCM、OGG Opus |
| 取樣率 | 48K / 24K / 16K / 8K |
| 可調控制項 | 速度、音高、音量(不支援 SSML) |
| 計費方式 | 依輸出時長計費 |
其中最容易造成困擾的,是 2 分鐘上限。完整的 Podcast 集數或長篇旁白,都得先拆成多段腳本再拼接,而不同片段之間可能出現語氣漂移。fal 的模型說明提到,後續預計更新將把單次生成長度提升至接近 10 分鐘,並加入明確的長度控制與更多語言支援;若你的工作以長篇內容為主,值得等這項更新。
價格:官方尚未公布
目前沒有官方定價。截至 2026 年 7 月,Volcengine 尚未公布 Seed Audio 1.0 的每秒費率;它在 Volcano Ark 仍是邀請制,官方費率通常會在正式全面開放時才會推出。fal 和 EvoLink 這類 gateway 同樣沒有固定寫死費率,而是依輸出時長收費,計算方式為生成秒數 × 費率,因此重試也會計入成本。網路上若看到按 token 計價的數字,可以直接忽略:這是按時長計費的音訊模型,token 計費並不合理。
現在要怎麼用到 Seed Audio 1.0?
目前有兩條路,但實際使用體驗差異很大。
官方途徑是 Volcano Ark。Seed Audio 1.0 在此採邀請制,你必須申請、等待開通,再透過 ByteDance 自家的主控台使用。等到全面開放與價格公布後,這裡會是最具權威性的來源。
較實際的做法是使用第三方 gateway。fal 以 bytedance/seed-audio-1.0 提供此模型,不需白名單;只要有一般 API key,就能呼叫端點,EvoLink 也提供類似存取方式。對多數人而言,這是現在不必等邀請就能實際生成音訊的途徑。
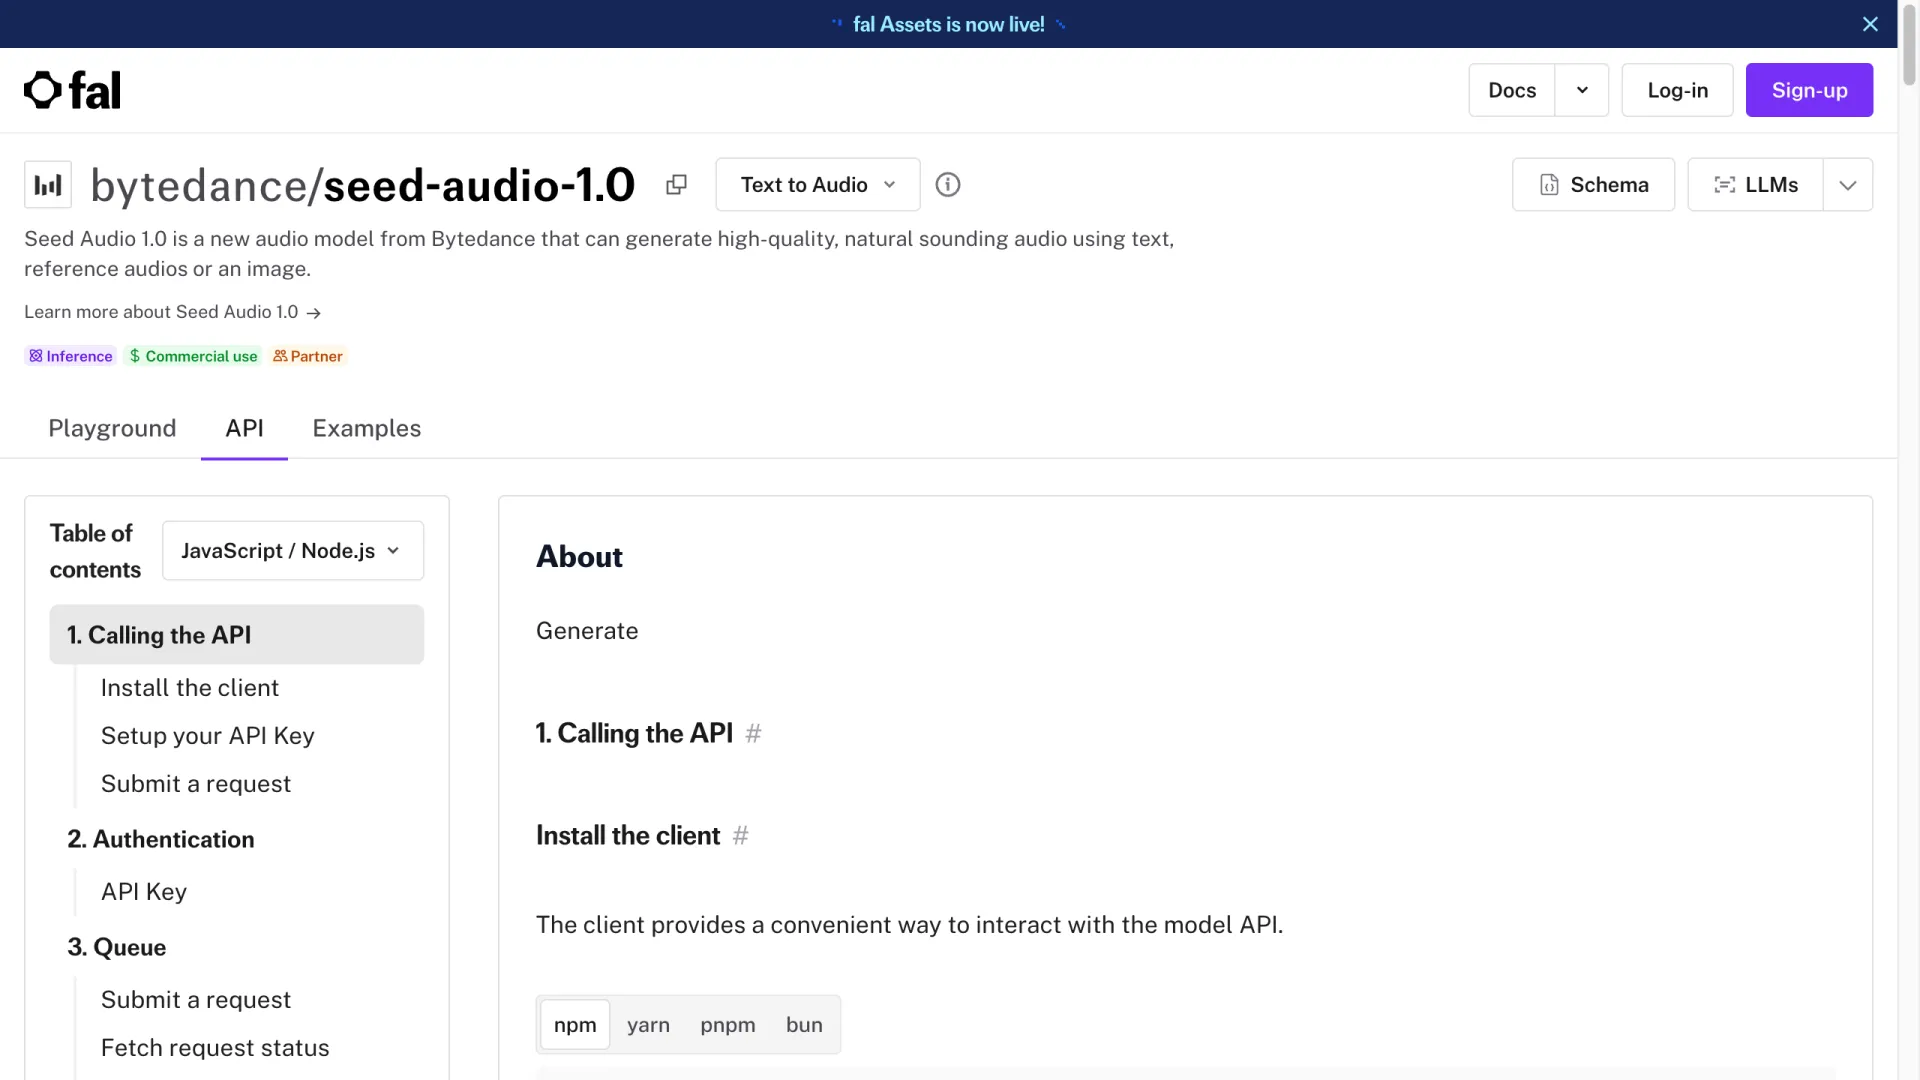
呼叫模式是常見的佇列式 API:安裝用戶端、設定金鑰、送出提示詞,再輪詢結果。如果你以前整合過任何託管式生成模型,這套流程沒有太多新東西;我們的 fal.ai 評測 會更深入介紹開發者使用體驗。
第一次測試時,建議從一段能同時測到對話、環境音與節奏的短多角色場景開始,例如「深夜便利商店裡一段 30 秒的懸疑廣播劇,英語」。首段控制在 30 秒以內,即使生成失敗,學習模型如何解讀提示詞的成本也比較低。
Seed Audio 1.0 對上 ElevenLabs、Stable Audio 與 AudioCraft
真正該比較的不是每段音訊的單點品質,而是各工具原本為什麼工作而設計。
| 工具 | 核心強項 | 場景混音 | 語言 | 聲音控制 |
|---|---|---|---|---|
| Seed Audio 1.0 | 完整音訊場景(語音 + 音樂 + SFX) | 是,一次完成 | EN、CN | Zero-shot 風格化 |
| ElevenLabs | 語音與聲音複製 | 僅語音 | 30+ | 複製能力最強 |
| Stable Audio | 音樂與音效生成 | 單軌 | N/A(音樂) | 提示詞控制 |
| AudioCraft | 開源音樂/SFX | 單軌 | N/A(音樂) | 提示詞控制 |
若你追求最好的純語音效果,或需要跨多種語言進行精準聲音複製,ElevenLabs 仍然更勝一籌。若需求是獨立生成音樂,Stable Audio 或 Meta 的 AudioCraft 才是為此設計的工具。Seed Audio 1.0 的優勢在於,能把對話、音樂和音效整合為連貫且可編輯的場景;這份比較中的其他工具,都無法在單次呼叫中做到這點。
優勢與不足:適合用在哪裡?
它的強項:多角色對話,以及一次完成音樂與音效混音,是最核心的吸引力。根據 fal 的使用指南,它也支援延長片段、局部 in-painting、拼接不同 take 等既有編輯流程,因此不只是一次性的生成器,而是能納入製作流程的工具。
它的短板:任何長篇內容都會受制於 2 分鐘上限,必須自行拼接;僅支援英語和中文,也排除了大部分全球化語音需求。它是離線生成模型,不適合即時語音代理;而官方存取目前仍受邀請資格限制。
現在值得投入使用嗎?
如果你的內容是英語或中文,而且以短篇為主,例如配音、有聲書片段、短影片配樂或音訊廣播劇原型,現在就值得透過 gateway 試用 Seed Audio 1.0。一次生成完整場景,省去了手動疊加語音、音樂與音效的工作。
但如果你需要即時互動、不支援的語言,或長時間不中斷的音訊,建議先等一等。全面開放與預計中的長度更新,會改變整體評估;在此之前,像 Qwen Audio 3 這類即時模型,會更適合直播或互動式情境。對其他人來說,現在更像是「透過 gateway 測試、現有工具鏈繼續運作」的時機,而不是全面替換。
常見問題
Seed Audio 1.0 是免費的嗎?
不是。官方目前沒有免費方案:Volcano Ark API 為邀請制,取得存取權後會依輸出時長計費。第三方 gateway 則各自收取按量計費的費率。
Seed Audio 1.0 可以複製我的聲音嗎?
它可以模仿參考片段的風格,也能讓一種聲音詮釋多個角色,但輸出的是合成語音,不是鎖定特定真人身分的複製版本。不要把它視為可直接取代身分型語音複製工具的方案。
Seed Audio 1.0 支援哪些語言?
推出時僅支援英語與中文。根據 fal 的模型說明,預計更新的路線圖中包含更廣泛的多語言支援。
生成的音訊最長可以多長?
目前每次生成最長 120 秒。預計更新會將單次生成長度提高至接近 10 分鐘,並提供明確的長度控制。
有官方的 Seed Audio 1.0 API 嗎?
有,在 Volcengine 的 Volcano Ark 上,但目前仍為邀請制。若要在不需白名單的情況下公開使用,可選擇託管 bytedance/seed-audio-1.0 的 fal 等 gateway。
Seed Audio 和 Seed Music 有什麼差別?
Seed-Music 是 ByteDance 早期聚焦音樂的研究;Seed Audio 1.0 則把這項音樂能力與語音、音效結合,成為單一的場景生成模型。